
第七章YDB基本使用详解
一、如何与YDB对接(交互)
目前延云YDB提供如下几种方式
l命令行的方式
lWeb http接口的方式
lJDBC接口的方式
通过JAVA编程接入
通过可视化SQL分析统计接入
通过报表分析工具接入
二、命令行接入
进入ya100的安装目录的bin目录
1.直接执行 ./conn.sh 即可。
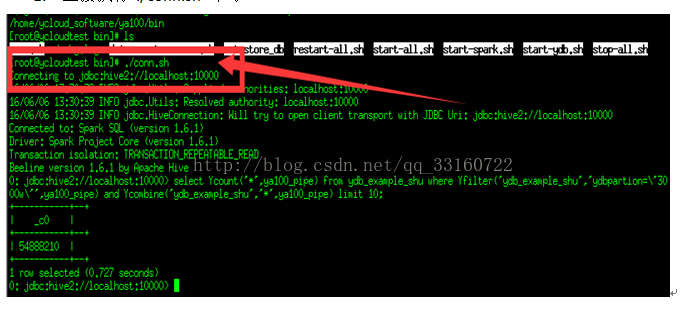
2.通过./sql.sh -f xxx.sql 直接执行文件中的SQL
三、WEB接入
WEB接口主要是为了给那些不支持HDBC访问的程序提供接口支持,如PHP。
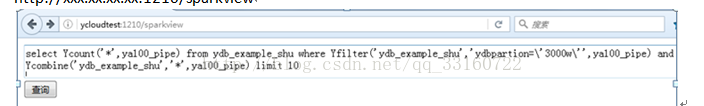
1.图形SQL 提交地址
http://xxx.xx.xx.xx:1210/sparkview
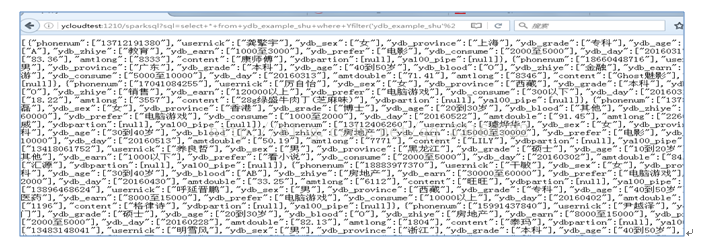
2.Json接口
http://xxx.xx.xx.xx:1210/sparksql?sql=?
SQL参数可以GET方式提交,也可以POST方式提交
四、JDBC接口
1.JDBC接入方式连接字符串
Connection conn = DriverManager.getConnection("jdbc:hive2://ydbmaster:10009/default", "hdfs", "");
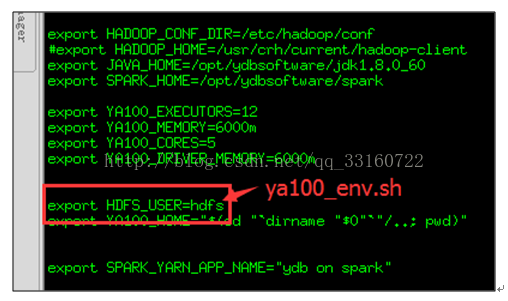
l10009表示JDBC的端口号,配置的值在ya100_evn.sh里面可以找到
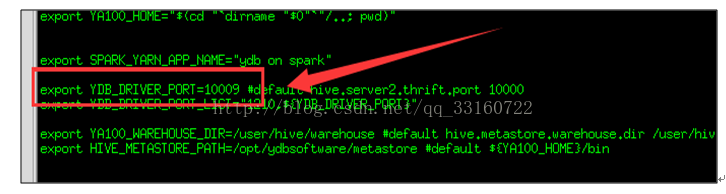
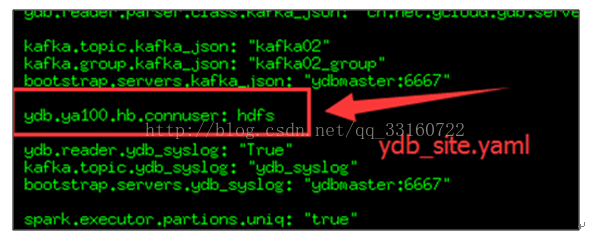
lhdfs表示连接时所使用的Hadoop账号,大家也要跟配置文件中一致,以免其他未知账号产生垃圾文件没有及时的清理掉,以及造成Hadoop权限问题。
这个账号的配置目前存在两个位置,请大家配置一致,使用同一个账号。
2.JAVA编程接口
Class.forName("org.apache.hive.jdbc.HiveDriver");
Connection conn = DriverManager.getConnection("jdbc:hive2://ydbmaster:10009/default", "hdfs", "");
Statement smst = conn.createStatement();
ResultSet rs = smst.executeQuery("/*ydb.pushdown('->')*/ select * from ydb_example_shu where ydbpartion = '3000w' limit 10 /*('<-')pushdown.ydb*/");
ResultSetMetaData m = rs.getMetaData();
int columns = m.getColumnCount();
for (int i = 1; i <= columns; i++) {
System.out.print(m.getColumnName(i));
System.out.print("\t\t");
}
while (rs.next()) {
for (int i = 1; i <= columns; i++) {
System.out.print(rs.getString(i));
System.out.print("\t\t");
}
System.out.println();
}
rs.close();
conn.close();
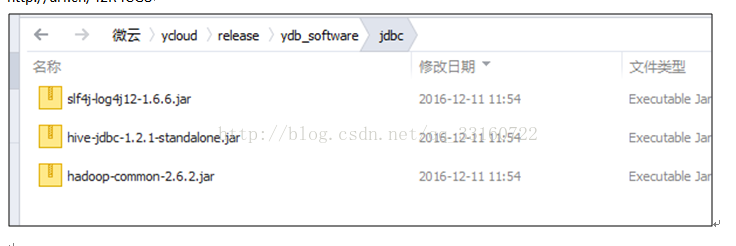
依赖的JDBC客户端jar包可以从这个地址获取,本质上就是HIVE的thrift接口,依赖的jar包也是Hive的jar包
http://url.cn/42R4CG8
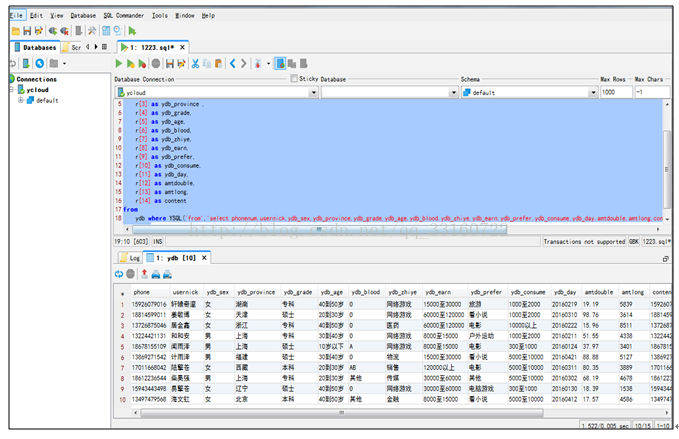
3.通过可视化SQL分析统计接入
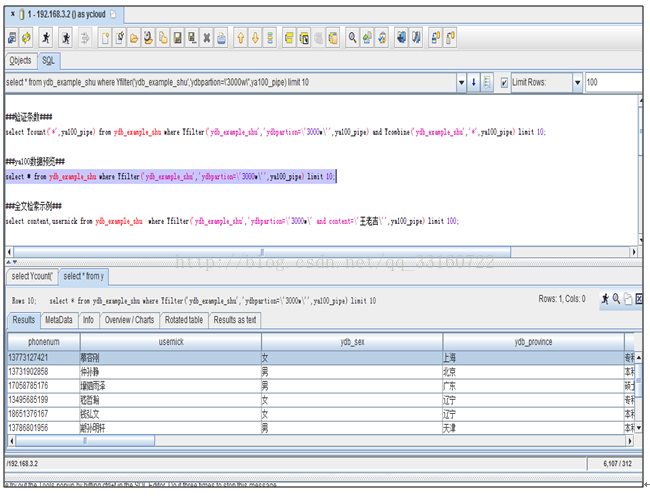
SQL分析工具有很多,只要支持HIVE接口即可,免费的有Squirrel、收费的有DbVisualizer等
4.通过报表分析工具接入
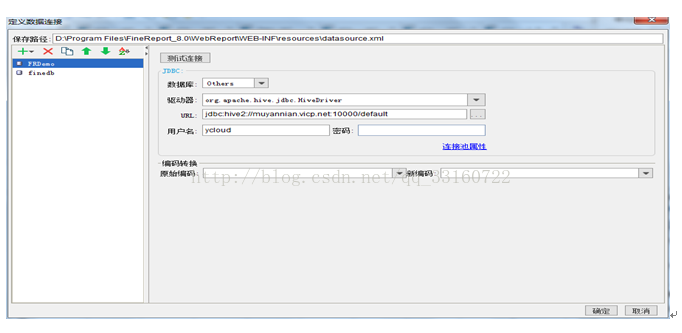
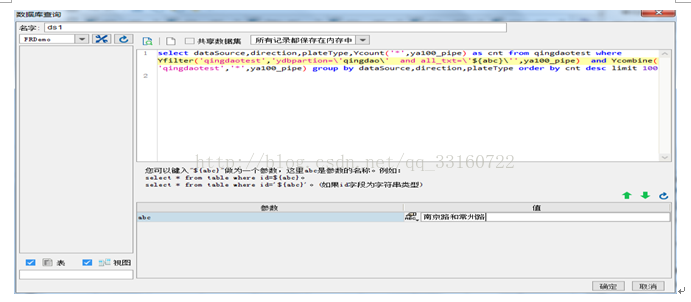
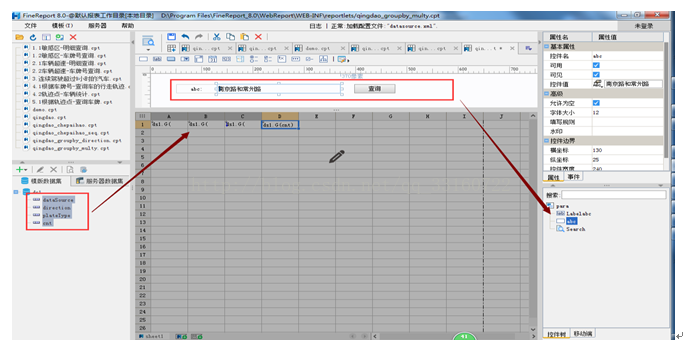
通过可视化报表分析工具,可以极大的提高程序开发的效率,只要是支持HIVE接口的可视化报表工具,都可以与YDB集成,下面以帆软报表为例。
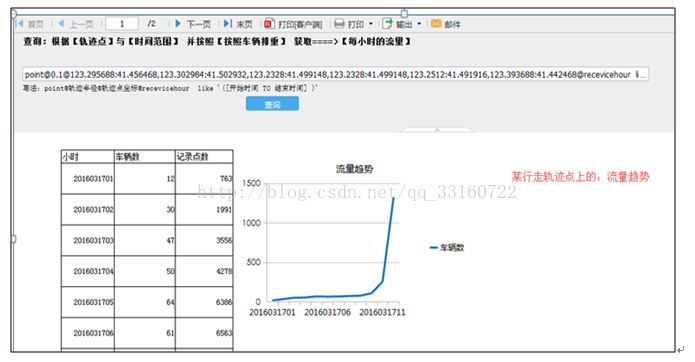
五、YDB分区
1.关于分区的说明
随着时间的日积月累,单个索引会越来越大,从而导致系统瓶颈。YDB不会将全部的数据都完整的创建在一个索引中,YDB会对数据进行分区,分区的方式由用户来定义,可以按照日期分区,也可以按照某些固定的HASH方式来分区。
一条数据的分区,在导入的时候直接指定,具体请参考后面的数据导入用法。
如果按照日期进行分区,每天就会生成一个分区,如需查询哪天的数据,就去对应的分区中检索,其他的分区则闲置。
YDB 的SQL需要通过ydbpartion来指定分区; SQL查询必须要设置分区,而且要写在SQL的最外层。
如果没有指定ydbpartion分区的查询,ydb表默认会去查询 " ydb_default_partion" 这个分区,也就是说,如果我们真的不想进行数据分区,不想在sql上添加ydbpartion的条件来指定分区,那么请将数据都导入到 " ydb_default_partion"这个分区里面。
设置分区例子如下:
ydbpartion =''
ydbpartion in ('','')
目前不支持大于等于,小于等于的范围指定分区,仅支持等于与in的方式。
2.关于分区的数量与粒度,控制多少比较好?
l如果我们的数据可以按照时间进行切分,是不是切分的越细越好?
很遗憾,YDB并不适合特别多的分区,分区越多代表索引文件越多
1)YDB中打开一个索引是有很大的开销的,打开一个索引加载的列的信息、索引的BlockTree的相关主干节点等,需要消耗较多的内存,而且要持久化到内存里去维护这个索引的状态。这就是为什么大家会发现,对于一个表第一次查询会比较慢,但是我们进行一次count以后,在进行别的查询就会快很多。
2)YDB在一个进程里能够打开的索引数量是有限的,如果超过了打开的索引文件数量,那么就要关闭一些索引,以保证内存不会OOM。
3)小文件太多,对HDFS的NameNode的压力较大。
l那么分区粒度控制在多少为好?
基本原则就是在避免索引频繁的打开与关闭的情况下,索引粒度越小越好。
1)如果我们的数量不是很大,一年加在一起还不到10亿,那么我就建议采用按年分区。
2)如果我们的数据处于中等,每月的数据增量为1亿左右,那么我们建议按照季度分区。
3)如果我们的数据每天写入量特别大,如果按照月份分区,单个索引太大会造成写入瓶颈,那么我们建议按照天进行分区。
很多时候我们还可以根据不同的查询方式,采用两种粒度的分区
1)最近一两天的数据经常被查询,我们最近3天的数据按照天进行分区
2)但是偶尔也会发生查询整年的数据,如果采用按天分区的话,一次打开的索引太多,那么我们可以再加一个按照季度的分区。
3)按天的数据分区只保存最近7天的数据,超过7天的数据会通过insert的方式归档按照季度的分区里。
六、YDB的数据类型
1.基本类型
基本类型的存储方式均为 按列存储
| YDB类型 |
只索引 |
只存储 |
Hive类型 |
解释 |
| string |
synn |
--- |
string |
字符串类型,该类型不分词,通常用来存储比较短的字符串,如类目 |
| tint |
tiynn |
--- |
int |
整形32位-适合大范围的range过滤查询 |
| tlong |
tlynn |
--- |
bigint |
整形64位-适合大范围的range过滤查询 |
| tdouble |
tdynn |
--- |
double |
Double类型-适合大范围的range过滤查询 |
| tfloat |
tfynn |
--- |
float |
Float类型-适合大范围的range过滤查询 |
| int |
iynn |
--- |
int |
整形32位,占用存储空间少,但是范围查找性能低 |
| long |
lynn |
--- |
bigint |
整形64位,占用存储空间少,但是范围查找性能低 |
| double |
dynn |
--- |
double |
Double类型,占用存储空间少,但是范围查找性能低 |
| float |
fynn |
--- |
float |
Float类型,占用存储空间少,但是范围查找性能低 |
| geopoint |
--- |
--- |
bigint |
用于地理位置搜索-使用方法详见《26.地理位置感知搜索.txt》 |
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/82105.html