
中文拼写检查一直以来都是研究中的难题,目前主要采用的是基于规则的方法和基于统计的方法,此外再增加人工校验的方式来提升效果。
那么如何更好的实现中文拼写纠错呢?

讯享网
本方案主要分为三部分,包含建立规则字典、字词纠错检测模块、评价纠错模块。
1.建立规则字典
建立常用字字典、相似音字典、相似字字典,这些都可以从网上进行获取。
根据场景建立自定义词典,作为检测白名单。
基于搜索历史query简历词频表,将用户自定义词典也添加到词频表里。
根据历史搜索数据自定义困惑集,可用于后续直接纠正,提升最终纠正效果。
2.字词纠错检测模块
2.1 基于HanLP平台的“错词检测模块
HanLP是一系列模型与算法组成的NLP工具包,由大快搜索主导并完全开源,目标是普及自然语言处理在生产环境中的应用。
HanLP主要功能包括分词、词性标注、关键词提取、自动摘要、依存句法分析、命名实体识别、短语提取、拼音转换、简繁转换等等。
Github地址:https://github.com/hankcs/HanLP
官网地址:http://hanlp.linrunsoft.com/
利用HanLP分词模型对query进行分词得到word序列[word1,word2,word3,…,wordn],并进行词性标注。将分词和词性标注后的结果进行NER,识别人名(nr)、机构名(nt)或者地名(ns)的词加入至白名单。最好将不在白名单的word加入到疑似错误集中,对于单字词则指定错误类型为字粒度,对于多字词则指定错误类型为词粒度。
备注:此实验使用HanLP可以达到目标,如若追求更高精度,也可以基于自己搜索场景的历史数据训练分词模型和NER模型。
2.2 基于BERT预训练模型的错字检测模块
BERT模型此前讲过多次,本次实验使用Bert原因是采用其强大的语义表征能力,BERT拥有多层注意力结构(12层或24层),并且在每个层中都包含有多个“头”(12头或16头)。由于模型的权重不在层与层之间共享,一个BERT模型相当于拥有12×12=224或24×16=384种不同的注意力机制,不同层能够提取不同层次的文本或语义特征,因此BERT具有超强的文本表征能力。
步骤如下:
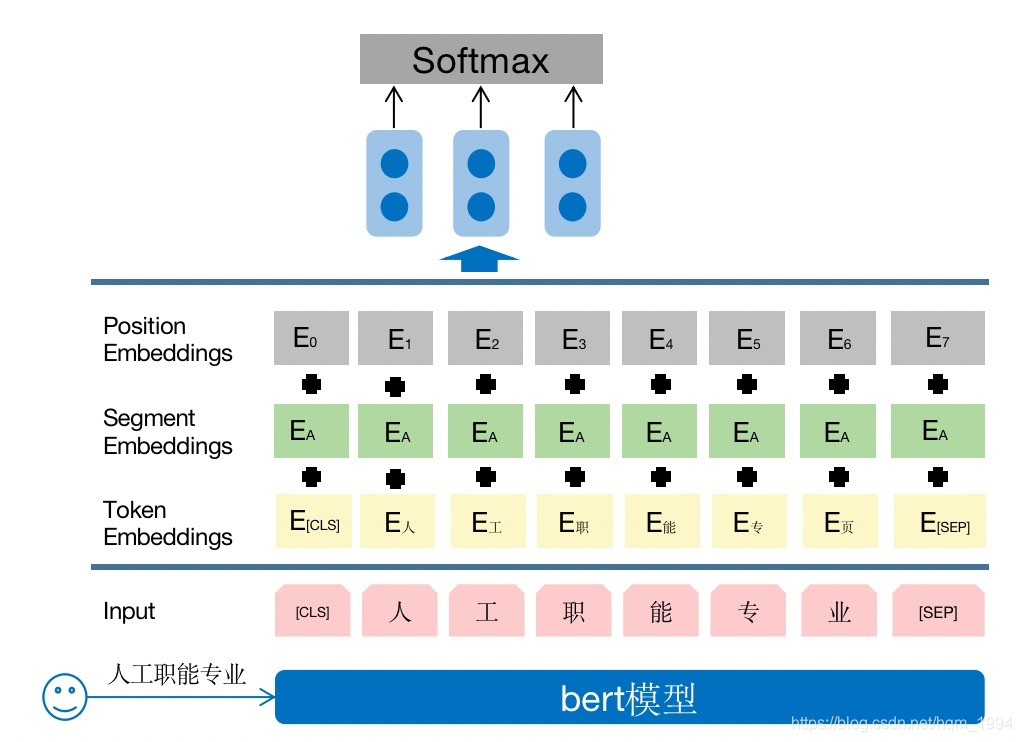
- 提取query特征——将query中的每个字符转换为其在BERT中文模型字典里的字典序号即为句子的特征,此外还有位置特征Position Embedding,如果句子长度小于序列最大长度,则补0直到长度满足。
- 计算query中每个字符出现的概率——在BERT模型框架的基础上添加一个Softmax层。将句子特征从BERT的输入层输入到模型里,通过中间隐藏层复杂的计算后,Softmax层的输出结果即为BERT字典中每个字出现在句子每个位置的概率(矩阵维度:序列最大长度*BERT字典大小)。
- 找出疑似错字——在剔除白名单中出现的字符的概率后,对剩下的所有字符的概率计算其平均绝对离差值,并且通过变量值与其中位数的离差除以平均绝对离差计算标准得分。对于概率小于平均绝对离差并且标准得分大于阈值的字符,我们认为是疑似错字,将其加入到疑似错误集中。
3.评价纠错模块
对于单字词,取其近音字(同音同调字、同音异调字、近音同调字、近音异调字)、同形字以及原字作为纠正候选,按照词频大小进行排列;
对于多字词,对词语里的所有字符的近音字、同形字以及原字做笛卡尔积,如果新组成的多字词存在于词频表里,则加入纠正候选,最后按照词频大小进行排列。
针对纠正候选池,遍历自定义困惑集的所有变体,如果变体在句子中,则直接将变体加入到疑似错误集中,纠正的时候直接用困惑集里对应的本体替换即可。如若不在困惑集中的变体,则利用句子困惑度作为评价函数进行排序。如何计算句子困惑度?首先将纠正候选逐个替换到错误位置上,生成新的句子。提取新句子特征,计算每个字出现的概率,然后将每个字出现的概率取log累加起来求平均最后取反,则可得句子困惑度。
困惑度越低表示句子越流畅,最终取困惑度最低的纠正候选作为最终纠错结果。
本实验充分发挥了BERT的强文本表征能力,利用BERT检测错字及HanLP辅助检测错词和筛选检测结果,使用NER模型避开人名、地名、机构名等命名实体之类,从而降低误检率。在评价纠正候选阶段,利用BERT语言模型计算句子困惑度,作为纠正候选的评分函数。在实际场景中,也加入了用户自定义词典、自定义困惑集模块以及检测白名单或者指定纠正结果来提升纠错准确率,在实际线上取得了比较好的结果。
最后欢迎关注微信公众号:药老算法(yaolaosuanfa),带你领略搜索、推荐等数据挖掘算法魅力。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/79436.html