
目录
一、对于隐私的理解
二、对于差分隐私的理解
三、 前提知识
3.1 符号说明
3.2 数据库
3.3 数据库的距离
3.4 概率单纯形
3.5 随机算法
四、 差分隐私的定义
五、差分隐私中常用的随机化算法(机制)
5.1 敏感度
5.2 拉普拉斯机制(Laplace mechanism)
1.拉普拉斯分布
2.实现拉普拉斯机制
3.拉普拉斯机制满足 (ε,0)-差分隐私的数学证明
5.3 高斯机制
1.高斯分布(正态分布)
2.高斯机制
3.拉普拉斯机制满足 (ε,δ)-差分隐私的数学证明
一、对于隐私的理解
在不同的考量下,隐私的定义也不一样。
百度百科给出的定义:隐私就是一种与公共利益、群体利益无关,当事人不愿意他人知道或他人不便于知道的信息。
目前普遍比较接受的定义是:“单个用户的某一些属性” 可以被看做是隐私。注意该说法所强调的是“单个用户”,也就是说,如果是一群用户的某一些属性,那么可以不看做隐私。
比如,医院发布调查报告说,抽烟的人会有更高几率得肺癌,这个不泄露任何隐私。但是如果医生说,张三因为抽烟,所以有x%的概率得肺癌,这就是个人隐私的泄露。
如果我们拥有一个数据库,那么对精确的个体信息的查询与检索都会泄露隐私,因此对于个人数据的加密是最基本的保护隐私策略。然而,就算我们对个人数据进行了加密,对一群用户的某些属性的查询,以及对查询结果进行加工与建模,也就是“数据分析”,往往也会泄露个人隐私。
那通过分析数据怎么获取个人隐私呢?
比如要查询一个大型医疗数据库,如果我们知道A的信息在数据库中,就可以利用一种叫差分攻击的方法得到个体的信息。可以查询有多少人患糖尿病,假如有100个人,然后条件查询,有多少不叫A的人患糖尿病,假如有99个人,这样经过差分,就得到了A患糖尿病。
差分隐私就是针对差分攻击的隐私保护框架。
二、对于差分隐私的理解
差分隐私想做的事情就是即使攻击者知道发布的100个人的信息,以及A之外另外99个人的信息,也没有办法对比这两个信息之后获取A的信息。
那如何做到这一点呢?
差分隐私就是要用一种方法让攻击者查询100个信息和查询99个信息得到的结果是一致的,这样攻击者就无法找出A的信息。
那如何做到让查询结果一致呢?
就是在查询结果里加入随机性/噪声。 让查询者无法根据返回的带噪声的结果推断出原始数据。
三、 前提知识
3.1 符号说明
- f(x)表示一个查询函数,比如查询count值,最大值,均值,梯度等等。
- R 表示一个实数的概念,上标如果不写表示一维数据,比如最大值;如果是
 表示n维数据,比如梯度。 代表 是n维实数集,即,每个元素是n维向量,向量中的每个分量是实数
- O是一个离散集合,|O|代表集合中元素的数量
- 和θ都表示一个随机噪声,可以服从拉普拉斯分布或者高斯分布。
- x,x′ 表示两个数据库,且只相差了一个样本。
- M(x) 表示最终的一个确定的查询结果f(x)加上一个不确定的随机噪声/θ得到的最终结果。
- ε表示一个很小的值,用来衡量隐私预算。 δ 是一个松弛项,表示可以接受差分隐私在一定程度上的不满足。
3.2 数据库
将数据库视为来自全集 的记录的集合, ,其中每一个表示全集中第i个数据在数据库中的数量。(设表示所有非负整数的集合,包括0)。在这种表示中,可以度量两个数据库x和y的ℓ1距离。
举例:
全集:
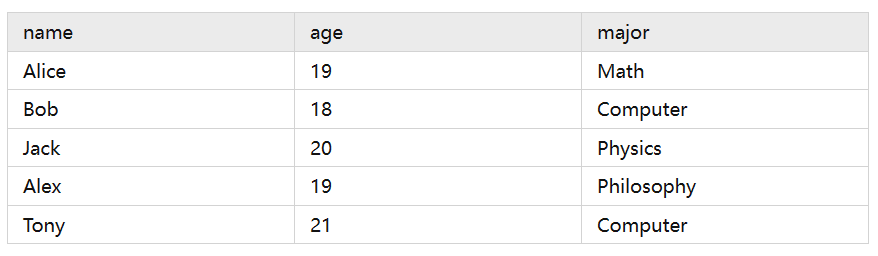
令  ,即中第1个数据在x中的数量为1,第2个数据的数量为0,第3个数据的数量为2....
则数据库x为:

3.3 数据库的距离
衡量两个数据库X和Y的差异是用L1距离来表示。
数据库x的L1范数用表示,其定义为:
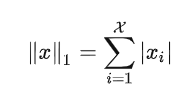
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/78164.html