
一、简介
实现简单的横竖表格图片的识别,提取表格并生成对应的Word文档
二、架构与部署
1.本项目为B/S架构
2.显示页面采用Python的web框架Django搭建页面,负责传入单张的表格图片
3.服务提供使用OpenCV与深度学习神经网络作为表格图片的处理技术
4.运行环境为Ubuntu
5。深度学习神经网络使用TensorFlow框架
三、具体内容
1.成果显示

2.前端页面
利用JS脚本进行图片选择后的预览

3.表格提取
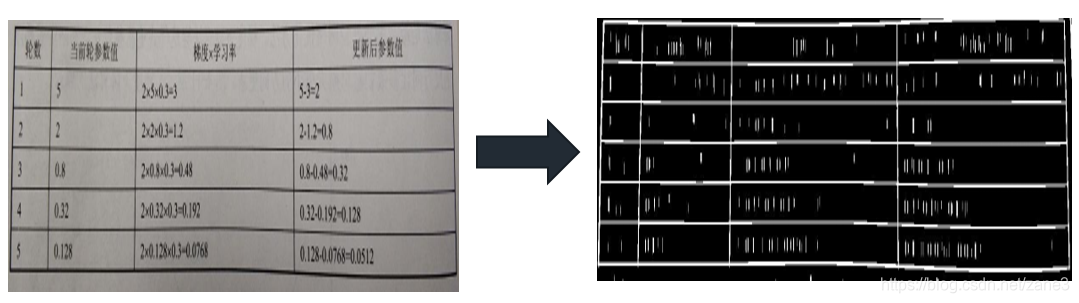
① OpenCV函数对图片灰度处理即二值化处理,腐蚀和膨胀后得到表格线
② 由获得的表格线得到单元格交点坐标,按坐标对表格图片进行分割,分割成多个单元格图片
https://blog.csdn.net/yomo127/article/details/?utm_source=blogxgwz1
文本的定位与识别使用了:CTPN + DenseNet + CTC神经网络
4.CTPN实现图片文字的定位
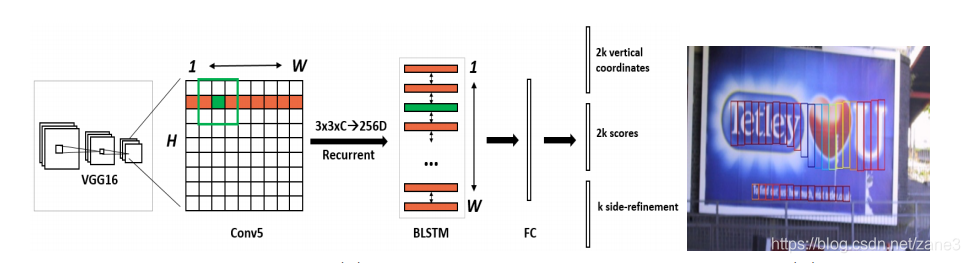
CTPN做图片文本的检测定位文本框:①首先,使用VGG16作为base net提取特征,得到conv5_3的特征作为feature map,大小是W×H×C。②其次,在这个feature map上做滑窗,窗口大小是3×3。也就是每个窗口都能得到一个长度为3×3×C的特征向量。这个特征向量将用来预测和10个anchor之间的偏移距离,也就是说每一个窗口中心都会预测出10个text propsoal。③接着,将上一步得到的特征输入到一个双向的LSTM中,得到长度为W×256的输出,然后接一个512的全连接层,准备输出。④输出层部分主要有三个输出。2k个vertical coordinate,因为一个anchor用的是中心位置的高(y坐标)和矩形框的高度两个值表示的,所以一个用2k个输出。(注意这里输出的是相对anchor的偏移)。2k个score,因为预测了k个text proposal,所以有2k个分数,text和non-text各有一个分数。k个side-refinement,这部分主要是用来精修文本行的两个端点的,表示的是每个proposal的水平平移量。⑤这是会得到密集预测的text proposal,所以会使用一个标准的非极大值抑制算法来滤除多余的box。⑥最后使用基于图的文本行构造算法,将得到的一个一个的文本段合并成文本行。
归纳成一句话就是:卷积神经网络(CNN)VGG16做特征提取,循环神经网络(RNN)BLSTM获得一个有关所有输出文字概率的概率数组
CTPN论文地址:https://arxiv.org/abs/1609.03605
CTPN论文阅读理解文章:http://slade-ruan.me/2017/10/22/text-detection-ctpn/
5.DenseNet+CTC做文本部分的识别
6.补充思路
我们还利用OpenCV将图片文字进行分割,按照单字识别方法去识别文本,但是处理效果并不好,主要原因在于单字分割的不准确性。
参考文章:https://www.cnblogs.com/skyfsm/p/8443107.html
四、相关项目地址
https://github.com/YCG09/chinese_ocr
https://github.com/senlinuc/caffe_ocr
注:以上两个项目地址均为文本识别项目地址,与本篇文章相关的源代码暂时并未给出
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/72790.html