
本贴为复习专用
已更新到C++11的lambda表达式
基础篇
- C++ 完全支持面向对象的程序设计,包括面向对象开发的四大特性:( 封装,抽象,继承,多态 )
- 标准的 C++ 由三个重要部分组成:
- (核心语言),提供了所有构件块,包括变量、数据类型和常量,
- (C++ 标准库),提供了大量的函数,用于操作文件、字符串
- (标准模板库(STL)),提供了大量的方法,用于操作数据结构
- IDE编程步骤
- ①源代码:你手敲的代码
- ②编译器:用来编译源代码, 相当于翻译,把你的C++语言C语言翻译给电脑听,即对电脑讲机器语言,当然也是代码,这里把翻译过的代码叫目标代码,这一步也处理了预处理器包含的指令
- ③目标代码:被编译器编译过的源代码
- ④链接程序=启动代码+库代码+目标代码, 你的程序可能需要调用很多其他的代码来帮助你完成任务,所以需要把他们链接起来, 整合起来的代码就是可执行代码
- ⑤可执行代码, 最终代码即程序运行时的代码
- 文本编辑器包括 (Windows Notepad)、(OS Edit command)、(Brief)、(Epsilon)、(EMACS) 和( vim/vi)
- 文本编辑器的名称和版本在不同的操作系统上可能会有所不同。例如,(Notepad )通常用于 Windows 操作系统上,(vim/vi )可用于 Windows 和 Linux/UNIX 操作系统上。
- C++ 程序的源文件通常使用扩展名( .cpp、.cp 或 .c), 大多数的 C++ 编译器并不在乎源文件的扩展名,但是如果您未指定扩展名,则默认使用 .cpp。
- 写在源文件中的源代码是人类可读的源。它需要"编译",转为机器语言,这样 CPU 可以按给定指令执行程序。
- C++ 编译器用于把源代码编译成最终的可执行程序。
- 最常用的免费可用的编译器是 GNU 的 C/C++ 编译器,
- 如果您使用的是 Linux 或 UNIX,请在命令行使用下面的命令来检查您的系统上是否安装了 GCC:
- 如果您使用的是 Mac OS X,最快捷的获取 GCC 的方法是从苹果的网站上下载 Xcode 开发环境,并按照安装说明进行安装。一旦安装上 Xcode,您就能使用 GNU 编译器。
- 为了在 Windows 上安装 GCC,您需要安装 MinGW。为了安装 MinGW,请访问 MinGW 的主页 www.mingw.org,进入 MinGW 下载页面,下载最新版本的 MinGW 安装程序,命名格式为 MinGW-.exe。当安装 MinGW 时,您至少要安装 gcc-core、gcc-g++、binutils 和 MinGW runtime,但是一般情况下都会安装更多其他的项。添加您安装的 MinGW 的 bin 子目录到您的 PATH 环境变量中,这样您就可以在命令行中通过简单的名称来指定这些工具。当完成安装时,您可以从 Windows 命令行上运行 gcc、g++、ar、ranlib、dlltool 和其他一些 GNU 工具。
-
C++的扩展名往往是.cpp 在linux中往往是.cxx,目标代码文件是.o 可执行文件是.out - 类是一种规范, 描述了你设计的新型数据结构, 对象就是类的实现,即根据这种规范所构造的数据结构, 换句话说,类描述了:(一种数据类型的全部属性包括了可使用它执行的操作), 而对象就是根据这些描述来创建的实体
- 函数可以来自函数库, 类也有类库,ostream和istream系列类就是一种类库,还有fstream系列类,类库不好听我们更喜欢叫系列类
- 预处理器
- 什么是预处理器呢?在主编译之前对源文件进行处理,你不需要进行特殊的操作来调用,只需要#即可
- 使用#Include编译指令,比如#include 就是把iostream文件添加到程序中,这是一种比较典型的预处理器操作,在源代码被编译之前,替换或添加文本
- #include指令会把iostream文件中的内容和源代码一起发送给编译器,具体就是iostream中的全部文件会取代#include 这一行代码,并且不修改源代码文件,而是新生成一个复合文件
- 头文件=包含文件
- iostream这种文件叫包含文件(常常被include包含在其他文件中) ,也叫头文件(常常在程序起始处)
- C++有很多头文件,每个头文件都带来了一组特定的工具
- C的头文件往往是.h扩展名, C++往往是没有扩展名,使用C的头文件时,你需要(去掉.h且在名前加c即cmath=math.h)
- C用不同扩展名表示不同文件类型,C++取消所有扩展名
- 在应用程序中引用非标准库时,可以先去浏览一下这些包含文件,这是最好的文档信息,你可以掌握很多知识,这种行为是很好的习惯
- 名称空间
- 上述头文件去掉了.h其实不是这么简单,而是让没有.h的头文件包含了名称空间
- 名称空间编译指令using namespace 比如using namespace std; 这里是using编译指令
- 打断一下,你现在了解了两个编译指令了,一个是using一个是#include
-
- using std::cout; //通过using编译指令来声明了cout的来源是std名称空间
- using namespace std; cout<<'a'<
- cout预定义的对象,它懂得如何显示字符串,数字和字符等数据
- cout是个对象,那是哪个类的对象呢????
- 插入运算符<<符号可以把信息流入到cout中即cout<<'a'
- cout<<'a'就是把字符a从程序中流出去了, 而cout正是表示了这种输出流,cout对象的具体属性是在iostream头文件中定义的,属性包括了一个插入运算符<<, 可以把数据插入到输出流中
- 控制符endl,表示重启一行,如果把控制符endl也插入到输出流中,那你屏幕光标将会(直接跳到下一行的开头),endl控制符也是iostream头文件中定义的,同样名字也在std名称空间中
- cout代表了输出流,所以并不能移动光标
- cout是指代表了输出流,所以也不能产生空格,如果你需要空格,那就把空格插入到输出流中吧
- C++程序可以看成一组函数, 而每个函数又是一组语句
- 声明语句创建了变量,作用就是:指出了(信息存储的具体位置)和(需要的内存空间大小)
- (计算机存储数据时,必须要知道数据的存储位置和所占内存空间大小)
- 声明语句提供了(存储类型)和(位置标签),位置标签表示了具体位置,存储类型则代表了所占内存空间的大小信息
- 比如int num; int是整数类型,根据计算机系统不同,整数类型所占的内存空间(位数或字节数)也不同,而num则代表了上述内存空间的位置标签,num作为变量是可以改变的,就是内存空间存储的信息是可以修改的
- 不同的数据类型,则代表了不同的内存空间占用的大小数量
- 你不需要管这些底层的事情,编译器会帮你分配好内存并标记好位置
- 定义和声明最好根据函数和变量来分别讨论
- 对于变量而言:
- 变量的声明,指出存储位置和所需空间大小
- 变量的定义,指出存储位置和所需空间大小,且申请相应内存空间
- 对于函数而言:
- 函数的声明,相当于变量声明于变量,声明函数原型
- 函数的定义,给出函数的结构体
- 对于变量而言:
思考:声明、定义、引用三者各什么意思?是否有什么联系??
- 赋值语句=赋值运算符则可以对内存空间中存储的数据进行修改
- 代表输入流的cin对象,插入运算符>>为cin提供了流入方向
- cout和cin都是智能对象,可以通过输入对象的类型而自动调整输入的数据类型
- 换行符\n, 换行符常用在字符串中,其实\n是一个字符,名称是换行符而已,
- 换行符\n和控制符endl的区别
- 显然是字符数量少了\n两个endl四个
- endl能够保证在程序继续运行前刷新屏幕,也就是立即显示在屏幕上,而\n不能, 甚至有时候你要在输入信息后才会有提示
- 当然如果你只想要一个空行,两者都可以选择
- cout<
- cout<<"\n";
- 由于;标志着一条语句的结束, 所以你在一条语句中使用多少回车都是无法表示该语句的结束的,甚至是没有什么影响,所以在一条语句中,回车的作用=空格=制表符(多个空格)
- 这并不意味着你可以随意使用多个空格或者回车, 无论是C还是C++你都不能把空格,制表符,回车,放到元素中(比如变量名), 也不能放到字符串中,这很重要,cout<<"字符串中不能添加回车,不要换行"
- 标记和空白
- 一行代码中不可分割元素比如int 比如main等,都叫做标记,通常我们用空格制表符回车把两个标记分开({}就是用回车分开的)
- 有些可以通过一个空格来分开,有些不可以,比如 int main()你不要把回车插入到int和main中间
基础语法篇
- C++ 程序可以定义为(对象)的集合,这些对象通过(调用)的方法进行交互。现在让我们简要地看一下什么是类、对象,方法、即时变量。
- 对象 - 对象具有状态和行为。例如:一只狗的状态 - 颜色、名称、品种,行为 - 摇动、叫唤、吃。对象是类的实例。
- 类 - 类可以定义为描述对象(行为,状态的模板)。
- 方法 - 从基本上说,一个方法表示一种行为。一个类可以包含多个方法。可以在方法中写入逻辑、操作数据以及执行所有的动作。
- 即时变量 - 每个对象都有其独特的即时变量。对象的状态是由这些即时变量的值创建的。
- main() 是程序开始执行的地方
- 分号是语句结束符。也就是说,每个语句必须以分号结束。它表明一个逻辑实体的结束。
- C++ 标识符是用来标识变量、函数、类、模块,或任何其他用户自定义项目的名称。一个标识符以字母 A-Z 或 a-z 或下划线 _ 开始,后跟零个或多个字母、下划线和数字(0-9)。
- C++ 注释以 /* 开始,以 */ 终止。注释也能以 // 开始,直到行末为止。
| 类型 | 位 | 范围 |
|---|---|---|
| char | 1 个字节 | -128 到 127 或者 0 到 255 |
| unsigned char | 1 个字节 | 0 到 255 |
| signed char | 1 个字节 | -128 到 127 |
| int | 4 个字节 | - 到 |
| unsigned int | 4 个字节 | 0 到 |
| signed int | 4 个字节 | - 到 |
| short int | 2 个字节 | -32768 到 32767 |
| unsigned short int | 2 个字节 | 0 到 65,535 |
| signed short int | 2 个字节 | -32768 到 32767 |
| long int | 8 个字节 | -9,223,372,036,854,775,808 到 9,223,372,036,854,775,807 |
| signed long int | 8 个字节 | -9,223,372,036,854,775,808 到 9,223,372,036,854,775,807 |
| unsigned long int | 8 个字节 | 0 to 18,446,744,073,709,551,615 |
| float | 4 个字节 | +/- 3.4e +/- 38 (~7 个数字) |
| double | 8 个字节 | +/- 1.7e +/- 308 (~15 个数字) |
| long double | 16 个字节 | +/- 1.7e +/- 308 (~15 个数字) |
| wchar_t | 2 或 4 个字节 | 1 个宽字符 |
- unsigned或signed改变范围不改变字节数, short 字节 *0.5, long字节*2,如short int 则字节为2, long int 字节为8
- 使用 (typedef) 为(一个已有的类型取)一个新的名字
- 使用 (sizeof()) 函数来获取各种数据类型的大小。
- 运算符sizeof返回类型或变量长度,单位是B字节
- 对变量操作时, 无需加括号,即int a = 0 ; cout<
- 对数据类型操作时,加括号,即cout<
- sizeof运算符直接指出了整个数组的长度(有多少个元素就有多长)
- sizeof运算符对指针进行操作时,得到的是指针的长度,即使指针指向的是个数组
- strlen()函数则返回可见字符的个数,不包括'\0'空字符
- 枚举
- 枚举类型(enumeration)是C++中的一种派生数据类型,它是由用户定义的若干枚举常量的集合.如果一个变量只有几种可能的值,可以定义为枚举(enumeration)类型。所谓"枚举"是指将变量的值一一列举出来,变量的值只能在列举出来的值的范围内。
- 创建枚举,需要使用关键字 enum。
- 默认情况下,第一个名称的值为 0,第二个名称的值为 1,第三个名称的值为 2,以此类推。但是,您也可以给名称赋予一个特殊的值,只需要添加一个初始值即可。例如,在下面的枚举中,green 的值为 5。
- 在这里,blue 的值为 6,因为默认情况下,每个名称都会比它前面一个名称大 1,但 red 的值依然为 0。
- 代码中是两种不同的创建枚举的方法,第一种方法,name, age,width,height的值,是其下标值,如age下表是1,则age=1;
- 第二种方法,直接赋值,age就是18
- 注意,枚举的各个元素都是符号常量,并且指定的具体数值必须是整数,当然第一种情况默认赋值必然是整数
/* enum 枚举名{ 标识符[=整型常数], 标识符[=整型常数], ... 标识符[=整型常数] } 枚举变量; */ enum color { red, green, blue} c ; c = blue; enum color { red, green = 5, blue}; enum person {name, age, width, height}; enum person0 {name = 1, age = 18, width =120, height=};讯享网
变量
- 变量的名称可以由(字母、数字和下划线)字符组成。它必须以(字母或下划线)开头。大写字母和小写字母是不同的,因为 C++ 是大小写敏感的。
| 类型 | 描述 |
|---|---|
| bool | 存储值 true 或 false。 |
| char | 通常是一个字符(八位)。这是一个整数类型。 |
| int | 对机器而言,整数的最自然的大小。 |
| float | 单精度浮点值。单精度是这样的格式,1位符号,8位指数,23位小数。 讯享网 |
| double | 双精度浮点值。双精度是1位符号,11位指数,52位小数。 |
| void | 表示类型的缺失。 |
| wchar_t | 宽字符类型。 |
使用( extern 关键字)在任何地方声明一个变量
- 左值(lvalue):指向内存位置的表达式被称为左值(lvalue)表达式。左值可以出现在赋值号的左边或右边。
- 右值(rvalue):术语右值(rvalue)指的是存储在内存中某些地址的数值。右值是不能对其进行赋值的表达式,也就是说,右值可以出现在赋值号的右边,但不能出现在赋值号的左边。
- 强制类型转换(这里是简单地类型转换,还有更高级的操作在fstream类中)
- static_cast<>运算符是强制类型转换符
- static_cast (xjh)把xjh变量强制转换成int类型
- 变量定义和变量声明(针对的是变量)
- 声明(declaration):不分配内存。 而 定义:是在变量声明后,给它分配内存
- 上边说的声明是说,指明了存储位置和所需的内存空间大小,并没有申请内存空间
- 而函数,则需要定义前进行声明
- 变量声明=提供名字+存储类型,
- 变量定义=提供名字+存储类型+申请内存空间
- extern外部声明
-
讯享网
// 变量声明 extern int a, b; extern int c; extern float f; // 函数声明 int func(); int main () { // 变量定义 int a, b; int c; float f; // 实际初始化 a = 10; b = 20; c = a + b; cout << c << endl ; f = 70.0/3.0; cout << f << endl ; // 函数调用 int i = func(); return 0; } // 函数定义 int func() { return 0; }
- 声明(declaration):不分配内存。 而 定义:是在变量声明后,给它分配内存
如果只声明不定义会怎么样呢?
#include <iostream> extern int a; int main(void) { extern int b; int a =0; b=1; std::cout<<"a:"<<a<<",b:"<<b<<std::endl; return 0; } >>>g++ main.cpp /tmp/cctOXSfB.o: In function `main': main.cpp:(.text+0x11): undefined reference to `b' main.cpp:(.text+0x50): undefined reference to `b' collect2: error: ld returned 1 exit status 常量
- 在 C++ 中,有两种简单的定义常量的方式:
- 使用 #define 预处理器。
-
- 编译指令#define在编译前在程序中查找所有的INT_MAX,然后用32767替换。完成替换后,程序会被编译
- 当然预处理器仅仅替换独立的标记,而不会替换嵌入INT_MAX的标记,如PINT_MAX或UINT_MAX
-
- 使用 const 关键字。
- 用const的优点:会进行类型安全检查。而define没有安全检查,且可能会产生意料不到的错误。
- 使用 #define 预处理器。
- 整数常量可以是十进制、八进制或十六进制的常量。前缀指定基数:0x 或 0X 表示十六进制,0 表示八进制,不带前缀则默认表示十进制。
- 整数常量也可以带一个后缀,后缀是 U 和 L 的组合,U 表示无符号整数(unsigned),L 表示长整数(long)。后缀可以是大写,也可以是小写,U 和 L 的顺序任意。
讯享网#include <iostream> using namespace std; #define LENGTH 10 #define WIDTH 5 #define NEWLINE '\n' int main() { int area; area = LENGTH * WIDTH; cout << area; cout << NEWLINE; const int NUMBER = 10; const float PRICE= 13.23; double output = NUMBER * PRICE; cout << output; return 0; } /* 212 // 合法的 215u // 合法的 0xFeeL // 合法的 078 // 非法的:8 不是八进制的数字 032UU // 非法的:不能重复后缀 85 // 十进制 0213 // 八进制 0x4b // 十六进制 30 // 整数 30u // 无符号整数 30l // 长整数 30ul // 无符号长整数 */
- 浮点常量
- 由整数部分、小数点、小数部分和指数部分组成。如3.14
- 当使用小数形式表示时,必须包含整数部分、小数部分,或同时包含两者。
- 当使用指数形式表示时, 必须包含小数点、指数,或同时包含两者。
- 带符号的指数是用 e 或 E 引入的。
- 由整数部分、小数点、小数部分和指数部分组成。如3.14
3.14159 // 合法的 E-5L // 合法的 510E // 非法的:不完整的指数 210f // 非法的:没有小数或指数 .e55 // 非法的:缺少整数或分数转义字符
| 转义序列 | 含义 |
|---|---|
| \ | \ 字符 |
| ' | ' 字符 |
| " | " 字符 |
| ? | ? 字符 |
| \a | 警报铃声 |
| \b | 退格键 back |
| \f | 换页符 form feed 换页 |
| \n | 换行符 newline换行 |
| \r | 回车 return |
| \t | 水平制表符 |
| \v | 垂直制表符 |
| \ooo | 一到三位的八进制数 |
| \xhh . . . | 一个或多个数字的十六进制数 |
引用 &
- 引用变量是一个别名,也就是说,它是某个已存在变量的另一个名字。一旦把引用初始化为某个变量,就可以使用该引用名称或变量名称来指向变量。
- 引用和指针的三个不同:
- 不存在空引用。引用必须连接到一块合法的内存。(不存在空引用,存在空指针)
- 一旦引用被初始化为一个对象,就不能被指向到另一个对象。指针可以在任何时候指向到另一个对象。(引用不可二次多次指向,指针可以)
- 引用必须在创建时被初始化。指针可以在任何时间被初始化。
- 变量名称是变量附属在内存位置中的标签,可以把引用当成是变量附属在内存位置中的第二个标签,也就是说修改其一另一个值也会改变,因为对应的内存块的数值变了.
引用时要注意两个两个变量的类型要求保持一致,const引用const int类型将产生错误
讯享网#include <iostream> using namespace std; int main () { // 声明简单的变量 int i; double d; // 声明引用变量 int& r = i; double& s = d; i = 5; cout << "Value of i : " << i << endl; cout << "Value of i reference : " << r << endl; d = 11.7; cout << "Value of d : " << d << endl; cout << "Value of d reference : " << s << endl; return 0; }
- 在这些声明中,& 读作引用。因此,第一个声明可以读作 "r 是一个初始化为 i 的整型引用",第二个声明可以读作 "s 是一个初始化为 d 的 double 型引用"。
存储类
- 存储类定义 C++ 程序中变量/函数的范围(可见性)和生命周期。说明符放置在它们所修饰的类型之前
- auto 存储类, auto 关键字用于两种情况:声明变量时根据初始化表达式自动推断:该变量的类型、声明函数时函数返回值的占位符。
可以使用STL中的 typeid(auto_name).name()来查看类型名
auto f=3.14; //double auto s("hello"); //const char* auto z = new auto(9); // int* auto x1 = 5, x2 = 5.0, x3='r';//错误,必须是初始化为同一 cout<<typeid(x1).name()<<endl; - register 存储类用于定义存储在寄存器中而不是 RAM 中的局部变量。这意味着变量的最大尺寸等于寄存器的大小(通常是一个词),且不能对它应用一元的 '&' 运算符(因为它没有内存位置)。
- 寄存器只用于需要快速访问的变量,比如计数器。还应注意的是,定义 'register' 并不意味着变量将被存储在寄存器中,它意味着变量可能存储在寄存器中,这取决于硬件和实现的限制。
- static 存储类指示编译器在程序的生命周期内保持局部变量的存在,而不需要在每次它进入和离开作用域时进行创建和销毁。因此,使用 static 修饰局部变量可以在函数调用之间保持局部变量的值。
- 当 static 修饰全局变量时,会使变量的作用域限制在声明它的文件内。
- 当 static 用在类数据成员上时,会导致仅有一个该成员的副本被类的所有对象共享。
- extern 存储类用于提供一个全局变量的引用,全局变量对所有的程序文件都是可见的。
- 当您有多个文件且定义了一个可以在其他文件中使用的全局变量或函数时,可以在其他文件中使用 extern 来得到已定义的变量或函数的引用。
- extern 修饰符通常用于当有两个或多个文件共享相同的全局变量或函数的时候,
讯享网//File0 #include <iostream> int count ; extern void write_extern(); int main() { count = 5; write_extern(); } //File1 #include <iostream> extern int count; void write_extern(void) { std::cout << "Count is " << count << std::endl; }
运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| + | 把两个操作数相加 | A + B 将得到 30 |
| - | 从第一个操作数中减去第二个操作数 | A - B 将得到 -10 |
| * | 把两个操作数相乘 | A * B 将得到 200 |
| / | 分子除以分母 | B / A 将得到 2 |
| % | 取模运算符,整除后的余数 | B % A 将得到 0 |
| ++ | 自增运算符,整数值增加 1 |
A++ 将得到 11 |
| -- | 自减运算符,整数值减少 1 |
A-- 将得到 9 |
| && | 称为逻辑与运算符。如果两个操作数都非零,则条件为真。 |
(A && B) 为假。 |
| || | 称为逻辑或运算符。如果两个操作数中有任意一个非零,则条件为真。 |
(A || B) 为真。 |
| ! | 称为逻辑非运算符。用来逆转操作数的逻辑状态。如果条件为真则逻辑非运算符将使其为假。 |
!(A && B) 为真。 |
| sizeof | sizeof 运算符返回变量的大小。例如,sizeof(a) 将返回 4,其中 a 是整数。 |
|
| Condition ? X : Y | 条件运算符。如果 Condition 为真 ? 则值为 X : 否则值为 Y。 |
|
| , | 逗号运算符会顺序执行一系列运算。整个逗号表达式的值是以逗号分隔的列表中的最后一个表达式的值。 |
|
| .(点)和 ->(箭头) | 成员运算符用于引用类、结构和共用体的成员。 |
|
| Cast | 强制转换运算符把一种数据类型转换为另一种数据类型。例如,int(2.2000) 将返回 2。 |
|
| & | 指针运算符 & 返回变量的地址。例如 &a; 将给出变量的实际地址。
|
|
| * | 指针运算符 * 指向一个变量。例如,*var; 将指向变量 var。 |
|
对于++和--,只要用对象,就进行自加自减,比如
int a = 0; int b = 0; a++; cout<<a; cout<<b++; cout<<b; //输出 1 0 1
循环与判断
- 循环控制语句
- break 终止 loop 或 switch 语句,程序流将继续执行紧接着 loop 或 switch 的下一条语句。
- continue 引起循环跳过主体的剩余部分,立即重新开始测试条件.
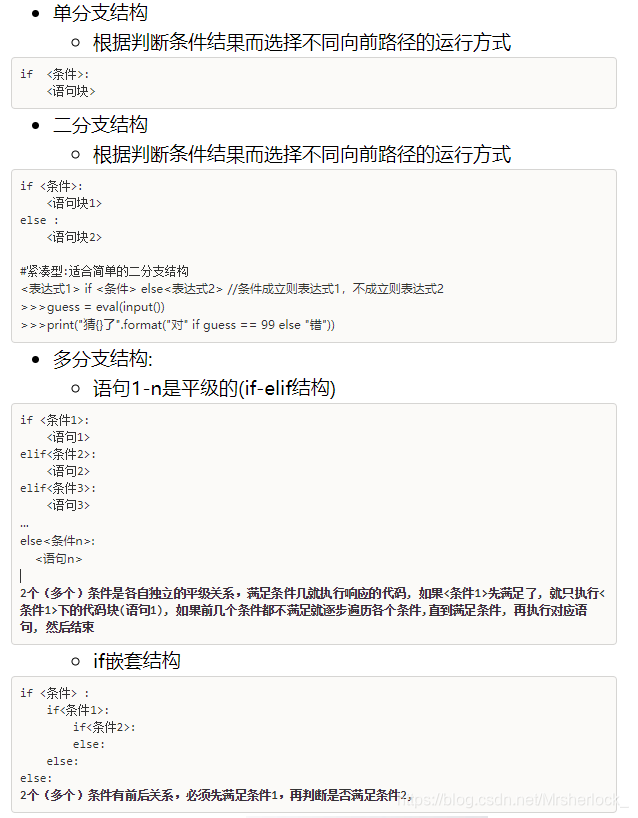
- 判断语句(拿python笔记充数,逻辑是同样的)
- ? : 运算符 可以用来替代 if...else 语句。
讯享网Exp1 ? Exp2 : Exp3;
- 如果 Exp1 为真,则计算 Exp2 的值,结果即为整个表达式的值。如果 Exp1 为假,则计算 Exp3 的值
函数参数
- 如果函数要使用参数,则必须声明接受参数值的变量。这些变量称为函数的形式参数。
形式参数就像函数内的其他局部变量,在进入函数时被创建,退出函数时被销毁。
当调用函数时,有两种向函数传递参数的方式:
| 传值调用 | 该方法把参数的实际值复制给函数的形式参数。在这种情况下,修改函数内的形式参数对实际参数没有影响。 |
| 指针调用 | 该方法把参数的地址复制给形式参数。在函数内,该地址用于访问调用中要用到的实际参数。这意味着,修改形式参数会影响实际参数。 |
| 引用调用 | 该方法把参数的引用复制给形式参数。在函数内,该引用用于访问调用中要用到的实际参数。这意味着,修改形式参数会影响实际参数。 |
- 当您定义一个函数,您可以为参数列表中后边的每一个参数指定默认值。当调用函数时,如果实际参数的值留空,则使用这个默认值。
- C++ 内置了丰富的数学函数,可对各种数字进行运算。下表列出了 C++ 中一些有用的内置的数学函数。为了利用这些函数,您需要引用数学头文件
| 序号 | 函数 & 描述 |
|---|---|
| 1 | double cos(double); 该函数返回弧度角(double 型)的余弦。 |
| 2 | double sin(double); 该函数返回弧度角(double 型)的正弦。 |
| 3 | double tan(double); 该函数返回弧度角(double 型)的正切。 |
| 4 | double log(double); 该函数返回参数的自然对数。 |
| 5 | double pow(double, double); 假设第一个参数为 x,第二个参数为 y,则该函数返回 x 的 y 次方。 |
| 6 | double hypot(double, double); 该函数返回两个参数的平方总和的平方根,也就是说,参数为一个直角三角形的两个直角边,函数会返回斜边的长度。 |
| 7 | double sqrt(double); 该函数返回参数的平方根。 |
| 8 | int abs(int); 该函数返回整数的绝对值。 |
| 9 | double fabs(double); 该函数返回任意一个浮点数的绝对值。 |
| 10 | double floor(double); 该函数返回一个小于或等于传入参数的最大整数。 |
#include <iostream> #include <cmath> using namespace std; int main () { // 数字定义 short s = 10; int i = -1000; long l = ; float f = 230.47; double d = 200.374; // 数学运算 cout << "sin(d) :" << sin(d) << endl; cout << "abs(i) :" << abs(i) << endl; cout << "floor(d) :" << floor(d) << endl; cout << "sqrt(f) :" << sqrt(f) << endl; cout << "pow( d, 2) :" << pow(d, 2) << endl; return 0; }随机数
- 随机数生成器,有两个相关的函数。一个是 rand(),该函数只返回一个伪随机数。生成随机数之前必须先调用 srand() 函数。
- 下面是一个关于生成随机数的简单实例。实例中使用了 time() 函数来获取系统时间的秒数,通过调用 rand() 函数来生成随机数:注意需要包含的库文件
讯享网#include <iostream> #include <ctime> #include <cstdlib> using namespace std; int main () { int i,j; // 设置种子 srand( (unsigned)time( NULL ) ); /* 生成 10 个随机数 */ for( i = 0; i < 10; i++ ) { // 生成实际的随机数 j= rand(); cout <<"随机数: " << j << endl; } return 0; }
数组
- C++ 支持数组数据结构,它可以存储一个固定大小的相同类型元素的顺序集合。
- 如何数组声明?
typeName arrayName[arraySize]; - 其中typeName是你元素类型, arrayName是你的自定义数组名,arraySize是你自定义数组长度(不能是变量必须是const)即元素总个数
- 举例说明数组的复合意义?float xjh[1228]; 这里的xjh类型不是数组,而是float数组, 要这么说:"你要建立一个int数组或者float数组"
- 数组从0开始索引并用[下标]来索引
- 数组赋值也不被允许,即int xjh[3] = {1,2,2,8};int xjh1[3] = {1,2,2,8};xjh1 = xjh;这种操作不被允许,只能通过下标访问元素来对某个元素进行赋值,修改等
- 所有的数组都是由连续的内存位置组成。最低的地址对应第一个元素,最高的地址对应最后一个元素。
- 声明数组,需要指定元素的类型和元素的数量,type arrayName [ arraySize ];
- 这叫做一维数组。arraySize 必须是一个大于零的整数常量,type 可以是任意有效的 C++ 数据类型。
- 初始化数组
- 可以逐个初始化数组,也可以使用一个初始化语句
- 大括号 { } 之间的值的数目不能大于我们在数组声明时在方括号 [ ] 中指定的元素数目
讯享网
double balance[5] = {1000.0, 2.0, 3.4, 7.0, 50.0}; - 如果您省略掉了数组的大小,数组的大小则为初始化时元素的个数。
double balance[] = {1000.0, 2.0, 3.4, 7.0, 50.0};快速初始化,举例如int数组 int xjh[3] = {1,2,2,8}; 即利用{}来对元素对位初始化
- 注意{}只能在初始化时使用,若int xjh[3]; 然后再xjh[3] = {1,2,2,8};则不被允许
- 数组元素可以通过数组名称加索引进行访问。元素的索引是放在方括号内,跟在数组名称的后边。
- 数组赋值,只能元素对元素,不能数组名对数组名,如下操作是非法的
讯享网
int array[3] = {1,2,3}; int array1 = array;二维数组
- 先看data,显然我们知道data是个数组名,也是个指针,常规的int data[];是说data是个int数组,data也是个指向int类型的指针
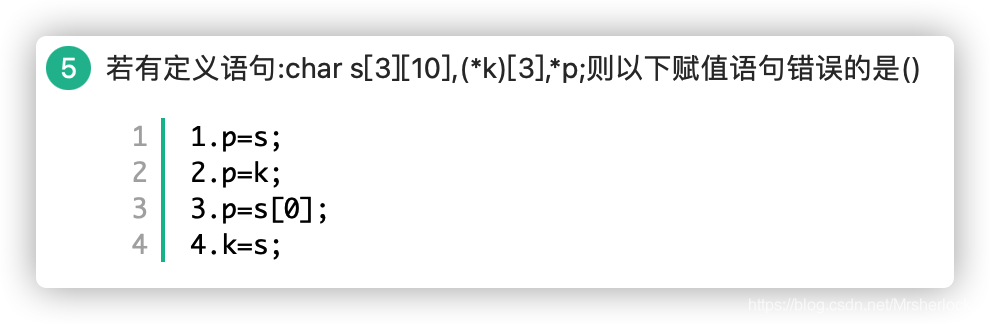
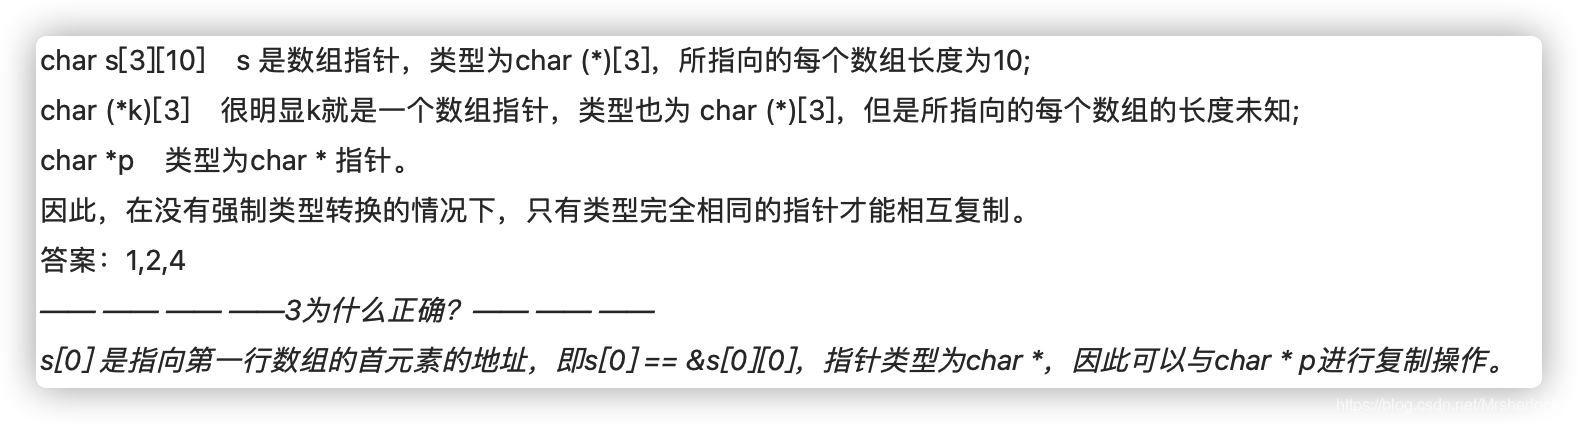
int data[3][4] = { {1,2,3,4}, {5,6,7,8}, {1,2,3,4}}; int (*data)[4]; - 这里的data是什么呢? data是 一个指针,这个指针指向的是个数组,这个数组是由4个int类型元素构成的,即int (*data) [4] ;这样太晦涩难懂了, 也可以这样int data[][4];意义完全相同,这里都表明了data不是数组而是指针
思路:
1⃣️int data[][3];可以看成int (*data)[3],即data是个指针,指向一个包含了3个int的数组
2⃣️指针完全可以用作数组名,例如int* ptr; ptr[1];,那么data则可以当做数组名,从而int data[][3];
- 这里明白了,那么如何传递数组的长度呢?
- 显然int data[][4]对行数是没有限制的,只是明确了列数要是4,即data指针指向的每个数组长度是4
- 同样的,函数对C风格字符串没有办法传递和返回,我们直接用string更合适
- 函数指针,函数指针这里交给指针笔记记录
- 二维数组和指向数组的指针
- 二维数组=指向数组的指针,因为指针名完全可以当成数组名来使用,数组名也可以当成指针来使用
-

讯享网
double (*ptr)[4]; double arr[][4]; // arr[][4] 换一个写法 (*arr)[4] //(*ptr)[4] 完全可以把ptr当成数组名来使用 ptr[][4]
字符串
基于数组的字符串即C-style stringC⻛格字符串
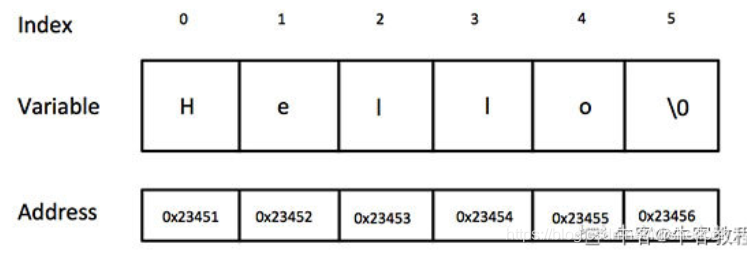
- 字符串实际上是使用 null 字符 '\0' 终止的一维字符数组。因此,一个以 null 结尾的字符串,包含了组成字符串的字符。
-
char greeting[6] = {'H', 'e', 'l', 'l', 'o', '\0'}; char greeting[] = "Hello"; //上述两个语句是一样的效果
| 序号 | 函数 & 目的 |
|---|---|
| 1 | strcpy(s1, s2); 复制字符串 s2 到字符串 s1。 |
| 2 | strcat(s1, s2); 连接字符串 s2 到字符串 s1 的末尾。 |
| 3 | strlen(s1); 返回字符串 s1 的可见长度。(不包含NULL字符,即'\0') |
| 4 | strcmp(s1, s2); 如果 s1 和 s2 是相同的,则返回 0;如果 s1s2 则返回值大于 0。 |
| 5 | strchr(s1, ch); 返回一个指针,指向字符串 s1 中字符 ch 的第一次出现的位置。 |
| 6 | strstr(s1, s2); 返回一个指针,指向字符串 s1 中字符串 s2 的第一次出现的位置。 |
| 7 | sizeof(s1);返回整个数组的长度,包括任何字符 |
- 'S'是字符常量,相当于83的另一个写法
- "S"是字符串,字符串"S"双引号表示,他是两个字符,即'S'和'\0',而且,"S"表示的其实是字符串所在的内存地址(地址在C++中是一个独立类型,你要用这种眼光去审视地址)
- istream中的类cin提供了面向行的类成员函数getline()和get()
- getline()从输入队列中读取输入内容, 遇到换行符停止读取,同时将换行符丢弃
- getline(name,20) 读取19个元素和一个换行符
- get()从输入队列中读取输入内容,遇到换行符停止读取,同时将换行符返还给输入队列
- 如果想提出换行符,可以利用空参数的cin.get(),它可以读取任何字符,用它来处理换行符,为下一行做准备
- getline()从输入队列中读取输入内容, 遇到换行符停止读取,同时将换行符丢弃
注意区分cin.get()和getline(),前者是类方法,后者是函数
get与getline区别
讯享网char arr[100]; cout<<"输入一段文字:"<<endl; cin.getline(arr,20); //使用getline cin.get(arr,20); //使用get
get与getline有两个参数,第一个参数是用来存储的数组名称,第二个参数代表着读取的字节数。
输入:asdfg 回车
get:只读取asdfg不读取回车,会导致下一个读取输入时第一个读取“回车”。
getline:getline读取asdfg回车,并将回车转换为“\0”读取,所以最终读取的是“asdfg\0”输入序列中无回车,下一个读取将会正常读取。
- 字符串输入,cin对象的解释
- cin对象通过使用空白,即空格,制表符(多个空格)换行符, 来确定字符串的结束位置, 这说明cin对象在输入流中每次只读取一个单词, 读取单词后就把它放到数组中并自动添加空字符
基于string类库的字符串
- 首先你要包含string类库文件(头文件), string类的名称在标准名称空间std中,std::string即可完成引用
- String类的对象来存储字符串,String类的设计让程序可以自动处理字符串的大小
- 数组不能赋值,但是String类对象可以,string s1;string s2; s1=s2;是允许的
- 还可以通过+来进行拼接合并,这里是无缝合并
- 通过类方法.size()可以快速获得String类对象的长度
C++ 日期 & 时间
- C++ 标准库没有提供所谓的日期类型。C++ 标准库没有提供所谓的日期类型。需要在 C++ 程序中引用 头文件。
指针
在学习指针时,首先要知道()的优先级高于 [] , 且 [] 的优先级高于*
明确这一点,可以对包含指针的语句分析时,抽丝剥茧,快速理解复杂的语句。
| A.B 直接成员运算符 |
A为对象或者结构体,访问A的成员B,若A是指针则不适用 |
| A->B间接成员运算符 | A为指针,->是成员提取,A->B是提取A中的成员B,且A只能是指向类,结构的指针 |
| :: | 作用域运算符,A::B表示作用域A中的名称B, A是命名空间,类,结构 |
| : | 表示继承 |
| :: | 作用域解析 | 作用域解析最优先 小中括号是二三 成员访问后增减 地址后边解引用 |
| () | 小括号 | |
| [] | 中括号,数组 | |
| -> | 成员访问 | |
| ++ | 后缀自增 | |
| -- | ||
| ! | 非 | |
| ~ | 位非 | |
| + | 正,加 | |
| - | ||
| ++ | 前缀自增 | |
| -- | ||
| & | 地址 | |
| * | 解除引用(指针) | |
- 指针是一个变量,存储的是地址信息
- P的值是地址
- *P的值是指向的数据值,完全可以把*P看成一个普通变量
- 获取地址值&
- 对于普通变量,想要获得该变量的地址,需要用地址运算符&,即&a表示的就是变量a的地址,和P一个意思
- *运算符也被称为是解除引用运算符
- 声明指针
- 指针的声明必须,指定指向的数据类型,如 int * p;
- 这里的*p 的数据类型是int,
- p是指向int类型的指针
- int *p 强调*p是个int类型,把 *p 看成普通int类型变量
- int* p强调int*是一种类型,即p是指向int类型的指针,强调的是int* ,把int*看成一种数据类型
- 指针的声明必须,指定指向的数据类型,如 int * p;
double * p; //定义声明了一个指向double类型的指针p double* p; //定义声明了一个指向double类型的指针p,强调p是指向double类型的指针变量 double *p; //定义声明了一个指向double类型的指针p,强调*p是double类型- 指针初始化
- Question: 初始化的是指针地址还是指针指向的数据值?
- 初始化的是指针存储的地址
- int *p = &a ;
- Question: 初始化的是指针地址还是指针指向的数据值?
- 指针可以用关系运算符进行比较,如 ==、< 和 >。如果 p1 和 p2 指向两个相关的变量,比如同一个数组中的不同元素,则可对 p1 和 p2 进行大小比较。
- &运算符注意点
- 对数组名进行&操作时,得到的是整个数组的地址,而不是第一个元素的地址(数组名=第一个元素的地址,无需&运算符),虽然这两个地址是相同的,但是操作起来时会有明显差异,如下:
- &array[2]得到的是一个2字节的内存块的地址值,而&array则是一个20个字节内存块的首地址
内存分配
栈区(stack):栈区的空间由操作系统自动分配和释放,该部分主要用于存放函数的参数值、局部变量等,比如声明在函数中的一个局部变量int b,系统就会自动在栈中为b开辟空间。栈区的操作方式类似于数据结构中栈(这也许是造成许多人混淆的地方,正如有的人所说,我们可以把数据结构的栈理解成某个技术,而内存的栈正好用到了该技术,但二者其实并不一样)。另外需要注意的是,在windows下,栈是向低地址扩展的数据机构,是一块连续的内存区域。也就是说栈顶的地址和栈的最大容量是系统预先设定好的,比如在windows下,栈的大小为2MB(也有的说是1MB,总之是一个编译时就确定的常数),如果申请的空间超过栈的剩余空间,将会提示overflow。总之就是说栈的空间是有限的。
堆区(heap):堆区空间一般由程序员分配和释放(需要注意堆区与数据结构中的堆是两回事,其分配方式类似于链表),比如,在C中用malloc函数--- p1 = (char*) malloc(10); 在C++中用new,都将分配堆区空间。不过要注意p1本身是在栈中。
静态数据区:全局变量和静态变量都存放于该区。初始化的全局变量和初始化的静态变量放在一块区域,未初始化的全局变量和未初始化的静态变量放在相邻的另一区域。程序结束后由系统自动释放。
代码区:该区用于存放函数体的二进制代码。
- 存储类型
- 自动存储
- 在函数内部定义或{}内的常规变量,使用自动存储空间,使用自动存储类型的变量叫自动变量,其使用的存储空间成为栈
- 自动变量其实是局部变量,随函数调用诞生,结束消亡
- 栈即LIFO后入先出
- 静态存储
- 程序执行期间都存在的存储方式,可以通过函数体or {} 外定义它,也可以通过声明变量时使用关键字static
- 只要程序活着,静态变量就一直存在
- 动态存储
- 运算符new和delete管理一个内存池,相当于自动存储的栈,但这里叫做堆,栈和堆事独立分开的
- 动态存储在程序运行时按需分配内存,用完就删除
- 自动存储
- 模版类vector
- vector也是一种动态数组,同样是new和delete管理内存的,但vector是自动完成的
- vector name(number);
- vector name;
- 指针和运算符
- 指针算术上述已有所述,这里结合自增运算符
- *++p,这里表示先把p的地址值增加1个单位的字节数,再结合*解除运算符
- *p++,同理
- ++*p,这里是把*p直接看成普通变量,再结合++自增运算符
- (*p)++ 这里是把*p看成普通变量
指针 vs 数组
数组名是一个常量指针
指向数组的指针
牢记下边两个恒等式 arr为数组名,p为数组名地址值赋值的指针, p=arr
左边是数组表示法,右边是指针表示法
arr[i] == *(p+i)
&arr[i] == p + i
- 一个指向数组开头的指针,可以通过使用指针的算术运算或数组索引来访问数组(就是上述两个式子)
- 指针和数组并不是完全互换的,数组名相当于一个指针常量,其值为数组0号元素的首地址。
- 不可改变数组名的值,但指针变量可以进行运算
- 指针运算符 * 应用到 数组var上是完全可以的,但修改var存储的值是非法的,只能修改var代表的数组的数组成员的值。
- 例外:sizeof运算符对数组名取长度,返回的是整个数组长度
讯享网
#include <iostream> using namespace std; const int MAX = 3; int main () { int var[MAX] = {10, 100, 200}; int *ptr; ptr = var; for (int i = 0; i < MAX; i++) { *var = i; // 这是正确的语法 var++; // 这是不正确的 ptr++; //TRUE, 指针加1个int单位字节,从而指向了下一个元素 } return 0; } - 数组名等于第0个元素的首地址
- arr和&arr[0]相同,第0个元素首地址
- arr和&arr虽然值相同,但是arr是第0个元素首地址,而&arr是整个数组首地址
- 当赋给指针进行算术运算时,前者将增减一个元素内存字节大小,而后者将增减一个数组字节大小
- 创建一个指向数组的指针
- 下边代码中:
- pa是个指针,指向数组0元素首地址
- pb是个指针,和pa相同
- pbb是个指针,与pa,pb同值,但pbb指向的是整个数组
- pc是个指针,指向一个包含了100个double的数组
- pd是个数组,该数组包含了100个double*指针元素
- 下边代码中:
double arr[100]; double *pa = arr; double *pb = &arr[0]; double *pbb = &arr; double (*pc)[100]; double *pd[100];new运算符分配内存
- 在C语言中,使用库函数malloc()来分配内存,在C++中也兼容,但是推荐使用new运算符来分配内存
- new运算符的操作流程:
- ①在运行阶段为一个int值即int类型的数据,该数据没有名字,即无内存标签,为这个数据来分配未命名的内存(这个int类型数据是占内存空间的,只不过没有为这个内存空间打标签)
- ②分配未命名的内存,同时利用指针访问这个内存块
- ③我只需要告诉new,我需要创建一个什么类型的数据即可
- ④new运算符会自动找到一个合适的内存块,并返回内存块的地址
- ⑤总而言之,我只需要告诉new数据类型即可,new会把一个对应的内存块地址交给一个指针
- int * ptr = new int;
- 前后两个数据类型要对应,这里是int
- Q:指针初始化和new分配内存有什么区别呢?
- int * p = &a; 指针初始化,可以通过非指针变量来访问数据,即通过a来修改内存块中的数值,也可以通过*p来修改
- int * ptr = new int; new分配内存只能通过*ptr来修改访问数据
- Q:对地址你了解多少呢?
- 地址是内存块的名字,变量则是内存块的标签
- 注意:地址只是内存块的第一个bit的名,比如x0,如果是int类型,那么加32就是该内存块的最后一个bit的地址名
new运算符创建动态数组
- 当数据量很大时,应避免使用常规数组,字符串,结构等,应尽量使用new运算符来创建动态数组
- 场景: 当你写程序时,发现不确定是否使用数组,那么用不用数组全看输入什么数据,这时候就需要了解一下静态联编和动态联编的问题
- 静态联编: 在编译时分配内存,不管程序是否调用数组,都会占据相应的内存空间
- 动态联编: 在编译时不分配内存,即在运行时根据程序是否调用而创建相应大小的内存空间,创建的长度和实际长度相同,这种特殊的数组叫做dynamic array动态数组\
- int *ptr_dynamic_array = new int[11];
- []表示元素个数
- new返回数组第一个元素的地址
- 使用完毕时,要使用delete运算符释放数组,直接delete ptr_dynamic_array
- 动态数组的使用,只需要把指针当作数组名来用即可,比如ptr_dynamic_array[10]
- new运算符的补充
- 通过new运算符可以创建动态数组,也可以创建动态结构和动态类,原理和new创建动态数组一样,即在运行时按需分配内存块,返回内存块首地址
- inflatable * ps = new inflatable;
- *ps是个inflatable结构类型的指针,inflatable*和int*一个道理
- 这里补充一下,如果你的指针是个结构,那么成员的访问就需要用成员运算符->来访问
指针算术
- 指针+1,这里+1表示增加1个指针指向类型的内存字节数,比如int * p; p+1表示p存的地址值增加8个字节
- 数组,地址,指针
讯享网
#include <iostream> using namespace std; int main() { int arr[3] = {0,1,2}; cout<<arr[0]<<endl; cout<<arr<<endl; cout<<&arr<<endl; cout<<&arr[0]<<endl; return 0; } 0 0x7ffdbb824d74 0x7ffdbb824d74 0x7ffdbb824d74- 变量指针可以递增,数组不能递增,数组可以视为一个常量指针。
- 数组名是其第一个元素的地址值,指针变量存放的也是地址值,所以指针变量可以当作数组名使用。
- 对数组名进行&取地址,需要注意:
- 对数组名取地址,&tell得到的是整个数组的地址,即得到的是一个数组所占内存块的块地址,&tell
- 对数组名取地址后,&tell 所可以赋值的指针,则是指向了一个包含了10个元素的数组
- 将&tell + 2那么,地址必然增加的是20
- 对数组第一个元素取地址,&tell[0] 就是一个元素所占内存块的块地址,往往默认为是数组名tell
- 把数组名tell看成指针,由于tell就是&tell[0],那么tell就是一个指向short类型的指针常量,
- 将tell+1,那么地址增加2个字节
- 对数组名取地址,&tell得到的是整个数组的地址,即得到的是一个数组所占内存块的块地址,&tell
- 因此对于数组和指针,既可以使用数组表示法,也可以使用指针表示法。
int main(){ double * ptr = new double; ptr[1] = 100.21; cout<<*(ptr+1)<<endl; return 1; } // 100.21 #include <iostream> using namespace std; const int MAX = 3; int main () { int var[MAX] = {10, 100, 200}; int *ptr; // 指针中最后一个元素的地址 ptr = &var[MAX-1]; for (int i = MAX; i > 0; i--) { cout << "Address of var[" << i << "] = "; cout << ptr << endl; cout << "Value of var[" << i << "] = "; cout << *ptr << endl; // 移动到下一个位置 ptr--; } return 0; } Address of var[3] = 0xbfdb70f8 Value of var[3] = 200 Address of var[2] = 0xbfdb70f4 Value of var[2] = 100 Address of var[1] = 0xbfdb70f0 Value of var[1] = 10 #include <iostream> using namespace std; int main() { int max = 3; int* ptr = new int[max]; *ptr = 5; ptr[1] = 11; ptr[2] = 12; for(int i=0;i<3;i++) { cout<<"ptr["<<i<<"]= "<<ptr[i]<<endl; } return 0; } ptr[0]= 5 ptr[1]= 11 ptr[2]= 12 int coats [10]; * (coats +4) = 99; //解释: //coats表示数组第一个元素地址,+4则地址增加4个int内存空间,即移动到coats[4]的位置 //*(coats+4) 和 coats[4] 等价辨析:
讯享网short (*pas)[20]; short *pas[20]; int *ar2[4]; int (*ar2)[4]; //解析 //牢记优先级() [] * short (*pas)[20]; //pas是指针,指向由20个short元素组成的数组的指针 short *pas[20]; //pas是个数组,包含了20个指向short类型指针的数组 int *ar2 [4]; //ar2是个数组,表示由4个int指针组成的数组 //-1-参考int arr[4];表示arr是个int数组,长度为4 //-2-int* ar2[4];表示ar2是个int*数组,长度为4,只不过元素都是只想int的指针 int (*ar2) [4];//ar2是个指针,指向一个包含了4个int的数组 //-1-先看括号里面,(*ar2),表示ar2是个指针 //-2-再看括号外面,int ()[4];表示名为()的int数组,长度为4
指针和const
- const表示常量,对于指针而言,有两个目标,一个是指针存的地址值,另一个是指针指向的变量值
- 直接举栗子说明
// NO.1 right int age = 30; const int * p = &age; //无法通过p修改age,age自身可修改 // NO.2 right const int age = 30; const int * ptr = &age; //无法通过ptr修改age,age自身不可修改 // NO.3 false const int age = 30; int *ptr = &age; //可通过ptr修改age,age自身不可修改,矛盾,ERROR - 接下来辨析如下四种类型,主要是指针常量, 指针变量,和常量,变量之间的关系辨析
- int* 指针 不能用const int变量来初始化,反之可以
讯享网#include <iostream> using namespace std; int main() { /*当对象是变量或者常量时,思考const的存在或不同位置,能否导致指针自身和指针指向的对象 改变?*/ int num = 10; //当对象是int变量 int test = 1; int * num_ptr0 = # // TRUE, *num_ptr0,可修改,num_ptr0可修改,num可修改 const int * num_ptr1 = # // TRUE, *num_ptr1常量不可修改,num_ptr1可修改,num可修改 int * const num_ptr2 = # // TRUE, *num_ptr2可以修改, num_ptr2不可修改,num可修改 const int* const num_ptr3 = # // TRUE, *num_ptr3常量不可修改, num_ptr3常量不可修改,num可修改 const int price = 100; //当对象是int常量 int * price_ptr0 = &price; //ERROR, 指针指向类型和指向对象类型不匹配, nt类型的实体不能用const int来初始化,反之可以 const int *price_ptr1 = &price; //TRUE, int * const price_ptr2 = &price; //ERROR, 指针指向类型和指向对象类型不匹配, int类型的实体不能用const int来初始化,反之可以 const int* const price_ptr3 = &price; //TRUE return 0; }
- 在变量声明的时候,如果没有确切的地址可以赋值,为指针变量赋一个 NULL 值是一个良好的编程习惯。赋为 NULL 值的指针被称为空指针。
- 如需检查一个空指针,您可以使用 if 语句,
#include <iostream> using namespace std; int main () { int *ptr = NULL; cout << "ptr 的值是 " << ptr ; return 0; } ptr 的值是 0 if(ptr) /* 如果 ptr 非空,则完成 */ if(!ptr) /* 如果 ptr 为空,则完成 */函数指针
指向函数的指针
- 获取函数的地址
- 直接使用函数名(注意区分函数名和函数返回值),如下,think为函数名,think()为函数返回值。
讯享网process(think); process(think());
- 声明函数指针与初始化赋值
- 牢记优先级() [] * 的顺序为从高到低
- 需指定函数的返回类型、特征标(直接将函数声明的函数名用指针替换即可,如下)
double pam(int); double (*f)(int); f = pam;- 函数指针的调用
- 直接把(*f)或者f作为函数名pam来用,都可以,注意(*f)的括号()
讯享网double pam(int); double (*f)(int); f = pam; double x = pam(4); double y = (*f)(4); double z = f(4);
- 辨析
double pam(int); double *f1(int); double (*f2)(int); int arr[10]; int *p = &arr[0]; int *a = arr; int *b = &arr; int *c[10] = &arr; int (*d)[10] = &arr; 上述代码中:
f1是个函数,返回值类型是个double* 指针
f2是个指针,指向了一个函数,类型就是double (*)(int);
p是个指针,指向数组arr的0号元素首地址
a是个指针,和p一样(数组名arr就是0号元素首地址)
b是个指针,虽然和a一样的值,但指向的是整个数组内存块的首地址,当b进行+1运算时,会增加整个数组内存字节数大小
c是个数组,包含了10个int* 指针元素的数组
d是个指针,指向了一个包含10个int元素的数组
深入学习函数指针
(下一节函数篇也有涉及)
函数原型
在函数原型中,特征标即参数列表有如下规则:
- arr[] 和 *arr 等价(仅作为特征标时可以这么做)
- 可以省略标识符 const double ar[] 简化为 const double [], const double *arr 同理const double *(仅在函数声明时可以,函数定义时不可以省略!)
包含函数指针的数组
讯享网const double * (*pa[3])(const double *,int) = {f1,f2,f3};
语句书写思路:先写出返回类型和特征标 const double * ()(const double*, int) 再向()内填写一个包含指针的数组表达式*pa[3]
指向包含函数指针数组的指针
const double * (*(*pa)[3])(const double *, int) = &pa;语句书写思路:先写出返回类型和特征标const double * ()(const double *, int)再向()内追加 一个 指向包含指针元素的数组的 指针表达式*(*pa)[3]
结构篇
- 数组允许定义可存储相同类型数据项的变量,结构允许您存储不同类型的数据项。
- 可以定义指向结构的指针,方式与定义指向其他类型变量的指针相似,把 & 运算符放在结构名称的前面
- 指针访问结构的成员,必须使用 -> 运算符
讯享网struct Books *struct_pointer; struct_pointer = &Book1; struct_pointer->title;
- 更简单的定义结构的方式,您可以为创建的类型取一个"别名". 现在,您可以直接使用 Books 来定义 Books 类型的变量,而不需要使用 struct 关键字(一般情况下即使不引用也是可以忽略strcut关键字来定义结构对象的)
//previous struct Books { string name; int book_id; }; struct Books Book1; Books newBook; newBook.name = "abcd"; //now typedef struct Books { string name; int book_id; }BOOKS; BOOKS Book1, Book2;为了访问结构的成员,我们使用成员访问运算符(.)
讯享网struct type_name { member_type1 member_name1; member_type2 member_name2; member_type3 member_name3; . . } object_names; struct Books { char title[50]; char author[50]; char subject[100]; int book_id; } book; typedef struct Books { char title[50]; char author[50]; char subject[100]; int book_id; }Books;
函数篇
文章使用Q&A问题回答形式,内容涉及C++函数部分。
函数基础
- Q:使用函数的基本步骤?
- 提供函数定义,提供函数原型,调用函数
- Q:库函数是什么
- 库函数是已经定义好和编译好的函数,在标准库 头文件中定义相关原型,在程序中包含该头文件后,正确调用库函数即可
- 例如C库头文件cstring中有strlen()函数
- 库函数是已经定义好和编译好的函数,在标准库 头文件中定义相关原型,在程序中包含该头文件后,正确调用库函数即可
//calling.cpp #include <iostream> void simple(); //原型 int main(){ simple(); //调用 return 0; } //定义 void simple(){ cout<<"ok"<<endl; } - Q:什么是void函数
- 没有返回值的函数
- 通常可以使用void函数执行某种操作,例如打印计算次数等。
- 没有返回值的函数
- Q:有返回值的函数应该注意什么?
- 1.必须有return返回语句,
- 2.返回的类型不能是数组,但可以将数组作为结构和对象的成员来返回。
- 1.必须有return返回语句,
- Q:若函数包含了多条retrun返回语句将会如何?
- 遇到第一条retrun返回语句后结束该函数。
- Q:为什么一定要有函数原型?
- 原型描述了函数到编译器的接口,将函数的返回值和特征标告诉编译器,编译器会检查该函数,从而降低出错率。
- Q:原型的书写语法是什么?
- 原型是一条语句,以;结束
- 原型可省略变量名,只保留类型列表 double cube(int, double, long);
- 原型是一条语句,以;结束
- Q:什么是按值传递?
- 将实参复制给形参,形参会得到内存分配,其存储持续性为自动,随函数存亡。
- Q:什么是形参,实参?
- 传递给函数的值是实参,接受实参的变量是形参。
- Q:函数参数传递的顺序是?
- 从左到右一次赋值给相应形参,不可跳过。
- Q:若函数参数中存在多个同类型参数,如3个int,则如何书写参数列表?
- 必须分别指定类型int a,int b, int c,不可组合声明int a,b,c
- Q:什么是递归?
- 自己调用自己,但main()不可。
- 递归需包含终止条件,否则将无限递归,一般把递归调用放在if语句中
- 和下楼梯一样,逐层下,逐层回。
- 自己调用自己,但main()不可。
- Q:写一个按下q键,循环终止的代码
讯享网#include <iostream> int main(){ char ch; cin >> ch; while(ch !='q'){ return -1; } return 0; }
函数和数组
- Q:函数如何用指针来处理数组?
- 当且仅当,在函数原型中,int &arr 和 int arr[] 含义相同,即arr是个int*类型。
- arr存储的是数组的第一个元素首地址
- 在函数原型外,无法通过int arr[]来声明指针
- 当且仅当,在函数原型中,int &arr 和 int arr[] 含义相同,即arr是个int*类型。
- Q:数组名的指针表示法和数组表示法是什么?
- 数组表示法 int arr[] 指针表示法 int * arr
- Q:将数组作为参数传递给函数的结果是什么?
- 没有将数组整个传递给函数,而是传递了数组的地址,和包含元素的类型以及元素的个数。
- 按值传递常规变量时,函数会复制实参给形参,不会使用实参数据,传递数组时,函数将直接使用数组原始数据。
- Q:是否违反函数不能传递数组的规则?
- 不违反,传递的是地址值,并不是数组整体本身。
- 没有将数组整个传递给函数,而是传递了数组的地址,和包含元素的类型以及元素的个数。
- Q:数组名和指针的相关性是好事吗?
- 是的,将节省复制数组的时间。
- Q:对函数传递数组时,应传递哪些元素?
- 数组的地址,和长度
//prototype void fillArray(int arr[], int size); void fillArray(int* arr, int size); void fillArray(int [], int); void fillArray(int*,int); - Q: 如何防止函数修改数组数据?
- 使用关键字const
讯享网//prototype void show_array(const double [], long); void show_array(const double arr[], long n); void show_array(const double *,long);
函数和二维数组
- Q:如何表示二维数组?
- C++中函数传递二维数组时,需传递行数参数,同时需要指明具体列数。下边就是size行4列的数组。
//prototype void show_array(int (*arr)[4], int size); void show_array(int arr[][4], int size); void show_array(int (*)[4], int); void show_array(int [][4], int);- Q:创建一个返回指针的函数,说明使用场景。
- 返回字符串数组时,函数无法返回一个C风格字符串本体,但可以返回它的地址值,即一个指针变量。
讯享网char* builder(char c,int n){ char* pstr = new char[n+1]; pstr[n] = '\0'; while(n-->0){ pstr[n] = x; } return pstr; }
函数和结构
- Q:如何传递结构到函数中?
- 结构与数组不同,结构对象将被视为一个整体,即一个普通变量
- 按值传递结构,将复制实参给形参
- 按指针传递,则可以通过指针间接访问结构对象,直接传递结构地址,利用&地址运算符
- 按引用传递,则可以直接访问结构对象
- 结构与数组不同,结构对象将被视为一个整体,即一个普通变量
- Q:按指针传递结构,应注意什么?(假设结构名为place,结构对象为bank)
- 调用函数时,将结构的地址传递&place,而不是结构本体
- 函数形参应为指向结构的指针place*,若不想修改结构,则 const place*
- 利用指针访问结构对象成员时,应使用间接访问运算符->而不是直接访问运算符.
- 调用函数时,将结构的地址传递&place,而不是结构本体
- Q:若函数想修改指针传递的结构,那么如何高效的返回结构?
- 传递两个指针给函数,一个指向原结构,另一个指向修改后的结构。
- 注意!函数不返回结构,而是通过指针来直接修改,该命题是个伪命题,不要返回结构。
- 传递两个指针给函数,一个指向原结构,另一个指向修改后的结构。
void rect_to_polar(const rect* pxy,polar* pda){ cout<<"begain"<<endl; using namespace std; pda->distance = (pxy->x + pxy->y); pda->angle = atan2(pxy->y,pxy->x); cout<<"OK"<<endl; }函数和string对象
- Q:string对象和C风格字符串的区别?
- string对象和结构相似,两个对象可以彼此赋值。但C风格字符串本质是数组,无法直接赋值。
函数指针
(上述,指针相关专题也有涉及)
- Q:什么是函数指针?
- 指向函数的指针。
- Q:如何获取函数的地址?
- 函数名本身就是地址
- 区分函数think()和函数名think,think表示函数地址,think()则是函数调用(返回值)
- 函数名本身就是地址
- Q:如何声明函数指针?
- 直接将函数原型中的函数名替换成(*ptr)
讯享网double pam(int); double (*ptr_f)(int);
- Q:如何利用指针去调用函数?
- 有两种方法
- 方法一:*pf(5)
- 方法二:pf(5)
- 有两种方法
#include <iostream> double pam(int); void estimate(int lines, double (*pf)(int)); int main(){ using namespace std; double (*pff)(int); pff = pam; cout<<"pff(4)="<<pff(4)<<endl; cout<<"(*pff)(4)="<<(*pff)(4)<<endl; cout<<"pam(4)="<<pam(4)<<endl; int code; cout<<"input a number"<<endl; cin>>code; cout<<"estimate="<<estimate(code,pam); } double pam(int lns){ retrun (0.03 * lns); } void estimate(int lines, double(*pf)(int)){ using namespace std; cout<<"lines"<<lines<<endl; cout<<"(*pf)(lines)"<<(*pf)(lines)<<endl; cout<<"pf(lines)"<<pf(lines)<<endl; }案例分析
- Q:创建一个包含3个函数指针的数组
讯享网const double * (*pa[3]) (const double * , int);
- Q:如何调用上述数组的元素?
- 为什么px是const double *类型? 因为函数的返回值是const double*类型
const double * px = pa[0](av,3); const double * py = (*pa[2])(av,4);
- 为什么px是const double *类型? 因为函数的返回值是const double*类型
- Q:创建一个指针,该指针指向包含3个函数指针的数组
-
讯享网
const double * (*(*pa)[3]) (const double * ,int);
-
- Q:如何通过上述指针来调用函数
-
const double * px = (*pa)[0](av,3); const double * py = *(*pa)[2](av,4);
-
内联函数
- 编译过程最终是生成可执行文件,然后运行,在运行程序时,操作系统将可执行文件,即这些机器语言指令装载到内存中,然后按照指令的地址逐步执行,有时候遇到循环或者条件分支语句时会跳着执行,函数调用也会从一个地址跳到函数所在的首地址,函数结束则返回
- 当程序跳转到函数地址时,即程序在函数调用后会立即存储该指令的地址,然后把函数参数放到堆栈内存池中,然后直接跳到函标记函数起点的内存块处开始执行函数代码,最后函数结束就跳回去了。
- 来回的跳跃并记录跳跃位置,需要太多的开销了,因此C++提供了内联函数,无需跳跃,但需要更多内存,即如果程序再10个不同的地方调用同一个内联函数,则这个内敛函数将有10个副本
- 使用: 函数声明或定义前加关键字inline即可
- Q:程序是如何调用函数的?
- -1-运行程序后,OS将指令载入内存,每条指令都占用内存空间
- -2-逐步按逻辑执行指令,遇到函数调用时,则跳到函数的地址处,执行函数体指令,结束后返回跳转位置
- -3-当执行到函数调用指令时,程序会立刻存储指令的内存地址,将函数参数复制到堆栈中,跳转到函数地址,执行完毕后,读取之前存的内存地址,跳回。反复跳转会有一定的开销,因此小函数可使用内联函数。
- Q:什么是内联函数?
- 编译器将函数体的代码替换调用函数指令,无需跳转,直接逐步执行函数体中的指令,代价是占据更多内存,但节省时间。
- Q:如何定义内联函数?
- 关键字inline
- -1在函数声明前加上关键字inline
- -2在函数定义前加上关键字inline
-
讯享网
inline double square(double x) {return x*x;}
- 关键字inline
- Q:如何调用内联函数?
-
#include <iostream> inline double square(double x){return x*x*;} int main(){ using namespace std; double a,b; double c = 0.294; a = square(c); b = square(a); cout<<"a="<<a<<endl; cout,<"b="<<b<<endl; return 0; }
-
引用
- Q:什么是引用?
- C++的一种复合类型,引用变量
- 引用变量是对另外一个变量起个新名字,即对其内存添加一个新标签。
- 引用变量常作为函数的形参,使得函数直接使用变量原始数据,而不是其副本,也就省去了按值传递复制给形参变量的步骤
- C++的一种复合类型,引用变量
- Q:如何使用引用?
- 地址运算符重载&,用来声明引用,下述int&表示指向int的引用,rodents的类型是int&
-
讯享网
int rats; int & rodents = rats;
-
- 地址运算符重载&,用来声明引用,下述int&表示指向int的引用,rodents的类型是int&
- Q:引用和指针的区别?
- 声明引用变量时,必须初始化,而普通指针变量无需,但const指针变量和引用变量一样,声明时要初始化。
- Q:函数参数传递数据的方法有哪几种?
- 共三种,分别是:
- -1-按值传递,直接将实参复制给形参,无法修改原数据;
- -2-按指针传递,通过指针变量,间接访问数据本身,间接修改原数据;
- -3-按引用传递,通过引用变量,直接访问数据本身,直接修改原数据。
- 共三种,分别是:
- Q:三种函数参数传递方法的使用场景
- 传递结构时,指针*or引用&,且不想修改时,const* or const&
- 传递类对象时,使用引用&,且不修改时,const&
- 传递数组时,使用指针*,且不想修改时,const*
double cube (double); double square(double*); double atan(double&);- Q:如何判断函数参数是通过哪种方法传递数据的?
- 只能通过函数原型或者函数定义,查看特征标来判断。
- Q:如何在使用 引用传递时,禁止函数修改原数据?
- 使用const关键字
-
讯享网
double square(const double &);
-
- 使用const关键字
- Q:创建一个返回类型和参数都是引用类型的函数。
-
#include <iostream> struct free_throws{ std::string name; int made; int attempts; float percent; }; free_throws & accumulate(free_throws&, const free_throws); int main(){ free_throws ini = {"ini",0,0}; free_throws one = {'A',1,11}; free_throws two = {'B',2,22}; free_throws team = {"all",0,0}; free_throws good = {"good",100,100}; free_throws fact_all; accumulate(team,one); fact_all =accumulate(team,two); cout<<ini.percent<<endl; cout<<fact_all.percent<<endl; cout<<good.percent<<endl; accumulate(ini,team) = good; //由于accumulate返回的是引用,因此可用good覆写ini cout<<ini.percent<<endl; } free_throws & accumulate(free_throws& target, const free_throws source){ target.attempts += source.attempts; target.made += source.made; return target; }
-
- Q:如果返回值不是引用,那么返回的是什么?
- 返回值是引用时,retrun返回自身,不是引用时,return A返回的是A的拷贝,A会复制给一个临时内存位置,调用程序将使用它,结束后释放。
- 上述代码中,fact_all =accumulate(team,two); 直接把team复制给fact_all, 如果返回的不是引用类型,那么先把team复制到一个临时位置,然后再复制给fact_all
- Q:能否返回一个临时变量的指针?
- 应避免,因为该临时变量在函数结束后将释放其内存空间
-
讯享网
const free_throws & clone2 (free_throws & ft){ free_throws newguy; newgy = ft; return newgy; //禁止这么写! }
- Q:如何禁止给accmiulate()返回的引用变量赋值?
- accumulate(ini,team) = good; //由于accumulate返回的是引用,因此good覆写ini
- 只需要将accumulate修改成:
const free_throws & accumulate(free_throws&, const free_throws&);
- 只需要将accumulate修改成:
- accumulate(ini,team) = good; //由于accumulate返回的是引用,因此good覆写ini
- Q:什么时候函数参数使用引用类型?
- -1-想修改调用函数中的数据对象
- -2-想提高程序运行速度
默认参数
- Q:什么是默认参数?
- 当函数调用时,输入实参少于参数个数时,其他参数则使用默认参数值。
- 当默认参数被输入实参时,自动使用实参值。
- Q:如何设置默认参数?
- 必须通过函数原型,且通过从右向左的顺序,将值赋给函数原型中的参数。(即要为某个参数添加默认值,必须保证他右边的全部参数都有默认值)
讯享网
char * left(const char* str, int n =1); -
//.cpp #include <iostream> char * left(const char* str, int n = 1): int main(){ } char * left(const char* str, int n){ char* p =new char[n+1]; retrun p; }
- 必须通过函数原型,且通过从右向左的顺序,将值赋给函数原型中的参数。(即要为某个参数添加默认值,必须保证他右边的全部参数都有默认值)
- Q:默认参数的作用?
- 允许使用不同参数个数来调用同一个函数,但要求参数输入时要从左向右顺序输入,不跳跃,不间隔。未传递实参的参数,使用默认参数。
函数重载
- Q:什么是多态?
- 多态:多种形式
- Q:什么是函数的特征标?
- 函数特征标:参数的个数、类型和排列顺序。
- Q:函数重载的条件:
- 函数特征标不同
- 其中类型和类型引用不作区分,且const和非const也不作区分
- 函数特征标不同
- Q:什么时候考虑使用函数重载?
- 函数执行的算法相同,但处理的数据类型不同时
- 术语:多态和重载,指的是同一回事,就是同一物体的多种形式
- 函数多态=函数重载,即允许函数有多种形式,即有多个同名函数,多态是函数多态,重载其实是函数名称重载
- 无论多态还是重载,意义就是,名字相同,参数列表不同
- 函数特征标:函数的参数列表,如果两个函数, 参数数目,参数类型,参数排列顺序,三者都相同,那么他们的特征标相同,显然这里和参数变量的名称无关
- C++允许定义函数名称相同的函数, 条件就是其特征标不同
讯享网double cube(double x); double cube(double &x); //看起来特征标是不同的,其实,类型引用和类型本身是同一特征标 double long(double x); long long long(double x); //显然这里的long函数是不允许被重载的,因为特征标是相同的,即返回值类型并不是特征标之一
函数重载很棒,但不要滥用,仅在函数执行基本基本相同任务,但对象的数据类型不同时,可以考虑函数重载
函数模板
- Q:什么是范型?
- 非具体类型
- Q:什么是函数模板?
- 函数模板是通用的函数描述,通过范型来定义函数,将类型参数化。
- 模板并不创建函数,而是告诉编译器如何定义函数
- 根据函数模板来定义函数,得到的函数根据输入参数的类型,来自动将ABC替换成其类型。
- Q:如何创建模板?
- template
- 使用两个关键字,template 和 typename或者使用class替代typename
- 必须使用<>
- 类型名任意命名
- Q:程序如何匹配由重载模板定义的函数 ?
- 根据函数参数特征标
- 函数模板是通用的函数描述, 使用"泛型"来定义声明函数,这里的"泛型"可以用具体类型替换,比如int, double, long等,具体方法就是通过具体的类型如double作为参数, 传递给模板,编译器就会自动生成该类型函数
- 另外的名字,①函数模板这种编程方法,也叫作通用编程,因为没有具体化, ②函数具体类型是由参数来表示的,这种模板特性也叫参数化类型
- 如何创建函数模板??利用关键字template和typename,注意这里typename也是个关键字,区分我们之前的这是我们自己为方便而写的一个概括而已
函数模板的核心: 抛开具体的变量类型, 着重关注数据处理的算法.
意思是变量用T统一代替
-
template <typename T>//建立模板,类型是AnyType,如果你想用类class,即把typename关键字改成关键字class即可 //函数定义声明如下 void swapFunction(T &a, T &b) { T xjh1; //定义声明变量xjh1是AnyType类型 xjh1 = a; //交换两个变量a和b的值,注意这里都是AnyType类型,可以是int double long long等 a = b; b = xjh1; } int x =1000; int y =20000; xjh(x,y) //xjh()函数获得了两个int类型的值,所以编译器生成了函数的int版本 //案例1 template <class S> void mySwap(S a, S b) { S c; c = a; a = b; b = c; } //案例2: template <class xjh> xjh* findTrueFriend(xjh* friend1, int age) { if(age>10) { cout<<*friend1<<endl; return friend1; } }
函数模板也不能总是乱用,就像函数重载,函数重载是在函数执行基本相同任务时,对象类型不同可以用函数重载,而函数模板则是在执行完全相同任务时,如果对象类型不同,则用函数模板
- 函数重载的基本相同告诉我们,并非要执行完全相同的计算方法即算法,所以函数模板也可以进行重载,即模板重载
- void xjh(AnyType &a, AnyType &b) 这里的函数模板,其实你也可以叫模板函数, 的特征标是AnyType &,AnyType &
- 模板的实例化和具体化
- 在代码中包含函数模板本身并不会生成函数定义,这个模板的工作只是用于生成函数定义的方案.就是说当编译器通过具体的类型来使用模板时,得到的是模板的实例, 这个模板的实例才是函数的定义声明
- 联想变量的初始化,那么我们的模板能不能在创建模板时初始化一个类型呢?可以
- Q:创建一个模板,并对其重载
-
讯享网
#include <iostream> template<typename A> void swap(A&, A&); //模板重载 template<typename A> void swap(A*, A*, int); int main(){ int i = 10, j = 20; swap(i,j); int d1[3] = {0,1,2}; int d2[3] = {3,4,5}; swap(d1,d2,3); return 0; } template<typename A> void swap(A& a, A& b){ A temp; temp = a; a = b; b = temp; } template<typename A> void swap(A*a, A*b, int n){ A temp; for (int i=0; i<n; i++){ temp = a[i]; a[i] = b[i]; b[i] = temp; } }
-
函数的构建模板如下
typeName functionName(parametersList); void mian(){} typeName functionName(parametersList) { statements return value; } //retrun无法返回数组,但可以是结构,类对象,或者可以把数组作为结构和类对象的成员返回 //函数参数也不能是数组函数无法返回数组,函数参数也不能是数组,但是可以通过结构、类来使用数组,或者在参数重吧
定义函数时参数列表的变量是形参,调用函数时,是实参,实参一直存在(当然这里是普通变量,new则另说),形参,在函数被调用时,计算机为形参分配内存,函数结束时,释放这些内存块,所以形参叫局部变量,他们的作用域仅在该函数内部
讯享网typeName fucntion(int param1, &prama2){} void main() { int a = 10; int b =11; function(a, &b); } //a和b都是实参,param1和param2都是形参
把数组和函数结合在一起
等等!不是说参数不能是数组,且retrun无法返回数组吗???难道只是做参数传递吗??No
int functionArray(int array[], int n); //这里的array[]实际上是个指针,还记得指针和数组名其实是一个东西吗?- 是的, int array[]表示一个数组, 而方括号是空的,则表示可以传递任何长度的数组给函数functionArray(),其实是错误的, 这里的array是指针!!!但是你把他看成数组又何妨呢?
- 另外,如果你想通过函数来处理数组, 你最好把数组名,数组类型和数组的长度都告诉函数
如果你想让函数可以修改传进来的数组
讯享网void function(double arr[], int n){}
如果不想让函数修改传进来的数组
void function(const double arr[], int n){}运算符的多态
函数有重载,即函数的多态,运算符也有,即运算符重载,运算符的多态.函数在的重载想让你用相同函数名完成基本差不多的操作.
运算符也有重载,实际上你已经学习过了,比如*即是乘号,也是地址运算符,根据运算符左右目来确定具体功能
我们知道函数重载可以自己定义,那运算符其实也可以
如何进行运算符重载?利用operator现有运算符(参数), 这里operator是个函数,不同的是,你需要在函数名后紧跟你需要重载的运算符,比如operator+()
讯享网//time.h class time { private: int hours; int munutes; public: time(); time(int h, int m = 0); void AddMin(int m); void AddHr(int h); void Reset(int h=0, int m=0); time sum(const time & t) const; void Show() const; // 加const表明,该函数只能是只读的,不能修改私有变量的值。加强安全性。 } //endif 这里sum的参数运用了&运算符重载,即引用 //把stock::sum()函数利用运算符+的重载来实现 //time.h class time { private: int hours; int munutes; public: time(); time(int h, int m = 0); void AddMin(int m); void AddHr(int h); void Reset(int h=0, int m=0); time operator+(const time & t) const; void Show() const; }
当使用operator+成员函数时, 你也可以通过对象用.运算符来调用该方法函数,你也可以直接用+运算符来操作该
int main() { total = coding.operator+(fixing); total1 = coding + fixing; } 类
对象和类
直接成员运算符.
间接成员运算符->
作用域解析符::
- Q:面向对象编程的特性是什么?
- 抽象
- 封装和数据隐藏
- 多态
- 继承
- 代码的可重用性
- Q:如何使用OOP面向对像编程思想?
- 从用户角度考虑对象
- 描述对象所需的数据
- 描述用户和数据交互所需的操作
- 完成接口,确定接口实现和数据存储
- 创建程序
- 从用户角度考虑对象
- Q:指定基本类型将完成哪些工作?
- 决定数据对象需要的内存数量
- 决定如何解释内存中的位
- 决定使用对数据对象使用的方法/操作
- Q:什么叫类?
- 类是将数据抽象出来,转换成用户自定义类型的一个C++工具
- 该工具将数据表示和数据操作方法 组合成一个 整洁的包
- Q:类的组成?
- 类声明:描述了该类的基本构成(常在.h中)
- 描述数据部分,由数据成员组成
- 描述公有接口部分,由成员函数组成(函数原型)
- 类方法定义:实现了该类的具体操作细节(常在.cpp中)
- 描述如何实现上述成员函数(函数定义)
- 类声明:描述了该类的基本构成(常在.h中)
- Q:如何理解接口?
- 接口可以简单的理解成函数原型,所谓细节实现则对应函数定义
- 接口可以快速让用户知道如何使用该方法来实现某种操作,而不必去学习该方法完成某种操作的原理。
- Q:类是如何实现数据隐藏的?
- 通过对成员设置访问权限,即公有和私有
- Q:什么是封装,数据隐藏?
- 将实现细节放在一起,并将细节和抽象分开,称为封装。
- 将类函数定义放在.cpp文件中,类函数声明放在.h中,也是一种封装。
- 防止程序直接访问数据称为数据隐藏,也是一种封装,将实现的细节放在了私有部分,比如私有函数set_tot()
- 将实现细节放在一起,并将细节和抽象分开,称为封装。
- Q:数据隐藏的作用?
- 防止直接访问数据
- 无需了解数据表示方法,直接用即可
- 只需要知道如何使用成员函数,了解成员函数功能,无需知道成员函数实现的细节。
- 当有更好的算法时,可直接修改成员函数实现细节,无需修改接口,使得维护梗方便。
- Q:如何访问隐藏的数据?
- 只能通过公有函数或者友元函数来访问私有成员
- Q:类是如何实现公有私有成员的?
- 通过类作用域,类定义中的名称作用域都是整个类,出了该类则无效,即不能从外部访问类成员,因为这些成员在外部是无效的
- 通过对象,使用成员运算符或作用域解析符,来调用公有函数,在公有函数中也就到了类作用域中,于是可以访问该作用域中的成员。
- Q:类声明的构成?
-
讯享网
class stock{ private: char company[30]; int shares; double share_val; double total_val; void set_tot() { total_val = shares*share_val; } public: stock(); ~stock(); void acquire(const char*, int, double); void buy(int, double); void sell(int,double); void update(double); void show(); }
-
- Q:如何利用数据隐藏的思想创建类?
- 数据项放在私有部分,类接口(成员函数/原型)放在公有部分。
- Q:类对象默认访问权限是??
- 私有
- Q:类和结构的主要区别是?
- 类的默认访问权限是公有,类则是私有
- Q:类成员函数和常规函数的异同是?
- 相同点:都有函数头和函数体、返回类型、参数和原型
- 不同点:
- 成员函数定义时,需要用作用域解析运算符::来表明 该函数所属的类
- 公有成员函数可以直接访问类的私有成员
- Q:能否在类声明中直接定义函数?
- 可以,此时函数直接转换成内联函数,上述代码中的set_tot()函数就是如此。
- Q:类对象是如何分配内存空间的?
- 每个类对象都有自己的存储空间,存储内部变量和类成员,创建新类对象时,为其内部变量和类成员开辟新内存空间;
- 同一类的对象,共享该类的方法,即每个方法只有一个副本,创建新类对象时不开辟新内存空间。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/133159.html