
目录
目录
一、 概要
二、网络结构
1. 整体结构
2. 特征金字塔
(1) 插值优先聚合 (Interpolation-First Aggregation,IFA)
(2)卷积优先聚合(Convolution-First Aggregation, CFA)
3. 可分离动态解码器
(1) Pre-Attention模块
(2)可分离动态卷积注意力模块
<1>传统交叉注意力模块
<2> 一维卷积进行多头交叉注意力
(3) Post-Attention模块
(4)预测输出
<1> Class 预测
<2> Mask 预测
4. 多个层堆叠
一、 概要
本文提出YOSO,一个实时的全景分割框架。YOSO通过全景Kernel和图像特征图之间的动态卷积进行分割预测,该方法处理实例和语义分割任务时,只需要分割一次。
为了减少计算开销,设计了一个用于特征图提取的特征金字塔聚合器,以及一个用于全景内核生成的可分离动态解码器。
其中:
聚合器:以卷积优先的方式重新参数化插值优先模块,这显著加快了Pipeline的速度,而没有任何额外的成本。
解码器:通过可分离的动态卷积执行多头交叉注意力,以获得更好的效率和准确性。
二、网络结构
1. 整体结构
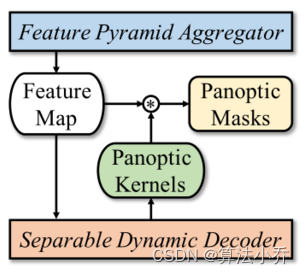
如上图所示,YOSO整体上是有一个特征金字塔和一个可分离动态解码器组成。
其Backbone采用的是ResNet,从输入图像中提取多级特征图,特征金字塔FPN将多级特征图压缩并聚合为一个特征图。
然后,通过 可分离动态解码器 生成全景kernel,进而进行mask的预测和分类。
2. 特征金字塔
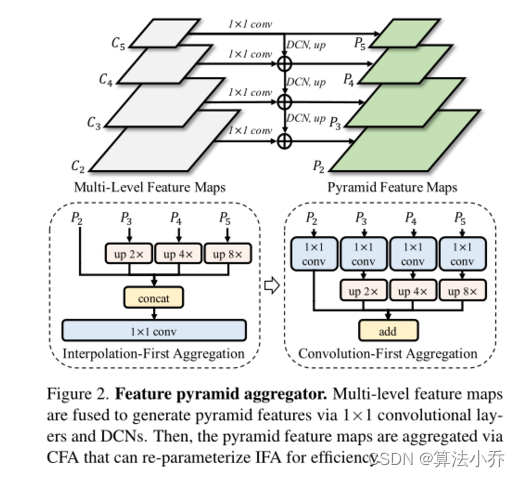
如上图所示,C2,C3,C4,C5是backbone的多级特征图,通过FPN + DCN(形变特征金字塔)的方式,对多级特征进行增强和融合,具体操作如下:
对于C2到C5,首先采用1x1的卷积对多级特征图进行通道压缩,然后C3到C5分别进行DCN和upsample操作,从上到下的特征融合,分别得到P5、P4、P3、P2.
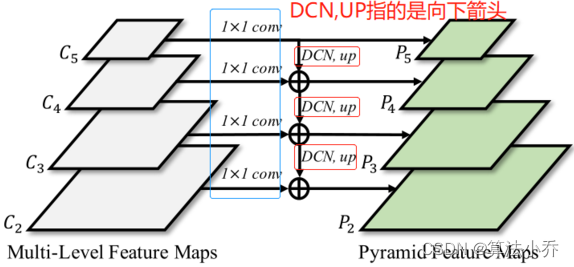
得到 P2、P3、P4、P5之后 进行 特征聚合,得到同P2同shape的特征图S
YOSO指出了两种方法,分别是 插值优先的IFA 和 卷积优先的 CFA。下面分别进行介绍:
(1) 插值优先聚合 (Interpolation-First Aggregation,IFA)
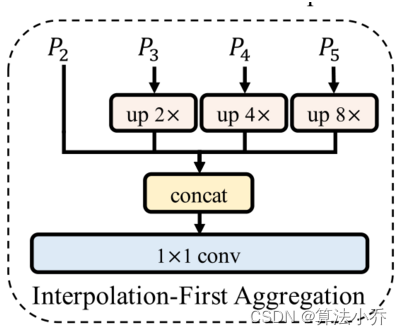
首先P3到P5,分别上采样到P2大小,然后Concat通道合并,最后通过1x1卷积进行通道间的特征融合。
(2)卷积优先聚合(Convolution-First Aggregation, CFA)
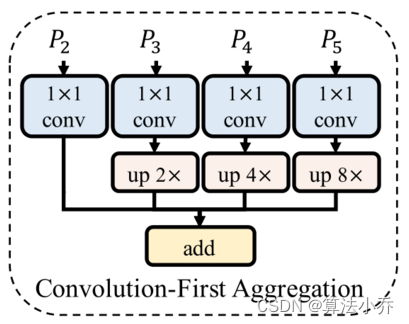
首先P2到P5分别进行1x1卷积,然后P3到P5卷积后的结果分别上采样到P2大小,最后直接进行Add操作。
两种方法的1x1卷积中,bias=False。
总结:上述两种方式,最终的效果是相当的;但是CFA的计算量更低一些。最终采用了CFA.
import torch.nn.functional as F import torch.nn as nn # 经过FPN结构得到x2,x3,x4,x5 class CFA_IFA(nn.Module): def __init__(self,in_channels_list,out_channels,mode='cfa'): super(CFA_IFA,self).__init__() self.mode = mode if self.mode=='cfa': self.conv_a5 = nn.Conv2d(in_channels_list[-1],out_channels,1,1,0) self.conv_a4 = nn.Conv2d(in_channels_list[-2],out_channels,1,1,0) self.conv_a3 = nn.Conv2d(in_channels_list[-3],out_channels,1,1,0) self.conv_a2 = nn.Conv2d(in_channels_list[-4],out_channels,1,1,0) else: self.fuse_conv = nn.Conv2d(4*out_channels,out_channels,1,1,0) self.output_conv = nn.Conv2d(out_channels,out_channels,3,1,1) def forward(self,x2,x3,x4,x5): if self.mode=='cfa': # CFA x5 = F.interpolate(self.conv_a5(x5), scale_factor=8, align_corners=False, mode='bilinear') x4 = F.interpolate(self.conv_a4(x4), scale_factor=4, align_corners=False, mode='bilinear') x3 = F.interpolate(self.conv_a3(x3), scale_factor=2, align_corners=False, mode='bilinear') x2 = self.conv_a2(x2) x = x5 + x4 + x3 + x2 + self.bias x = self.output_conv(x) return x else: # IFA x5 = F.interpolate(x5, scale_factor=8, align_corners=False, mode='bilinear') x4 = F.interpolate(x4, scale_factor=4, align_corners=False, mode='bilinear') x3 = F.interpolate(x3, scale_factor=2, align_corners=False, mode='bilinear') x = torch.concat([x5,x4,x3,x2], dim=1) x = self.fuse_conv(x) x = self.output_conv(x) return x 讯享网
3. 可分离动态解码器
为了生成精确的分割Kernel,之前的方法通常采用密集的预测器(如sigmoid)或重型的Transformer解码器。
YOSO,则采用了一种轻量可分离的动态解码器来生成kernel,在保持高精度的同时加快了kernel的预测与生成。结构如下:
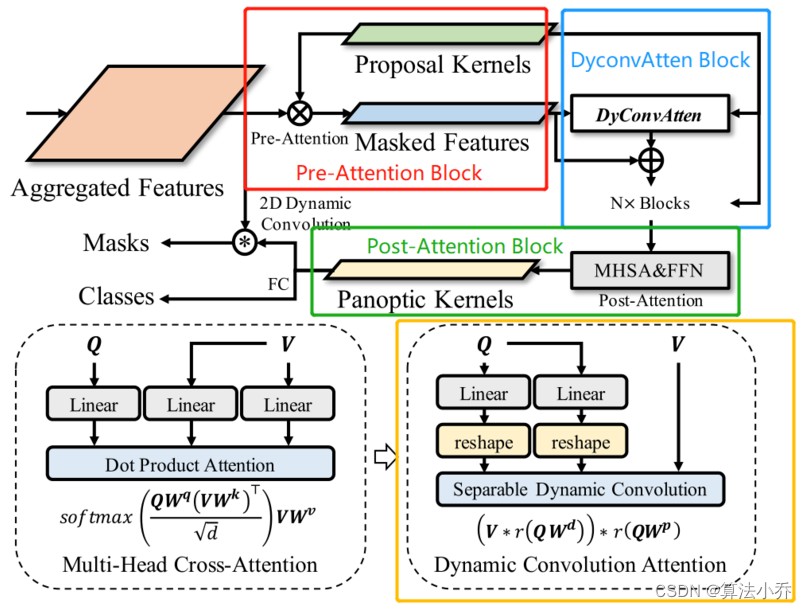
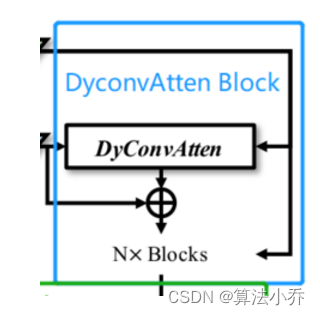
如图所示,由三部分组成:Pre-Attention(预注意力模块)、可分离动态卷积注意力模块、Post-Attention(后注意力模块)
(1) Pre-Attention模块
如上图的红色框所示:
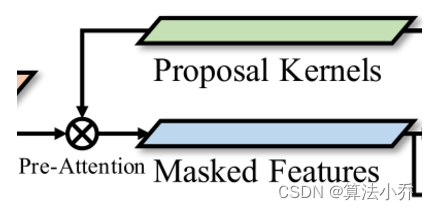
a. 作用:
从主干网络的FPN的聚合特征S(bxc x h x w)选择性地(自适应地)提取关键信息。
b. 操作流程:
<1> 获取映射矩阵Mask
S的shape为b x c x h x w, 即通道数目为c, 高为h, 宽为w 。
首先通过Conv2d卷积对S进行处理,kernel_size=1,调整通道数目为 n ( n 指的是proposal kernels的数目,即每张图像设定一个最大的候选结果数目proposal kernels number,后期在通过处理从候选结果中筛选 )得到卷积结果 A (shape为b x n x h x w)
然后对卷积结果 A 进行Sigmoid处理,并设定阈值0.5,作为一个注意力矩阵Mask shape为b x n x h x w(有点空间注意力的意思)
最后通过Msak对S进行注意力映射。
<2> 特征映射获得self-Attention的V
映射流程:
Mask shape: [b x n x h x w] -> reshape [b , n , hw] , 表示 n 个 proposal kernels , 每个 proposal kernel 有 hw 个像素点,将每个像素点映射到对应的n个proposal kernels。
S shape : [b x c x h x w] -> reshape [b,c,hw] , 表示 hw个像素点,每个像素点有c个通道数。
V 映射结果,shape : [b x n x c], 相当于对每个 kernel 进行特征选择,对于每个 kernel 从 特征矩阵 S 中选择 c 个 特征值,对应于上图中的 Masked Features
公式如下所示:
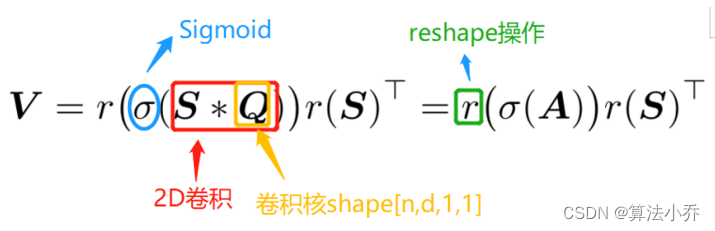
上图中的Proposals Kernels 指的就是2D卷积的卷积核Q, 估计当时作者这样绘图的初心是为了更形象,因为 Q 在后面的stage中也会用到!!!。
注意!! 公式中的Q 也就是后面动态卷积注意力(Dynamic Convolution Attention )Decoder中的Q。它来自于上述2D卷积的卷积核 shape [n,c,1,1] -> reshape [n,c], 与V的shape一致(不考虑batch)。
对应回图像,如下所示:
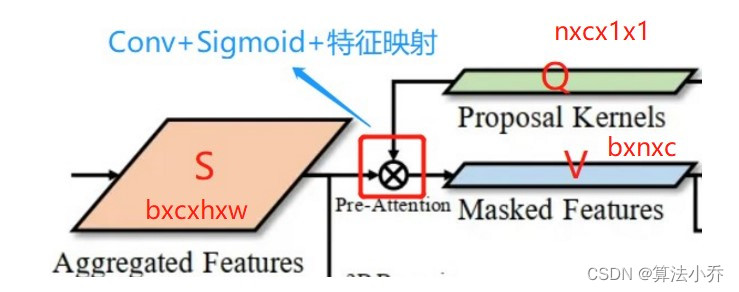
可见Q既应用于卷积操作,也应用于下面的注意力模块。
代码如下:
讯享网import torch import torch.nn as nn # 首先声明一个卷积函数,用于上面公式中的红框操作 class YOSOHead(nn.Module): def __init__(self,in_channels,num_proposals): super(YOSOHead,self).__init__() ''' in_channels: 主干网络输出S的通道数 num_proposals: 设置的proposals数目,kernel的个数 ''' self.num_proposals = num_proposals # 声明一个Conv用于卷积操作,同时会获取卷积权重,用于后面注意力模块的Q self.kernels = nn.Conv2d(in_channels,num_proposals,kernel_size=1) def forward(self,features,xxx): B,C,H,W = features.shape # features : b x c x h x w # mask_preds: b x n x h x w mask_preds = self.kernels(features)# 卷积操作 # sigmoid处理并与阈值比较获得mask # b x n x h x w soft_sigmoid_mask = mask_preds.sigmoid() nonzero_inds = soft_sigmoid_mask > 0.5 hard_sigmoid_mask = nonzero_inds.float() # V = r(A)r(S).T # b x n x c V = torch.einsum('bnhw,bchw->bnc', hard_sigmoid_masks, features) # ------------------ 以上 Pre-Attentinon ------------------ # # 获取注意力的Q # n x c x k x k k = 1 proposal_kernels = self.kernels.weight.clone() # reshape b x n x c x 1 x 1 -> b x n x (cxkxk)= b x n x c 与V的shape相同 Q = proposal_kernels[None].expand(B,*proposal_kernels.size()).view().view(B,self.num_proposals,-1)
(2)可分离动态卷积注意力模块
<1>传统交叉注意力模块
如下图所示:
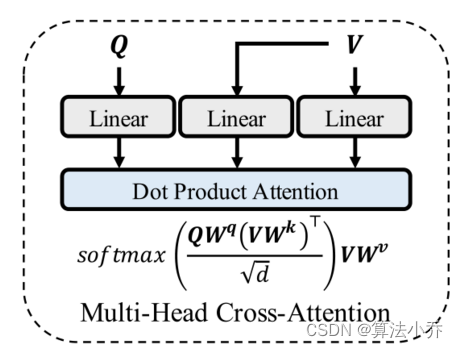
上图为传统的多头交叉注意力模块,将输入 Q和V sape[n,c] ,拆分为t个head,进行交叉注意力计算,公式如下:
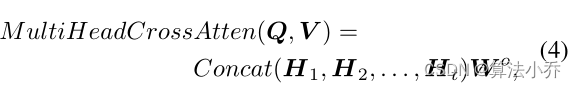
其中,Wo ,shape[c,c] 是一个线性映射矩阵,每个Head内部分注意力定义计算如下:
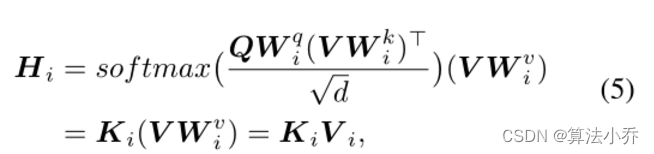
其中 shape均为 [c,c/t], 是 第i个Head的投影映射矩阵。结果中的Ki 表示相关矩阵,即Attention矩阵shape [b,n,n],Vi 表示 第i 个Head的输入特征,shape [b , n , c/t], Hi表示第i个Head的输出,shape为[b,n,c/t].
传统方法的不足:
虽然可以提升性能,但是计算量很大。
<2> 一维卷积进行多头交叉注意力
从上面叙述可知,多头交叉注意力主要涉及三个基本操作:多头映射 (如下图红色框)、 注意力计算(如下图绿色框)、 注意力融合(如下图蓝色框)
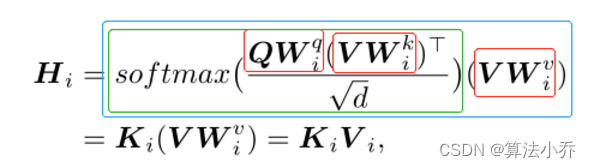
其中  表示将 Q 或 V 从维度 c 映射到维度为 c/t 的t个不同的Head中。而KiVi 表示 第i 个Head中,特征矩阵在不同proposal kernels中的交叉融合。
本文方法中,QV和KV的操作,我们采用1D 卷积代替,进行多头交叉注意力,使模块更为轻量化,如下图所示:
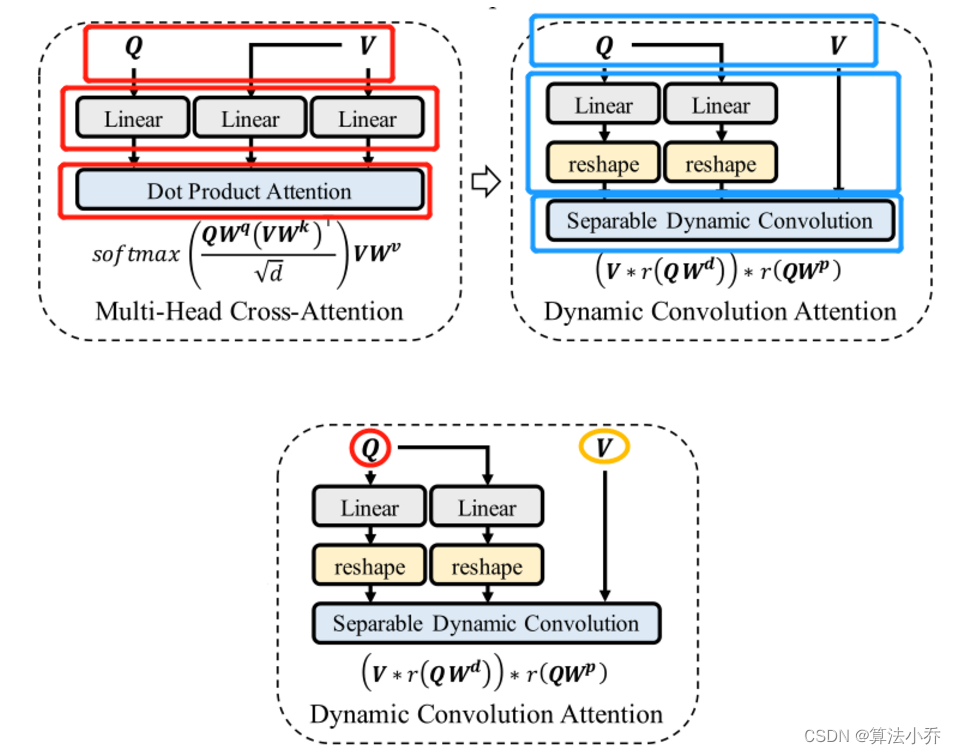
Q来自于上面Per-Attention中的Proposal Kernels 其shape为[n,c,1,1] -> expand[b,n,c,1,1] -> reshape [b,n,c] ,V 为 Per-Attention中得到的映射矩阵 其shape为[b,n,c]。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/132716.html