
前言
在使用爬虫时,高并发的请求很容易造成IP封禁,这个时候就需要用到代理ip访问来进行绕过了。构建代理池这里我用了两种方式:
- 第一种是github上的一个开源项目 proxy_pool
- 手动编写代码采集(只适合练手,推荐第一种)
一丶proxy_pool
安装步骤
1.下载
git clone https://github.com/jhao104/proxy_pool.git讯享网
2.下载依赖库
讯享网pip install -r requirements.txt
3.配置环境
安装redis,这里我直接用小皮面板安装了
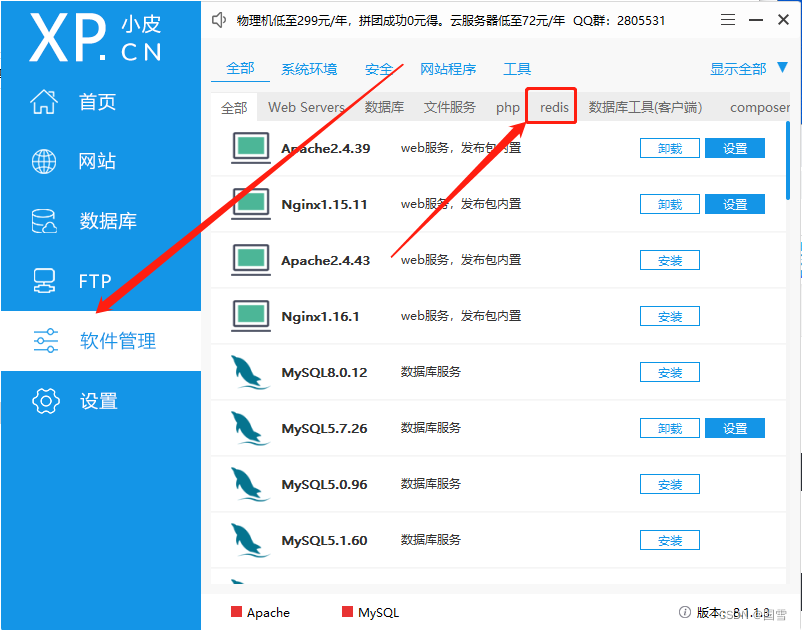
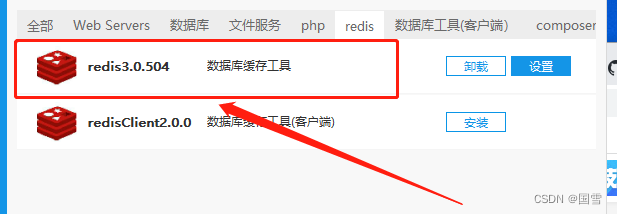
设置redis密码

配置setting.py文件

代理采集以及使用
python proxyPool.py schedule # 采集可用代理ip开启web服务
讯享网python proxyPool.py server
完成后可访问ip:端口/get单条代理ip,ip:端口/all所有可用代理ip
二丶手动采集
1.所用到的库requests,threadpool,bs4,random,json,time(以防请求过快导致ip封禁)
2.定义一个随机请求头部函数,伪装还是必须得要的啦
def req_headers(): ua_list = [ 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/30.0.1599.101', 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/38.0.2125.122', 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71', 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.95', 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/21.0.1180.71', 'Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; Download 732; .NET4.0C; .NET4.0E)', 'Mozilla/5.0 (Windows NT 5.1; U; en; rv:1.8.1) Gecko/ Firefox/2.0.0 Opera 9.50', 'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:34.0) Gecko/ Firefox/34.0', "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36", "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Maxthon/4.4.3.4000 Chrome/30.0.1599.101 Safari/537.36", "Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; Trident/4.0; SV1; Download 732; .NET4.0C; .NET4.0E; SE 2.X MetaSr 1.0)", "Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; WOW64; Trident/5.0; SLCC2; .NET CLR 2.0.50727; .NET CLR 3.5.30729; .NET CLR 3.0.30729; Media Center PC 6.0; .NET4.0C; .NET4.0E; Browser/7.0.3698.400)", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59", ] user_agent = random.choice(ua_list) num = range(1, 255) ip_num1 = random.choice(num) ip_num2 = random.choice(num) ip_num3 = random.choice(num) ip_num4 = random.choice(num) headers = { 'User-Agent': user_agent, # 随机生成一个ua 'X-Forward-for': "%d.%d.%d.%d" % (ip_num1, ip_num2, ip_num3, ip_num4) # 使用随机数生成随机来源ip } return headers # 返回一个随机头部3.代理ip查询
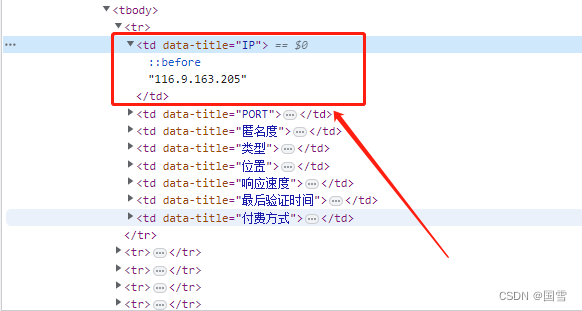
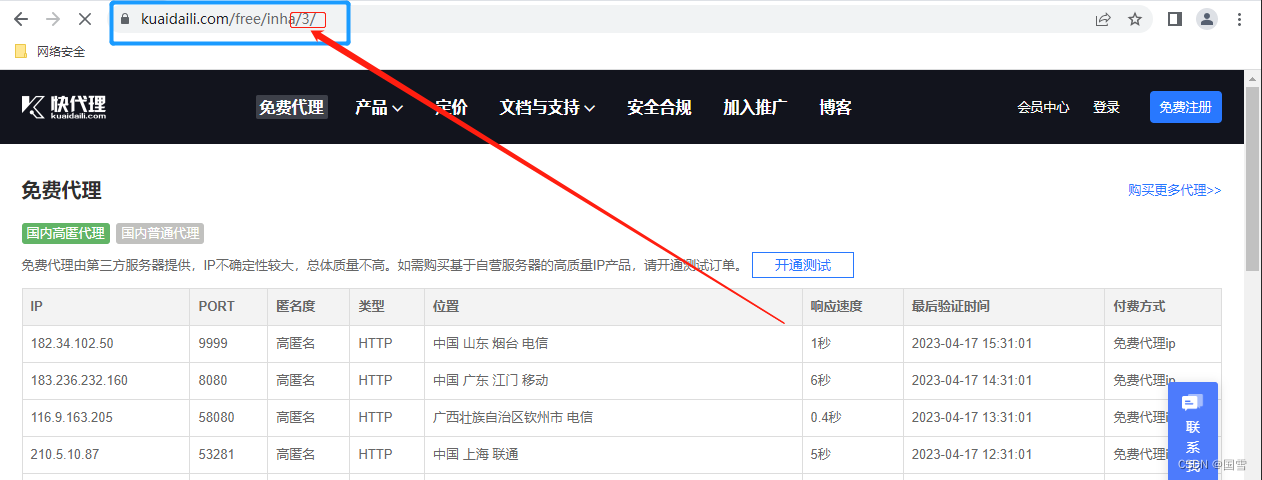
可以看到所有的数据都保存在了一个个的td标签中,在替换页数的时候url会随之变化,而我们需要的只有ip,port,类型将它裁剪出来然后放到文本中
讯享网def req(page):
    response = requests.get(f'https://www.kuaidaili.com/free/inha/{page}/', headers=req_headers(), verify=False)
    soup = BeautifulSoup(response.text, 'html.parser')
    url_pools = soup.find_all('tr')
    for url_ip in url_pools:
        pools = url_ip.text[1:].split()
        # print(f"'{pools[3].lower()}': '{pools[0]}:{pools[1]}'")
        with open('proxy.txt', 'a+') as f:
            f.write("{\"%s': \"%s://%s:%s\"}" % (pools[3].lower(), pools[3].lower(), pools[0], pools[1]) + '\n')
            f.close()
    time.sleep(1)
这里我没有加多线程跑,因为第一次跑被封ip了
4.代理ip测试
# 导入代理ip def proxy(): f = open('proxy.txt', 'r') proxy_pools = [] for url in f.readlines(): proxy_ip = url[:-1] proxy_ip = json.loads(proxy_ip) proxy_pools.append(proxy_ip) return proxy_pools # 发送请求 def check_url(proxies): headers = req_headers() time.sleep(1) try: response = requests.get('http://www.baidu.com', proxies=proxies, headers=headers, timeout=5, allow_redirects=False) print('=' * 15 + proxies + '=' * 15) if response.status_code == 200: print("============代理地址IP可用============") with open('ok.txt', 'a+') as f: f.write(proxies + '\n') else: print('error') except Exception: pass完整代码
讯享网import time
import requests
import json
import threadpool
from bs4 import BeautifulSoup
import random


# 生成随机头部
def req_headers():
    ua_list = [
        'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/30.0.1599.101',
        'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/38.0.2125.122',
        'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71',
        'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.95',
        'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/21.0.1180.71',
        'Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; Download 732; .NET4.0C; .NET4.0E)',
        'Mozilla/5.0 (Windows NT 5.1; U; en; rv:1.8.1) Gecko/20061208 Firefox/2.0.0 Opera 9.50',
        'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:34.0) Gecko/20100101 Firefox/34.0',
        "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36",
        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Maxthon/4.4.3.4000 Chrome/30.0.1599.101 Safari/537.36",
        "Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; Trident/4.0; SV1; Download 732; .NET4.0C; .NET4.0E; SE 2.X MetaSr 1.0)",
        "Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; WOW64; Trident/5.0; SLCC2; .NET CLR 2.0.50727; .NET CLR 3.5.30729; .NET CLR 3.0.30729; Media Center PC 6.0; .NET4.0C; .NET4.0E; Browser/7.0.3698.400)",
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59",
    ]
    user_agent = random.choice(ua_list)

    num = range(1, 255)
    ip_num1 = random.choice(num)
    ip_num2 = random.choice(num)
    ip_num3 = random.choice(num)
    ip_num4 = random.choice(num)

    headers = {
        'User-Agent': user_agent,
        'X-Forward-for': "%d.%d.%d.%d" % (ip_num1, ip_num2, ip_num3, ip_num4)
    }
    return headers


def proxy():
    f = open('proxy.txt', 'r')
    proxy_pools = []
    for url in f.readlines():
        proxy_ip = url[:-1]
        proxy_ip = json.loads(proxy_ip)
        proxy_pools.append(proxy_ip)
    return proxy_pools


def check_url(proxies):
    headers = req_headers()
    time.sleep(1)
    try:
        response = requests.get('http://zhihuiy.top', proxies=proxies, headers=headers, timeout=5,
                                allow_redirects=False)
        print('=' * 15 + proxies + '=' * 15)
        if response.status_code == 200:
            print("============代理地址IP可用============")
            with open('ok.txt', 'a+') as f:
                f.write(proxies + '\n')
        else:
            print('error')
    except Exception:
        pass

def req(page):
    print(f"===============正在爬取第{page}页===============")
    response = requests.get(f'https://www.kuaidaili.com/free/inha/{page}/', headers=req_headers(), verify=False)
    soup = BeautifulSoup(response.text, 'html.parser')
    url_pools = soup.find_all('tr')
    for url_ip in url_pools:
        pools = url_ip.text[1:].split()
        # print(f"'{pools[3].lower()}': '{pools[0]}:{pools[1]}'")
        with open('proxy.txt', 'a+') as f:
            f.write("{\"%s\": \"%s://%s:%s\"}" % (pools[3].lower(), pools[3].lower(), pools[0], pools[1]) + '\n')
            f.close()
    time.sleep(1)


def main():
    th_pools = threadpool.ThreadPool(50)
    pools = []
    for proxies in proxy():
        th = threadpool.makeRequests(check_url, (proxies,))
        pools.extend(th)
    for th in pools:
        th_pools.putRequest(th)
    th_pools.wait()

if __name__ == '__main__':
    for num in range(1, 4000):
        req(num)
    main()
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/82344.html