
Freivalds算法
一、问题引出:给定三个n x n 的矩阵A, B, C,如何判断A x B = C?
按照我们很自然的思维,首先需要计算出A x B的值,再与C进行比较。而这需要 O ( n 3 ) O(n^3) O(n3)的复杂度,显然,这种方法是效率很低的。
但是我们考虑到一个问题,这里并不是需要计算出A x B,而是只需要判断A x B与C是否相等,换句话说,判断他们是否相等并不是一定要计算出A x B的值。
而接下来介绍的Freivalds算法就是在不必计算出A x B的前提下判断出A x B==C?
二、Freivalds算法
首先,根据矩阵的特性我们知道,A x B = C的一个必要条件是:对于一个n x 1的向量r(r[i]=0 or 1),有A x B x r=C x r 。
如何理解上面这个必要条件呢?也就是说,由“如果A x B = C,则必然有A x B x r=C x r”,我们换成其逆否命题,即:如果A x B x r = C x r不成立,那么A × B = C就一定不成立。但是,那如果A x B x r = C x r成立,那么A × B = C就一定成立吗?,显然是不一定的,但是,幸运的是,有人证明出了A x B x r = C x r成立,而A × B = C不成立的概率是小于1/2的。
即: P ( A ∗ B ∗ r = C ∗ r , A ∗ B ! = C ) ≤ 1 / 2 P(A*B*r = C*r, A*B != C) ≤ 1/2 P(A∗B∗r=C∗r,A∗B!=C)≤1/2
因此,我们可以反复做出判断,重复判断k次,就可以把错误概率降低到 1 / 2 k 1/2^k 1/2k了。
比如下面这个例子:
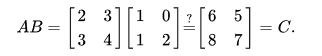
如果我们要判断上面的等式是否成立,则可以判断下面的等式是否等于零向量:
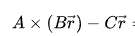
那么,我们可以先随机生成一个每个数值为0或者1的向量,
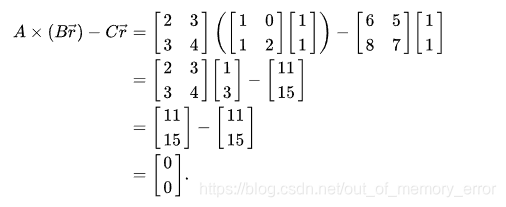
经过计算,其结果确实为零向量,但是现在如果下结论说A x B = C的话,错误的概率有1/2。于是,再随机生成一个向量:
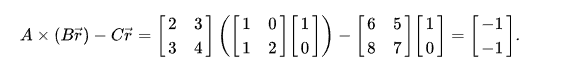
经过计算,发现其结果不等于零向量了,这时候,我们便可以下结论说A x B != C了。当然,如果这一次依然等于零向量的话,则错误概率降到了1/4,如果重复很多次,则错误概率会降低到很小很小,几乎不会发生了。
因此,可以用下面的Python代码来实现。
三、Python代码
from random import randint from sys import stdin def readint(): """ 按照输入规则,输入的第一个数为矩阵的维度 """ return int(stdin.readline()) def readarray(typ): """ 读入一行数据 """ return list(map(typ, stdin.readline().split())) def readmatrix(n): """ 读入矩阵 """ M = [] for _ in range(n): row = readarray(int) assert len(row) == n M.append(row) return M def mult(M, v): """ 矩阵与向量相乘 """ n = len(M) assert len(M) == len(v) return [sum(M[i][j] * v[j] for j in range(n)) for i in range(n)] def freivalds(A, B, C): """ freivalds算法 """ n = len(A) for i in range(10000): x = [randint(0, 1) for _ in range(n)] if not mult(A, mult(B, x)) == mult(C, x): return False else: return True if __name__ == "__main__": n = readint() A = readmatrix(n) B = readmatrix(n) C = readmatrix(n) print(freivalds(A, B, C)) 讯享网
上面的代码中有几点需要说明:
- 上述代码可以从文件读入数据作为输入。即通过下面命令可以运行:
讯享网
python freivalds.py < input.in其中,freivalds.py为Python文件名,input.in中存放的是待输入的数据。
- 读入数据的方式不是用的常见的input()函数,而是改用stdin.readline(),其目的是加快了读取速度。
- 经过试验证明,上述的代码还可以把freivalds(A, B, C)函数改写成如下:
def freivalds(A, B, C): """ freivalds算法 """ n = len(A) x = [randint(0, ) for _ in range(n)] return mult(A, mult(B, x)) == mult(C, x) 即,按照上文所说,r向量里面的每一个元素必须是0或者1,如此重复多次可以降低错误率到很小,但实际上,将r里面随机数的取值范围扩大,也可以在不必重复很多次的情况下降低错误率。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/80702.html