
问题一:只能读出部分信息
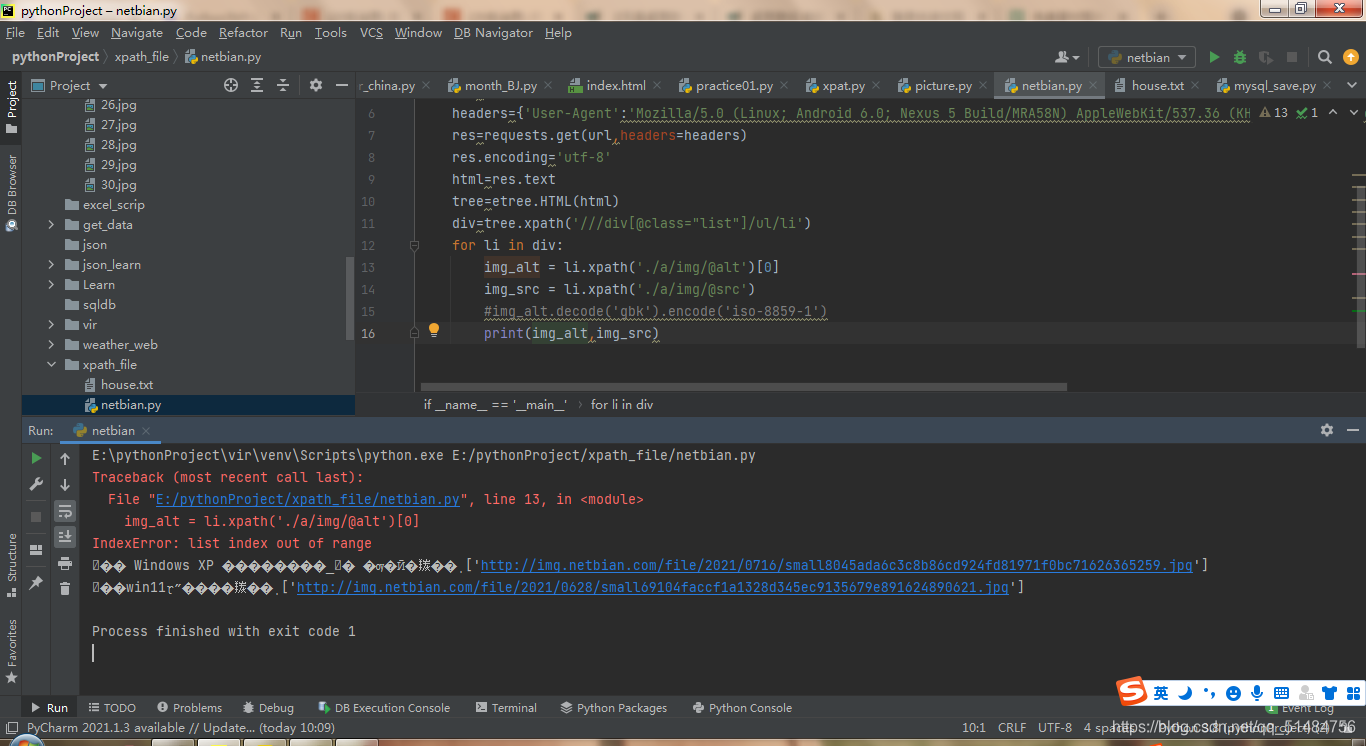
刚开始爬取只能爬出来前两张图片的信息,从第三张就开始报错
讯享网
原因是这个网址的第三张图片是一个有er围马的图片
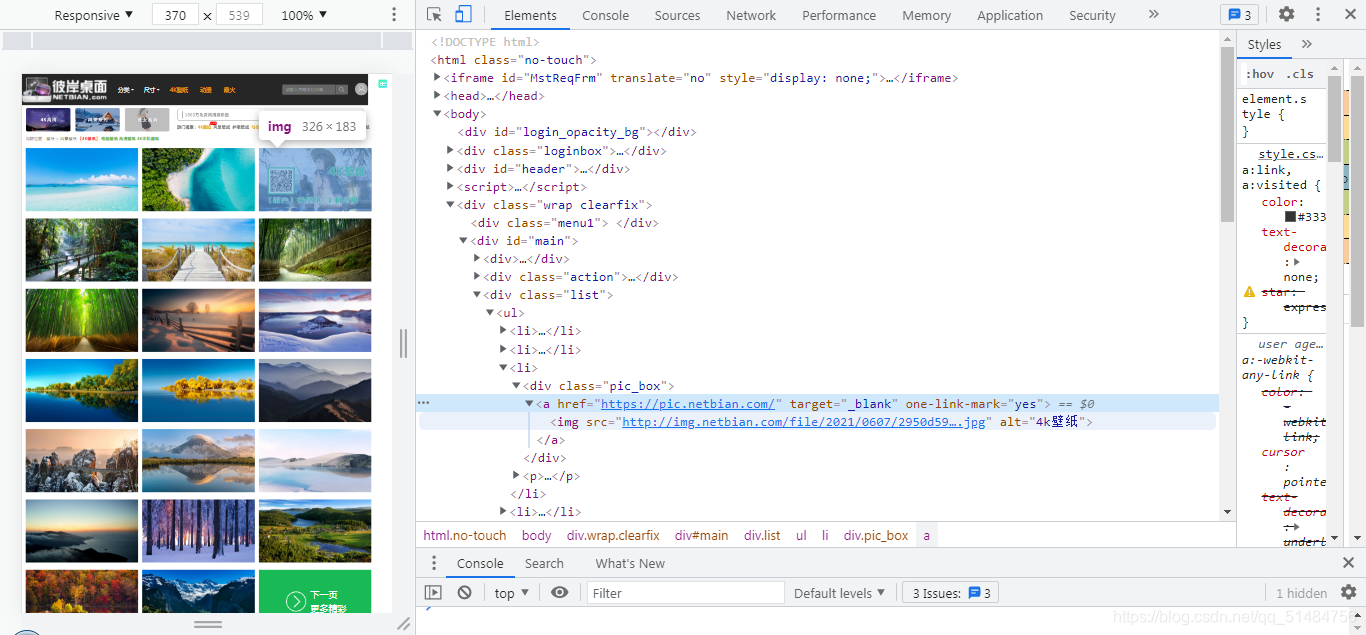
虽然html里面alt 和 src 看着正常但是和别的图片的读出来却不同
在这里就用try … except…来处理,跳过第三张。
问题二:读取的中文用utf-8仍然乱码
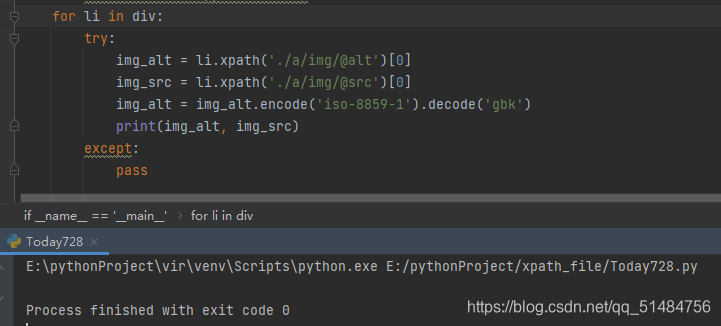
按照网上通用的改法发现它不报错,但是打印不出结果了
此时我改动了utf-8为gbk
res.encoding = ‘gbk’
然后就可以了
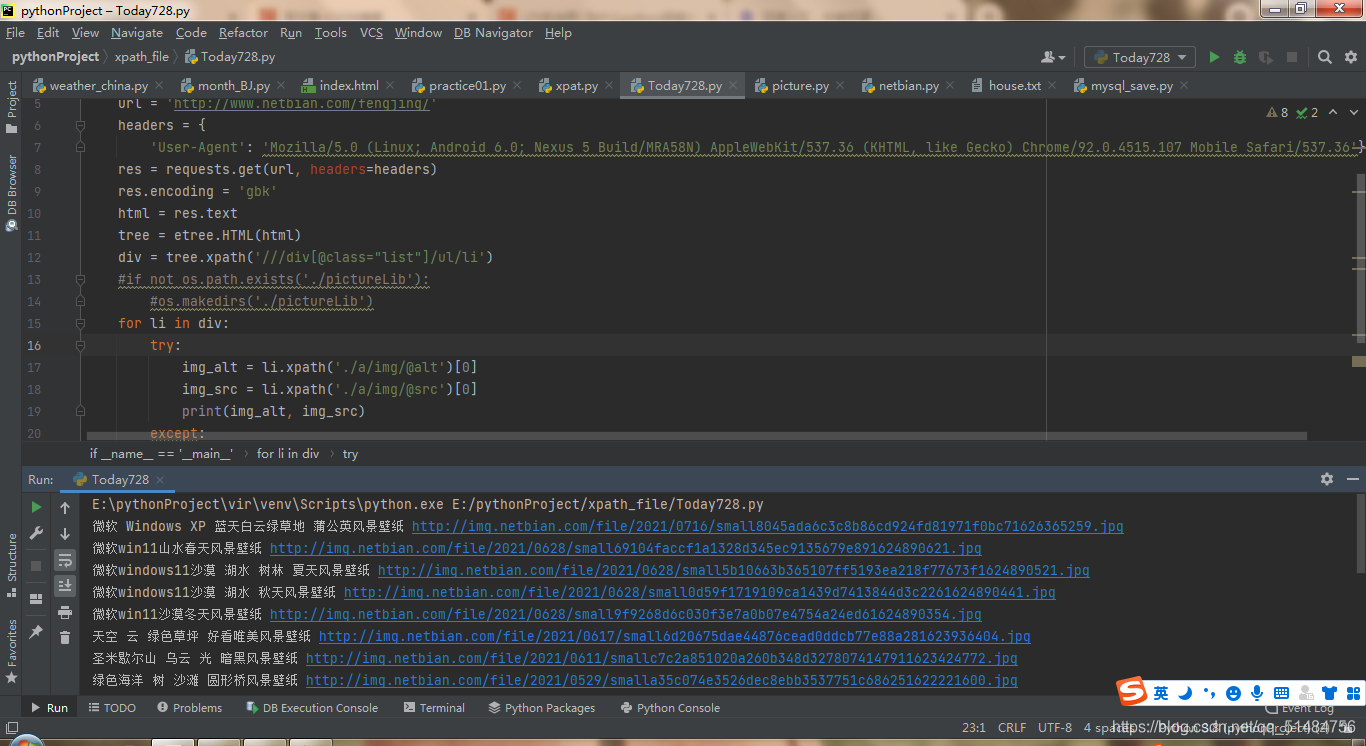
接下来将爬取的数据存入一个文件夹
完整代码如下:
import requests from lxml import etree import os if __name__ == '__main__': url = 'http://www.netbian.com/fengjing/' headers = {
    'User-Agent': 'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/92.0.4515.107 Mobile Safari/537.36'} res = requests.get(url, headers=headers) res.encoding = 'gbk'
    html = res.text tree = etree.HTML(html) div = tree.xpath('///div[@class="list"]/ul/li') if not os.path.exists('./pictureLib'): os.makedirs('./pictureLib') for li in div: try: img_alt = li.xpath('./a/img/@alt')[0]+'.jpg' img_src = li.xpath('./a/img/@src')[0] #print(img_alt, img_src) except: pass img_data=requests.get(url=img_src,headers=headers).content img_path='pictureLib/'+img_alt with open(img_path,'wb') as f: f.write(img_data) print(img_alt,'下载成功!!!')
讯享网
最终结果:
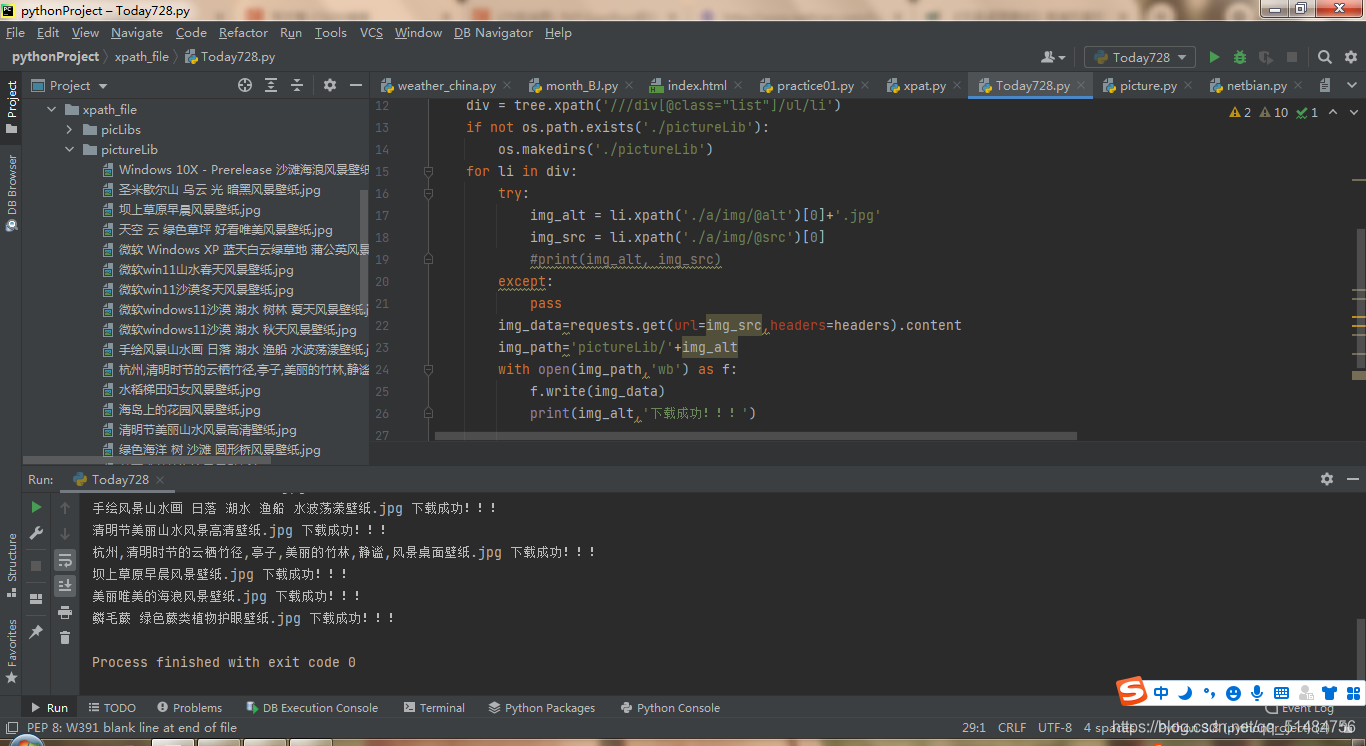
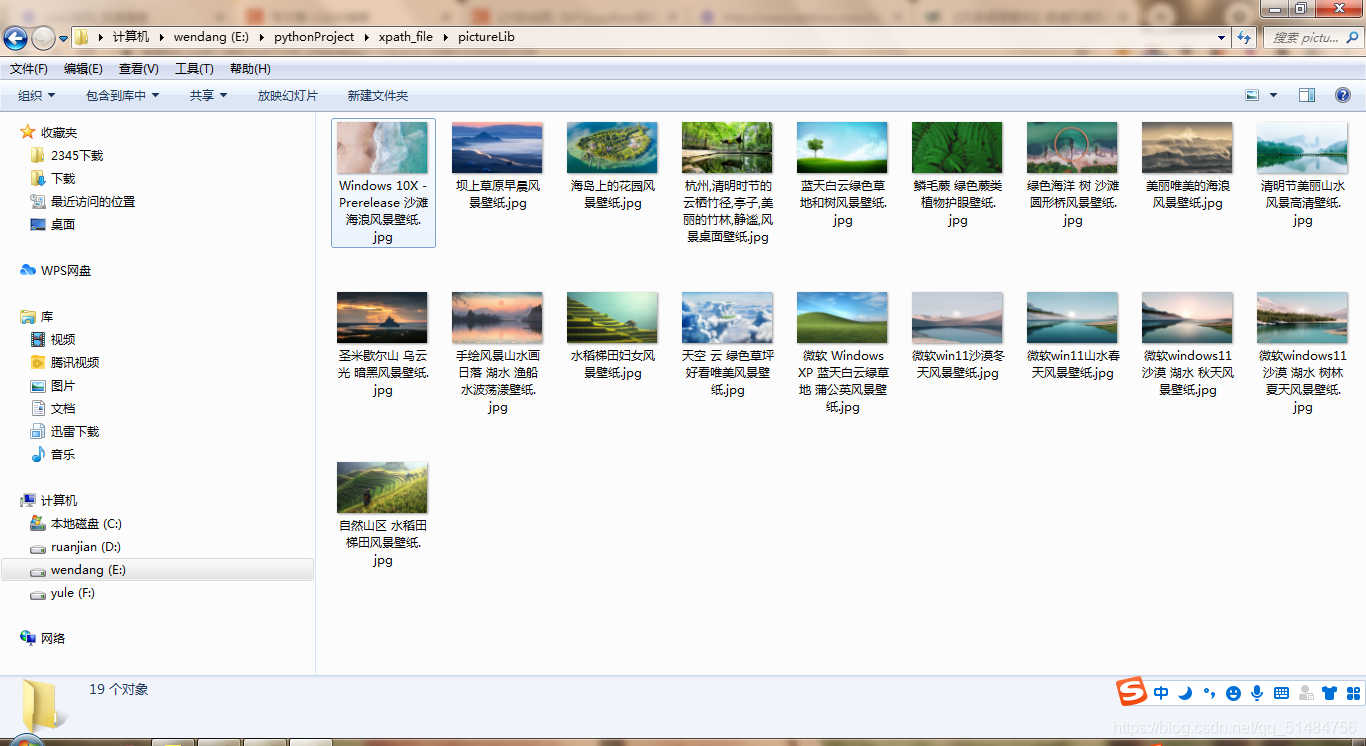
已经将网上的图片爬取并存入我的电脑E盘下了
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/76336.html