
import urllib.request import os import json import requests import time import re #今日囧图的编号,gif编号,视频编号 jinristr = "" #生成文件时要对文件名字做处理 def validateTitle(title): rstr = r"[\/\\\:\*\?\"\<\>\|]" # '/ \ : * ? " < > |' new_title = re.sub(rstr, "_", title) # 替换为下划线 return new_title #接口 url = "http://tu.duowan.com/index.php?r=show/getByGallery&gid=" #生成有参数的接口 url = url + jinristr + "&_=" + str(int(round(time.time() * 1000))) resp=requests.get(url) dataJson=json.loads(resp.content) listdaa=dataJson['picInfo'] listdaa.sort(key = lambda x:(int)(x['ding'])) str = '' #循环找到的数据 for i in listdaa: print(i['ding']) print(i['add_intro']) str = str+i['add_intro']+"\n" #在电脑中定义存放图片的位置并新建 path1='G:\\多玩爬取图片\\'+dataJson['gallery_title'] if os.path.exists(path1): pass else: os.makedirs(path1) #定义文件的连接 for i in listdaa: #后面的文件名应该是随着类型的不同而变化的 picpath = path1+'\\'+validateTitle(i['add_intro']+'.gif') if not os.path.exists(picpath): #下载 urllib.request.urlretrieve(i['source'], picpath) #写一个文本文件,里面放着他们的文件名字,这个其实没用的 txtpath = path1 + '\\1.txt' f = open(txtpath,'w') f.write(str) f.close() 讯享网
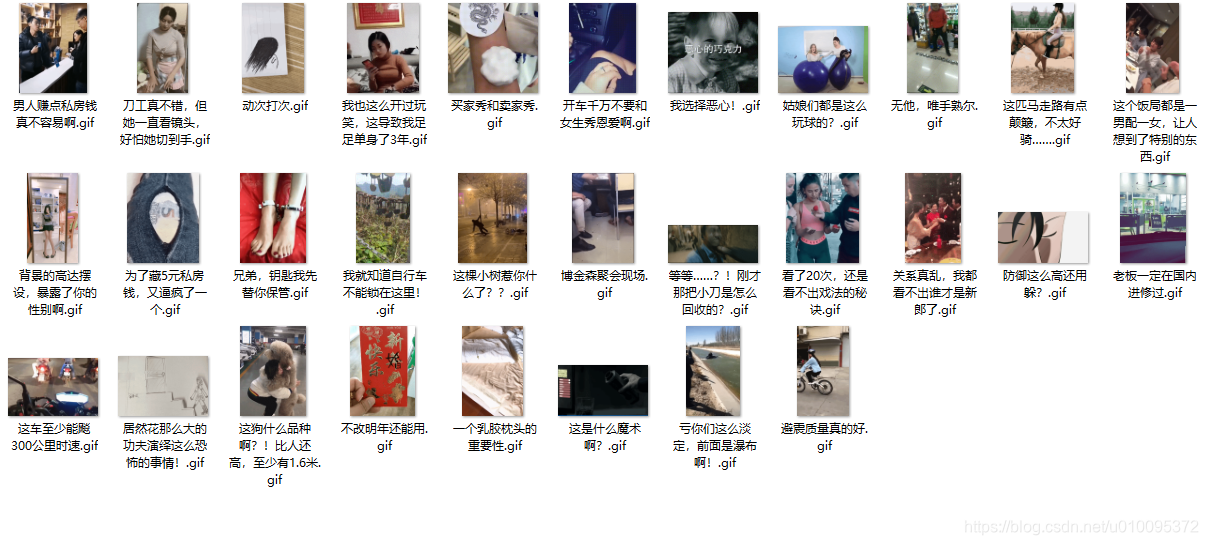
爬下来就这样子
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/76007.html