深度强化学习-策略梯度算法推导
引言
1 策略梯度算法推导
1.1 方法一
1.2 方法二
2 Reinforce算法
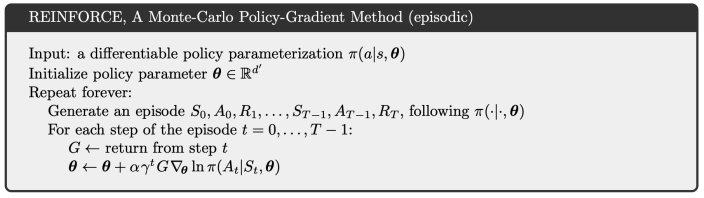
3 Reinforce算法伪代码
引言
之前我们讨论过DQN算法:深度强化学习-DQN算法原理与代码、Double DQN算法:深度强化学习-Double DQN算法原理与代码、Dueling DQN算法:深度强化学习-Dueling DQN算法原理与代码以及D3QN算法:深度强化学习-D3QN算法原理与代码,这些算法在求解最优策略的过程中试图估计最优价值函数,所以这些算法都被称为最优价值算法(optimal value algorithm)。
但是求解最优策略梯度不一定要估计最优价值函数,策略梯度算法(policy gradient algorithm)试图用含参函数近似最优策略,并通过迭代更新参数值。本文采用两种方法推导策略梯度算法,法一的推导过程比较简单,可以直观了解策略梯度算法的原理,但是不太严谨,具体可以参考李宏毅老师讲解PG算法的视频:Policy Gradient。法二的推导过程稍微复杂一点,但是推导过程严谨,Reinforce算法就是法二推导结果的直观体现。
1 策略梯度算法推导
强化学习的目标在于最大化累积期望回报,策略梯度算法给出了期望回报和策略梯度之间的关系。采用函数近似法估计最优策略

讯享网的基本思想是用含参函数
来近似最优策略。
1.1 方法一
假设智能体与环境交互一次的经验轨迹为
,T为终止时刻,即

本次交互的累积回报为

本次经验轨迹出现的概率为

其中,
和
由环境决定,与
无关。
真实的累积回报为采样得到累积回报的期望,即累积期望回报为
![\bar{R_{\theta }}=E_{\tau \sim P_{\theta }(\tau )}\left [ R_{\tau } \right ]=\sum_{\tau }^{}R(\tau )P_{\theta }(\tau )](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
对
关于
求梯度,得到

注意:式中的
其实与参数
有关,但是推导时假定无关,没有算入梯度,因此不太严谨,不过并不影响对策略梯度算法的理解,严谨的推导见方法二。
由于
那么
![\triangledown \bar{R_{\theta }}=\sum_{\tau }^{}R(\tau )P_{\theta }(\tau )\triangledown lnP_{\theta }(\tau )=E_{\tau \sim P_{\theta }(\tau )}\left [ R(\tau )\triangledown lnP_{\theta }(\tau ) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
上面求和符号可以通过采样消除,即N次采样后,得到

对
求对数,得到
![lnP_{\theta }(\tau )=lnp(s_{0})+ln\pi _{\theta }(a_{0}\mid s_{0})+lnp(s_{1}\mid s_{0},a_{0})+ln\pi _{\theta }(a_{1}\mid s_{1})+\cdots +ln\pi_{\theta }(a_{T-1}\mid s_{T-1})+lnp(s_{T}\mid s_{T-1},a_{T-1})=lnp(s_{0})+\sum_{t=0}^{T-1}\left [ ln\pi_{\theta }(a_{t}\mid s_{t})+lnp(s_{t+1}\mid s_{t},a_{t}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
对
关于
求梯度,由于
与
无关,因此全部被消掉,得到

将
代入
,得到
策略梯度:
至此,我们完成了策略梯度算法的推导,沿着
的方向改变策略参数
,就有机会增加累积期望回报。不过,策略梯度公式中有一个需要注意的地方,
表示的是整条轨迹的累积回报,并非即时回报。
1.2 方法二
策略
满足Bellman期望方程
Bellman期望方程:
对以上两式关于
求梯度,得到


将
代入
,得到
![\triangledown v_{\pi _{\theta }}(s)=\sum_{a}^{}q_{\pi _{\theta }}(s,a)\triangledown \pi _{\theta }(a\mid s)+\sum_{a}^{}\pi _{\theta }(a\mid s)\gamma \sum_{s{}'}^{}p(s{}'\mid s,a)\triangledown v_{\pi _{\theta }}(s{}')=\sum_{a}^{}q_{\pi _{\theta }}(s,a)\triangledown \pi _{\theta }(a\mid s)+\sum_{s{}'}^{}Pr_{\theta }\left [ S_{t+1}=s{}'\mid S_{t}=s \right ]\gamma \triangledown v_{\pi _{\theta }}(s{}')](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
在策略
下,当
时求上式的期望,得到
![E\left [ \triangledown v_{\pi _{\theta }}(S_{t}) \right ]=\sum_{s}^{}Pr\left [ S_{t}=s \right ]\triangledown v_{\pi _{\theta }}(S_{t})](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=\sum_{s}^{}Pr\left [ S_{t}=s \right ]\left [ \sum_{a}^{}q_{\pi _{\theta }}(s,a)\triangledown \pi _{\theta }(a\mid s)+\sum_{s{}'}^{}Pr_{\theta }\left [ S_{t+1}=s{}'\mid S_{t}=s \right ]\gamma \triangledown v_{\pi _{\theta }}(s{}') \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=\sum_{s}^{}Pr\left [ S_{t}=s \right ]\sum_{a}^{}q_{\pi _{\theta }}(s,a)\triangledown \pi _{\theta }(a\mid s)](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![+\sum_{s}^{}Pr\left [ S_{t}=s \right ]\sum_{s{}'}^{}Pr_{\theta }\left [ S_{t+1}=s{}'\mid S_{t}=s \right ]\gamma \triangledown v_{\pi _{\theta }}(s{}')](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=\sum_{s}^{}Pr\left [ S_{t}=s \right ]\sum_{a}^{}q_{\pi _{\theta }}(s,a)\triangledown \pi _{\theta }(a\mid s)+\gamma\sum_{s{}'}^{}Pr_{\theta }\left [ S_{t+1}=s{}' \right ]\triangledown v_{\pi _{\theta }}(s{}')](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=E\left [ \sum_{a}^{}q_{\pi _{\theta }}(S_{t},a)\triangledown \pi _{\theta }(a\mid S_{t}) \right ]+\gamma E\left [ \triangledown v_{\pi _{\theta }}(S_{t+1}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
这样就得到了从
到
的递推式。注意到最终关注的梯度值就是
![\triangledown E_{\pi _{\theta }}\left [ G_{0} \right ]=\triangledown E\left [ v_{\pi _{\theta }}(S_{0}) \right ]=E\left [ \triangledown v_{\pi _{\theta }}(S_{0}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
所以有
![\triangledown E_{\pi _{\theta }}\left [ G_{0} \right ]=E\left [ \triangledown v_{\pi _{\theta }}(S_{0}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=E\left [ \sum_{a}^{}q_{\pi _{\theta }}(S_{0},a)\triangledown \pi _{\theta }(a\mid S_{0}) \right ]+\gamma E\left [ \triangledown v_{\pi _{\theta }}(S_{1}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=E\left [ \sum_{a}^{}q_{\pi _{\theta }}(S_{0},a)\triangledown \pi _{\theta }(a\mid S_{0}) \right ]+E\left [ \gamma \sum_{a}^{}q_{\pi _{\theta }}(S_{1},a)\triangledown \pi _{\theta }(a\mid S_{1}) \right ]+\gamma^{2} E\left [ \triangledown v_{\pi _{\theta }}(S_{2}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)

![=\sum_{t=0}^{+\infty }E\left [ \gamma ^{t}q_{\pi _{\theta }}(S_{t},a)\triangledown \pi _{\theta }(a\mid S_{t}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
考虑到

所以
![E\left [ \gamma ^{t}q_{\pi _{\theta }}(S_{t},a)\triangledown \pi _{\theta }(a\mid S_{t}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=E\left [ \sum_{a}^{}\pi _{\theta }(a\mid S_{t})\gamma ^{t}q_{\pi _{\theta }}(S_{t},a)\triangledown ln\pi _{\theta }(a\mid S_{t}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
![=E\left [ \gamma ^{t}q_{\pi _{\theta }}(S_{t},A_{t})\triangledown ln\pi _{\theta }(A_{t}\mid S_{t}) \right ]](https://51itzy.com/uploads/202412/23/d8d6e00325d3a7fb.jpg)
又由于
,所以
因此
策略梯度:
2 Reinforce算法
在每一个回合结束后,就回合中的每一步利用如下迭代式更新

这样的算法称为简单的策略梯度算法,R.Willims称它为“REward Increment=Nonnegative Factor x Offset Reinforcement x Characteristic Eligibility”(REINFORCE),表示增量
是由三个部分的积组成。这样迭代完这个回合轨迹就实现了

在具体的更新过程中,不一定要严格采用这样的形式。当采用自动微分的软件包来学习参数时,可以定义单步的损失为
,让软件包中的优化器减小整个回合中所有步的平均损失,就会沿着
的梯度方向更新参数
。
3 Reinforce算法伪代码


版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/75608.html