
目录
1 特征工程是什么?
2 特征工程的流程
3 机器学习中的特征
3.1 特征(Feature)
3.2 特征的重要性(Feature Importance)
4 数据预处理
4.1 无量纲化
4.1.1 标准化
4.1.2 区间缩放法
4.1.3 标准化与归一化的区别
4.2 对定量特征二值化
4.3 对定性特征哑编码
4.4 缺失值计算
4.5 数据变换
5 特征构建
6 特征提取
6.1 PCA主成分分析
6.2 LDA线性判别分析
6.3 ICA独立成分分析
7 特征选择
7.1 Filter
7.1.1 方差选择法
7.1.2 相关系数法
7.1.3 卡方检验
7.1.4 互信息法
7.2 Wrapper
7.2.1 递归特征消除法
7.3 Embedded
7.3.1 基于惩罚项的特征选择法
7.3.2 基于树模型的特征选择法
8 特征提取与特征选择
8.1 区别与联系
8.2 准则性质总结
1 特征工程是什么?
有这么一句话在业界广泛流传:数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已。那特征工程到底是什么呢?顾名思义,其本质是一项工程活动,目的是最大限度地从原始数据中提取特征以供算法和模型使用。通过总结和归纳,人们认为特征工程包括以下方面:
特征工程能使得模型的性能得到提升,有时甚至在简单的模型上也能取得不错的效果。特征工程在机器学习中占有非常重要的作用,一般认为括特征构建、特征提取、特征选择三个部分。特征构建比较麻烦,需要一定的经验。 特征提取与特征选择都是为了从原始特征中找出最有效的特征。它们之间的区别是特征提取强调通过特征转换的方式得到一组具有明显物理或统计意义的特征;而特征选择是从特征集合中挑选一组具有明显物理或统计意义的特征子集。两者都能帮助减少特征的维度、数据冗余,特征提取有时能发现更有意义的特征属性,特征选择的过程经常能表示出每个特征的重要性对于模型构建的重要性。
2 特征工程的流程
(1)机器学习中数据的转换过程:
- 选择数据:收集整合数据,将数据规划化为一个数据集
- 预处理数据:对数据进行清洗、格式化、采样
- 转换数据:特征工程所在
- 对数据建模:构建模型、评估模型、调整模型
(2)特征工程的迭代过程:
- 对特征进行头脑风暴:深入分析问题,观察数据特点,参考其他问题的有关特征工程的方法并应用到自己问题中
- 特征的设计:你可以自动提取特征,手动构造特征,或将两者相结合
- 特征选择:使用不同的特征重要性评分方法或特征选择方法
- 评估模型:利用所选择的特征对测试数据进行预测,评估模型准确性
3 机器学习中的特征
3.1 特征(Feature)
在机器学习和模式识别中,特征是在观测现象中的一种独立、可测量的属性。选择信息量大的、有差别性的、独立的特征是模式识别、分类和回归问题的关键一步。 最初的原始特征数据集可能太大,或者信息冗余,因此在机器学习的应用中,一个初始步骤就是选择特征的子集,或构建一套新的特征集,减少功能来促进算法的学习,提高泛化能力和可解释性。在表格数据中,观测数据或实例(对应表格的一行)由不同的变量或者属性(表格的一列)构成,这里属性其实就是特征。但是与属性一词不同的是,特征是对于分析和解决问题有用、有意义的属性。
在机器视觉中,一幅图像是一个观测,但是特征可能是图中的一条线;在自然语言处理中,一个文本是一个观测,但是其中的段落或者词频可能才是一种特征;在语音识别中,一段语音是一个观测,但是一个词或者音素才是一种特征。
3.2 特征的重要性(Feature Importance)
你可以客观的评价特征的实用性。判别特征的重要性是对特征进行选择的预先指标,特征根据重要性被分配分数,然后根据分数不同进行排序,其中高分的特征被选择出来放入训练数据集。如果与因变量(预测的事物)高度相关,则这个特征可能很重要,其中相关系数和独立变量方法是常用的方法。
在构建模型的过程中,一些复杂的预测模型会在算法内部进行特征重要性的评价和选择,如多元自适应回归样条法(Multivariate Adaptive Regression Splines, MARS)、随机森林(Random Forest)、梯度提升机(Gradient Boosted Machines)。这些模型在模型准备阶段会进行变量重要性的确定。
4 数据预处理
未经处理的特征可能有以下问题:
- 不属于同一量纲:即特征的规格不一样,不能够放在一起比较。无量纲化可以解决这一问题。
- 信息冗余:对于某些定量特征,其包含的有效信息为区间划分,例如学习成绩,假若只关心“及格”或不“及格”,那么需要将定量的考分,转换成“1”和“0”表示及格和未及格。二值化可以解决这一问题。
- 定性特征不能直接使用:某些机器学习算法和模型只能接受定量特征的输入,那么需要将定性特征转换为定量特征。最简单的方式是为每一种定性值指定一个定量值,但是这种方式过于灵活,增加了调参的工作。通常使用哑编码的方式将定性特征转换为定量特征:假设有N种定性值,则将这一个特征扩展为N种特征,当原始特征值为第i种定性值时,第i个扩展特征赋值为1,其他扩展特征赋值为0。哑编码的方式相比直接指定的方式,不用增加调参的工作,对于线性模型来说,使用哑编码后的特征可达到非线性的效果。
- 存在缺失值:缺失值需要补充。
- 信息利用率低:不同的机器学习算法和模型对数据中信息的利用是不同的,之前提到在线性模型中,使用对定性特征哑编码可以达到非线性的效果。类似地,对定量变量多项式化,或者进行其他的转换,都能达到非线性的效果。
我们使用sklearn中的preproccessing库来进行数据预处理,可以覆盖以上问题的解决方案。
4.1 无量纲化
无量纲化使不同规格的数据转换到同一规格。常见的无量纲化方法有标准化和区间缩放法。标准化的前提是特征值服从正态分布,标准化后,其转换成标准正态分布。区间缩放法利用了边界值信息,将特征的取值区间缩放到某个特点的范围,例如[0, 1]等。
4.1.1 标准化
标准化需要计算特征的均值和标准差,公式表达为:

使用preproccessing库的StandardScaler类对数据进行标准化的代码如下:
from sklearn.preprocessing import StandardScaler #标准化,返回值为标准化后的数据 StandardScaler().fit_transform(iris.data)讯享网
在数据分析与挖掘、算法建模的都会用到数据标准化。数据的标准化(normalization)是将数据按比例缩放,使之落入一个小的特定区间。在某些比较和评价的指标处理中经常会用到,去除数据的单位限制,将其转化为无量纲的纯数值,便于不同单位或量级的指标能够进行比较和加权。
但是经常会遇到一个问题:
- 方式一:先对整个数据集数据标准化后再划分训练集、测试集
- 方式二:先对训练集标准化再将规则用于测试集
为什么这么做?这两种方式有什么区别?
如果是做案例类学习研究,由于数据量是固定的,其实这两种方式不会有太大的区别;但是在实际的业务应用中,第二种方式还是会比第一种方式更可靠,因为会有实时的数据集进来应用模型,而这时的数据处理规则仍然采用建模前的规则会有一定的容错率。
可以思考一下:
第一种方式,先对整个数据集进行标准化之后,假设标准化规则的最大值为100,最小值为1,使数据的最大值为1,最小值为0.05,再将其划分为训练集和测试集,此时训练集或者测试集是同一个规则。
第二种方式:先对训练级标准化再将规则用于测试集,本身训练集和测试集的极值(最大值,最小值)会不同,例如训练集最大值为100,标准化之后为1,而测试集最大值为200,按训练集的标准化规则为1.5,而如果用测试集的标准化规则就会为1。但此时的模型会将1看做100,而不是200,会造成误差,并且有实时数据来应用模型,采用训练集的标准化规则,更适合于模型。
讯享网from sklearn.model_selection import train_test_split data_tr1,data_te1,target_tr,target_te = train_test_split(media_rfm.iloc[:,3:9],media_rfm['class'],test_size=0.2,random_state=10) from sklearn.preprocessing import StandardScaler stdScale = StandardScaler().fit(data_tr1) 生成规则 data_tr = stdScale.transform(data_tr1) 将规则应用于训练集 data_te = stdScale.transform(data_te1) 将规则应用于测试集
4.1.2 区间缩放法
区间缩放法的思路有多种,常见的一种为利用两个最值进行缩放,公式表达为:
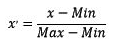
使用preproccessing库的MinMaxScaler类对数据进行区间缩放的代码如下:
from sklearn.preprocessing import MinMaxScaler #区间缩放,返回值为缩放到[0, 1]区间的数据 MinMaxScaler().fit_transform(iris.data)4.1.3 标准化与归一化的区别
简单来说,标准化是依照特征矩阵的列处理数据,其通过求z-score的方法,将样本的特征值转换到同一量纲下。归一化是依照特征矩阵的行处理数据,其目的在于样本向量在点乘运算或其他核函数计算相似性时,拥有统一的标准,也就是说都转化为“单位向量”。规则为l2的归一化公式如下:

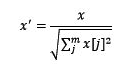
使用preproccessing库的Normalizer类对数据进行归一化的代码如下:
讯享网from sklearn.preprocessing import Normalizer #归一化,返回值为归一化后的数据 Normalizer().fit_transform(iris.data)
在机器学习中,标准化是更常用的手段,归一化的应用场景是有限的。原因如下:
- 标准化更好保持了样本间距。当样本中有异常点时,归一化有可能将正常的样本“挤”到一起去。比如三个样本,某个特征的值为1,2,10000,假设10000这个值是异常值,用归一化的方法后,正常的1,2就会被“挤”到一起去。如果不幸的是1和2的分类标签还是相反的,那么,当我们用梯度下降来做分类模型训练时,模型会需要更长的时间收敛,因为将样本分开需要更大的努力!而标准化在这方面就做得很好,至少它不会将样本“挤到一起”。
- 标准化更符合统计学假设。
对一个数值特征来说,很大可能它是服从正态分布的。标准化其实是基于这个隐含假设,只不过是略施小技,将这个正态分布调整为均值为0,方差为1的标准正态分布而已。
逻辑回归必须要进行标准化吗?
答:这取决于我们的逻辑回归是不是用正则。如果你不用正则,那么,标准化并不是必须的,如果你用正则,那么标准化是必须的。
因为不用正则时,我们的损失函数只是仅仅在度量预测与真实的差距,加上正则后,我们的损失函数除了要度量上面的差距外,还要度量参数值是否足够小。而参数值的大小程度或者说大小的级别是与特征的数值范围相关的。举例来说,我们用体重预测身高,体重用kg衡量时,训练出的模型是:
身高 = 体重*x
x就是我们训练出来的参数。
当我们的体重用吨来衡量时,x的值就会扩大为原来的1000倍。
在上面两种情况下,都用L1正则的话,显然对模型的训练影响是不同的。
假如不同的特征的数值范围不一样,有的是0到0.1,有的是100到10000,那么,每个特征对应的参数大小级别也会不一样,在L1正则时,我们是简单将参数的绝对值相加,因为它们的大小级别不一样,就会导致L1最后只会对那些级别比较大的参数有作用,那些小的参数都被忽略了。
如果你回答到这里,面试官应该基本满意了,但是他可能会进一步考察你,如果不用正则,那么标准化对逻辑回归有什么好处吗?
答案是有好处,进行标准化后,我们得出的参数值的大小可以反应出不同特征对样本label的贡献度,方便我们进行特征筛选。如果不做标准化,是不能这样来筛选特征的。
答到这里,有些厉害的面试官可能会继续问,做标准化有什么注意事项吗?
最大的注意事项就是先拆分出test集,不要在整个数据集上做标准化,因为那样会将test集的信息引入到训练集中,这是一个非常容易犯的错误!?
4.2 对定量特征二值化
定量特征二值化的核心在于设定一个阈值,大于阈值的赋值为1,小于等于阈值的赋值为0,公式表达如下:
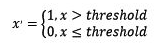
使用preproccessing库的Binarizer类对数据进行二值化的代码如下:
from sklearn.preprocessing import Binarizer #二值化,阈值设置为3,返回值为二值化后的数据 Binarizer(threshold=3).fit_transform(iris.data)4.3 对定性特征哑编码
由于IRIS数据集的特征皆为定量特征,故使用其目标值进行哑编码(实际上是不需要的)。使用preproccessing库的OneHotEncoder类对数据进行哑编码的代码如下:
讯享网from sklearn.preprocessing import OneHotEncoder #哑编码,对IRIS数据集的目标值,返回值为哑编码后的数据 OneHotEncoder().fit_transform(iris.target.reshape((-1,1)))
4.4 缺失值计算
使用preproccessing库的Imputer类对数据进行缺失值计算的代码如下(由于IRIS数据集没有缺失值,故对数据集新增一个样本,4个特征均赋值为NaN,表示数据缺失。):
from numpy import vstack, array, nan from sklearn.preprocessing import Imputer #缺失值计算,返回值为计算缺失值后的数据 #参数missing_value为缺失值的表示形式,默认为NaN #参数strategy为缺失值填充方式,默认为mean(均值) Imputer().fit_transform(vstack((array([nan, nan, nan, nan]), iris.data))) 4.5 数据变换
常见的数据变换有基于多项式的、基于指数函数的、基于对数函数的。4个特征,度为2的多项式转换公式如下:
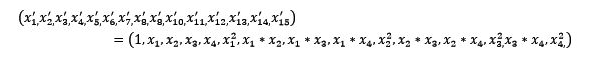
使用preproccessing库的PolynomialFeatures类对数据进行多项式转换的代码如下:
讯享网from sklearn.preprocessing import PolynomialFeatures #多项式转换 #参数degree为度,默认值为2 PolynomialFeatures().fit_transform(iris.data)
基于单变元函数的数据变换可以使用一个统一的方式完成,使用preproccessing库的FunctionTransformer对数据进行对数函数转换的代码如下:
from numpy import log1p from sklearn.preprocessing import FunctionTransformer #自定义转换函数为对数函数的数据变换 #第一个参数是单变元函数 FunctionTransformer(log1p).fit_transform(iris.data) 5 特征构建
特征构建是指从原始数据中人工地找出一些具有物理意义的特征。需要花时间去观察原始数据,思考问题的潜在形式和数据结构,对数据敏感性和机器学习实战经验能帮助特征构建。除此之外,属性分割和结合是特征构建时常使用的方法。结构性的表格数据,可以尝试组合二个、三个不同的属性构造新的特征,如果存在时间相关属性,可以划出不同的时间窗口,得到同一属性在不同时间下的特征值,也可以把一个属性分解或切分,例如将数据中的日期字段按照季度和周期后者一天的上午、下午和晚上去构建特征。总之特征构建是个非常麻烦的问题,书里面也很少提到具体的方法,需要对问题有比较深入的理解。
6 特征提取
特征提取:将原始特征转换为一组具有明显物理意义(Gabor、几何特征[角点、不变量]、纹理[LBP HOG])或者统计意义或核的特征。特征提取是自动地对原始观测降维,使其特征集合小到可以进行建模的过程。
对于表格式数据,可以使用主元素分析(Principal Component Analysis)、聚类等映射方法;对于图像数据,可以进行线(line)或边缘(edge)的提取;根据相应的领域,图像、视频和音频数据可以有很多数字信号处理的方法对其进行处理。
6.1 PCA主成分分析
详见:https://mp.csdn.net/postedit/
PCA的思想是通过坐标轴转换,寻找数据分布的最优子空间,从而达到降维、去相关的目的。下面的图原始数据二维特征,三分类问题,左图是原始数据。进行PCA特征转换,第一个新坐标轴选择的是原始数据中方差最大的方向(线B),第二个新坐标轴与第一个坐标轴正交且具有最大方差的方向(线C),当特征维度较多时,重复上述过程,会发现大部分的方差都包含在前几个新的坐标轴中,通过选择保留前N个坐标轴达到降维的效果。下面中上是特征转换的图,中下是降维后的图。在数学上,是先用原始数据协方差矩阵的前N个最大特征值对应的特征向量构成映射矩阵,然后原始矩阵左乘映射矩阵,从而对原始数据降维。下图右面列出了两个随机变量之间协方差的计算公式、怎么计算矩阵的协方差矩阵、矩阵的特征值、特征向量。特征向量可以理解为坐标准换中的新坐标轴的方向,特征值表示矩阵在对应的特征向量上的方差,特征值越大,方差越大,信息量越多。
使用decomposition库的PCA类选择特征的代码如下:
讯享网from sklearn.decomposition import PCA #主成分分析法,返回降维后的数据 #参数n_components为主成分数目 PCA(n_components=2).fit_transform(iris.data)
6.2 LDA线性判别分析
详见:https://mp.csdn.net/postedit/
LDA的原理是将带上标签的数据(点),通过投影的方法,投影到维度更低的空间,使得投影后的点,会形成按类别区分,相同类别的点,将会在投影后更接近,不同类别的点距离越远。skearn网站上面有个例子介绍PCA与LDA的区别,分别通过PCA和LDA将4维特征三分类的Iris数据降维为2维特征,然后再进行分类,效果差不多,可视化出来发现有些不同,毕竟降维方式有些不同。
LDA算法的主要步骤:
1:分别计算每个类别i的原始中心点
2:类别i投影后的中心点为:
3.衡量类别i投影后,类别点之间的分散程度,用方差来表示:
4.使用下面的式子表示LDA投影到w后的损失函数,最大化J(W)就可以求出最优的w:
使用lda库的LDA类选择特征的代码如下:
from sklearn.lda import LDA #线性判别分析法,返回降维后的数据 #参数n_components为降维后的维数 LDA(n_components=2).fit_transform(iris.data, iris.target)6.3 ICA独立成分分析
PCA特征转换降维,提取的是不相关的部分,ICA独立成分分析,获得的是相互独立的属性。ICA算法本质寻找一个线性变换z = Wx,使得z的各个特征分量之间的独立性最大。ICA相比与PCA更能刻画变量的随机统计特性,且能抑制噪声。ICA算法听着有点绕,ICA认为观测到数据矩阵X是可以由未知的独立元举证S与未知的矩阵A相乘得到。ICA希望通过矩阵X求得一个分离矩阵W,使得W作用在X上所获得的矩阵Y能够逼近独立源矩阵S,最后通过独立元矩阵S表示矩阵X,所以说ICA独立成分分析提取出的特征中的独立部分。
7 特征选择
当数据预处理完成后,我们需要选择有意义的特征输入机器学习的算法和模型进行训练。通常来说,从两个方面考虑来选择特征:
- 特征是否发散:如果一个特征不发散,例如方差接近于0,也就是说样本在这个特征上基本上没有差异,这个特征对于样本的区分并没有什么用。
- 特征与目标的相关性:这点比较显见,与目标相关性高的特征,应当优先选择。除方差法外,本文介绍的其他方法均从相关性考虑。
根据特征选择的形式又可以将特征选择方法分为3种:
- Filter:过滤法,按照发散性或者相关性对各个特征进行评分,设定阈值或者待选择阈值的个数,选择特征。
- Wrapper:包装法,根据目标函数(通常是预测效果评分),每次选择若干特征,或者排除若干特征。
- Embedded:集成法,先使用某些机器学习的算法和模型进行训练,得到各个特征的权值系数,根据系数从大到小选择特征。类似于Filter方法,但是是通过训练来确定特征的优劣。
我们使用sklearn中的feature_selection库来进行特征选择。
7.1 Filter
7.1.1 方差选择法
使用方差选择法,先要计算各个特征的方差,然后根据阈值,选择方差大于阈值的特征。使用feature_selection库的VarianceThreshold类来选择特征的代码如下:
讯享网from sklearn.feature_selection import VarianceThreshold #方差选择法,返回值为特征选择后的数据 #参数threshold为方差的阈值 VarianceThreshold(threshold=3).fit_transform(iris.data)
7.1.2 相关系数法
使用相关系数法,先要计算各个特征对目标值的相关系数以及相关系数的P值。相关系数(Correlation coefficient)是反应变量之间关系密切程度的统计指标,相关系数的取值区间在1到-1之间。1表示两个变量完全线性相关,-1表示两个变量完全负相关,0表示两个变量不相关。数据越趋近于0表示相关关系越弱。
以下是相关系数的计算公式。
其中rxy表示样本相关系数,Sxy表示样本协方差,Sx表示X的样本标准差,Sy表示y的样本标准差。下面分别是Sxy协方差和Sx和Sy标准差的计算公式。由于是样本协方差和样本标准差,因此分母使用的是n-1。
Sxy样本协方差计算公式:
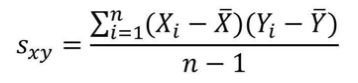
Sx样本标准差计算公式:
Sy样本标准差计算公式:
相关系数的优点是可以通过数字对变量的关系进行度量,并且带有方向性,1表示正相关,-1表示负相关,可以对变量关系的强弱进行度量,越靠近0相关性越弱。缺点是无法利用这种关系对数据进行预测,简单的说就是没有对变量间的关系进行提炼和固化,形成模型。
用 feature_selection 库的 SelectKBest 类结合相关系数来选择特征的代码如下:
from sklearn.feature_selection import SelectKBest from scipy.stats import pearsonr #选择K个最好的特征,返回选择特征后的数据 #第一个参数为计算评估特征是否好的函数,该函数输入特征矩阵和目标向量,输出二元组(评分,P值)的数组,数组第i项为第i个特征的评分和P值。在此定义为计算相关系数 #参数k为选择的特征个数 SelectKBest(lambda X, Y: array(map(lambda x:pearsonr(x, Y), X.T)).T, k=2).fit_transform(iris.data, iris.target) 7.1.3 卡方检验
经典的卡方检验是检验定性自变量对定性因变量的相关性。假设自变量有N种取值,因变量有M种取值,考虑自变量等于 i 且因变量等于 j 的样本频数的观察值与期望的差距,构建统计量:
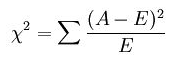
不难发现,这个统计量的含义简而言之就是自变量对因变量的相关性。用feature_selection库的SelectKBest类结合卡方检验来选择特征的代码如下:
讯享网from sklearn.feature_selection import SelectKBest from sklearn.feature_selection import chi2 #选择K个最好的特征,返回选择特征后的数据 SelectKBest(chi2, k=2).fit_transform(iris.data, iris.target)
7.1.4 互信息法
经典的互信息也是评价定性自变量对定性因变量的相关性的,互信息计算公式如下:
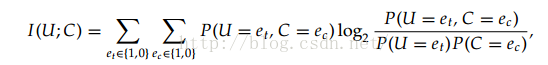
其中U、C代表两个事件,e的取值可以为0或者1,1代表出现这个事件,0代表不出现。把上述公式拆解为统计形式为:
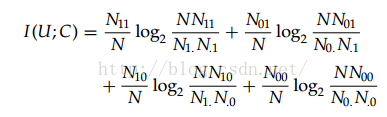
其中N11是表示全部数据中两个事件同时出现的概率,N表示全部事件出现的次数,而N0.则表示N01+N00。
实际做单特征选择的时候,我们把某个特征是否出现和分类是否正确这两个事件放在一起计算。把得分较高的特征进行保留。
需要注意的是计算时会遇到四种情况也就是,10,11,01,00,对于其中的某一种情况,当计算得到的值是0时,代表了两者没有关联,当计算出的值是正值时,表示两者共同出现的概率比较高,当值为负时,表示两者是负相关。例如:00情况是负值时,表示两者互相排斥,出现A时,B出现的概率就比较小,这个时候往往01情况和10情况的值为正。
为了处理定量数据,最大信息系数法被提出,使用feature_selection库的SelectKBest类结合最大信息系数法来选择特征的代码如下:
from sklearn.feature_selection import SelectKBest from minepy import MINE #由于MINE的设计不是函数式的,定义mic方法将其为函数式的,返回一个二元组,二元组的第2项设置成固定的P值0.5 def mic(x, y): m = MINE() m.compute_score(x, y) return (m.mic(), 0.5) #选择K个最好的特征,返回特征选择后的数据 SelectKBest(lambda X, Y: array(map(lambda x:mic(x, Y), X.T)).T, k=2).fit_transform(iris.data, iris.target)7.2 Wrapper
7.2.1 递归特征消除法
递归消除特征法使用一个基模型来进行多轮训练,每轮训练后,消除若干权值系数的特征,再基于新的特征集进行下一轮训练。使用feature_selection库的RFE类来选择特征的代码如下:
讯享网from sklearn.feature_selection import RFE from sklearn.linear_model import LogisticRegression #递归特征消除法,返回特征选择后的数据 #参数estimator为基模型 #参数n_features_to_select为选择的特征个数 RFE(estimator=LogisticRegression(), n_features_to_select=2).fit_transform(iris.data, iris.target)
7.3 Embedded
7.3.1 基于惩罚项的特征选择法
使用带惩罚项的基模型,除了筛选出特征外,同时也进行了降维。使用feature_selection库的SelectFromModel类结合带L1惩罚项的逻辑回归模型,来选择特征的代码如下:
from sklearn.feature_selection import SelectFromModel from sklearn.linear_model import LogisticRegression #带L1惩罚项的逻辑回归作为基模型的特征选择 SelectFromModel(LogisticRegression(penalty="l1", C=0.1)).fit_transform(iris.data, iris.target)实际上,L1惩罚项降维的原理在于保留多个对目标值具有同等相关性的特征中的一个,所以没选到的特征不代表不重要。故,可结合L2惩罚项来优化。具体操作为:若一个特征在L1中的权值为1,选择在L2中权值差别不大且在L1中权值为0的特征构成同类集合,将这一集合中的特征平分L1中的权值,故需要构建一个新的逻辑回归模型:
讯享网from sklearn.linear_model import LogisticRegression class LR(LogisticRegression): def __init__(self, threshold=0.01, dual=False, tol=1e-4, C=1.0, fit_intercept=True, intercept_scaling=1, class_weight=None, random_state=None, solver='liblinear', max_iter=100, multi_class='ovr', verbose=0, warm_start=False, n_jobs=1): #权值相近的阈值 self.threshold = threshold LogisticRegression.__init__(self, penalty='l1', dual=dual, tol=tol, C=C, fit_intercept=fit_intercept, intercept_scaling=intercept_scaling, class_weight=class_weight, random_state=random_state, solver=solver, max_iter=max_iter, multi_class=multi_class, verbose=verbose, warm_start=warm_start, n_jobs=n_jobs) #使用同样的参数创建L2逻辑回归 self.l2 = LogisticRegression(penalty='l2', dual=dual, tol=tol, C=C, fit_intercept=fit_intercept, intercept_scaling=intercept_scaling, class_weight = class_weight, random_state=random_state, solver=solver, max_iter=max_iter, multi_class=multi_class, verbose=verbose, warm_start=warm_start, n_jobs=n_jobs) def fit(self, X, y, sample_weight=None): #训练L1逻辑回归 super(LR, self).fit(X, y, sample_weight=sample_weight) self.coef_old_ = self.coef_.copy() #训练L2逻辑回归 self.l2.fit(X, y, sample_weight=sample_weight) cntOfRow, cntOfCol = self.coef_.shape #权值系数矩阵的行数对应目标值的种类数目 for i in range(cntOfRow): for j in range(cntOfCol): coef = self.coef_[i][j] #L1逻辑回归的权值系数不为0 if coef != 0: idx = [j] #对应在L2逻辑回归中的权值系数 coef1 = self.l2.coef_[i][j] for k in range(cntOfCol): coef2 = self.l2.coef_[i][k] #在L2逻辑回归中,权值系数之差小于设定的阈值,且在L1中对应的权值为0 if abs(coef1-coef2) < self.threshold and j != k and self.coef_[i][k] == 0: idx.append(k) #计算这一类特征的权值系数均值 mean = coef / len(idx) self.coef_[i][idx] = mean return self
使用feature_selection库的SelectFromModel类结合带L1以及L2惩罚项的逻辑回归模型,来选择特征的代码如下:
from sklearn.feature_selection import SelectFromModel #带L1和L2惩罚项的逻辑回归作为基模型的特征选择 #参数threshold为权值系数之差的阈值 SelectFromModel(LR(threshold=0.5, C=0.1)).fit_transform(iris.data, iris.target)7.3.2 基于树模型的特征选择法
树模型中GBDT也可用来作为基模型进行特征选择,使用feature_selection库的SelectFromModel类结合GBDT模型,来选择特征的代码如下:
讯享网from sklearn.feature_selection import SelectFromModel from sklearn.ensemble import GradientBoostingClassifier #GBDT作为基模型的特征选择 SelectFromModel(GradientBoostingClassifier()).fit_transform(iris.data, iris.target)
8 特征提取与特征选择
8.1 区别与联系
特征提取:将原始特征转换为一组具有明显物理意义(Gabor、几何特征[角点、不变量]、纹理[LBP HOG])或者统计意义或核的特征。
特征选择:从特征集合中挑选一组最具统计意义的特征,达到降维。
两者的共同作用:
1 减少数据存储和输入数据带宽;
2 减少冗余;
3 低纬上分类性往往会提高;
4 能发现更有意义的潜在的变量,帮助对数据产生更深入的了解。
8.2 准则性质总结
特征提取与特征选择的准则需要满足:
- 单调性:J(x1,...,xn)<=J(x1,...,xs,xs+1)J(x1,...,xn)<=J(x1,...,xs,xs+1)
- 可加性:J(x1,...,xs)=∑iJ(xi)J(x1,...,xs)=∑iJ(xi)
- 不变性:J(x)=J(AX)J(x)=J(AX)线性变换下
- 度量性:Jij>=0,Jij=Jji,Jij=0ifandonlyifi=jJij>=0,Jij=Jji,Jij=0ifandonlyifi=j
- 与错误率的上界或者下届有单调关系,或者说本身就是错误率的上界或者下届
特征提取与特征选择的对比:http://lanbing510.info/2014/10/22/Feature-Extraction-Selection.html
https://www.zhihu.com/question/
https://www.cnblogs.com/wxquare/p/5484636.html
https://blog.csdn.net/jasonding1354/article/details/
http://blog.jobbole.com/74951/
http://lanbing510.info/2014/10/22/Feature-Extraction-Selection.html
https://blog.csdn.net/_/article/details/
机器学习—特征工程:https://www.cnblogs.com/geo-will/p/9626196.html
机器学习面试之归一化与标准化:https://www.jianshu.com/p/4c3081d40ca6?utm_campaign=haruki&utm_content=note&utm_medium=reader_share&utm_source=weixin
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/75564.html