
1. 堆(Heap)是一种树状的数据结构, 但是在堆中任意节点的值总是 ≥( ≤ )子节点的值, 并且堆中的元素必须具备可比较性
如果任意节点的值总是 ≥ 子节点的值,称为:最大堆、大根堆、大顶堆
如果任意节点的值总是 ≤ 子节点的值,称为:最小堆、小根堆、小顶堆
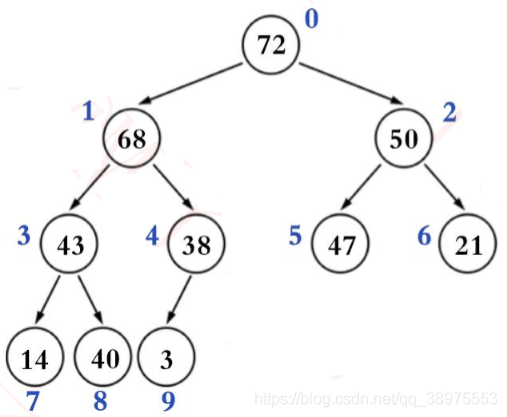
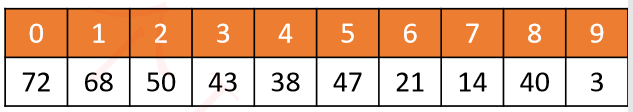
2. 二叉堆的逻辑结构就是一棵完全二叉树,所以也叫完全二叉堆, 鉴于完全二叉树的一些特性,二叉堆的底层(物理结构)一般用数组实现即可
索引 i 的规律( n 是元素数量)
如果 i = 0 ,它是根节点
如果 i > 0 ,它的父节点的索引为 floor( (i – 1) / 2 )
如果 2i + 1 ≤ n – 1,它的左子节点的索引为 2i + 1 如果 2i + 1 > n – 1 ,它无左子节点
如果 2i + 2 ≤ n – 1 ,它的右子节点的索引为 2i + 2 如果 2i + 2 > n – 1 ,它无右子节点
最大堆的添加
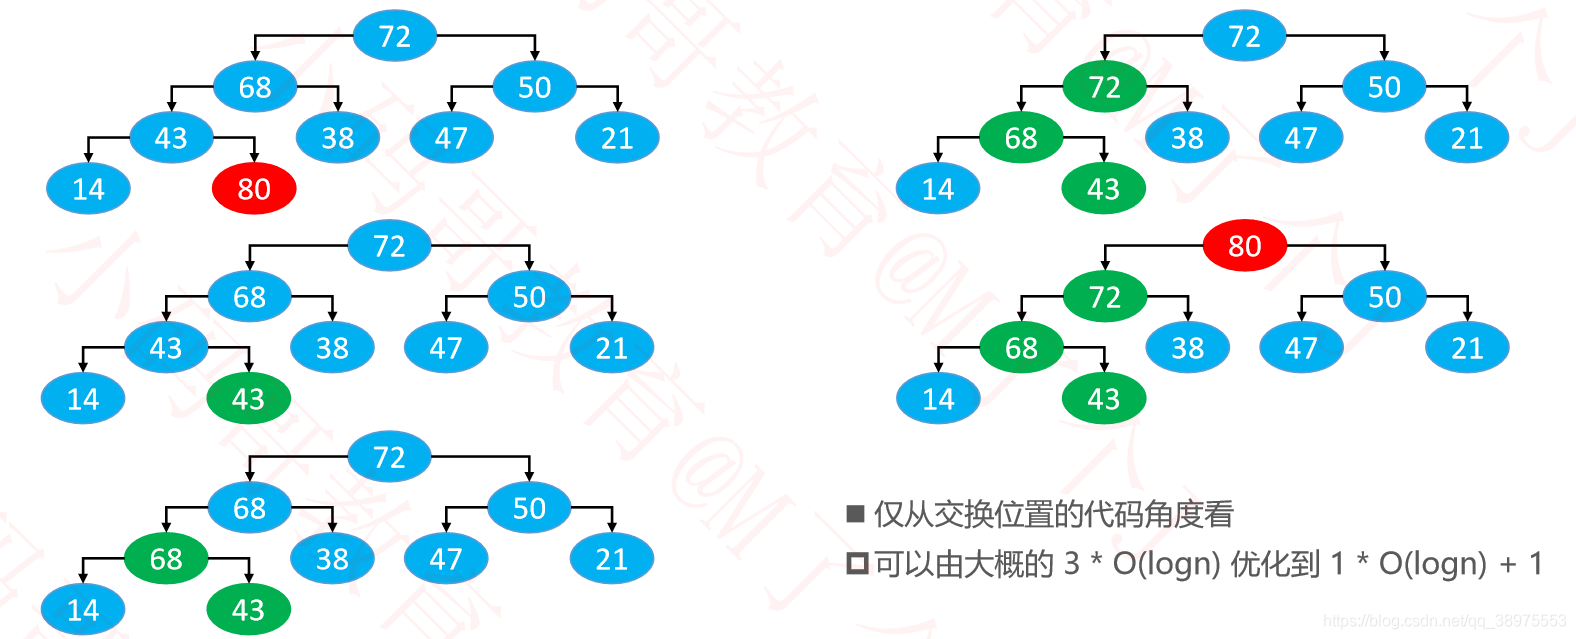
例: 添加元素80
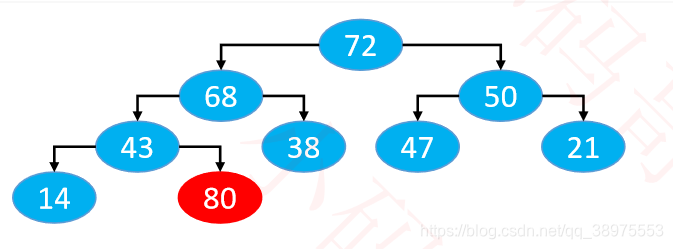
循环执行以下操作:
如果 node > 父节点: 与父节点交换位置
如果 node <= 父节点, 或者 node 没有父节点: 退出循环
这个过程,叫做上滤( Sift Up) 时间复杂度: O(logn)
流程图如下:
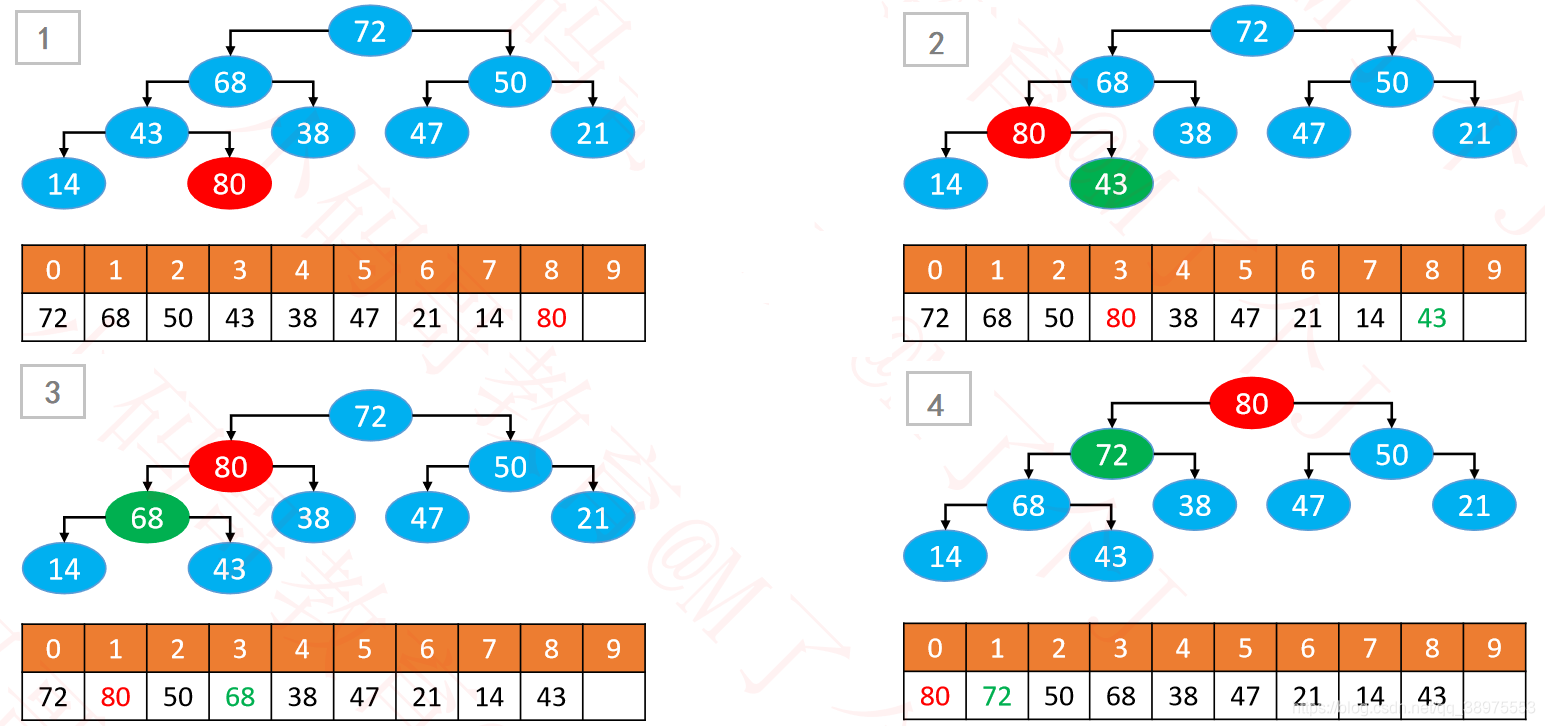
优化点: 将新添加的节点备份, 在进行比较时, 如果需要进行上虑操作的话, 就先使用父节点覆盖这个节点, 直至找到不再需要进行上虑的的位置, 然后使用新添加的节点覆盖即可;
/ * 在数组末尾新增一个元素, 然后进行上虑找到合适的位置 */ public void add(E element) { elementNotNullCheck(element); //判断元素是否合法 ensureCapacity(size + 1); //数组是否需要扩容 elements[size++] = element; siftUp(size - 1); } / * 让index位置的元素上滤 * @param index */ private void siftUp(int index) { E element = elements[index]; while (index > 0) { int parentIndex = (index - 1) >> 1; E parent = elements[parentIndex]; if (compare(element, parent) <= 0) break; // 将父元素存储在index位置 elements[index] = parent; // 重新赋值index index = parentIndex; } elements[index] = element; }讯享网
最大堆的删除
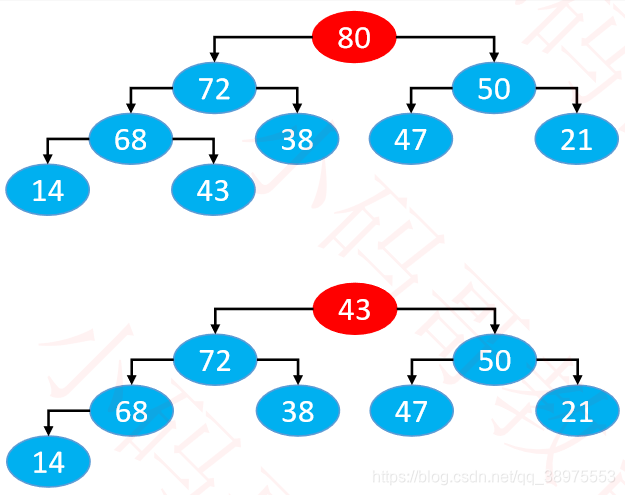
1.用最后一个节点覆盖根节点
2.删除最后一个节点
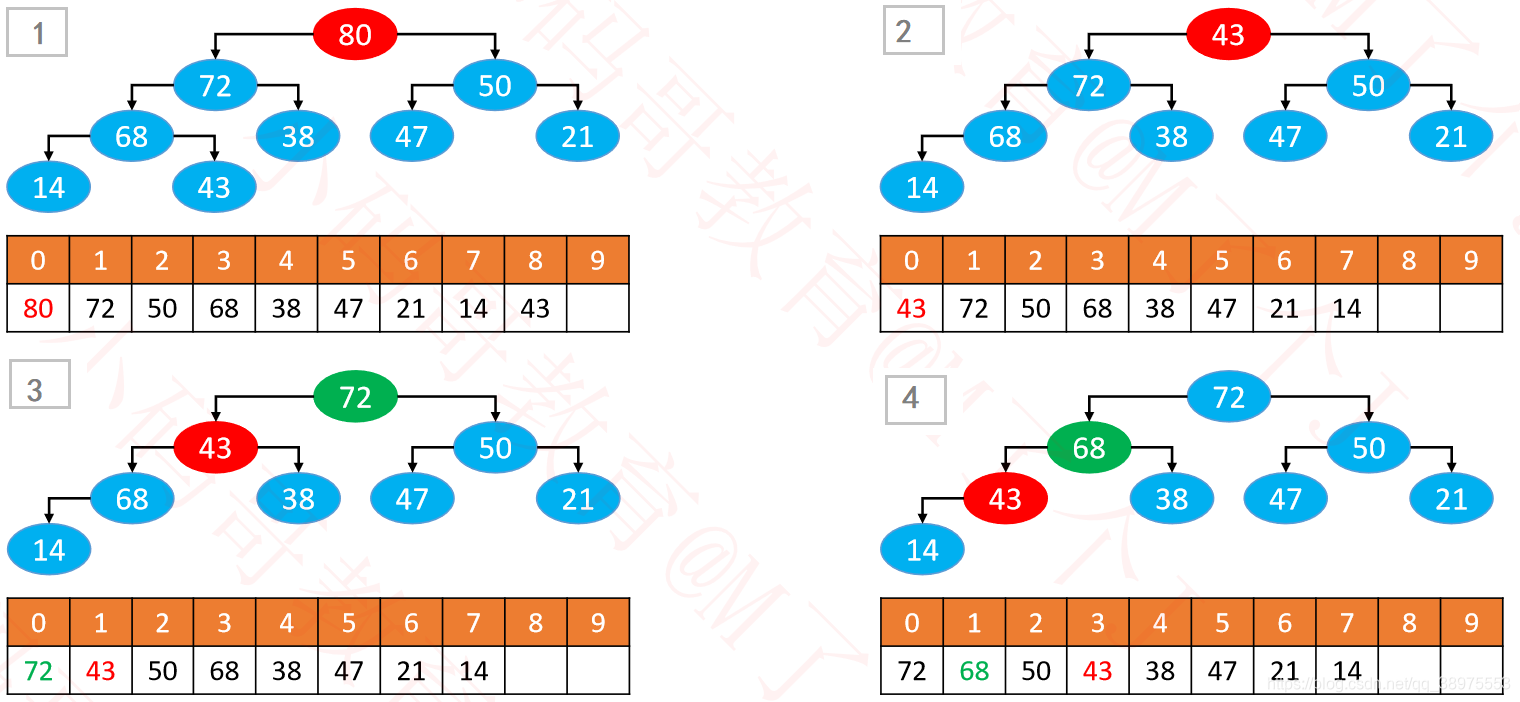
3.循环执行以下操作:
如果 node < 最大的子节点: 与最大的子节点交换位置
如果 node ≥ 最大的子节点, 或者 node 没有子节点: 退出循环
这个过程,叫做下滤(Sift Down), 时间复杂度: O(logn)
同样, 交换位置的操作可以像添加那样进行优化
讯享网/ * 删除堆顶元素 */ public E remove() { emptyCheck(); int lastIndex = --size; E root = elements[0]; elements[0] = elements[lastIndex]; elements[lastIndex] = null; siftDown(0); return root; } / * 让index位置的元素下滤 * @param index */ private void siftDown(int index) { E element = elements[index]; int half = size >> 1; // 第一个叶子节点的索引 == 非叶子节点的数量 // index < 第一个叶子节点的索引 // 必须保证index位置是非叶子节点 while (index < half) { // index的节点有2种情况 // 1.只有左子节点 // 2.同时有左右子节点 // 默认为左子节点跟它进行比较 int childIndex = (index << 1) + 1; E child = elements[childIndex]; // 右子节点 int rightIndex = childIndex + 1; // 选出左右子节点最大的那个 if (rightIndex < size && compare(elements[rightIndex], child) > 0) { child = elements[childIndex = rightIndex]; } if (compare(element, child) >= 0) break; // 将子节点存放到index位置 elements[index] = child; // 重新设置index index = childIndex; } elements[index] = element; }
批量建堆(Heapify)
自上而下的上虑
注意: 绿色图标为进行上虑操作后该位置的元素; 在每一个上虑操作完成后, 数组中存储的元素顺序都可能发生变化
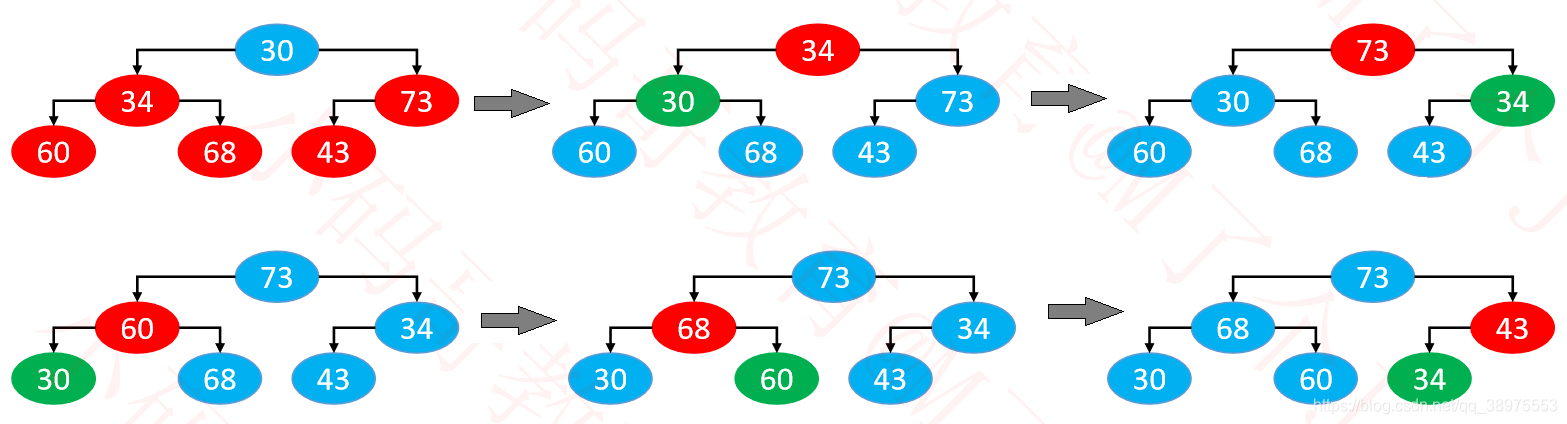
/ * 批量建堆 */ public BinaryHeap(E[] elements, Comparator<E> comparator) { super(comparator); if (elements == null || elements.length == 0) { this.elements = (E[]) new Object[DEFAULT_CAPACITY]; } else { size = elements.length; int capacity = Math.max(elements.length, DEFAULT_CAPACITY); this.elements = (E[]) new Object[capacity]; for (int i = 0; i < elements.length; i++) { this.elements[i] = elements[i]; } heapify(); } } private void heapify() { // 自上而下的上滤 for (int i = 1; i < size; i++) { siftUp(i); } } / * 让index位置的元素上滤 * @param index */ private void siftUp(int index) { E element = elements[index]; while (index > 0) { int parentIndex = (index - 1) >> 1; E parent = elements[parentIndex]; if (compare(element, parent) <= 0) break; // 将父元素存储在index位置 elements[index] = parent; // 重新赋值index index = parentIndex; } elements[index] = element; }自下而上的下虑
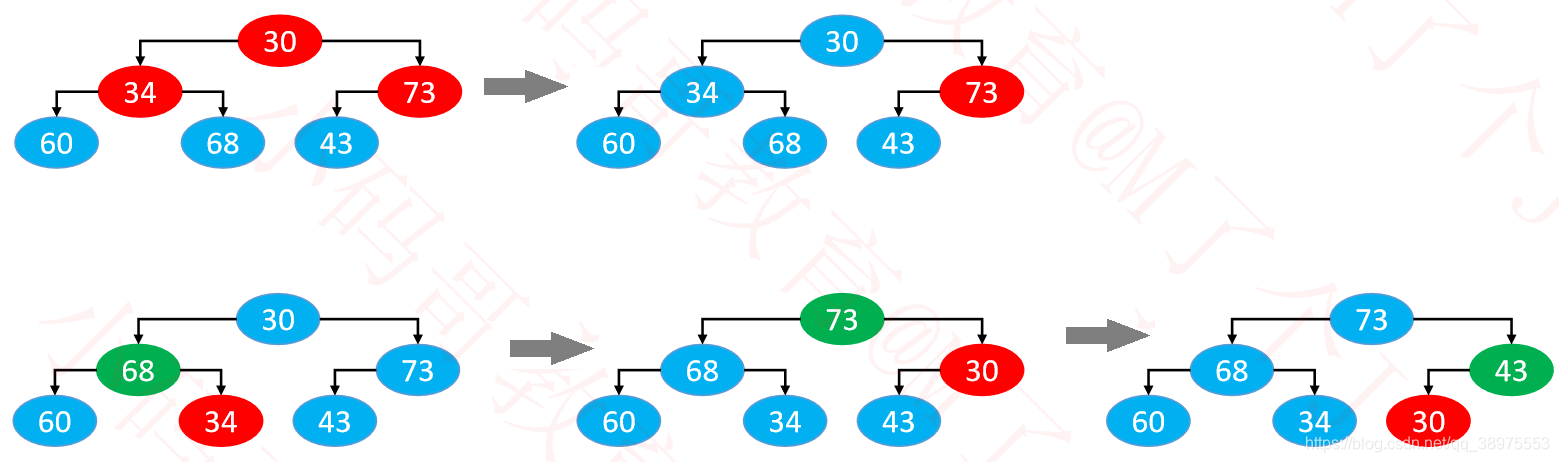
讯享网/ * 批量建堆 */ public BinaryHeap(E[] elements, Comparator<E> comparator) { super(comparator); if (elements == null || elements.length == 0) { this.elements = (E[]) new Object[DEFAULT_CAPACITY]; } else { size = elements.length; int capacity = Math.max(elements.length, DEFAULT_CAPACITY); this.elements = (E[]) new Object[capacity]; for (int i = 0; i < elements.length; i++) { this.elements[i] = elements[i]; } heapify(); } } / * 批量建堆 */ private void heapify() { // 自下而上的下滤 for (int i = (size >> 1) - 1; i >= 0; i--) { siftDown(i); } } / * 让index位置的元素下滤 * @param index */ private void siftDown(int index) { E element = elements[index]; int half = size >> 1; // 第一个叶子节点的索引 == 非叶子节点的数量 // index < 第一个叶子节点的索引 // 必须保证index位置是非叶子节点 while (index < half) { // index的节点有2种情况 // 1.只有左子节点 // 2.同时有左右子节点 // 默认为左子节点跟它进行比较 int childIndex = (index << 1) + 1; E child = elements[childIndex]; // 右子节点 int rightIndex = childIndex + 1; // 选出左右子节点最大的那个 if (rightIndex < size && compare(elements[rightIndex], child) > 0) { child = elements[childIndex = rightIndex]; } if (compare(element, child) >= 0) break; // 将子节点存放到index位置 elements[index] = child; // 重新设置index index = childIndex; } elements[index] = element; }
批量建堆效率比较

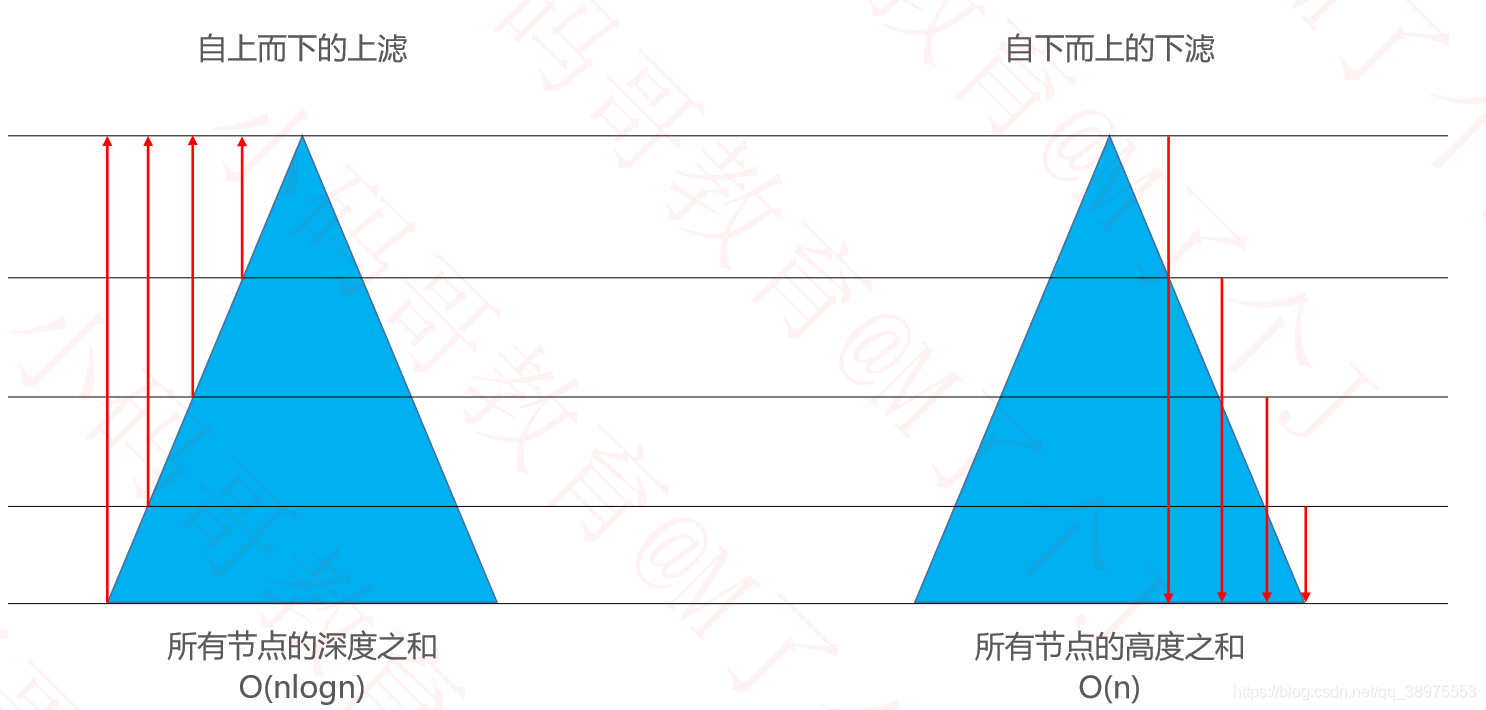
所有节点的深度之和:
仅仅是叶子节点,就有近 n/2 个,而且每一个叶子节点的深度都是 O(logn) 级别的
因此,在叶子节点这一块,就达到了 O(nlogn) 级别
O(nlogn) 的时间复杂度足以利用排序算法对所有节点进行全排序
所有节点的高度之和:
假设是满树,节点总个数为 n,树高为 h,那么 n = 2h − 1
所有节点的树高之和 H(n) = 20 ∗ h − 0 + 21 ∗ h − 1 + 22 ∗ h − 2 + ⋯+ 2h −1 ∗ h − h − 1
H(n) = h ∗ 20 + 21 + 22 + ⋯+ 2h −1 − 1 ∗ 21 + 2 ∗ 22 + 3 ∗ 23 + ⋯+ h − 1 ∗ 2h−1
H(n) = h ∗ 2h − 1 − h − 2 ∗ 2h + 2
H(n) = h ∗ 2h − h − h ∗ 2h + 2h+1 − 2
H(n) = 2h+1 − h − 2 = 2 ∗ (2h − 1) − h = 2n − h = 2n − log2(n + 1) = O(n)
TOP K 问题
问题: 从 n 个整数中,找出最大的前 k 个数( k 远远小于 n )
思路:
1. 新建一个小顶堆
2. 扫描 n 个整数
先将遍历到的前 k 个数放入堆中
从第 k + 1 个数开始, 如果大于堆顶元素, 就使用 replace 操作(删除堆顶元素, 将第 k + 1 个数添加到堆中)
3. 扫描完毕后,堆中剩下的就是最大的前 k个数
代码:
// 新建一个小顶堆 BinaryHeap<Integer> heap = new BinaryHeap<>(new Comparator<Integer>() { public int compare(Integer o1, Integer o2) { return o2 - o1; } }); // 找出最大的前k个数 int k = 3; Integer[] data = {51, 30, 39, 92, 74, 25, 16, 93, 91, 19, 54, 47, 73, 62, 76, 63, 35, 18, 90, 6, 65, 49, 3, 26, 61, 21, 48}; for (int i = 0; i < data.length; i++) { if (heap.size() < k) { // 前k个数添加到小顶堆 heap.add(data[i]); // logk } else if (data[i] > heap.get()) { // 如果是第k + 1个数,并且大于堆顶元素 heap.replace(data[i]); // logk } }参考资料: <<恋上数据结构与算法>>
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/72432.html