<svg xmlns="http://www.w3.org/2000/svg" style="display: none;"> <path stroke-linecap="round" d="M5,0 0,2.5 5,5z" id="raphael-marker-block" style="-webkit-tap-highlight-color: rgba(0, 0, 0, 0);"></path> </svg> Clawdbot 是一个开源的个人 AI 助手(MIT License),由 Peter Steinberger 创建。截至本文撰写时,它在 GitHub 上已经获得了 32,600+ Star。与 ChatGPT、Claude 这类运行在云端的 AI 不同,Clawdbot 完全运行在本地,并且可以接入你已经在使用的聊天平台,比如 Discord、WhatsApp、Telegram 等。
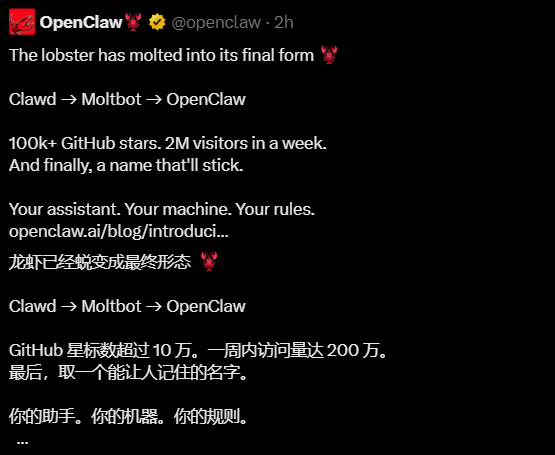
短短几天名字已经从Clawdbot变Moltbot,今天又变成了OpenClaw
不使用云端、公司控制的记忆系统,而是将一切保存在本地,把上下文和能力的完全所有权交还给用户。
在讨论记忆之前,先看看 模型在每一次请求中实际能看到什么内容:
GPT plus 代充 只需 145
System Prompt 定义了 Agent 的能力和可用工具。
与记忆最相关的是 Project Context —— 这些是 用户可编辑的 Markdown 文件,会被注入到每一次请求中。
这些文件和 memory 文件 一起存放在 agent 的工作区中,使整个 Agent 的配置 完全透明、可编辑。
理解 Context(上下文) 和 Memory(记忆) 的区别,是理解 Clawdbot 的关键。
Context(上下文)
模型在单次请求中可见的一切:
Context 的特点:
- 短暂(Ephemeral):只存在于当前请求
- 有上限(Bounded):受模型上下文窗口限制(如 200K tokens)
- 昂贵(Expensive):每个 token 都影响 API 成本和响应速度
Memory(记忆)
存储在磁盘上的长期信息:
GPT plus 代充 只需 145
Memory 的特点:
- 持久(Persistent):跨重启、跨天、跨月
- 无上限(Unbounded):可无限增长
- 便宜(Cheap):存储不消耗 API 成本
- 可搜索(Searchable):支持语义检索
Agent 通过两个专用工具访问记忆。
1️⃣ memory_search
用途:在所有记忆文件中查找相关内容(强制召回步骤)
返回结果:
GPT plus 代充 只需 145
2️⃣ memory_get
用途:在 找到内容后,精确读取指定行
返回结果:
GPT plus 代充 只需 145
Clawdbot 没有专门的 工具。
Agent 使用的是 通用的文件 write / edit 工具,和操作任何文件完全一致。
因为记忆本质上就是 Markdown 文件,你也可以 手动编辑(系统会自动重新索引)。
写入位置的策略由 AGENTS.md 中的提示词驱动。
此外,在以下场景也会自动写入:
- 预压缩(pre-compaction)内存刷新
- 会话结束(session end)
Clawdbot 的核心理念是:
记忆 = Agent 工作区中的纯 Markdown 文件
双层记忆系统(Two-Layer Memory System)
Layer 1:每日日志(Daily Logs)
只追加(append-only) 的当天记录。
GPT plus 代充 只需 145
Layer 2:长期记忆(MEMORY.md)
用于存储 重要、稳定、长期有价值的信息。
在 AGENTS.md 中有明确指令:
GPT plus 代充 只需 145
当一个记忆文件被保存时,系统后台流程如下:
SQLite 中包含:
- :文本块元数据
- :向量(sqlite-vec)
- :全文索引(FTS5)
- :避免重复 embedding
👉 无需外部向量数据库,一切在 SQLite 内完成
Clawdbot 同时运行两种搜索:
- 向量搜索(语义)
- BM25 关键词搜索
最终得分:
GPT plus 代充 只需 145
为什么是 70 / 30?
- 语义相似度是主要信号
- 关键词搜索能捕捉 名称 / ID / 日期 等精确项
每个 Agent 拥有 完全独立的记忆空间:
GPT plus 代充 只需 145
- Markdown 是 事实源(source of truth)
- SQLite 是 派生索引
- 默认 不能跨 Agent 访问记忆
这非常适合区分 个人 Agent / 工作 Agent。
当上下文接近模型上限时,Clawdbot 会:
- 总结旧对话
- 保留最近消息
- 将摘要写入磁盘
压缩结果 会持久化,不会丢失。
为防止压缩导致信息丢失:
- 在接近上限前
- 触发 静默 memory flush
- 把重要事实写入记忆文件
- 用户无感知
Clawdbot 的记忆系统之所以出色,是因为它坚持了以下原则:
- 透明优于黑盒
记忆就是 Markdown,可读、可编辑、可版本控制。 - 搜索优于硬塞上下文
用时再找,保持上下文精简、成本可控。 - 持久优于会话
重要信息先落盘,压缩也无法摧毁。 - 混合优于单一方案
语义 + 关键词,兼顾理解与精确。
GPT plus 代充 只需 145
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/214232.html