
一、表的定义
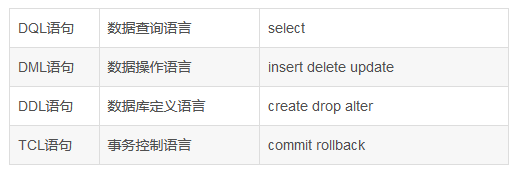
DML修改数据库表中的数据,DDL是修改数据中表的结构;
查看MySQL版本
mysql --version
mysql -V
查看当前使用数据库
select database ();
查看MySQL数据库版本
select version();
创建数据库
create database 数据库名称;
终止一条语句
\c
查看和指定现有的数据库
show databases;
指定当前缺省数据库
use bjpowernode;
查看当前数据库中的表
show tables;
查看其它数据库中的表
show tables from 数据库名称;
查看表结构
desc 表名称;
查看表的创建语句
show create table 表名称 ;
四、简单查询
1.建表语句
DROP TABLE IF EXISTS EMP;
DROP TABLE IF EXISTS DEPT;
DROP TABLE IF EXISTS SALGRADE;
CREATE TABLE DEPT
(DEPTNO int(2) not null ,
DNAME VARCHAR(14) ,
LOC VARCHAR(13),
primary key (DEPTNO)
);
CREATE TABLE EMP
(EMPNO int(4) not null ,
ENAME VARCHAR(10),
JOB VARCHAR(9),
MGR INT(4),
HIREDATE DATE DEFAULT NULL,
SAL DOUBLE(7,2),
COMM DOUBLE(7,2),
primary key (EMPNO),
DEPTNO INT(2)
)
;
CREATE TABLE SALGRADE
( GRADE INT,
LOSAL INT,
HISAL INT );
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
10, 'ACCOUNTING', 'NEW YORK');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
20, 'RESEARCH', 'DALLAS');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
30, 'SALES', 'CHICAGO');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
40, 'OPERATIONS', 'BOSTON');
commit;
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7369, 'SMITH', 'CLERK', 7902, '1980-12-17'
, 800, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7499, 'ALLEN', 'SALESMAN', 7698, '1981-02-20'
, 1600, 300, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7521, 'WARD', 'SALESMAN', 7698, '1981-02-22'
, 1250, 500, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7566, 'JONES', 'MANAGER', 7839, '1981-04-02'
, 2975, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7654, 'MARTIN', 'SALESMAN', 7698, '1981-09-28'
, 1250, 1400, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7698, 'BLAKE', 'MANAGER', 7839, '1981-05-01'
, 2850, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7782, 'CLARK', 'MANAGER', 7839, '1981-06-09'
, 2450, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7788, 'SCOTT', 'ANALYST', 7566, '1987-04-19'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7839, 'KING', 'PRESIDENT', NULL, '1981-11-17'
, 5000, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7844, 'TURNER', 'SALESMAN', 7698, '1981-09-08'
, 1500, 0, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7876, 'ADAMS', 'CLERK', 7788, '1987-05-23'
, 1100, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7900, 'JAMES', 'CLERK', 7698, '1981-12-03'
, 950, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7902, 'FORD', 'ANALYST', 7566, '1981-12-03'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7934, 'MILLER', 'CLERK', 7782, '1982-01-23'
, 1300, NULL, 10);
commit;
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
1, 700, 1200);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
2, 1201, 1400);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
3, 1401, 2000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
4, 2001, 3000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
5, 3001, 9999);
commit;
2.查询员工姓名
select ename from emp;
3.查询员工编号和员工姓名
select empno,ename from emp;
4.查询全部字段
select * from emp;
5.计算员工年薪
1)列出员工的编号,姓名和年薪
select empno,ename,sal*12 from emp;
2)将查询出来的字段重命名和显示为中文
select empno,ename,sal * 12 as ‘年薪’from emp;
五、条件查询
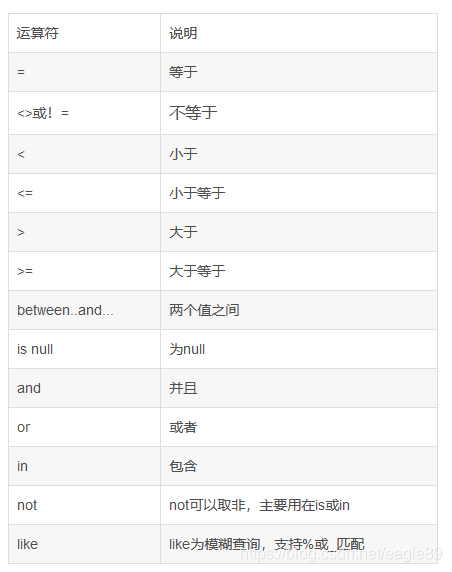
1.支持如下运算符
2.查询薪水为5000的员工
select empno,ename,sal from emp where sal = 5000;
3.查询job为MANAGER的员工
select empno,ename,job from emp where job =“manager”;
4.查询薪水不等于5000的员工
select empno,ename,sal from emp where sal <> 5000;
5.查询工作岗位不等于MANAGER的员工
select empno,ename,job from emp where job <>„MANAGER‟;
6.查询薪水为1600到3000的员工
select empno,ename,sal from emp where sal between 1600 and 3000;
7.查询津贴为空的员工
select empno,ename,comm from emp where comm is null;
8.查询工作岗位为“MANAGER”并且薪水大于2500的员工
select empno,ename,job,sal from emp where job ="MANAGER" and sal > 2500;
9.查询出 job 为 SALESMAN 和 job为MANAGER的员工
select ename,job from emp where job = 'SALESMAN' or job = 'MANAGER';
10.查询出Job为 SALESMAN 和 Job为 MANAGER 的员工
select ename,job from emp where job in ('SALESMAN','MANAGER');
11.查询出薪水不为1600和3000的员工
select ename,sal from emp where sal not in (1600,3000);
12.查询出薪水不是1600和薪水不是3000的员工
select ename,sal from emp where not (sal = 1600 or sal = 3000);
select ename,sal from emp where sal not in (1600,3000);
select ename,sal from emp where sal <> 1600 and sal <> 3000;
13.查询以姓名以 M 开头的所有员工‘M%’
select ename from emp where ename like 'M%';
14.查询姓名以N结尾的所有员工‘%N’
select ename from emp where ename like '%N';
15.查询姓名中包含O的所有员工‘%O%’
select ename from emp where ename like '%O%';
16.查询姓名中第二个字符为A的所有员工‘_A%’
select ename from emp where ename like '_A%';
17.查询姓名中倒数第二个字符为E的所有员工‘%E_’
select ename from emp where ename like '%E_';
18.查询姓名中第三个字符为N的所有员工姓名‘__R%’
(二)
一、建表语句
DROP TABLE IF EXISTS EMP;
DROP TABLE IF EXISTS DEPT;
DROP TABLE IF EXISTS SALGRADE;
CREATE TABLE DEPT
(DEPTNO int(2) not null ,
DNAME VARCHAR(14) ,
LOC VARCHAR(13),
primary key (DEPTNO)
);
CREATE TABLE EMP
(EMPNO int(4) not null ,
ENAME VARCHAR(10),
JOB VARCHAR(9),
MGR INT(4),
HIREDATE DATE DEFAULT NULL,
SAL DOUBLE(7,2),
COMM DOUBLE(7,2),
primary key (EMPNO),
DEPTNO INT(2)
)
;
CREATE TABLE SALGRADE
( GRADE INT,
LOSAL INT,
HISAL INT );
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
10, 'ACCOUNTING', 'NEW YORK');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
20, 'RESEARCH', 'DALLAS');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
30, 'SALES', 'CHICAGO');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
40, 'OPERATIONS', 'BOSTON');
commit;
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7369, 'SMITH', 'CLERK', 7902, '1980-12-17'
, 800, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7499, 'ALLEN', 'SALESMAN', 7698, '1981-02-20'
, 1600, 300, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7521, 'WARD', 'SALESMAN', 7698, '1981-02-22'
, 1250, 500, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7566, 'JONES', 'MANAGER', 7839, '1981-04-02'
, 2975, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7654, 'MARTIN', 'SALESMAN', 7698, '1981-09-28'
, 1250, 1400, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7698, 'BLAKE', 'MANAGER', 7839, '1981-05-01'
, 2850, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7782, 'CLARK', 'MANAGER', 7839, '1981-06-09'
, 2450, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7788, 'SCOTT', 'ANALYST', 7566, '1987-04-19'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7839, 'KING', 'PRESIDENT', NULL, '1981-11-17'
, 5000, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7844, 'TURNER', 'SALESMAN', 7698, '1981-09-08'
, 1500, 0, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7876, 'ADAMS', 'CLERK', 7788, '1987-05-23'
, 1100, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7900, 'JAMES', 'CLERK', 7698, '1981-12-03'
, 950, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7902, 'FORD', 'ANALYST', 7566, '1981-12-03'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7934, 'MILLER', 'CLERK', 7782, '1982-01-23'
, 1300, NULL, 10);
commit;
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
1, 700, 1200);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
2, 1201, 1400);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
3, 1401, 2000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
4, 2001, 3000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
5, 3001, 9999);
commit;
二、数据排序asc、desc
含义
select ename,sal from emp order by sal;
2.取得job为MANAGER的员工,按照薪水由小到大排序(系统默认由小到大)
select ename,job,sal from emp where job = 'MANAGER' order by sal;
3.按照job和薪水倒序排序
select ename,job,ename from emp order by job desc,sal desc;
注:如果采用多个字段排序,如果根据第一个字段排序重复了,会根据第二个字段排序
三、处理函数(单行处理)
1.数据处理函数(单行处理函数)
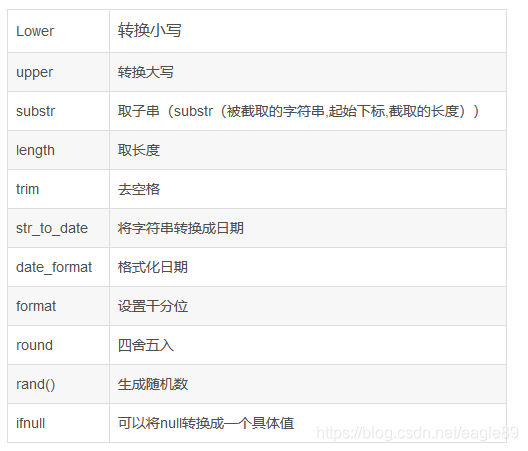
select lower(ename) as ename from emp;
3.upper(字段名)函数:转换为大写
select upper(ename) as ename from emp;
4.substr(字段名,起始下标,截取长度)函数:取子串
用法:substr(字段名,起始下标,截取长度)
select substr(ename,2,1) from emp;
2)查询员工姓名中第二个字母为A的所有员工
select ename from emp where substr(ename,2,1) = 'A'
5.length(字段名)函数:取字段长度
select ename,length(ename) as nameLength from emp;
6.ifnull(字段名,替换值)函数:空值处理函数
用法:ifnull(字段名称,将要替换)
select ename,ifnull(comm,0) from emp;
2)查询员工薪水与补助的和
select sal+ifnull(comm,0) from emp;
3)没有补助的员工,将每月补助100,求员工的年薪
select ename,(sal+ifnull(comm,100)) * 12 yearsal from emp;
select ename,sal,job,
(case job
when 'MANAGER' then sal*1.1
when 'SALESMAN' then sal*1.5
else sal
end) as newsal
from
emp;
8.trim(‘字符串’)函数:去除首尾空格
作用:trim函数去除首尾空格,不会去除中间空格
select * from emp where job = trim(' manager ');
9.round(数字,保留小数位数)函数:四舍五入
select round(rand()*100,0);
11.str_to_date函数:将字符串转换为日期
作用:将‘日期字符串’ 转换为 ‘日期类型’数据
用法:str_to_date('日期字符串',‘日期格式’)
日期字符串:日期格式的字符串
日期格式:告知MySQL输入日期字符串的格式是什么
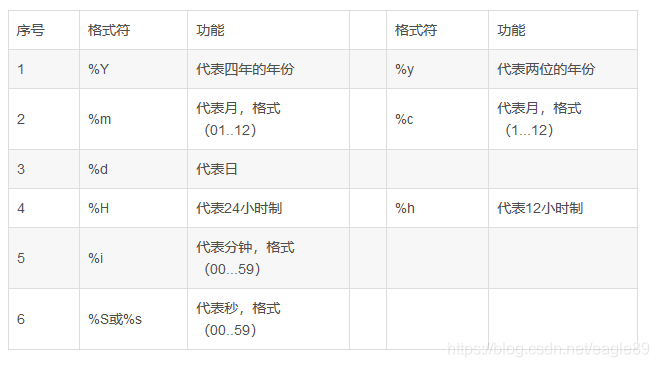
MySQL日期格式:
1)查询出1981-12-03入职的员工
select ename,hiredate from emp where hiredate = '1981-12-03';
原因:
1、在MySQL中日期作为查询条件时:可以使用字符串为其赋值
select ename,hiredate from emp where hiredate = str_to_date('02-20-1981','%m-%d-%Y');
12.date_format函数:将日期转换为特定格式字符串
作用:‘将日期类型’转换为特定格式的‘日期字符串’类型
用法:date_format(日期类型数据,;'日期格式')
1)查询员工的入职日期,以‘10-12-1980’的格式显示到窗口中
select ename,date_format(hiredate,'%m-%d-%Y') hiredate from emp;
2)查询员工的入职日期,以'10/12/1980'的格式显示到窗口中
select ename,date_format(hiredate,'%m/%d/%Y') hiredate from emp;
结论:date_format函数主要用在数据库查询操作中。实际工作中,客户需要日期以特定格式展示的时候,需要使用该函数
四、分组函数/聚合函数/多行处理函数
1.常见函数
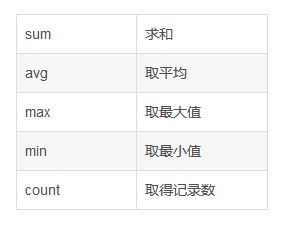
2.单行/多行处理函数
单行处理函数:一行输入对应一行输出
多行处理函数:多行输入对应一行输出
注:
1、分组函数自动忽略控制,不需要手动增加where条件排除空值;
作用:求某一列的和,null会自动被忽略;
select sum(sal) from emp;
2)取得补助总计
select sum(comm) from emp;
3)取得总共薪水(工资+补助)合计
select sum(sal + ifnull(comm,0)) from emp
4.avg(字段名)函数
作用:求某一列的平均值,null会被自动忽略
select avg(sal) as avgsal from emp
5.max(字段名)函数
作用:取得某一列的最大值
select max(sal) from emp;
2)取得最晚入职的员工max(sal)
select max(hiredate) from emp;
6.min(字段名)函数
作用:取得某一列最小值
select min(sal) from emp;
2)取得最早入职的员工max(sal)
select min(hiredate) from emp;
7.count函数
作用:取得某字段值不为null的记录总数
用法:count(字段名称)或count(*)
注意:
1、count(*)表示取得当前查询表所有记录
select count(*) from emp;
2)取得补助不为空的所有员工数
select count(comm) from emp;
3)取得补助为空的员工数量
select count(*) from emp where comm is null;
8.distinct去除重复记录
作用:将查询结果中某一字段的重复记录去除掉
用法:distinct字段名或distinct 字段名1,字段名2
distinct 字段名A:去除与字段名A相同的记录
distinct字段名A,字段名B:去除与字段A和字段B同时相同的记录
select distinct job from emp
2)查询该公司工作岗位数量
select count(distinct job) from emp;
3)去除部门编号deptno和工作岗位job重复记录
select distinct deptno,job from emp
9.分组查询:group by
作用:通过哪个或哪些字段进行分组
select job,max(sal) from emp group by job
思路分析:先按照工作岗位job进行分组,然后对每一组薪水求最大值max,最后在根据每一组薪水的最大值进行由低到高排序
select job,max(sal) as maxsal from emp group by job order by maxsal
思路分析:首先,按照部门编号分组,然后对每一组的薪水求平均值
select deptno,avg(sal) as avgsal from emp group by deptno
4)计算不同部门不同岗位的最高薪水
思路分析:首先把deptno和job看成一个字段进行联合字段分组,联系到distinct关键字
select dep,job,max(sal) as maxsal from emp group by deptno,job;
select job,max(sal) as maxsal from emp where job <> 'MAXAGER' group by job;
10.having
思路分析:先对工作岗位job分组,然后对每一组薪水求平均值,最后再对每一组平均薪水的值进行大于2000的条件过滤
select job,avg(sal) from emp group by job having avg(sal) > 2000
11.where与having区别
1)where和having都是为了完成数据的过滤,他们后面都是添加条件
2)where是在group by之前完成过滤
3)having是在group by之后完成过滤
一个完整的SQL语句如下:
select
xxxx
from
xxxx
where
xxxx
group by
xxxx
having
xxxx
order by
xxxx
1)from将硬盘上的表文件加载到内存
2)where将符合条件的数据进行摘取出来,生成一张新的临时表
3)group by根据列中的数据种类,将当前临时表划分成若干个新的临时表
4)having可以过滤掉group by生成的不符合条件的临时表
5)select对当前临时表进行整列读取
6)order by对select生成的临时表,进行重新排序,生成新的临时表
(三)
一、建表语句
DROP TABLE IF EXISTS EMP;
DROP TABLE IF EXISTS DEPT;
DROP TABLE IF EXISTS SALGRADE;
CREATE TABLE DEPT
(DEPTNO int(2) not null ,
DNAME VARCHAR(14) ,
LOC VARCHAR(13),
primary key (DEPTNO)
);
CREATE TABLE EMP
(EMPNO int(4) not null ,
ENAME VARCHAR(10),
JOB VARCHAR(9),
MGR INT(4),
HIREDATE DATE DEFAULT NULL,
SAL DOUBLE(7,2),
COMM DOUBLE(7,2),
primary key (EMPNO),
DEPTNO INT(2)
)
;
CREATE TABLE SALGRADE
( GRADE INT,
LOSAL INT,
HISAL INT );
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
10, 'ACCOUNTING', 'NEW YORK');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
20, 'RESEARCH', 'DALLAS');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
30, 'SALES', 'CHICAGO');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
40, 'OPERATIONS', 'BOSTON');
commit;
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7369, 'SMITH', 'CLERK', 7902, '1980-12-17'
, 800, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7499, 'ALLEN', 'SALESMAN', 7698, '1981-02-20'
, 1600, 300, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7521, 'WARD', 'SALESMAN', 7698, '1981-02-22'
, 1250, 500, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7566, 'JONES', 'MANAGER', 7839, '1981-04-02'
, 2975, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7654, 'MARTIN', 'SALESMAN', 7698, '1981-09-28'
, 1250, 1400, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7698, 'BLAKE', 'MANAGER', 7839, '1981-05-01'
, 2850, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7782, 'CLARK', 'MANAGER', 7839, '1981-06-09'
, 2450, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7788, 'SCOTT', 'ANALYST', 7566, '1987-04-19'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7839, 'KING', 'PRESIDENT', NULL, '1981-11-17'
, 5000, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7844, 'TURNER', 'SALESMAN', 7698, '1981-09-08'
, 1500, 0, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7876, 'ADAMS', 'CLERK', 7788, '1987-05-23'
, 1100, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7900, 'JAMES', 'CLERK', 7698, '1981-12-03'
, 950, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7902, 'FORD', 'ANALYST', 7566, '1981-12-03'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7934, 'MILLER', 'CLERK', 7782, '1982-01-23'
, 1300, NULL, 10);
commit;
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
1, 700, 1200);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
2, 1201, 1400);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
3, 1401, 2000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
4, 2001, 3000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
5, 3001, 9999);
commit;
select e.ename,d.dname from emp e,dept d;
select e.ename,d.dname from emp e,dept d where e.deptno = d.deptno;
select e.ename,d.dname from emp e join dept d on e.deptno = d.deptno
优点:表连接独立,结构清晰,如果结果数据不满足要求,可再追加where条件进行过滤;
3. 连接查询根据:连接方式分类
3.1 内连接
定义:只连接匹配的行,即A表与B表相连接,能将匹配的记录查询出来
1)等值连接
查询员工的名称和员工所对应的部门名称
select e.ename,d.dname from emp e (inner) join dept d on e.deptno = d.deptno;
select e.ename,s.grade from emp e join salgrade s on e.sal between losal and hisal;
select e.ename empname,b.ename leadername from emp e join emp b on e.empno = b.mgr;
3.2 外连接
定义:包含右边表的全部行(不管右边的表中是否存在与他们匹配的行),以及左边表中全部匹配的行。
4.案例详解
4.1查询每一个员工所在的部门名称,要求最终显示员工姓名和对应的部门名称(内连接:等值)
注意:多张表查询时,通常会对表起别名,若两张表中有相同名称的字段时,该相同名称字段不知道属于哪张表中,这时需要通过对表起别名来限制该字段属于哪张表,并且提高SQL语句的效率,可读性也高。
思路分析:
1)Step 1:从<emp e员工信息表>查询出员工姓名和部门编号;
2)Step 2:从<dept d 部门信息表>查询出部门编号和部门名称;
3)Step 3:内连接等值条件:e.deptno = d.deptno
注意:在连接查询时,即使我们使用的了限制条件,但是匹配次数没有减少,只显示有效数据;
select e.ename,d.dname from emp e join dept d on e.deptno = d.deptno
4.2 找出每一个员工对应的部门名称,要求部门名称全部显示(左/右连接)
思路分析:
1)先查询出每一个员工的部门名称
2)查询部门信息
3)右外连接条件:员工表的部门编号=部门表的部门编号
select e.ename,d.dname from emp e right outer join dept d on e.deptno = d.deptno;
select e.ename,d.dname from dept d left outer join emp e on e.deptno = d.deptno;
思路分析:
1)查询出员工对应的部门编号和工资
2)查询出部门信息
3)查询出工资等级信息
4)多表连接条件:员工表与部门表连接,再与工资等级表连接
select e.ename,d.dname,s.grade from emp e join dept d on e.deptno = d.deptno join salgrade s on e.sal between s.losal and hisal;
注意:多张表进行表连接得语法格式:
select
xxx
from
A表
join
B表
on
连接条件1
join
C表
on
连接条件2
定义:select 语句嵌套select语句被称为子查询;
注意:select子句可出现在select、from、where关键字后面
1.案例
1.1 (where后)找出薪水比公司平均薪水高的员工,要求显示员工名和薪水
思路分析:
1)找出公司的平均薪水
2)找出薪水比公司平均薪水高的员工
3)将平均薪水替换为他的查询语句
select ename,sal from emp where sal > (select avg(sal) from emp);
1.2(from后)找出每一个部门的平均薪水,并且要求显示平均薪水的薪水等级
1)根据部门分组找到每一个部门的平均薪水
2)查询出薪水等级信息
3)将第一步查询结果当作一张临时表t,然后将t表与薪水等级表进行表连接
select t.deptno,t.avgsal,s.grade from (select deptno,avg(sal) as avgsal from emp group by deptno) t join salgrade s on t.avgsal between s.losal and s.hisal order by deptno;
定义:将查询的结果集合并
select empno,ename,job from emp where job = 'MANAGER'
union
select empno,ename,job from emp where job = 'SALESMAN'
作用:获取一表前几条或中间某几行数据
思路分析:
1)查询出全部员工的信息
2)使用limit取出前5个员工的信息
select * from emp limit 0,5;
5.2 找出工资排名前5的员工
思路分析:
1)按照工资降序排序
2)取前5个员工<limit出现在SQL语句的最后位置>
(四)
一、建表语句
DROP TABLE IF EXISTS EMP;
DROP TABLE IF EXISTS DEPT;
DROP TABLE IF EXISTS SALGRADE;
CREATE TABLE DEPT
(DEPTNO int(2) not null ,
DNAME VARCHAR(14) ,
LOC VARCHAR(13),
primary key (DEPTNO)
);
CREATE TABLE EMP
(EMPNO int(4) not null ,
ENAME VARCHAR(10),
JOB VARCHAR(9),
MGR INT(4),
HIREDATE DATE DEFAULT NULL,
SAL DOUBLE(7,2),
COMM DOUBLE(7,2),
primary key (EMPNO),
DEPTNO INT(2)
)
;
CREATE TABLE SALGRADE
( GRADE INT,
LOSAL INT,
HISAL INT );
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
10, 'ACCOUNTING', 'NEW YORK');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
20, 'RESEARCH', 'DALLAS');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
30, 'SALES', 'CHICAGO');
INSERT INTO DEPT ( DEPTNO, DNAME, LOC ) VALUES (
40, 'OPERATIONS', 'BOSTON');
commit;
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7369, 'SMITH', 'CLERK', 7902, '1980-12-17'
, 800, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7499, 'ALLEN', 'SALESMAN', 7698, '1981-02-20'
, 1600, 300, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7521, 'WARD', 'SALESMAN', 7698, '1981-02-22'
, 1250, 500, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7566, 'JONES', 'MANAGER', 7839, '1981-04-02'
, 2975, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7654, 'MARTIN', 'SALESMAN', 7698, '1981-09-28'
, 1250, 1400, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7698, 'BLAKE', 'MANAGER', 7839, '1981-05-01'
, 2850, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7782, 'CLARK', 'MANAGER', 7839, '1981-06-09'
, 2450, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7788, 'SCOTT', 'ANALYST', 7566, '1987-04-19'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7839, 'KING', 'PRESIDENT', NULL, '1981-11-17'
, 5000, NULL, 10);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7844, 'TURNER', 'SALESMAN', 7698, '1981-09-08'
, 1500, 0, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7876, 'ADAMS', 'CLERK', 7788, '1987-05-23'
, 1100, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7900, 'JAMES', 'CLERK', 7698, '1981-12-03'
, 950, NULL, 30);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7902, 'FORD', 'ANALYST', 7566, '1981-12-03'
, 3000, NULL, 20);
INSERT INTO EMP ( EMPNO, ENAME, JOB, MGR, HIREDATE, SAL, COMM,
DEPTNO ) VALUES (
7934, 'MILLER', 'CLERK', 7782, '1982-01-23'
, 1300, NULL, 10);
commit;
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
1, 700, 1200);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
2, 1201, 1400);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
3, 1401, 2000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
4, 2001, 3000);
INSERT INTO SALGRADE ( GRADE, LOSAL, HISAL ) VALUES (
5, 3001, 9999);
commit;
二、表
2.1 定义
表:是数据库最基本的组成单元,数据库是用来存储数据的,数据库中有很多表,每一个表都是一个独立的单元,表也是一个结构化的文件,由行和列组成,行称为数据或记录,列称为字段,字段又包括:字段名称、字段类型、长度、约束。
2.2 创建表
2.2.1.语法格式:create table 表名称(字段名 类型(长度) 约束);
2.2.2.MySQL常用数据类型
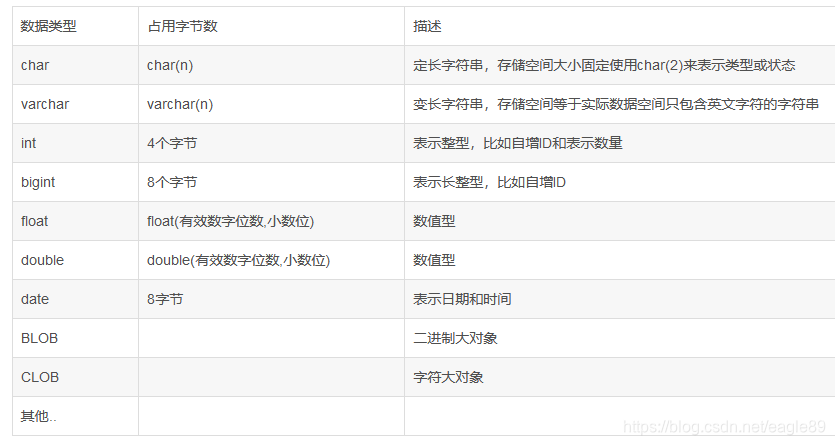
varchar与char对比:
a)都是字符串
b)varchar比较智能,可以根据实际的数据长度分配空间,比较节省空间,但在分配的时候需要相关判断
c)char不需要动态分配空间,所以执行效率高,但是可能会导致空间浪费
d)若字段中的数据不具备伸缩性,建议采用char类型存储
字段包括:
学号:no INT(10)
姓名:name varchar(32)
性别:sex char(1)
出生日期:birth date
邮箱:email varchar(128)
建表语句:
create table t_student(
no int(10),
name varchar(32),
sex char(1),
birth date,
email varchar(128)
)
2.2.4 删除表格
1)drop table t_student;
1)DML语句包括:insert、update、delete;
a)插入数据insert语法
insert into 表名(字段名1,字段名2,....) values(值1,值2);
注意:字段和数值必须一一对应,字段与数据个数必须相同,数据类型必须一致;
第一种方式:向表格中所有字段插入数据
insert into t_student(no,name,sex,birth,email) values(1,'zz','m','1970-01-01','zz');
第二种方式:向t_student表格中部分字段插入数据
insert into t_student(name,email) values('wangwu','');
b)插入中文?
insert into t_student(no,name) values(5,'密码');
查看建表语句
show create table t_student;
错误原因:DOS窗口字符编码为GBK,数据库字符编码为UTF-8,可以使用数据库管理工具插入数据;
查看变量
show variables like '%char%'
设置结果编码集
set character_set_results = 'GBK'
2.2.6 创建表格时给字段设置默认值:default默认值
create table t_student(
no int(10),
name varchar(32),
sex char(1) default 'm',
birth date,
email varchar(128)
)
2.2.7 表的复制
1.定义:将查询结果当作一张表创建
2.语法结构:create table 表名 as select 查询语句;
1)完全复制emp表到emp1
create table emp1 as select * from emp;
2)选择性复制emp表到emp2:
create table emp2 as select ename,sal from emp;
2.2.8 将查询结果插入到某张表中
1.语法结构:insert into 表名 select 查询语句
1)从emp2表中查询出员工工资为3000的,同时将查询结果插入到emp2表中
insert into emp2 select * from emp2 where sal = 3000
2)复制emp表为emp_bak,再将emp表中数据插入到emp_bak中
1)新增:alter table 表名 add 字段名 字段类型(长度);
2)修改:alter table 表名 modify 字段名 字段类型(长度);
字段
编号:no int(10)
姓名:name varchar(32)
drop table if exists t_student;
create table t_student(
no int(10),
name varchar(32)
);
2.3.3 给表添加一个电话字段
alter table t_student add tel varchar(10);
2.3.4 将字段tel长度扩展到20个长度
alter table t_student modify tel varchar(20);
2.3.5 将t_student表中的tel字段删除
alter table t_student drop tel;
语法格式:update 表名 set 字段名 = 字段值,字段名 = 字段值 where 条件;
注意:update如果没有条件限制,将把整张表的数据全部更新;
1)向t_student表中插入数据
①向t_student表添加email varchar(128)
alter table t_student add email varchar(128);
②向t_student表插入测试数据
insert into t_student(no) values(1);
insert into t_student(no) values(2);
insert into t_student(no) values(3);
2)将编号no为3的记录name改为zhangsan,email改为
update t_student set name = 'zhangsan',email = '' where no = 3;
3)将所有名字name改为lisi
update t_student set name = 'lisi'
4)将emp_bak 表中的name包含"o"字母的改为wangwu
update emp_bak set name = 'wangwu' where name like '%o%'
5)将emp_bak表中工作岗位为MANAGER和SALESMAN员工的工资上调10%
update emp_bak set sal = sal * 1.1 where job in ('MANAGER','SALESMAN');
2.4.4 delete删除数据
语法格式:delete from 表名 where 条件限制
注意:若没有条件限制,会将表中所有记录全部删除;
1)将t_student表中no为3的学生全部删除
delete from t_student where no = 3;
2)将emp_bak表中部门编号为20的MANAGER删除掉
delete from emp_bak where deptno = 20 and job = 'MANAGER';
2.5 创建表加入约束
英文单词:constraint
什么是约束?实际上是对表中数据的限制条件
作用:not null约束的字段不能为NULL值,必须赋具体数据;
示例:创建t_user表,name字段不能为空
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32) not null,
email varchar(128)
)
2.5.2 唯一性约束(unique)
作用:unique约束的字段具有唯一性,不可重复
示例:创建t_user表,name不能为空,email保证唯一
1)方法一:列级约束
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32) not null,
email varchar(128) unique
);
注意:unique约束的字段不能重复,但是可以为NULL,NULL不是一个值,也不能用等号比较;
2)方法二:表级约束
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32) not null,
email varchar(128),
unique(email)
);
3)使用表级约束给多个字段联合添加字段
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32) not null,
email varchar(128),
unique(name,email)
);
表级约束还可以给约束起名字,原因:以后可以通过名字操作这个约束
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32) not null,
email varchar(128),
constraint t_user_email_unique unique(email)
);
--使用information_schema
use information_schema;
--展示表
show tables;
--展示字段
desc table_constraints;
--查询出表中的唯一约束名称
select constraint_name from table_constraints where table_name = 't_user';
(五)
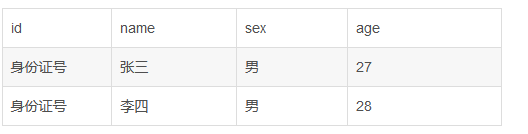
1)添加主键primary key的字段即不能重复也不能为空,效果与“not null nuique”相同,但本质是不同的,添加主键约束后,主键不仅会有“not null unique”作用,而且主键字段还会自动添加“索引——index”
1)单一主键:是给一个字段添加主键约束
列级主键约束
drop table if exists t_user;
create table t_user(
id int(10) primary key,
name varchar(32)
);
表级主键约束
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32),
constraint t_user_id_pk primary key(id)
);
2)复合主键:是给多个字段联合添加一个主键约束:
drop table if exists t_user;
create table t_user(
id int(10),
name varchar(32),
email varchar(128),
constraint t_user_id_name_pk primary key(id,name)
);
1.5 表中主键个数(只能有一个)
1)自然主键:主键值若是一个自然数,并且这个自然数与业务没有任何关系,这种主键称为自然主键;
1)定义:MySQL数据库管理系统中提供了一个自增数字auto_increment,专门用来自动生成主键值。自增数字默认从1开始,以1递增:1、2、3....
2)需求:创建t_user表,id name,id为自增主键
drop table if exists t_user;
create table t_user(
id int(10) primary key auto_increment,
name varchar(32)
);
二、外键约束FK(foreign key)
2.1 外键涉及到的术语:外键约束、外键字段、外键值
1)单一外键:给一个字段添加外键约束
需求:设计数据表用来存储学生和班级信息
需求分析:
a)学生表t_student包括:sno,sname,classno,cname
b)学生信息和班级信息之间的关系:一个班级对应多个学生,典型的一对多关系;
1)第一种解决方案:将学生信息和班级信息存储到同一张表中
学生信息表:t_student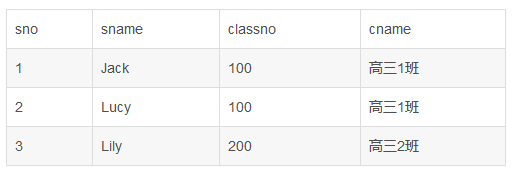
缺点:数据
2)第二种解决方案:将学生信息和班级信息分开两张表存储:学生表+班级表
思路分析:
a)创建t_student表和t_class表
b)t_student表要与t_class表有关系,需要在t_student表中添加一个classno字段作为外键
c)结论:为了保证t_student表中的classno字段中的数据必须来自t_class表中cno字段中数据,有必要给t_student表中classno字段添加外键约束;classno称为外键字段
注意:
①外键字段可以为NULL,外键为空的数据也叫孤儿数据;
②被引用字段必须具有unique约束
③有了外键引用之后,表分为父表和子表,父表:t_class;子表:t_student;创建表时先创建父表,在创建子表;插入数据时,先插入父表数据,再插入子表数据;
ROP TABLE IF EXISTS t_student;
CREATE TABLE t_student(
sno INT(4) PRIMARY KEY AUTO_INCREMENT,
sname VARCHAR(32),
classno INT(4),
CONSTRAINT t_student_classno_fk FOREIGN KEY(classno) REFERENCES t_class(cno)
);
DROP TABLE IF EXISTS t_class;
CREATE TABLE t_class(
cno INT(4) PRIMARY KEY,
cname VARCHAR(32)
);
2.4 找出每个学生的班级名称
SELECT s.sname,c.cname FROM t_student s JOIN t_class c ON s.`classno` = c.`cno`;
用法:在添加级联更新与级联删除的时候,需要在外键约束后面添关键字
注意:级联更新与级联删除操作谨慎使用,因为级联操作会将数据改变或者删除
1)级联删除:on delete cascade
定义:在删除父表数据的时候,级联删除子表中数据;
a)删除外键约束
ALTER TABLE t_student DROP FOREIGN KEY t_student_classno_fk;
b)添加外键约束及级联删除功能
语法:alter table 表名 add constraint 外键名称 foreign key(外键字段) references 引用表名(引用表中字段名称) on delete cascade;
c)级联删除需求
①删除t_student中的外键
ALTER TABLE t_student DROP FOREIGN KEY t_student_classno_fk;
②增加t_student_classno_fk外键,并加入级联删除 on delete cascade;
ALTER TABLE t_student ADD CONSTRAINT t_student_classno_fk FOREIGN KEY(classno) REFERENCES t_class(cno) ON DELETE CASCADE;
2.6 级联更新
定义:在更新父表中数据的时候,级联更新子表中数据;
a)删除外键约束
语法:alter table 表名 drop foreign key 外键字段;
ALTER TABLE t_student DROP FOREIGN KEY t_student_classno_fk;
b)更新外键约束和添加级联更新功能
语法:alter table 表名 add constraint 外键名称 foreign key(外键字段) references 引用表名(引用表中字段名称) on update cascade
c)级联更新需求
①删除t_student中的外键
ALTER TABLE t_student DROP FOREIGN KEY t_student_classno_fk;
②增加t_student_classno_fk外键,并加入级联更新 on update cascade;
ALTER TABLE t_student ADD CONSTRAINT t_student_classno_fk FOREIGN KEY(classno) REFERENCES t_class(cno) ON UPDATE CASCADE;
(六)
通过采用不同的技术将数据存储在文件或内存中
每一种技术都有不同的存储机制,不同的存储机制提供不同的功能和能力
通过选择不同的技术,可以获得额外的速度或功能,改善我们的应用
2.查看存储引擎
show engines\G
1)在建表时,可使用<ENGINES>选项为CREATE TABLE语句显示指定存储引擎
create table table_name(
no int(4),
)engine = MylSAM;
2)如果创建表时没有指定存储引擎,则使用当前默认的存储引擎
3)默认的存储引起可在my.ini配置文件中使用default-storage-engin选项指定
4)修改表的存储引擎使用
alter table 表名 engine = 存储引擎名称
5)查看表使用的存储引擎
MyISAM引擎是MySQL数据库最常用的
它管理的表具有以下特征:
使用三个文件表示每个表:
a)格式文件——存储表的结构
b)数据文件——存储表的数据
c)索引文件——存储表的索引
InnoDB存储引擎是MySQL数据库的缺省引擎;
它管理的表具有以下特征:
a)每个InnoDB表在数据库目录中以.frm格式文件表示
b)InnoDB表空间tablespace被用于存储表的内容
c)提供一组用来记录事务性活动的日志文件
d)用commit、savepoint及rollback支持事务处理
e)提供全部ACID兼容
f)在MySQL服务器崩溃后提供自动恢复
使用MEMORY存储引擎的表,因为数据存储在内存中,且行的长度固定,所以使得MEMORY存储引擎非常快
MEMORY存储引擎管理的表具有下列特征:
a)在数据库目录内,每个表均以.frm格式文件表示
b)表数据及索引被存储在内存中
c)表级锁机制
MyISAM表最适合于大量的数据读而少量数据更新的混合操作。MyISAM表的另一种适用情形是适用压缩的只读表。
如果查询中包含较多的数据更新操作,应适用InnoDB,其行级锁机制和多版本的支持为数据读取和更新的混合提供了良好的并发机制
使用MEMORY存储引擎存储非永久需要的数据,或者是能够从基于磁盘的表中重新生成的数据
二、事务Transaction
1.事务是什么
1)一个最小的不可再分的工作单元
2)通常一个事务对应一个完整的业务
3)而一个完整的业务需要批量的DML语句共同完成
事务具有四个特性ACID:
1)原子性
事务是最小单元,不可再分
2)一致性
事务要求所有的DML语句操作的时候,必须保证同时成功或同时失败
3)隔离性
一个事务不会影响其他事务的运行
4)持久性
在事务完成之后,该事务对数据库所作的更改将持久地保存在数据库中,并不会被回滚
事务中的一些概念
1)开启事务:start transaction
2)结束事务:end transaction
3)提交事务:commit transaction
4)回滚事务:rollbakc transaction
和事务有关的两条SQL语句
1)commit:提交
2)rollback:回滚
事务开启和结束的标志
开启:任何一条DML语句执行,标志事务的开启
结束
a)提交:成功的结束,将所有的DML语句操作记录和底层硬盘文件中数据进行一次同步
MySQL默认事务:自动提交show variables like '%commit%';
在MySQL数据库管理系统中,默认情况下,事务是自动提交的;也就是说,只要执行一条DML语句,就开启了事务,并且提交了事务;
第一种:关闭MySQL事务自动提交
1)事务成功用法:start transaction; commit;
第一步:start transaction; 手动开启事务
第二步:DML语句... 执行批量DML语句
第三步:commit; 手动提交事务
2)回滚提交用法:start transaction; rollback;
第一步:start transaction; 手动开启事务
第二步:DML语句... 批量DML语句
第三步:rollbakc; 手动回滚事务
第二种:关闭MySQL事务自动提交:只对当前会话有效
1)两种关闭自动提交事务
a)set autocommit = off
b)set session autocommit = off
2)两种打开自动提交事务
a)set autocommit = on
b)set session autocommit = on
事务四个特性ACID之一:隔离性(isolation)
隔离性有四个隔离级别:
1)read uncommitted 读未提交
2)read committed 读已提交
3)repearable read 可重复读
4)serialiazble 串行化
read uncommitted 读未提交(级别最低)
1)事务A和事务B,事务A未提交的数据,事务B可以读取
2)这里读取的数据可以叫做“脏数据”或“脏读Dirty Read”
3)读未提交隔离级别最低,这种级别一般只在理论上存在,数据库默认隔离级别一般都高于该隔离级别
read committed 读已提交
1)事务A和事务B,事务A提交的数据,事务B才可读取到;
2)该隔离级别高于“读未提交”级别;
3)换句话说:对方事务提交之后的数据,当前事务才可读取到;
4)该隔离级别可以避免脏数据;
5)该隔离级别能够导致“不可重复读”
repeatable read 可重复读
1)事务A和事务B,事务A提交之后的数据,事务B读取不到
2)事务B可重复读到数据的
3)这种隔离级别高于“读已提交”
4)换句话说,对方提交之后的数据,还是读取不到
5)这种隔离级别可以避免“脏读和不可重复读”,达到“重复读取”
6)MySQL数据库管理系统默认隔离级别为:可重复读
7)虽然可以达到“可重复读”,但是会导致幻象读
serializable 串行化
1)事务A和事务B,事务A在操作数据库表中数据的时候,事务B只能排队等待
2)这种事务隔离级别一般很少使用,吞吐量太低,用户体验不好
3)这种隔离级别可以避免幻象读,每一个读取都是数据库表中真实的记录
4)事务A和事务B不再并发
查看隔离级别
1)查看当前会话级隔离级别
2)查看当前全局隔离级别
select @@qlobal.tx_isolation
设置服务器缺省隔离级别
1)修改my.init配置文件
transaction-isolation = READ-COMMITTED
隔离级别可选项为:
-READ-UNCOMMITTED
-READ-COMMITTED
-REPERATABLE-READ
-SERIALIZABLE
2)通过命令方式设置事务隔离级别
set transaction isolation level is xxx
隔离级别可选项为:
-READ-UNCOMMITTED
-READ-COMMITTED
-REPERATABLE-READ
-SERIALIZABLE
三、视图
1.什么是视图
1)视图在数据库管理系统中也是一个对象,也是以文件形式存在的
语法结构:create view 视图名称 as 查询语句
create view myview as select empno,ename,sal from emp;
3.删除视图
语法结构:drop view if exists 视图名称
drop view if exists myview
4.修改视图
语法结构:alter view 视图名称 as 查询语句
alter view myview as select deptno,ename,job,sal from emp;
四、数据库设计三范式
1.第一范式:主键、字段不能再分
定义:要求有主键,数据库中不能出现重复记录,每一个字段是原子性不能再分;
1)每一行必须唯一,也就是每个表必须有主键
2)主键通常采用数值型或定长字符串表示
定义:第二范式是建立在第一范式基础之上,要求数据库中所有非主键字段完全依赖主键,不能产生部分依赖
3.第三范式:建立在第二范式基础之上,要求主键字段不能产生传递依赖于主键字段
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/130764.html