
Chapter 11 特征选择和稀疏学习
1 子集搜索与评价
一个样本通常有多个属性,如西瓜有色泽,根蒂,颜色等。将属性称之为特征,对一个学习任务而言,有用的特征称之为“相关特征”(relevant feature),用处不大的特征称之为“无关特征”(irrelevant feature)。在特征集合中选出相关特征子集的过程称之为特征选择。特征选择不仅可以解决维数灾难,亦可以降低学习任务的难度。
子集搜索(subset search)
Input: 特征集$\left\{ a_1,a_2,...,a_{\mathrm{d}} \right\}$ Do: 将每个特征视为一个属性子集 Repeat: 在k-1轮的最优属性集中每次放入一个未被选择特征,构成包含有k个特征的候选特征子集(可生成d-k个) 评价d-k个候选特征子集 选取最优的一个特征子集(包含有k个特征) Until: 第k+1轮加入一个新特征后的最优子集不如第k轮最优子集效果好 Output: 最优特征子集 讯享网
子集评价(subset evaluation)
对每个特征,使用信息增益进行评价后选择最优特征。
假定数据集D中第i类样本所占比例为 p i p_i pi ,对属性子集A,当前特征有V个取值时,根据样本取值将样本集D分成了V个子集 { D 1 , D 2 , . . . , D V } \left\{ D^1,D^2,...,D^V \right\} {
D1,D2,...,DV},每个子集中样本在属性子集A中取值相同,计算属性子集A的信息增益为:
G a i n ( A ) = E n t ( D ) − ∑ v = 1 V ∣ D V ∣ ∣ D ∣ E n t ( D V ) Gain\left( A \right) =Ent\left( D \right) -\sum_{v=1}^V{\frac{\left| D^V \right|}{\left| D \right|}}Ent\left( D^V \right) Gain(A)=Ent(D)−v=1∑V∣D∣∣∣DV∣∣Ent(DV)
其中信息熵定义为:
E n t ( D ) = − ∑ k = 1 ∣ y ∣ p k log 2 p k Ent\left( D \right) =-\sum_{k=1}^{\left| y \right|}{p_k\log _2}p_k Ent(D)=−k=1∑∣y∣pklog2pk
其中 ∣ y ∣ |y| ∣y∣表示样本集D在属性集A中特征类别的数量。
信息增益 G a i n ( A ) Gain\left( A \right) Gain(A)越大,则特征子集A包含有助于分类的信息越多,对每个候选特征子集D进行评价,选取信息增益最大的候选特征子集作为最优特征子集。
特征选择方法 = 特征子集搜索机制 + 子集评价机制
常见特征选择方法可以分为:过滤式(filter)、包裹式(wrapper)、嵌入式(embedding)
2 过滤式选择
过滤式选择方法先对数据集进行特征选择,然后再训练学习器,特征选择的过程与学习器无关。
Relif(Relevant feature)算法设定“相关统计量”来度量特征重要性,相关统计量(向量)的每个分量对应一个特征,特征子集的重要性由子集中特征对应的相关统计量分量之和来决定。可设置阈值或欲选取的特征个数来筛选最优特征。
Relif算法流程如下:
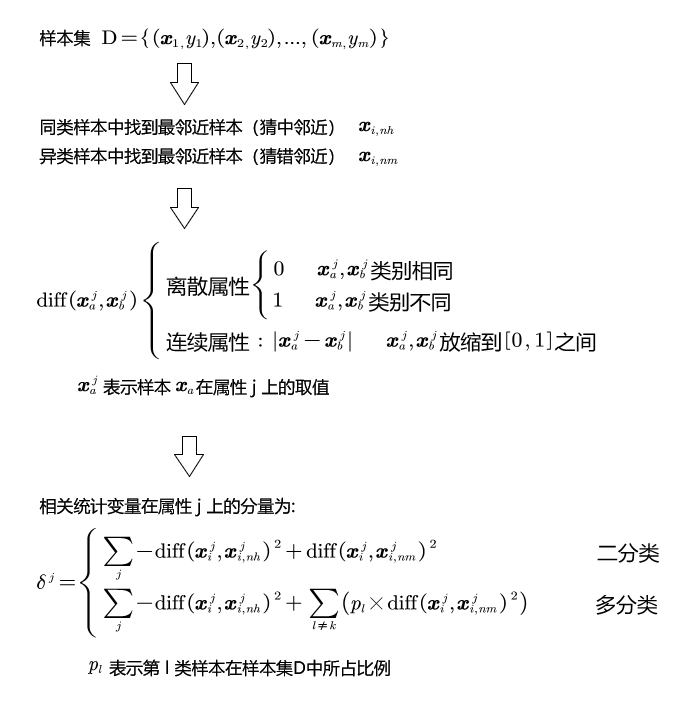
容易看出, δ j \delta ^j δj越大,对应属性的分类能力就越强。
3 包裹式选择
包裹式选择直接将学习器的性能作为特征子集的评价指标,给学习器量身定做最优特征子集。
LVW (Las Vegas Wrapper) 使用随机策略进行子集搜索,将最终分类器(学习器)的误差作为特征子集的评价指标。
先随机产生特征子集A,通过交叉验证估计学习误差,不断更新(误差更小的特征子集)或(误差相等但子集内特征数更少的特征子集)作为最优子集,直到连续 T 轮不再更新。
4 嵌入式选择与L1正则化
嵌入式选择将特征选择与学习器训练融合在一起,共同在同一个优化过程中完成。
在简单的线性回归模型中,以平方误差为损失函数时,当样本特征过多容易过拟合,加入 L 2 L_2 L2范数正则化项后的优化目标为:
min ω ∑ i = 1 m ( y i − ω T x i ) 2 + λ ∣ ∣ ω ∣ ∣ 2 2 \underset{\boldsymbol{\omega }}{\min}\,\,\sum_{i=1}^m{\left( y_i-\boldsymbol{\omega }^{\mathrm{T}}x_i \right) ^2+\lambda ||\boldsymbol{\omega }||_{2}^{2}} ωmini=1∑m(yi−ωTxi)2+λ∣∣ω∣∣22
其中正则化系数 λ > 0 \lambda >0 λ>0,上式称为岭回归(ridge regression)。
将 L 2 L_2 L2范数正则化项推广为 L p L_p Lp范数正则化项,当p=1时,采用 L 1 L_1 L1范数正则化项的优化目标为:
min ω ∑ i = 1 m ( y i − ω T x i ) 2 + λ ∣ ∣ ω ∣ ∣ 1 \underset{\boldsymbol{\omega }}{\min}\,\,\sum_{i=1}^m{\left( y_i-\boldsymbol{\omega }^{\mathrm{T}}x_i \right) ^2+\lambda ||\boldsymbol{\omega }||_{1}^{\,\,}} ωmini=1∑m(yi−ωTxi)2+λ∣∣ω∣∣1其中正则化系数 λ > 0 \lambda >0 λ>0,上式称为LASSO(Least Absolute Shrinkage and Selection Operator,最小绝对收缩选择算子)。
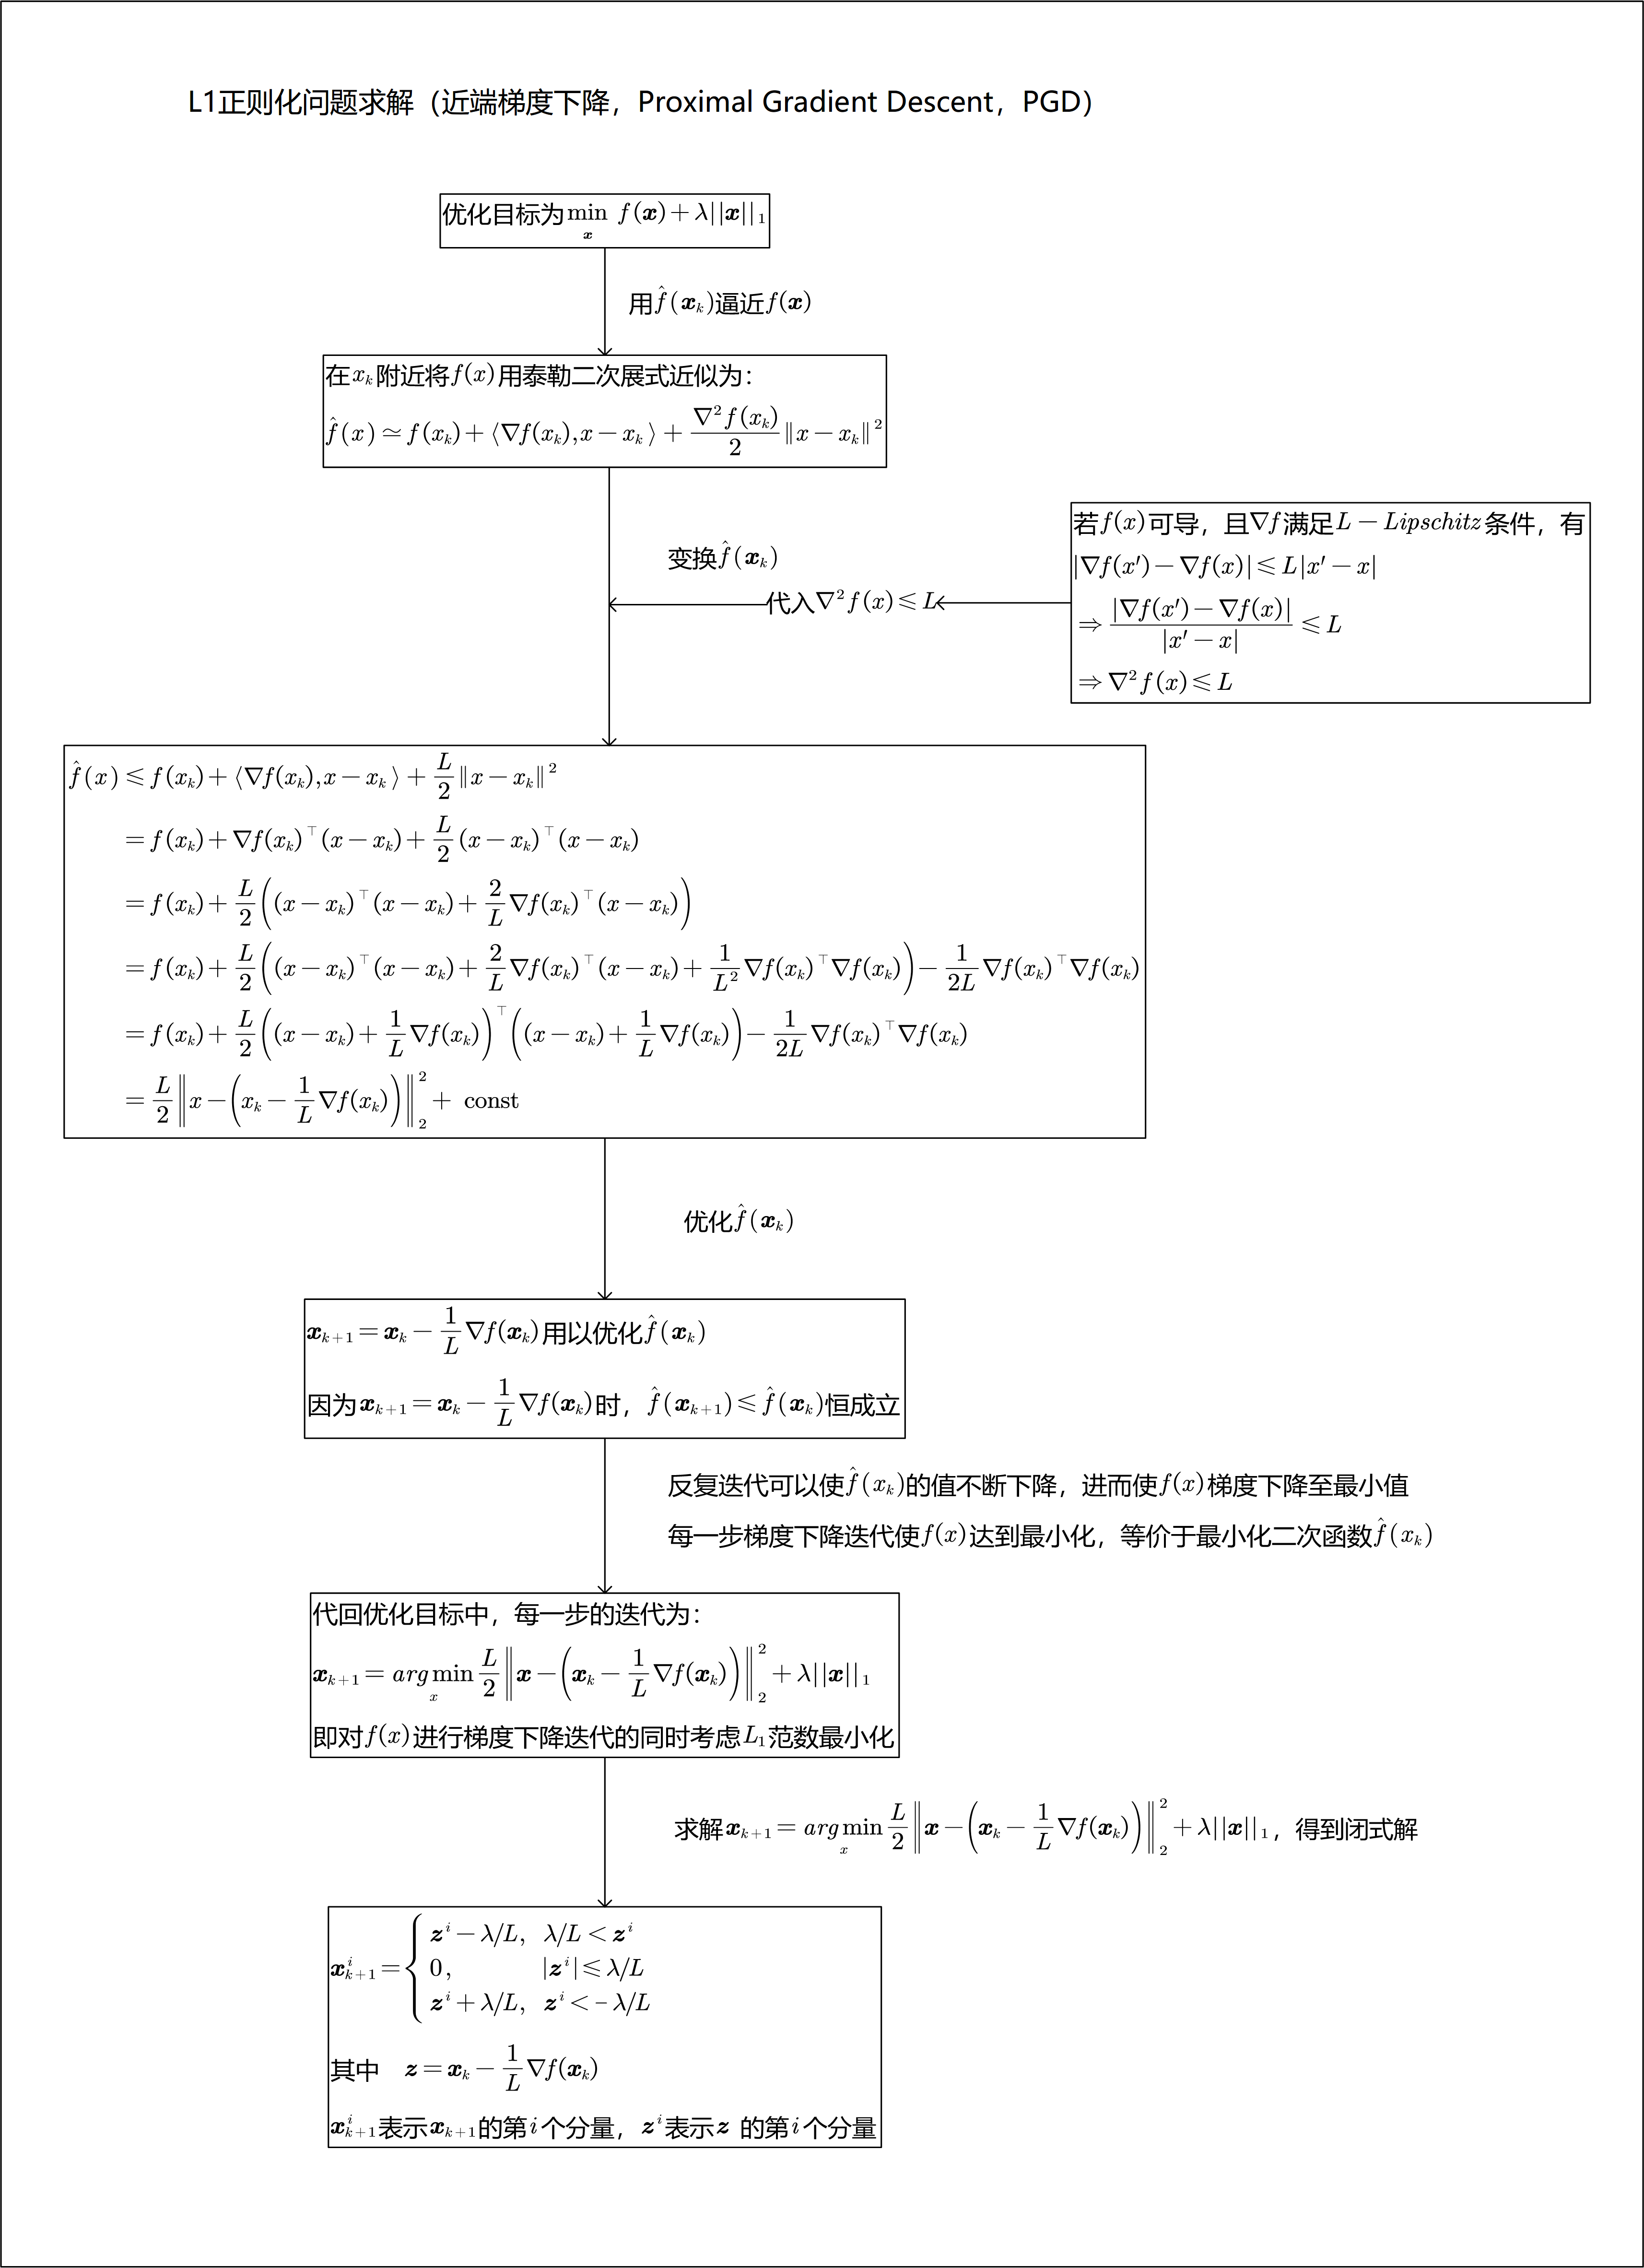
L 1 L_1 L1范数正则化及 L 2 L_2 L2范数正则化都可以降低过拟合风险,但 L 1 L_1 L1范数正则化的突出优势是更易获得稀疏解,即求得的向量 ω \boldsymbol{\omega } ω将含有更多的零分量,零向量对应的特征被剔除。换言之,基于 L 1 L_1 L1范数正则化的学习方法是一种嵌入式特征选择方法,其特征选择过程与学习器训练过程融为一体,共同完成。
5 稀疏表示与字典学习
将样本集D看成一个矩阵,每行表示一个样本,每列对应一个特征。通过特征选择方法去除与学习任务无关的列可以降低学习难度,减少计算开销。在文档分类任务中,将每个文档作为一个样本,将每个字(词)作为一个特征,行列交汇处为该列字在该文档中出现的次数,于是矩阵每一行内都含有大量零元素,但又不是出现在同一列。如下图:
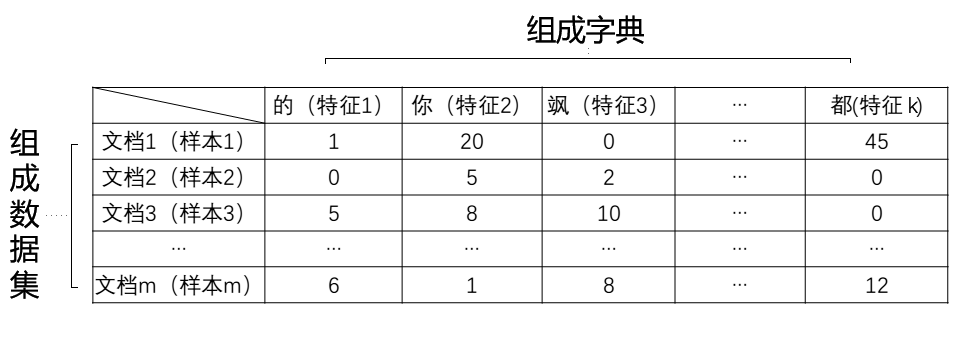
当每个样本具有大量零元素时,称为稀疏表达形式,稀疏表达形式对机器学习有很大好处,可使很多问题线性可分,亦可高效储存稀疏矩阵。
字典学习(dictionary learning)/ 稀疏编码(sparse coding):为普通稠密的样本集找到合适的字典以转化为稀疏表达形式。字典亦称为码书(codebook)。
字典学习的简单形式是:
min B , α i ∑ i = 1 m ∥ x i − B α i ∥ 2 2 + λ ∑ i = 1 m ∥ α i ∥ 1 \min_{\mathbf{B},\boldsymbol{\alpha }_i} \sum_{i=1}^m{\left\| \boldsymbol{x}_i-\mathbf{B}\boldsymbol{\alpha }_i \right\| _{2}^{2}}+\lambda \sum_{i=1}^m{\left\| \boldsymbol{\alpha }_i \right\| _1} B,αimini=1∑m∥xi−Bαi∥22+λi=1∑m∥αi∥1
其中 B \mathbf{B} B为字典矩阵(d x k型), α i \boldsymbol{\alpha }_i αi(k 维) 为样本 x i \boldsymbol{x}_i xi (d 维)的稀疏表示。容易看出,第一项中希望稀疏表示 α i \boldsymbol{\alpha }_i αi 通过字典矩阵重构后能与原先的样本 x i \boldsymbol{x}_i xi 尽可能相近;第二项希望稀疏表示 α i \boldsymbol{\alpha }_i αi 尽可能稀疏。
使用变量交替优化来更新上式:
第一步先固定字典B,更新 α i \boldsymbol{\alpha }_i αi,为每个样本找到对应的 α i \boldsymbol{\alpha }_i αi:
min α i ∥ x i − B α i ∥ 2 2 + λ ∥ α i ∥ 1 \min_{\boldsymbol{\alpha }_i} \left\| \boldsymbol{x}_i-\mathbf{B}\boldsymbol{\alpha }_i \right\| _{2}^{2}+\lambda \left\| \boldsymbol{\alpha }_i \right\| _1 αimin∥xi−Bαi∥22+λ∥αi∥1
第二步用 α i \boldsymbol{\alpha }_i αi的初值来更新字典B:
min B ∥ X − B A ∥ F 2 \min_{\mathbf{B}} \left\| \boldsymbol{X}-\mathbf{B}\boldsymbol{A} \right\| _{F}^{2} Bmin∥X−BA∥F2
其中 X = ( x 1 , x 2 , . . . , x m ) \boldsymbol{X}=\left( \boldsymbol{x}_1,\boldsymbol{x}_2,...,\boldsymbol{x}_m \right) X=(x1,x2,...,xm)(dxm), A = ( α 1 , α 2 , . . . , α m ) \boldsymbol{A}=\left( \boldsymbol{\alpha }_1,\boldsymbol{\alpha }_2,...,\boldsymbol{\alpha }_m \right) \,\, A=(α1,α2,...,αm)(kxm), ∥ ⋅ ∥ F \left\| \cdot \right\| _{F}^{\,\,} ∥⋅∥F是矩阵的Frobenius范数。
求解第二步,常用基于逐列更新策略的KSVD,令 b i b_i bi表示矩阵B第i列,令 α i \boldsymbol{\alpha }^i αi表示矩阵A第i行,第二步重写为:
min B ∥ X − B A ∥ F 2 \min_{\mathbf{B}} \left\| \boldsymbol{X}-\mathbf{B}\boldsymbol{A} \right\| _{F}^{2} Bmin∥X−BA∥F2
= min b i ∥ X − ∑ j = 1 k b j α j ∥ F 2 =\underset{b_i}{\min}\left\| \boldsymbol{X}-\sum_{j=1}^k{\boldsymbol{b}_j\boldsymbol{\alpha }^j} \right\| _{F}^{2} =bimin∥∥∥∥∥X−j=1∑kbjαj∥∥∥∥∥F2
= min b i ∥ ( X − ∑ j ≠ i b j α j ) − b i α i ∥ F 2 =\underset{b_i}{\min}\left\| \left( \boldsymbol{X}-\sum_{j\ne i}^{\,\,}{\boldsymbol{b}_j\boldsymbol{\alpha }^j} \right) -\boldsymbol{b}_i\boldsymbol{\alpha }^i \right\| _{F}^{2} =bimin∥∥∥∥∥∥⎝⎛X−j=i∑bjαj⎠⎞−biαi∥∥∥∥∥∥F2
= min b i ∥ E i − b i α i ∥ F 2 =\underset{b_i}{\min}\left\| \boldsymbol{E}_i-\boldsymbol{b}_i\boldsymbol{\alpha }^i \right\| _{F}^{2} =bimin∥∥Ei−biαi∥∥F2
更新第二步中的字典时,由于其他列固定,即 E i \boldsymbol{E}_i Ei也固定,原则上对 E i \boldsymbol{E}_i Ei进行奇异值分解取得最大奇异值对应的正交向量即可,但直接对 E i \boldsymbol{E}_i Ei进行奇异值分解会修改 b i b_i bi, α i \boldsymbol{\alpha }^i αi,从而破坏A的稀疏性。KSVD对 E i \boldsymbol{E}_i Ei和 α i \boldsymbol{\alpha }^i αi专门处理: α i \boldsymbol{\alpha }^i αi仅保留非零元素, E i \boldsymbol{E}_i Ei则仅保留 b i b_i bi与 α i \boldsymbol{\alpha }^i αi零元素的累计项,然后再进行奇异值分解,即可保证稀疏的同时,通过对 E i \boldsymbol{E}_i Ei进行奇异值分解以使上式最小化。
最小化字典矩阵B,先初始化B,再迭代运行上述两步,即可求出B和 α i \boldsymbol{\alpha }_i αi。
6 压缩感知
压缩感知关注于利用信号本身的稀疏性,如何将接收到的信号(部分样本)重构出原信号。压缩感知包含感知测量和重构恢复,感知测量关注如何对原信号处理以获得稀疏样本表示,重构恢复关注如何基于稀疏性从部分样本中恢复原信号。
假设原始离散信号 x 的长度为 m,假定以远小于奈奎斯特采样定理的要求采样得到长度为 n 的信号 y,n << m,即有:
y = Φ x \boldsymbol{y}=\mathbf{\Phi }\boldsymbol{x} y=Φx
其中 Φ \mathbf{\Phi } Φ(nxm)是采样矩阵。
显然,若已知 Φ \mathbf{\Phi } Φ, x x x 时容易得出 y y y;但难从 y y y , Φ \mathbf{\Phi } Φ 得到原始信号 x x x,因为n << m, y = Φ x \boldsymbol{y}=\mathbf{\Phi }\boldsymbol{x} y=Φx 是一个欠定方程。
若假设一个线性变换 Ψ ∈ R m × m \mathbf{\Psi }\in \mathbf{R}^{m\times m} Ψ∈Rm×m, Ψ \mathbf{\Psi } Ψ称为稀疏基,使得:
y = Φ x = Φ Ψ s = A s \boldsymbol{y}=\mathbf{\Phi }\boldsymbol{x}=\mathbf{\Phi \Psi }\boldsymbol{s}=\mathbf{A}\boldsymbol{s} y=Φx=ΦΨs=As
其中 A = Φ Ψ ∈ R n × m \mathbf{A}=\mathbf{\Phi \Psi }\in \mathbf{R}^{n\times m} A=ΦΨ∈Rn×m,作用类似字典,将信号转换为稀疏表示。当 s \boldsymbol{s} s具有稀疏性,则能根据 y \boldsymbol{y} y恢复出 s \boldsymbol{s} s(因为稀疏性排除了很多未知因素),进而通过 x = Ψ s \,\,\boldsymbol{x}=\mathbf{\Psi }\boldsymbol{s} x=Ψs恢复原信号 x \boldsymbol{x} x。
对于大小为nxm的矩阵A,若存在常数 δ k ∈ ( 0 , 1 ) \delta _k\in \left( 0,1 \right) δk∈(0,1),使得任意向量 s \boldsymbol{s} s和A的所有子矩阵 A k ∈ R n × k \boldsymbol{A}_k\in \mathrm{R}^{n\times k} Ak∈Rn×k满足:
( 1 − δ k ) ∥ s ∥ 2 2 ⩽ ∥ A k − s ∥ 2 2 ⩽ ( 1 + δ k ) ∥ s ∥ 2 2 \left( 1-\delta _k \right) \left\| \boldsymbol{s} \right\| _{2}^{2}\leqslant \left\| \boldsymbol{A}_k-\boldsymbol{s} \right\| _{2}^{2}\leqslant \left( 1+\delta _k \right) \left\| \boldsymbol{s} \right\| _{2}^{2} (1−δk)∥s∥22⩽∥Ak−s∥22⩽(1+δk)∥s∥22
则称A满足k限定等距性(k-RIP),A满足此特性时,可通过从下式优化,从y中恢复出稀疏信号s,进而恢复出原始信号x:
min s ∥ s ∥ 0 \underset{s}{\min}\left\| \boldsymbol{s} \right\| _0 smin∥s∥0
s . t . y = A s s.t. \ \boldsymbol{y}=\mathbf{A}\boldsymbol{s}\,\, s.t. y=As
L0范数最小化式NP难问题,L1范数最小化再一定条件下与L0范数最小化同解,只需关注:
min s ∥ s ∥ 1 \underset{s}{\min}\left\| \boldsymbol{s} \right\| _1 smin∥s∥1
s . t . y = A s s.t. \ \boldsymbol{y}=\mathbf{A}\boldsymbol{s}\,\, s.t. y=As
至此,压缩感知的问题可以求解L1范数最小化求解,可通过转化为LASSO的等价形式再通过近端梯度下降法求解。
收集读者对书籍的喜好程度可以实现用户分析,原始数据中往往有很多缺失数据(?表示),当信号(读书喜好数据)具有稀疏表示时,可以,可以通过压缩感知任务恢复采样信号。
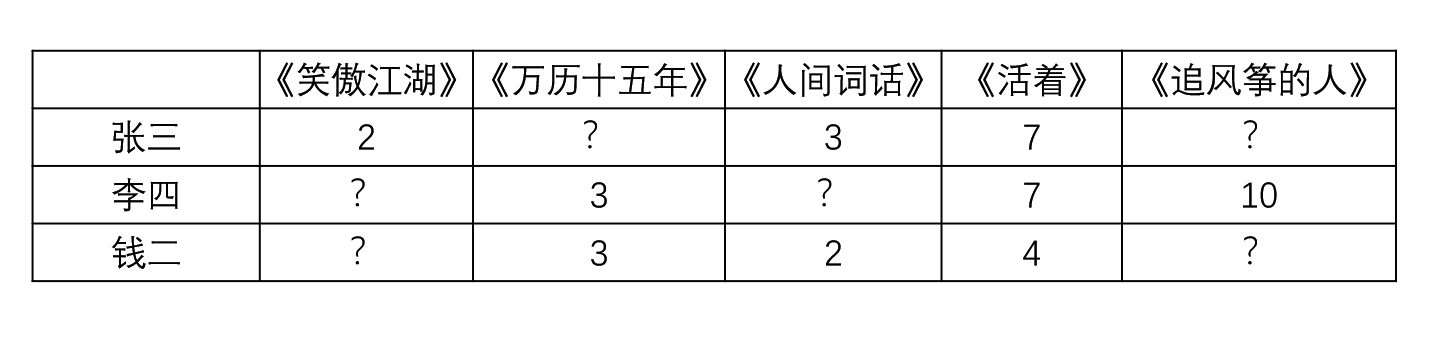
矩阵补全技术(matrix completion)用以解决此类问题,形式为:
min X r a n k ( X ) \underset{\mathbf{X}}{\min}\,\,\mathrm{rank}\left( \mathbf{X} \right) Xminrank(X)
s . t . ( X ) i j = ( A ) i j , ( i , j ) ∈ Ω s.t. \left( \mathbf{X} \right) _{ij}=\left( \mathbf{A} \right) _{ij}\,\,,\left( i,j \right) \in \varOmega s.t.(X)ij=(A)ij,(i,j)∈Ω
其中A表示上表中的已观察信号,X表示需要恢复的稀疏信号, i j ij ij表示A中的’?'元素下标。
r a n k ( X ) \mathrm{rank}\left( \mathbf{X} \right) rank(X)在 { X ∈ R m × n : ∥ X ∥ F 2 ⩽ 1 } \left\{ \mathbf{X}\in \mathbf{R}^{m\times n}:\left\| \mathbf{X} \right\| _{F}^{2}\leqslant 1 \right\} {
X∈Rm×n:∥X∥F2⩽1}上的凸包是X的“核范数”(迹范数,trace norm):
∥ X ∥ ∗ = ∑ j = 1 min { m , n } σ j ( X ) \left\| \mathbf{X} \right\| _{*}^{\,\,}=\sum_{j=1}^{\min \left\{ m,n \right\}}{\sigma _j\left( \mathbf{X} \right)} ∥X∥∗=j=1∑min{
m,n}σj(X)
其中 σ j ( X ) \sigma _j\left( \mathbf{X} \right) σj(X)表示X的奇异值,即矩阵的核范数为矩阵的奇异值之和,可以通过最小化核范数来近似求解最小化X的迹:
min X ∥ X ∥ ∗ \underset{\mathbf{X}}{\min}\,\,\left\| \mathbf{X} \right\| _{*}^{\,\,} Xmin∥X∥∗
s . t . ( X ) i j = ( A ) i j , ( i , j ) ∈ Ω s.t. \left( \mathbf{X} \right) _{ij}=\left( \mathbf{A} \right) _{ij}\,\,,\left( i,j \right) \in \varOmega s.t.(X)ij=(A)ij,(i,j)∈Ω
上式为凸优化问题,可通过半正定规划求解。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/115057.html