
源视频
整个流程:
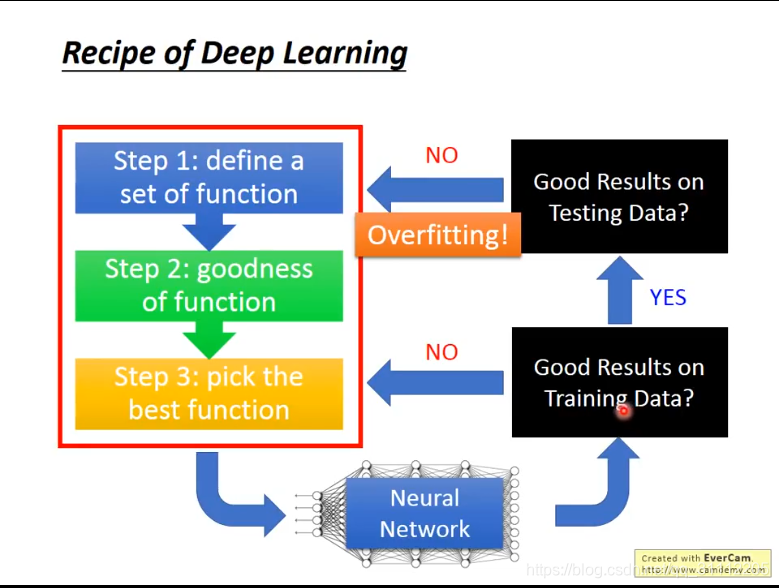
最后的结果不好,不同阶段会有不同原因。不同的原因有不同的解决方法,如下:
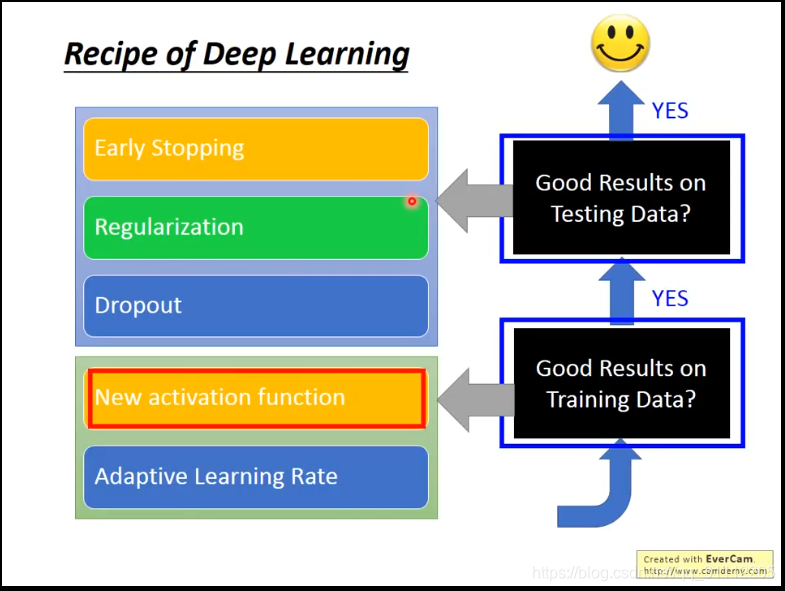
1.在训练阶段(loss降不下来)
- 为什么有时候越深的网络,反而在训练阶段没有好的loss呢?
梯度消失。激活函数没有选好。比如选的激活函数是Sigmoid,这个激活函数的值区间是(0,1),随着网络层的增加,输入的值对最后的输出的影响会越来越小,以至于训练不到后面的网络层。解决办法:可以尝试使用ReLU激活函数(该函数的区间是[0,正无穷));也有改进的ReLU函数,比如leaky ReLU,Parametric ReLU,或者更加激进的maxout。 - 采用自适应的学习率,比如Adagrad(考虑前面的学习率),更好的RMSProp。
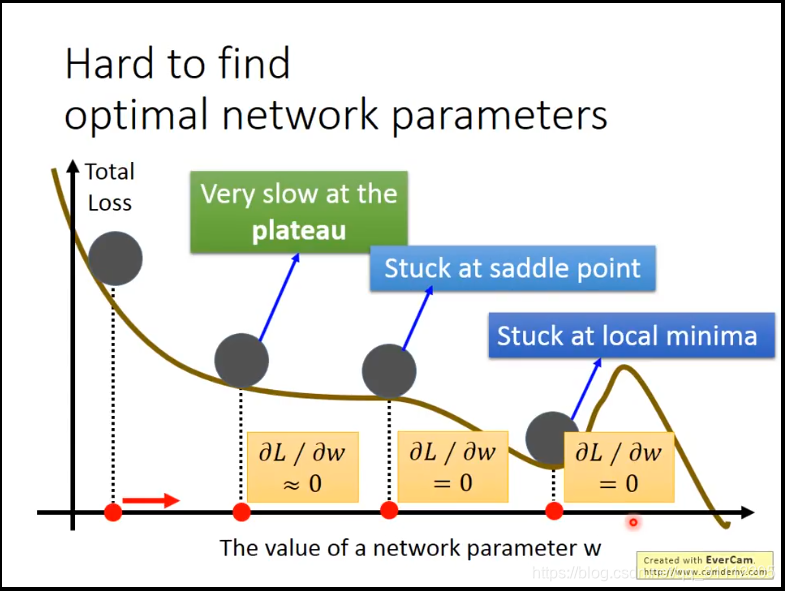
- 局部最优导致loss下不来。
如下图,不能说解决,只能说目前比较好的方法是用Momentum
- 采用Adam = RMSProp + Momentum
2.测试阶段(测试效果不好)
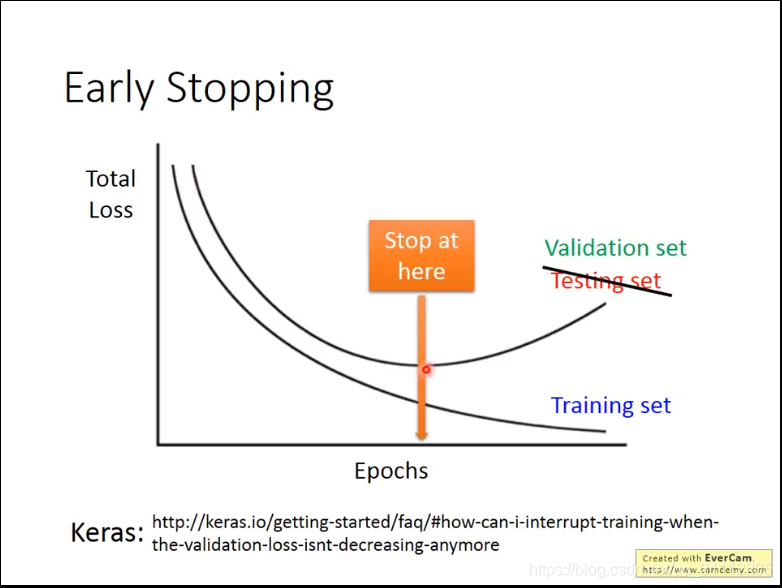
- 提前终止训练。如下图
- 正则化(效果可能不会那么显著)。如果用L1,可能weight有很大的值,也有小的甚至为0的weight;如果用L2,weight的值比较平均。
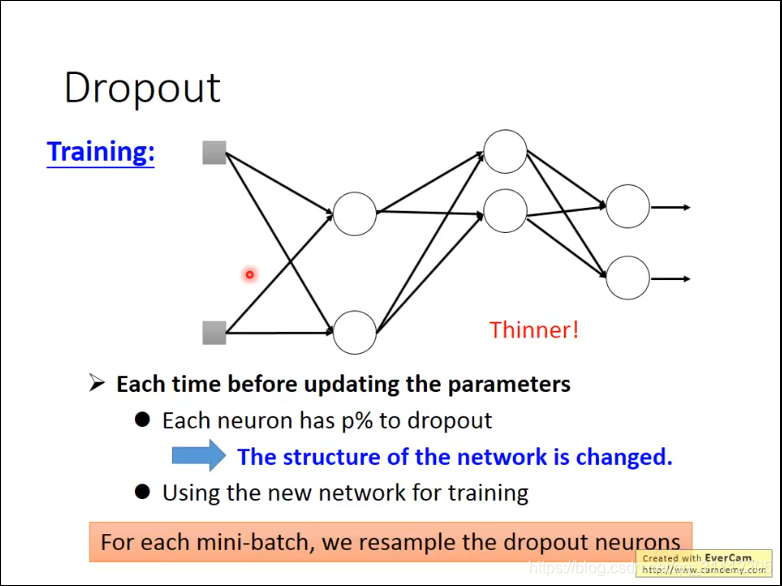
- dropout。效果如下图(在训练的时dropout,在testing不用dropout,但是weight需要乘(1-dropout率))
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/114723.html