
本篇推文翻译自Manuel Gimond的在线教程Intro to GIS and Spatial Analysis的附录F Raster operations in R,网址为https://mgimond.github.io/Spatial/raster-operations-in-r.html。原教程遵循CC BY-NC 4.0共享协议(https://creativecommons.org/licenses/by-nc/4.0/deed.zh)。
本文虽然不是逐字逐句地翻译,但没有对原文的内容进行删减。原文篇幅较长,共有6小节,这里为前4节。
1 Sample files for this exercise
本文使用的示例数据可以从以下网站中加载,其中包含了三个数据:高程数据elev(栅格)、深度数据bath(栅格)、洲界数据cont(矢量)。
load(url("https://github.com/mgimond/Spatial/raw/main/Data/raster.RData"))讯享网
- 译者注:若通过上面代码无法加载数据,可以直接通过链接下载到本地并进行加载。如下:
讯享网load("114-1.raster.rdata")
两个栅格数据的范围都覆盖全球。在elev中,平均海平面以下的地区都被编码为0;类似地,在bath中,平均海平面以上的地区也都被编码为0。
需要注意的是,这里使用的地图代数操作符和函数(map algebra operations and functions)都来自raster工具包,关于它们的理论讨论请参见本书第10章(译者注:https://mgimond.github.io/Spatial/chp10_0.html)。
2 Local operations and functions
2.1 Unary operations and functions (applied to single rasters)
大部分代数操作符都能应用于栅格对象。例如,将bath中的深度数据从正数转换成负数的形式,只需要将该栅格乘以-1。
library(raster) bath2 <- bath * (-1)另外一种类型的一元操作符是重分类(reclassification)。在接下的例子中,我们将使bath2中所有小于0的值变为1,而所有0值保持不变。一个简单的方法就是使用条件语句。
讯享网bath3 <- bath2 < 0
让我们来看一下输出结果。注意,值为0的像元会被编码为FALSE,值为1的像元则会被编码为TRUE
library(tmap) tm_shape(bath3) + tm_raster(palette = "Greys") + tm_legend(outside = TRUE, text.size = .8)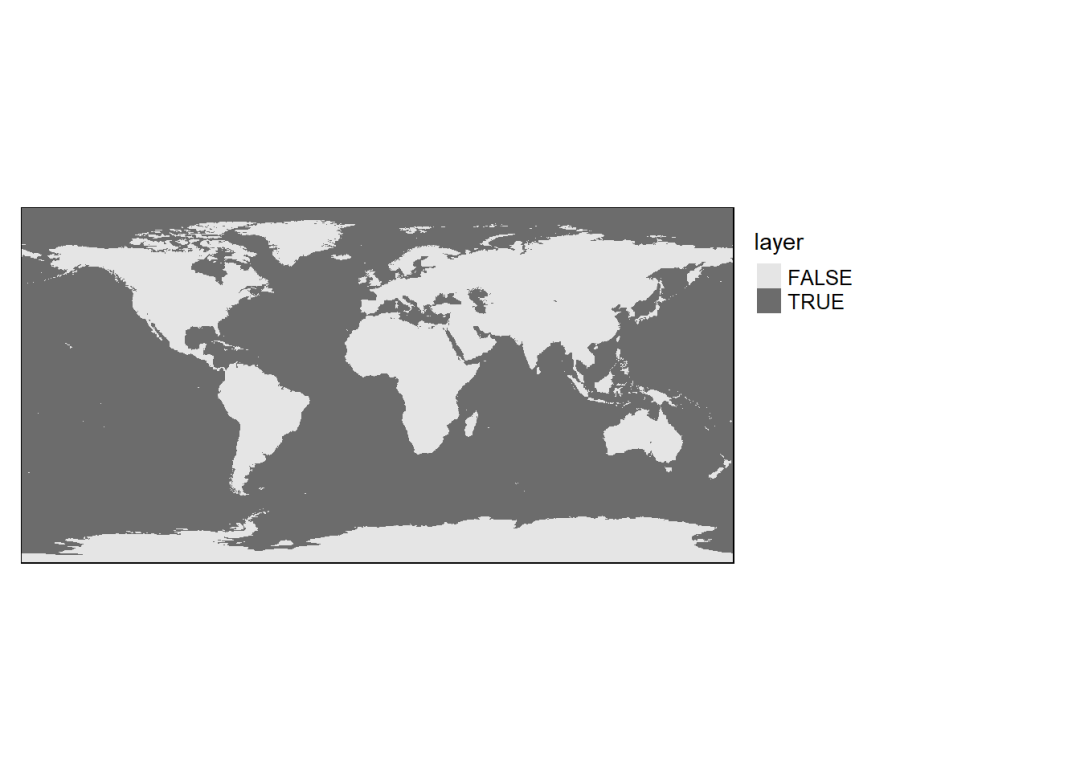
讯享网
如果需要进行多分类,可以使用reclassify()函数。在下面的例子中,bath中的像元被分成4类:100、500、1000和11000。
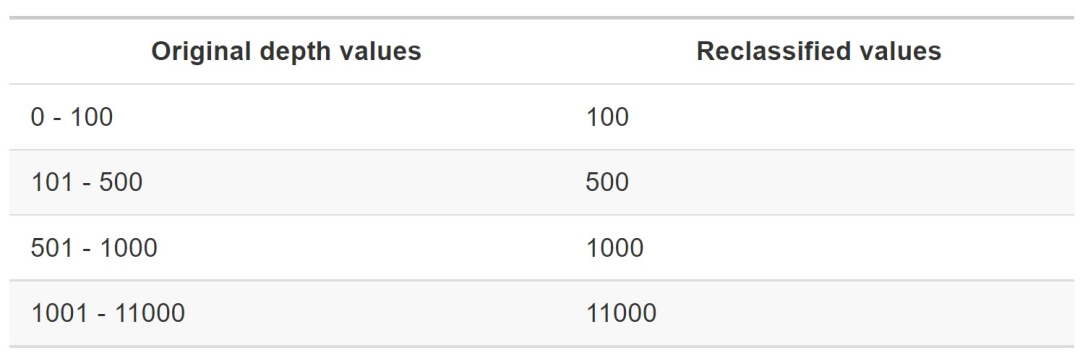
第一步就是创建一个矩阵,它的第一、第二列分别是原始值范围的起始和终点值,第三列则对应重分类后的值。
讯享网m <- c(0, 100, 100, 100, 500, 500, 500, 1000, 1000, 1000, 11000, 11000) m <- matrix(m, ncol = 3, byrow = T) m [,1] [,2] [,3] [1,] 0 100 100 [2,] 100 500 500 [3,] 500 1000 1000 [4,] 1000 11000 11000
bath3 <- reclassify(bath, m, right = T)上面代码中的right = T表示区间范围是左开右闭的,也就是说第二列对应的值是包括在当前类的。
讯享网tm_shape(bath3) + tm_raster(style = "cat") + tm_legend(outside = TRUE, text.size = .8)
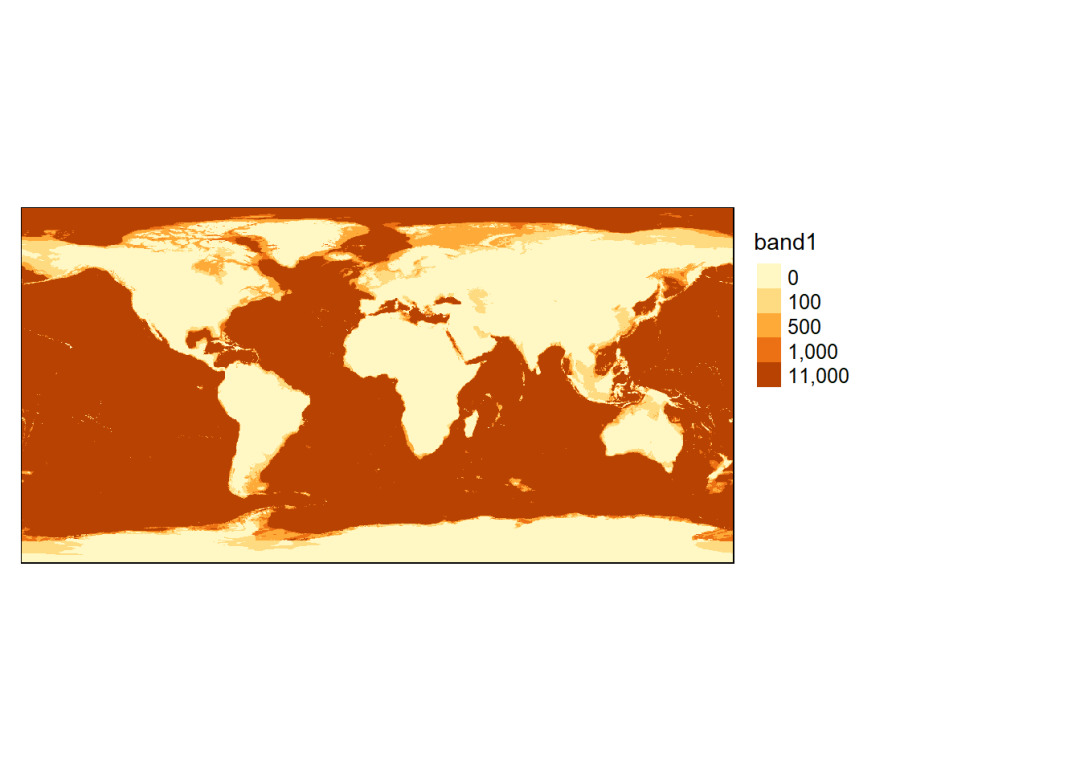
也可以将像元值定义成NA(缺失值)。例如,将重分类后等于100的像元值定义为NA。
bath3[bath3 == 100] <- NA下面代码在绘图时将这些缺失值使用灰色进行了高亮,并在图例中标记为missing。
讯享网tm_shape(bath3) + tm_raster(showNA = TRUE, colorNA = "grey") + tm_legend(outside = TRUE, text.size = .8)
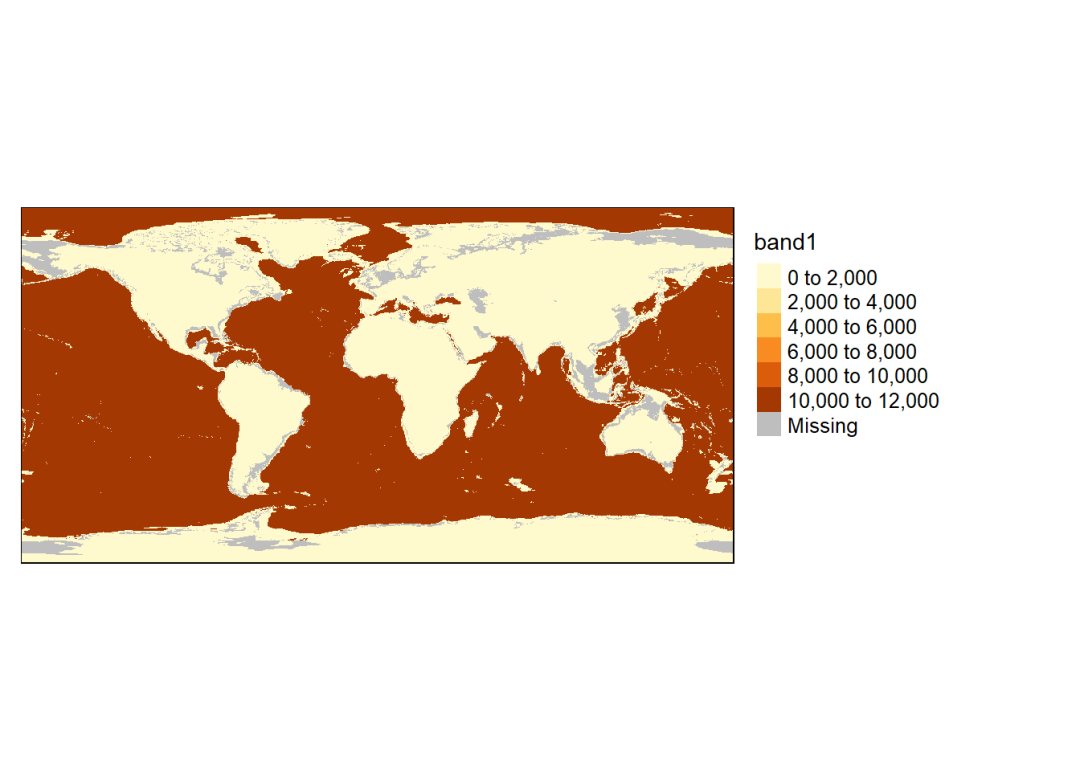
2.2 Binary operations and functions (where two rasters are used)
在下面的例子中,我们使用elev和bath相减来获得一个新的高程栅格,它表示海平面以上和海平面以下的距离之和。
elevation <- elev - bath tm_shape(elevation) + tm_raster(palette = "-RdBu",n = 6) + tm_legend(outside = TRUE, text.size = .8)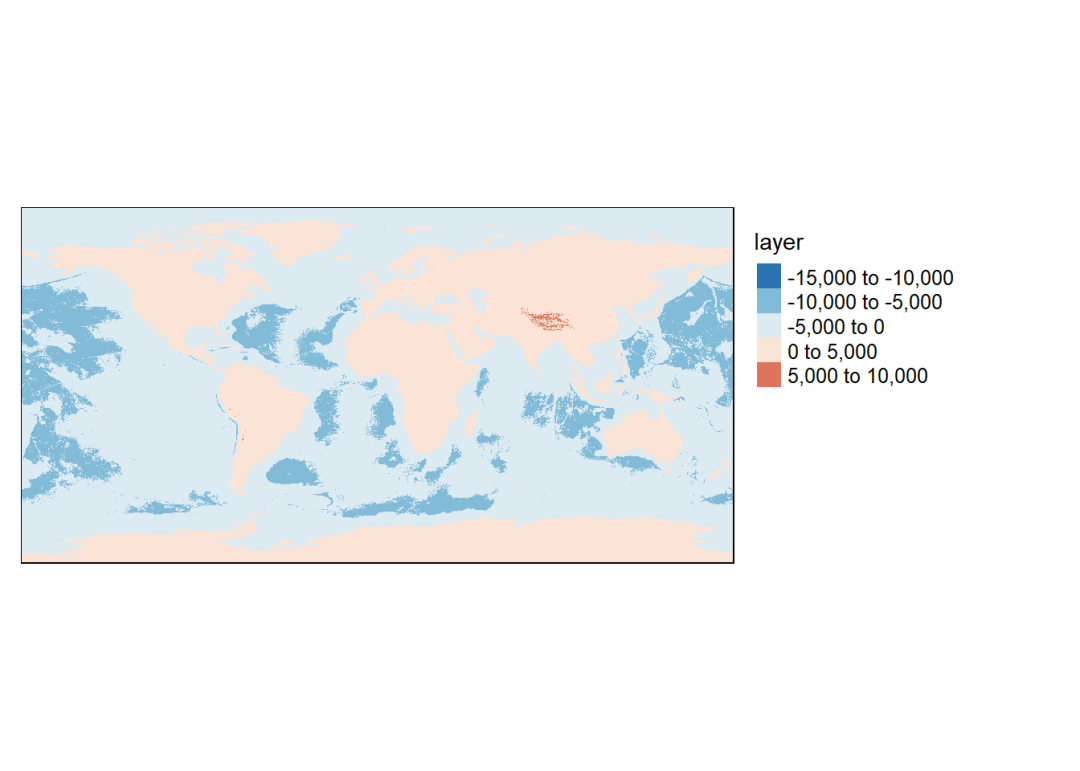
3 Focal operations and functions
该类操作符和函数在使用时需要定义邻近像元。例如,一个像元的输出值可以被定义为它邻近121个(11*11的核窗口)像元的平均值(这也是一个平滑函数的例子)。
讯享网f1 <- focal(elevation, w = matrix(1, nrow = 11,ncol = 11), fun = mean) tm_shape(f1) + tm_raster(palette = "-RdBu",n = 6) + tm_legend(outside = TRUE, text.size = .8)
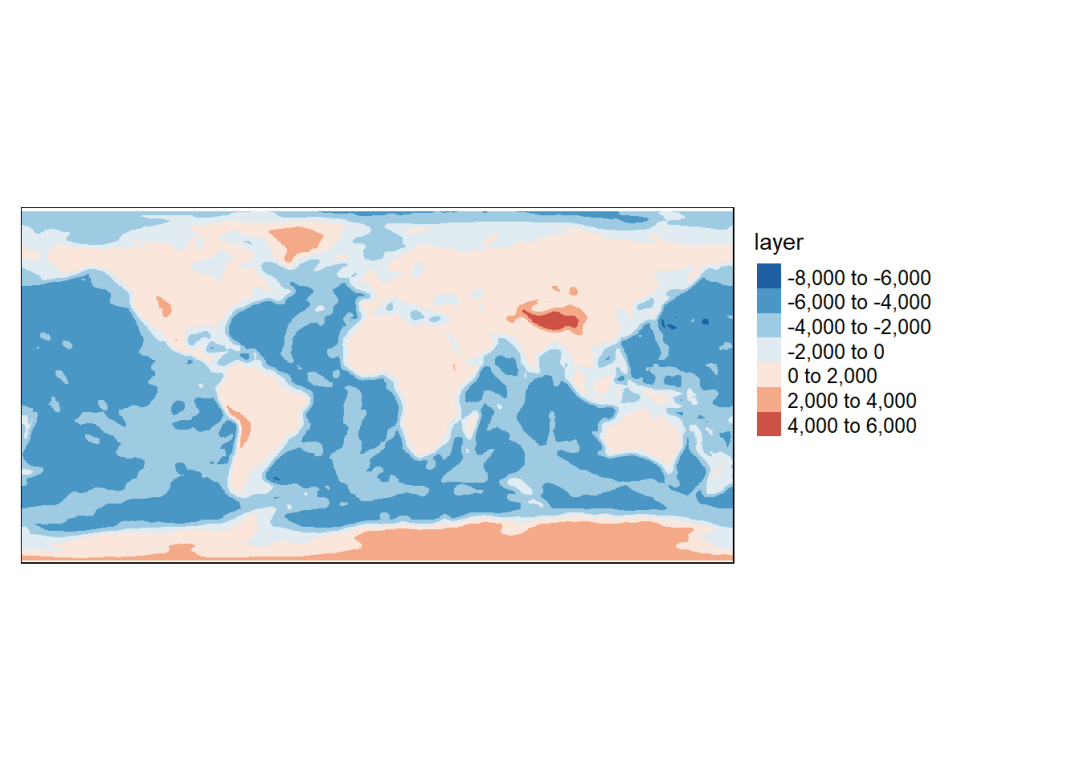
默认情况下,边缘的像元值为NA。这是因为栅格数据以外的像元是没有值的,但当计算边缘像元值时,它们可能会落入核窗口内。这种情况下可以通过设置参数na.rm = TREU和pad = TRUE来纠正(译者注:pad参数为TRUE时,计算中会在栅格范围之外添加虚拟的行和列,以消除边缘效应) 。
f2 <- focal(elevation, w = matrix(1, nrow = 11,ncol = 11) , fun = mean, pad = TRUE, na.rm = TRUE) tm_shape(f2) + tm_raster(palette = "-RdBu",n = 6) + tm_legend(outside = TRUE, text.size = .8)
- 译者注:原文这里的输出变量仍被命名为
f1,这里为作区分,将其命名为f2,通过以下代码可以清楚地看出二者的差异。
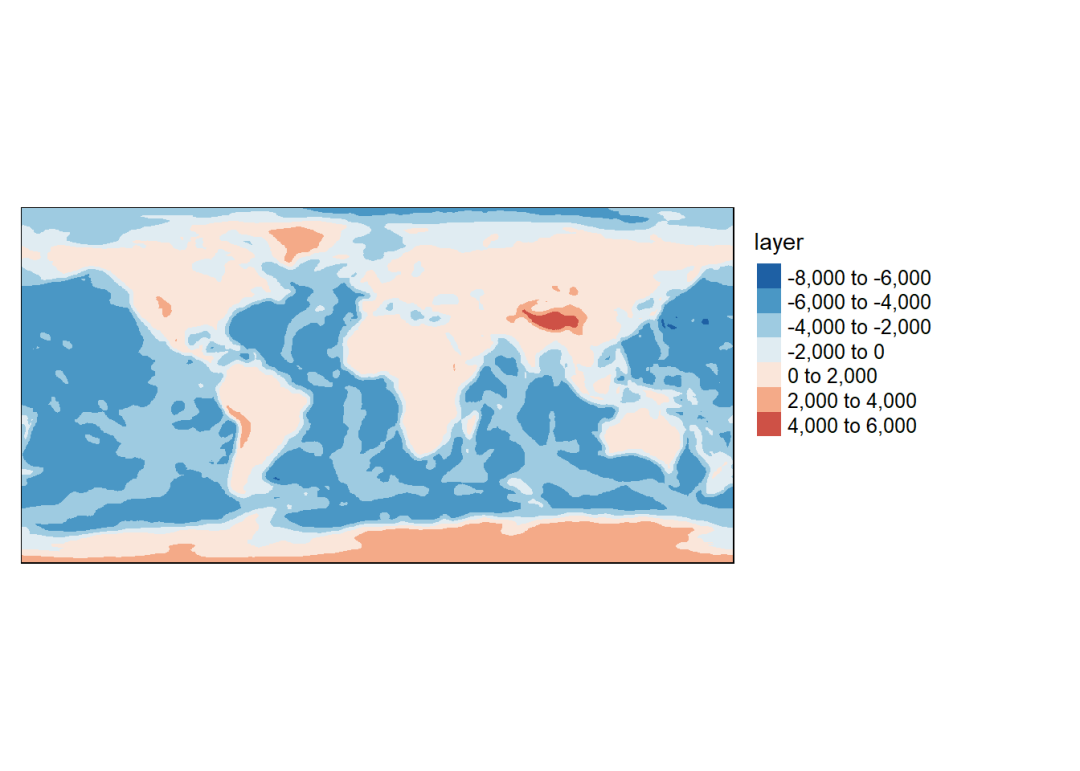
讯享网# 提取平滑后栅格左下角的像元值 f1[1,1] [1] NaN f2[1,1] [1] -3420.348
不过,在组合使用na.rm = TRUE和pad = TRUE时必须小心。在上面的例子中,窗口内像元的值以向量的形式被传递给mean()函数,而有效像元(非空值像元)的个数也会被传递给函数,这使得计算结果不会受到影响,因为该函数会以实际参与计算的像元个数来决定各邻近像元值的权重。
但是,如果平滑函数具有已定义的权重,再设置pad = TRUE就会导致计算边缘像元值时出现不平衡的权重(译者注:权重和小于1)。在接下来的例子中,我们比较以下平滑函数计算结果的差异(核窗口大小为3*3):
# Using the mean function f_mean <- focal(elevation, w = matrix(1, nrow = 3,ncol = 3), fun = mean, na.rm = TRUE, pad = TRUE) # Using explicitly defined weights f_wt_nopad <- focal(elevation, w = matrix(1/9, nrow = 3,ncol = 3), na.rm = TRUE, pad = FALSE) f_wt_pad <- focal(elevation, w = matrix(1/9, nrow = 3,ncol = 3), na.rm = TRUE, pad = TRUE)下面图像是每种情况下输出的栅格对象左上角9个像元的放大图,计算的输入栅格对象是elevation。
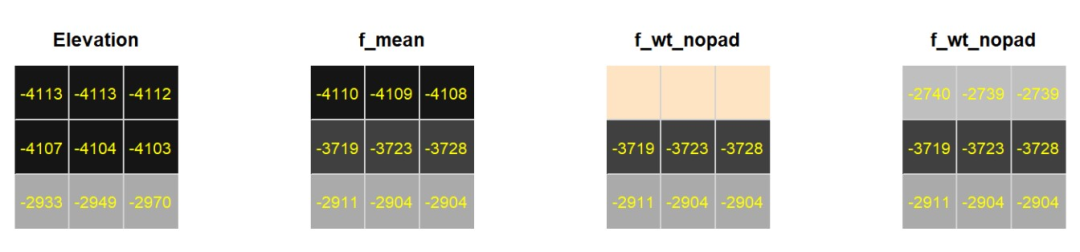
最左侧的图像展示的是原始栅格。第二个图像是使用mean()函数并设置pad = TRUE得到的。第三个图像是使用加权的核窗口并设置pad = FALSE得到的(注意:空值栅格被高亮显示)。最后一个图像是使用同样的加权核窗口并设置pad = TRUE得到的,而它所得到的结果也不是想要的。例如,它最上面一行中间像元的值是通过1/9(-4113 -4113 -4112 -4107 -4104 -4103)计算得到的——明明只有6个像元参与计算,它们的权重却被定义为1/9,从而导致了不平衡权重效应。注意,当使用mean()函数不会出现这种情况。
你可能会注意到最左侧中、下两个像元也处于边缘位置,但计算结果并没有出现边界效应,这是因为若栅格数据覆盖的是全球范围的话,focal()函数会把栅格对象最左侧像元的边界(西经180度)和最右侧像元的边界(东经180度)视为同一条边界。
邻接矩阵(或者称作“核”)是可以自定义的。比如,我们只想除计算中心像元以外的8个像元的平均值时,矩阵可以进行如下定义:
讯享网m <- matrix(c(1,1,1,1,0,1,1,1,1)/8, nrow = 3) f3 <- focal(elevation, w = m, fun = sum)
- 译者注:原为此处输出结果为
f2。
更复杂的核也可以被定义。比如Sobel筛选器(在图像处理时用来探测边缘)可以进行如下定义:
Sobel <- matrix(c(-1,0,1,-2,0,2,-1,0,1)/4, nrow = 3) f3 <- focal(elevation, w = Sobel, fun = sum) tm_shape(f3) + tm_raster(palette = "Greys") + tm_legend(legend.show = FALSE)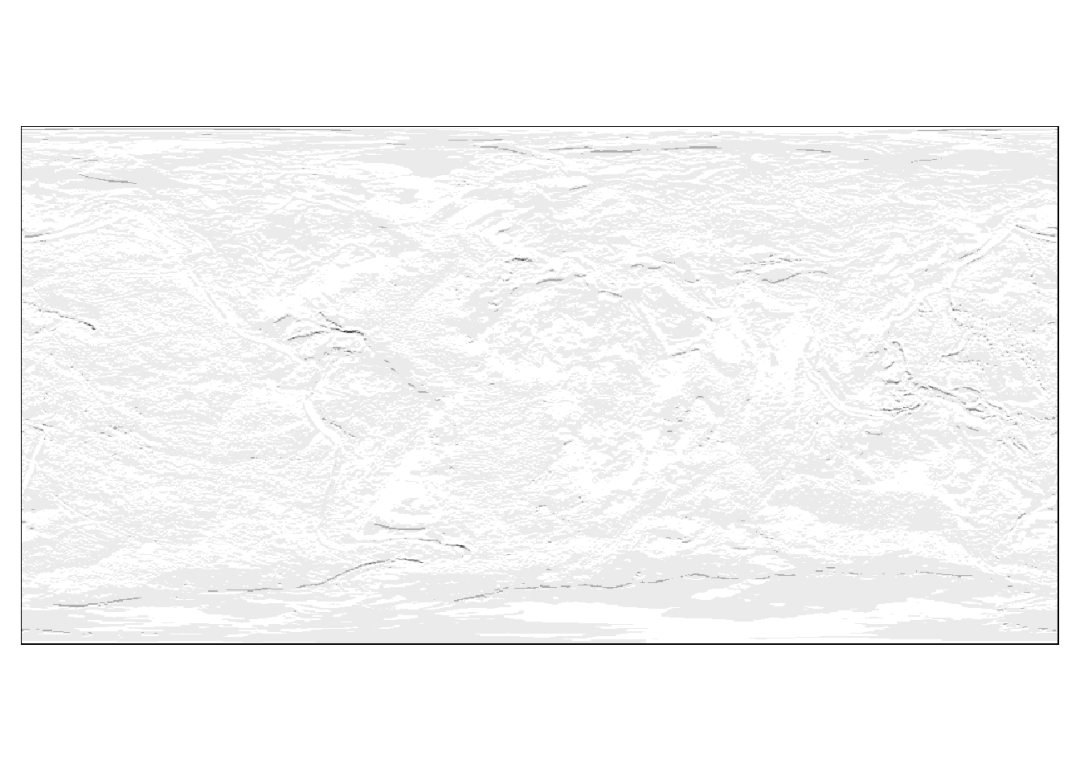
4 Zonal operations and functions
该类操作符常见的用途是像元聚合。
讯享网z1 <- aggregate(elevation, fact = 2, fun = mean, expand = TRUE) tm_shape(z1) + tm_raster(palette = "-RdBu", n = 6) + tm_legend(outside = TRUE, text.size = .8)
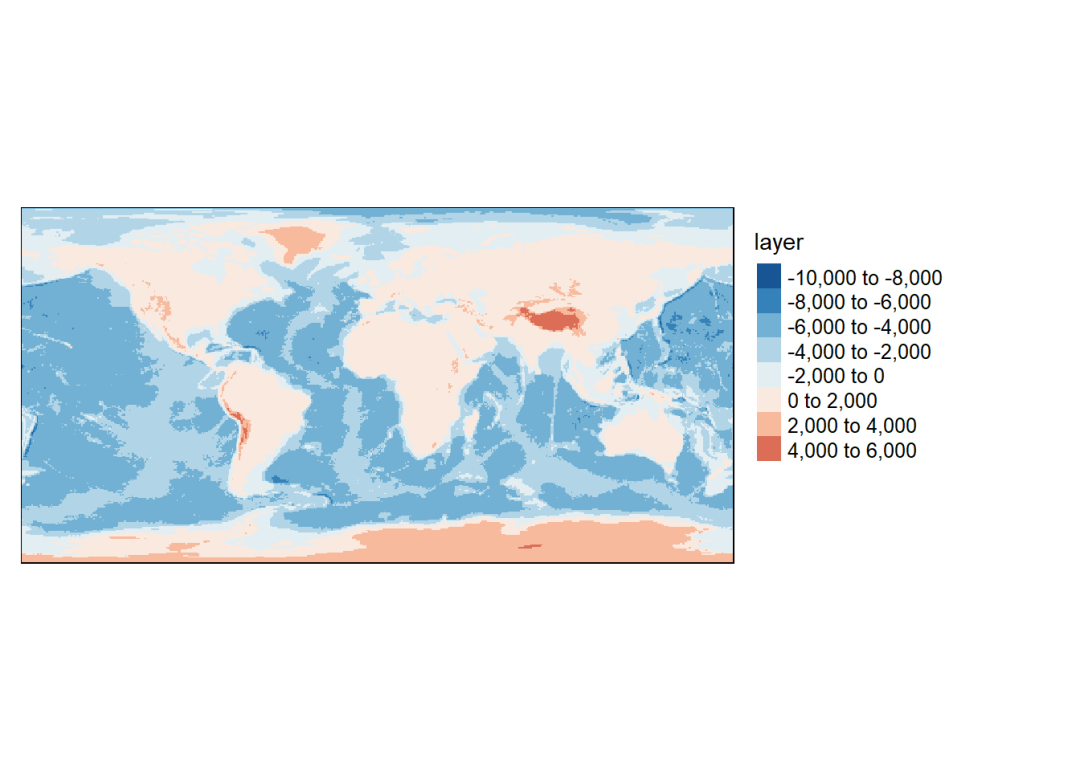
这个图像和原始图像可能看起来没有太大差别,但是它们对应栅格的尺寸属性存在明显差别:
res(elevation) [1] 0. 0. res(z1) [1] 0. 0.z1的维度是elevation的一半。你也可以使用disaggregate()函数来进行逆操作,这样每个像元将被分裂成指定数目的子像元,每个子像元都继承父像元的值。
分区操作(zonal operations)也可以在两个图层中进行,即根据一个图层的分区对另外一个图层的值进行聚合。在下列例子中,elevation中的值将会根据面状矢量数据cont的分区进行聚合。
下面代码计算的是cont中每个部分的平均高程:
讯享网cont.elev.sp <- extract(elevation, cont, fun = mean, sp = TRUE)
参数sp = TRUE表示输出对象的数据结构为SpatialPolygonsDataFrame,而非表格(矩阵)。输出对象继承了输入对象cont的原始属性并新增了一列layer用来表示计算出的平均高程值。
为了更方便,我们可以将SpatialPolygonsDataFrame对象转换成sf格式的对象。
library(sf) cont.elev <- st_as_sf(cont.elev.sp)sf对象的平均高程值可以通过以下代码提取:
讯享网st_drop_geometry(cont.elev) CONTINENT layer 1 Africa 630.6706 2 Antarctica 2342.8605 3 Australia 276.5497 4 Europe 262.7817 5 North America 826.0598 6 South America 595.4753 7 Asia 790.6417
如果你想使用原始的SpatialPolygonsDataFrame对象来操作,可以使用语句cont.elev.sp@data来提取数据框。
现在,我们可以绘制各大洲的平均高程图了。
tm_shape(cont.elev) + tm_polygons(col = "layer") + tm_legend(outside = TRUE, text.size = .8)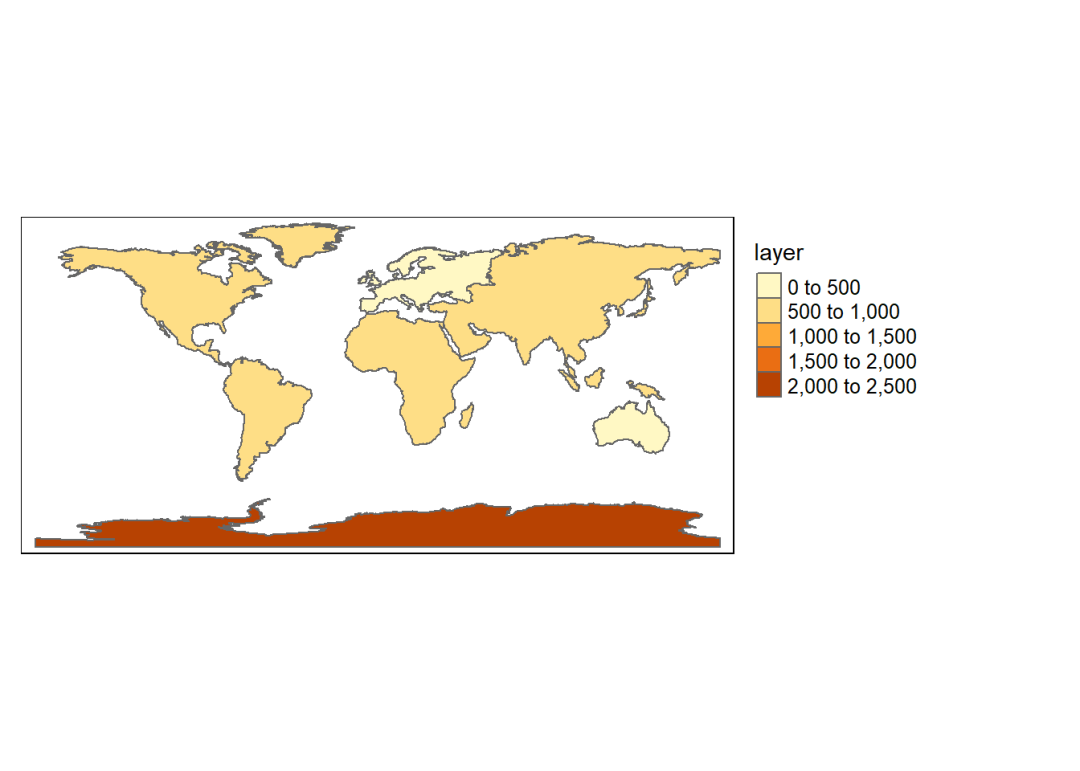
其他一些常用的函数也可以应用于extract()。例如,提取各大洲高程的最大值:
讯享网cont.elev.sp <- extract(elevation, cont, fun = max, sp = TRUE)
还有,我们还可以提取各大洲所在的像元个数:
cont.elev.sp <- extract(elevation, cont, fun=function(x,...){length(x)}, sp = TRUE)extract()函数也可以应用于点状和线状矢量对象。但是,如果你所使用的分区图层是栅格对象而非矢量对象时,请使用zonal()函数。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/82680.html