
L1:界面
L2:文生图
提示词思路

权重


- 采样步数20步以后提升效果不大
- 采样算法 带加号的是改进过的算法,更稳定
- 提示词帮写网站
- 提示词和作品分享网站 另一个替代的
- 分辨率起始为512,设置太高会出现多人问题,解决办法是使用high-resolution fix(hires fix)来提高分辨率,内容就会更加精细
L3:图生图
- Denoising strength 重绘幅度参数:与原图差别多大
- 随机种子:筛子-1即随机生成;循环按钮将返回上一张图的种子,按照上一张图的样子再次生成。
L4:大模型
- 下载大模型的网站:
- https://huggingface.co/
- https://civitai.com/
- 一些后缀的分类:
- checkpoint 大模型
- Lora:从模型网站上下载到的很多模型属于lora,要把他们放在model/Lora文件夹下,相当于一个附加修改器,需要以其他模型为基础
- 大模型分类
- trained:一手,原创的
- merge:模型混合的,名字里一般都有mix
模型风格:

up推荐的:

L5:提高产图质量
高清修复
一种说法:hires.fix中的算法R-ESRGAN 4x+对真实图来说更有细节(但其实还是需要多尝试
SD放大
安装extension的方法
在img2img中的script找到对应脚本,注意需要设置重叠像素(tile)的宽高

附加功能放大
其实就是一个重绘幅度为0的放大,只会精细描线,并不会增加细节
L6:修改器
embedding词嵌入
- 原理:相当于给一个指示,按照某个人物特点来进行生成,c站的模型筛选中可以找到
- 使用方法:下载后放入embedding文件夹,在提示词中填入模型详情中的Trigger Words即可。注意看作者说的应该填入哪种提示词
- 应用:
- 画某个角色的同人二创(其实更多用lora
- 经典应用:转身图(具体使用的时候应参考wiki

- 画手。记录了一些手的错误案例,下次ai绘图会避开这些错误案例。

图生文
BLIP
a man with no shirt and no shirt on is standing in front of a wall with his shirt off, Benjamin Marra(一个美漫艺术家), cel shading(一种三渲二的方法), a comic book panel(一个漫画面板), cobra(未找到来源)
DeepBooru(速度更快)
1boy, abs, bara(一种同性艺术风格), beach, dark-skinned male, goggles(护目镜), male focus, male swimwear, muscular, muscular male, navel(肚脐), nipples(r头), pectorals(胸脯), shorts, solo, sunglasses, toned(强壮), topless male
LORA
超网络hypernetwork
一般用于改变画风(有时可被lora取代
使用方法:
下载后放在\models\hypernetworks
在超网络标签中,刷新,选中即可
L7:局部重绘inpaint
参数解释:
- 蒙版:就是涂黑的那一部分
- 蒙版模糊度:类似ps的羽化
- mask mode:正选反选
- masked content:
Fill: 基于模糊选区
Original: 基于原图(大多数情况会选这个
Latent Noise: 随机图像,如果想要随机生成这个选区就勾选这个选项
Latent Nothing: 基于纯色块选区,色块是选区附近像素的平均色
- Inpaint area
全图/Whole picture:绘制全图再拼接回去你提供的图
仅蒙版/Only masked:只重绘选区内容,容易出错 - inpaint和inpaint sketch似乎没有区别…

L8:扩展
介绍和安装了一些好用的扩展
- 中文
- tag提示
- 中文tag
- image browser
- Tagger:一种更好用的图生文
- adetailer:修复人脸/手
- infinite zoom:生成无线循环的视频
L9:Lora

L10:controlNet
- 可以用于控制人物姿势
- 需要将controlNet的扩展装在扩展文件夹下面
- 模型放在controlNet下的models中
参数:
- 控制权重/Control Weight:决定这个控制效应在图片中呈现出来的程度
- 启动控制的步数/Starting Control Step和结束控制的步数/Ending Control Step:controlnet什么时候生效,0-1代表全程生效
- 完美匹配像素/Pixel Perfect:无脑勾选
- 爆炸按钮:只生成动作的 骨骼图
常用的controlnet的一些细节:
- pose:预处理中的openpose_full可以精确定位包括表情、手指、躯干所有内容,其他都是部分内容
- Depth:用于画场景、透视。生成一个空间深度图。【有时候openpose无法生成的动作,可可以试试depth】
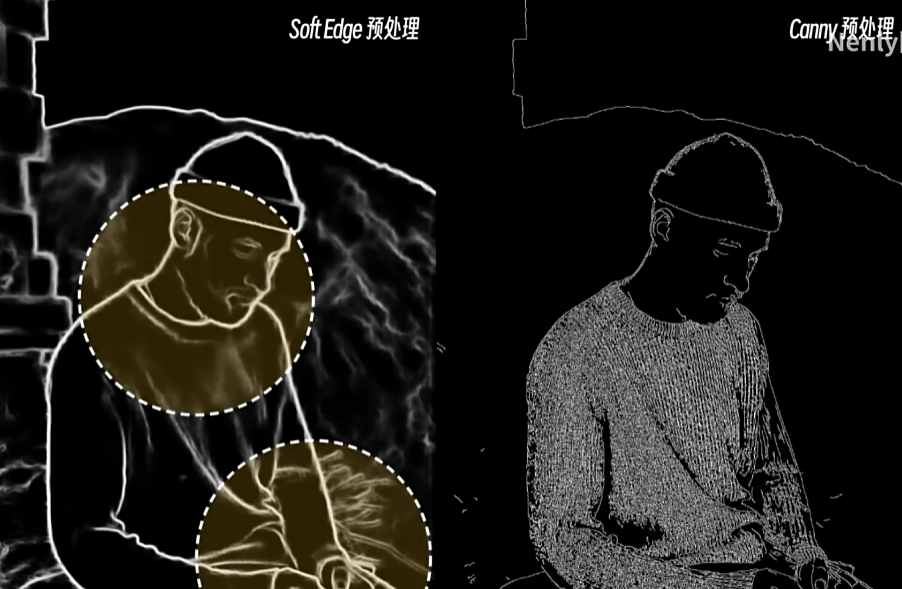
- canny:边缘检测,注重对细节的重现。
- 据说可以用于
线稿上色 - 效果:(很想试试2333 - 要求精准重现某种事物(比如文字、汽车等等- sofe eage:同样边缘检测,但是只保留大概轮廓,canny更注重细节。
- 据说可以用于


 - 要求精准重现某种事物(比如文字、汽车等等- sofe eage:同样边缘检测,但是只保留大概轮廓,canny更注重细节。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/81920.html