
导读:
主流的多因子选股模型通常采用量价数据(开高低收、成交量)、财务数据(流通市值、市盈率、市净率等)、舆情数据(事件)来挖掘市场中存在的超额收益。本文主要以资金数据为落脚点,试图挖掘有效的资金因子(月频),并构建资金因子选股策略,获取市场超额收益。
1.合成因子-机构收割散户:
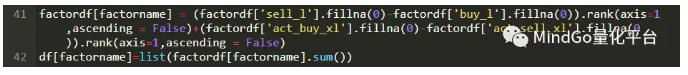
分析完单因子后,我们进入合成因子环节,首先让我们想一些A股投资逻辑,比如通常1个月内超大单流入代表主力机构看涨,流出则看跌,而小单流入则代表散户看涨,流出为看跌,在A股市场上,散户往往是被机构收割的,由此我们合成一个因子,取名:机构收割散户
因子值计算公式:Rank(超大单买入金额-超大单卖出金额)+Rank(小单买入金额-小单卖出金额)=超大单净额的Rank值+小单净额的Rank值
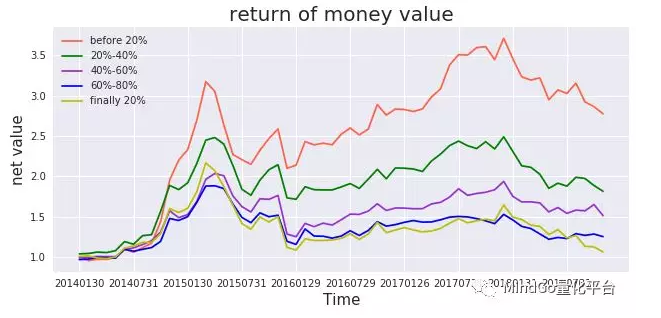
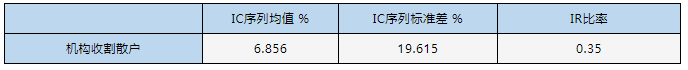
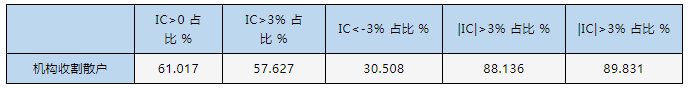
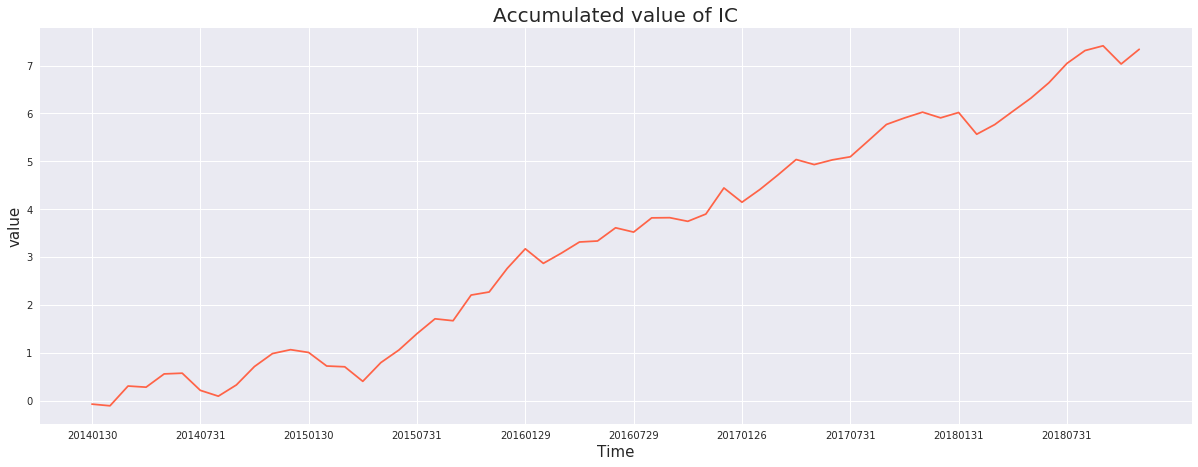
运用单因子检测框架对合成因子进行测试,对机构收割散户因子评价:
从收益走势图分析:5组组别收益差异较为明显,在选股上,应该保持与第一组一致,即挑选上个月机构净买入而散户净卖出的股票。
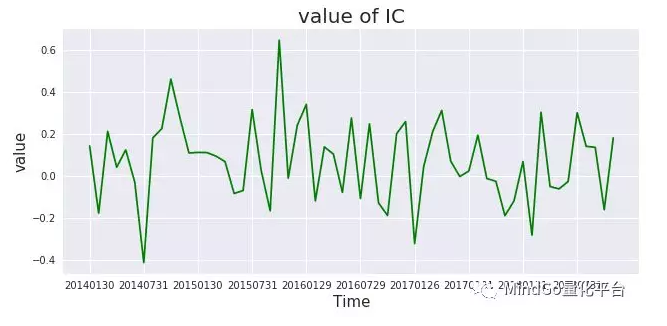
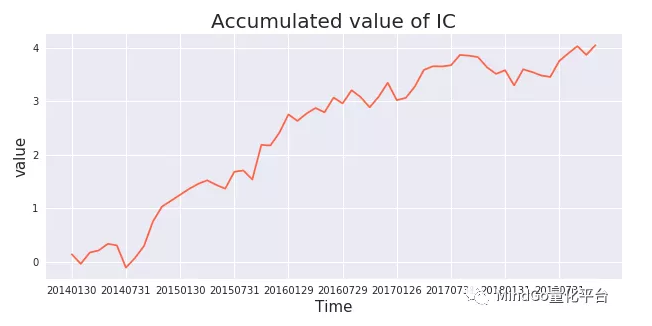
从IC、IR分析:机构收割散户因子具有预测能力,但是IR仅为0.35,因子预测稳定性较差,可能与A股熊市中,机构散户通杀的特性有关,但IC累计明显走出单向上涨,说明下个月的股票涨跌是机构主导而非散户主导。
数据图表结果如下:
2.合成因子-资金反转:
分析“机构收割散户”因子后,再让我们想想资金流向情况,第一种是上个月资金大量流入,下个月继续大量流入,第二种是上个月资金大量流入,下个月反转出现流出,当然还可能存在一些意外情况,比如上个月大量流入后,下个月资金静止,不流入也不流出,暂时我们不把意外考虑在内,由此我们构建一个资金反转因子。
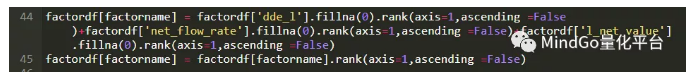
因子值计算公式:DDE净额Rank+大单净量Rank+资金流入率Rank
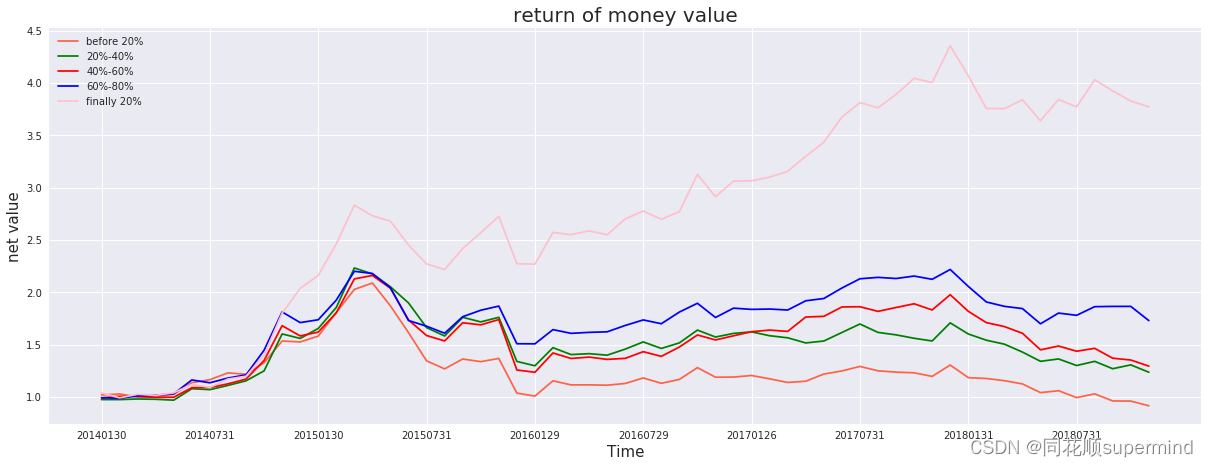
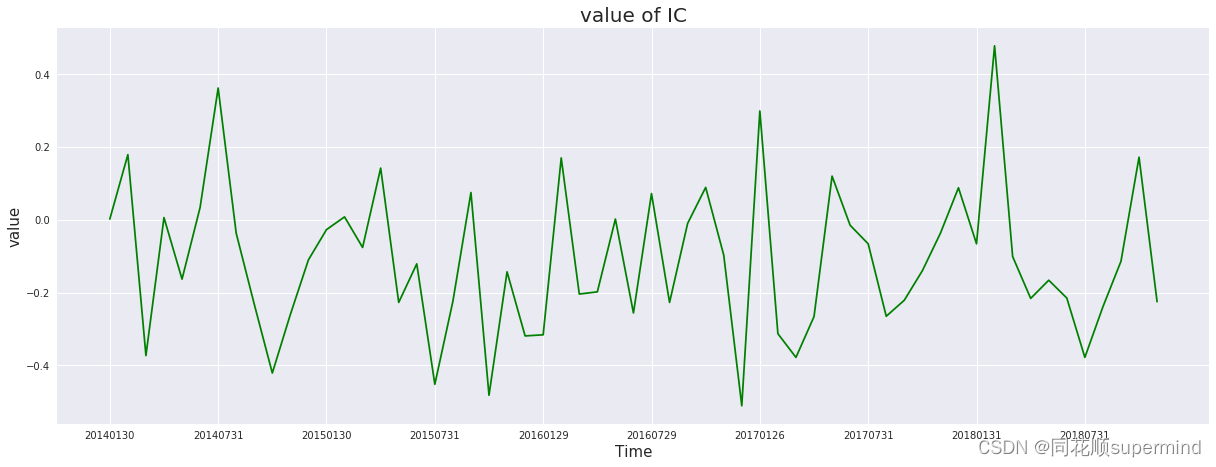
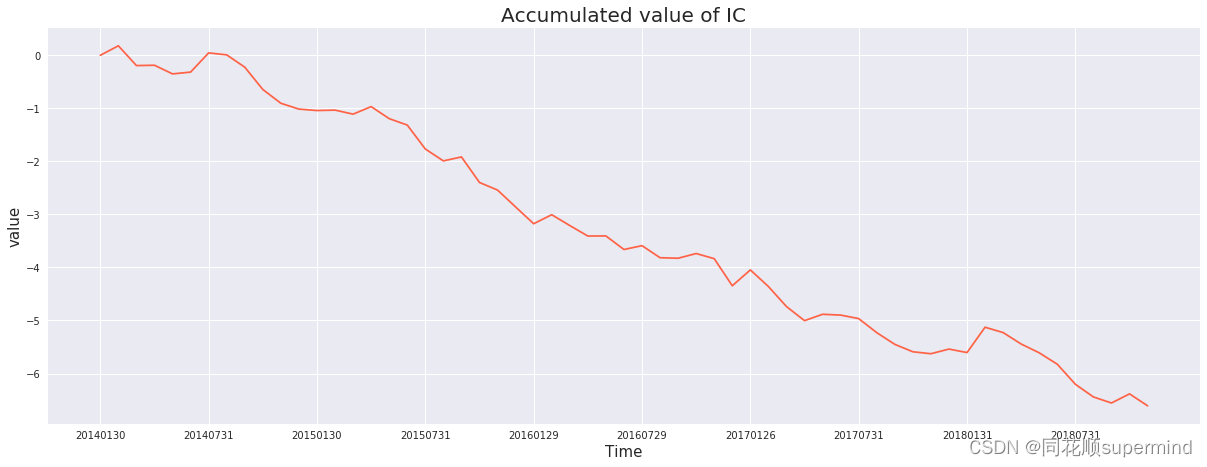
运用单因子检测框架对合成因子进行测试,对资金反转因子评价:
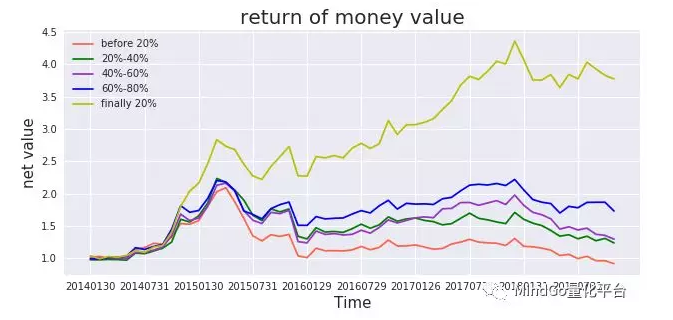
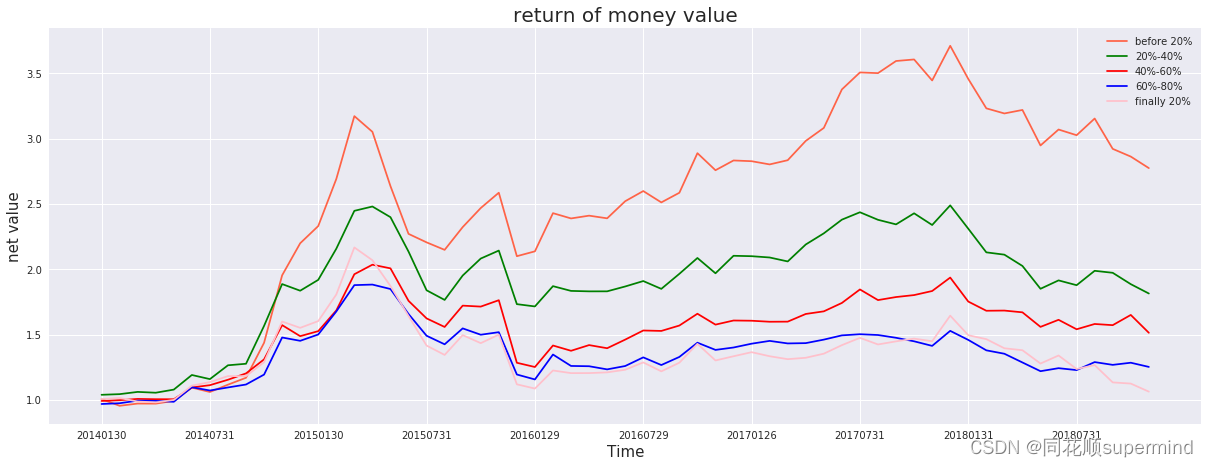
从收益走势图分析:5组组别收益差异较为明显,在选股上,应该保持与第五组一致,即挑选上个月DDE净额、大单净量、资金流入率三者都较差的股票,等待下个月资金流入。
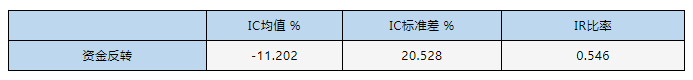
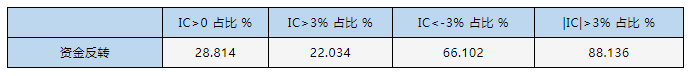
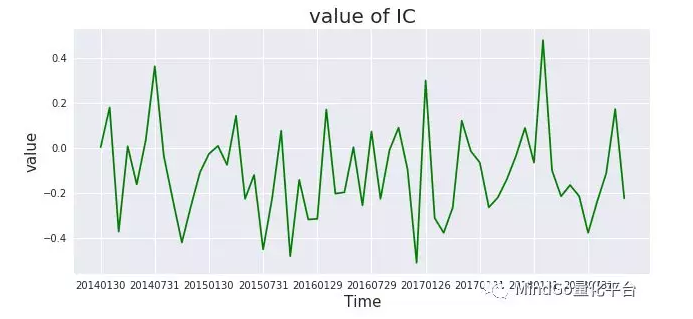
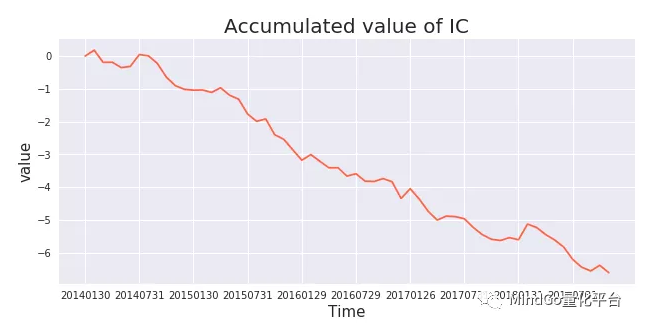
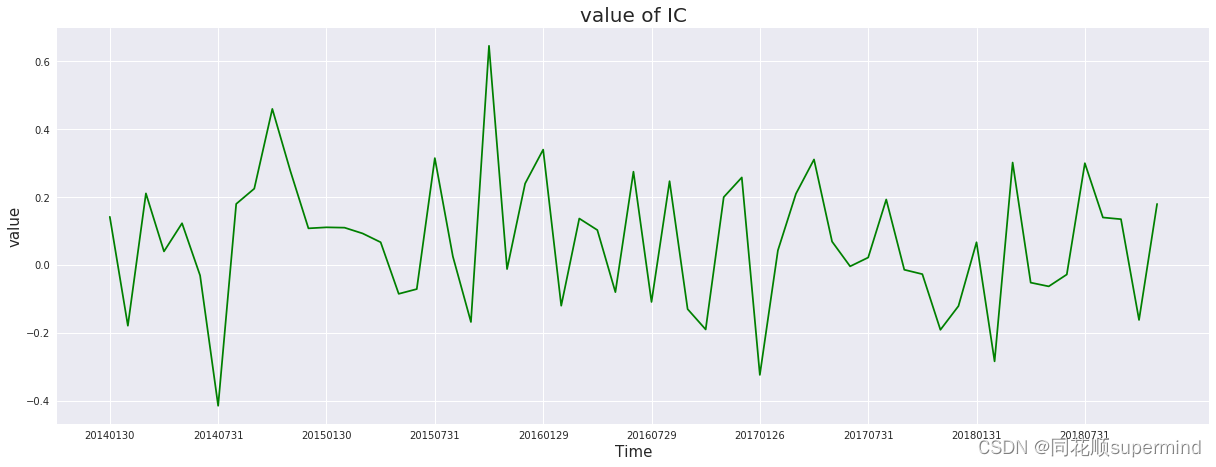
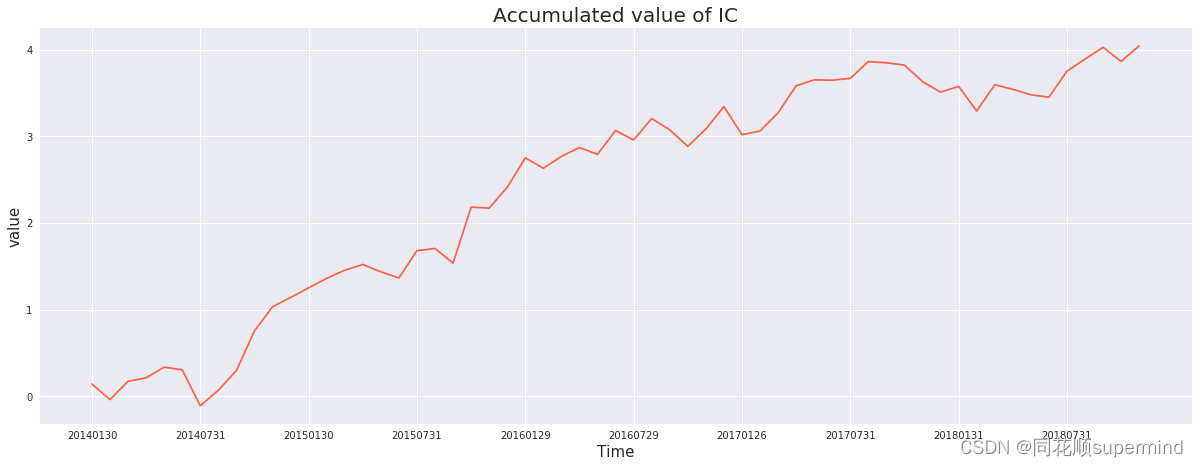
从IC、IR分析:资金反转因子具有较强的预测能力,但是IR仅为0.546,因子预测稳定性还是不容乐观(IR提升上尝试较多次数,发现可能单纯用资金数据很难提),但IC累计明显走出单向下跌,说明资金具有反向流动特性,即上个月资金流入的股票,下个月会受到资金抛弃,而上个月流出的股票,下个月往往会受到资金青睐。该因子是反向指标。
数据图表结果如下:
3.因子策略回测:
我们将“资金反转”因子编写成量化策略,基于同花顺MindGo量化平台进行回测,因子分析时,我们不考虑手续费,涨跌停、停复牌等情况,因此在编写成策略后,其回测结果会更加严谨,但不影响月频因子的内在有效性。
反转因子策略回测结果展示:(资金反转因子是反向指标,指标值越大代表下期收益率越低)
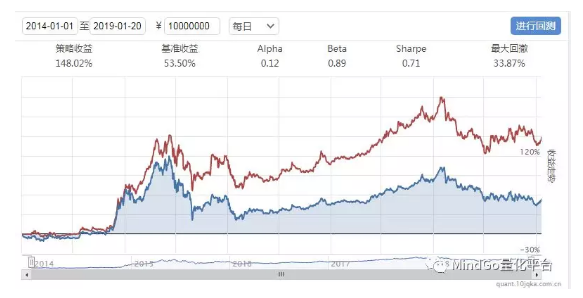
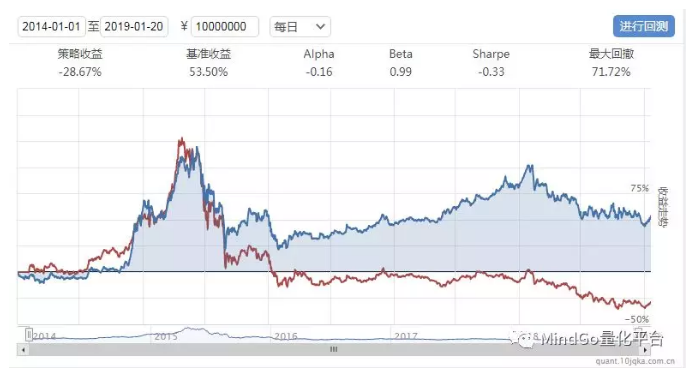
资金反转因子正向选股策略(月频)-上证50指数
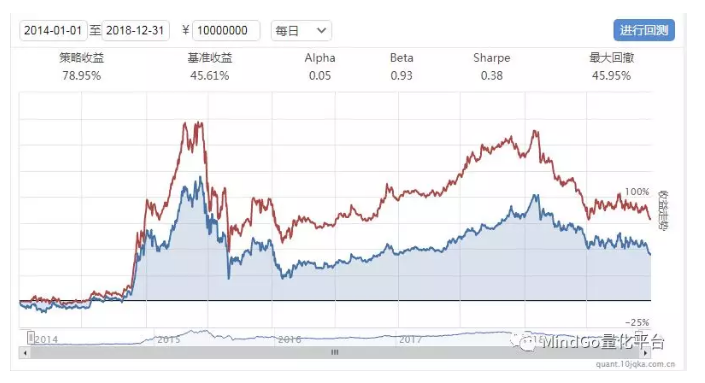
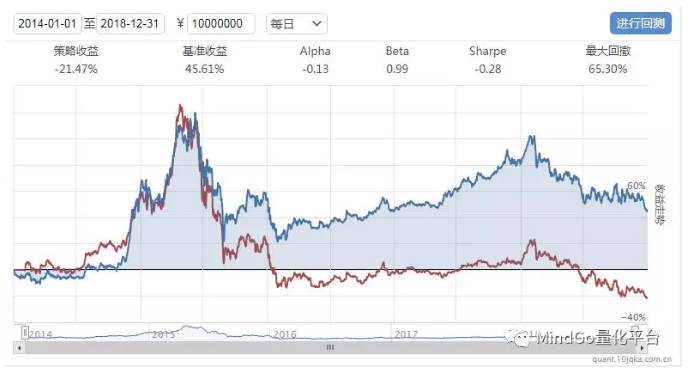
机构收割散户因子反向选股策略(月频)-上证50指数
结束语
::资金数据的单因子分析中,投资者简单把某个资金指标当做选股指标,并预测收益是较难实现,运用金融投资逻辑,结合A股市场的特性来合成因子,并预测收益在某种程度上是可行的,本文“资金反转因子”和“机构收割散户因子”都较好的说明了这一点。其次资金数据相对于财务数据而言,数据内噪音较多,使得因子的IC标准差较大,预测能力的稳定性普遍较低。有兴趣的小伙伴,可以尝试通过行业数据、财务数据与资金数据进行合成因子,试图挖掘具有较强预测收益能力,且预测能力稳定的因子。
参考文献:
-华泰单因子测试之资金流向因子-林晓明
-Israel R,Maloney T.Understanding Style Premia[J].Journal of Investing,2014(4)
资金因子组合挖掘框架
作者:陈诚
1.研究时间
从2014年1月1日至2019年1月15日,按一个月作为单位研究窗口
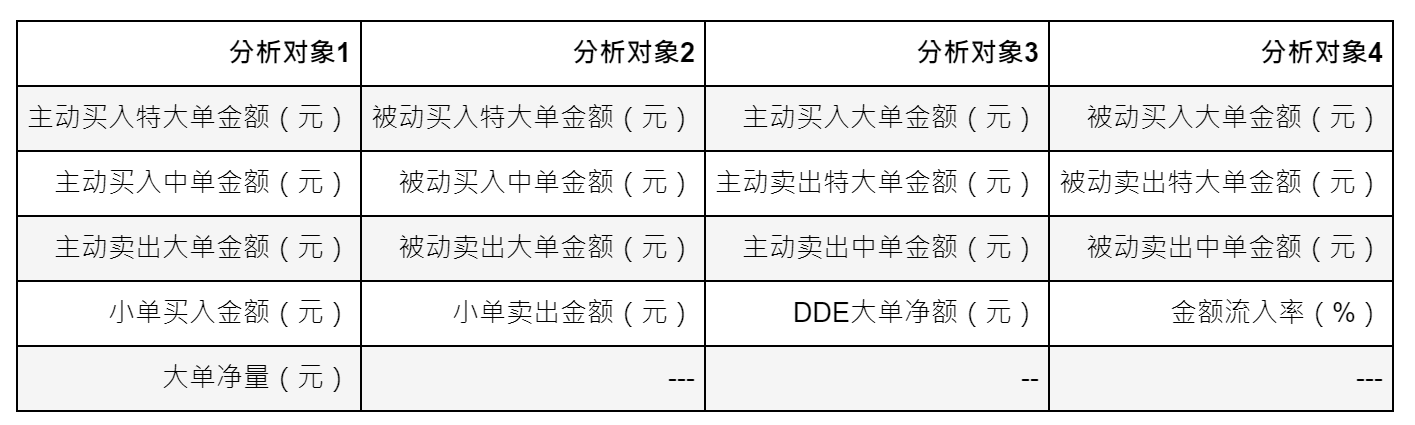
2.分析对象为
我们选取了17个因子作为研究对象,展示如下:
3.单因子研究示例
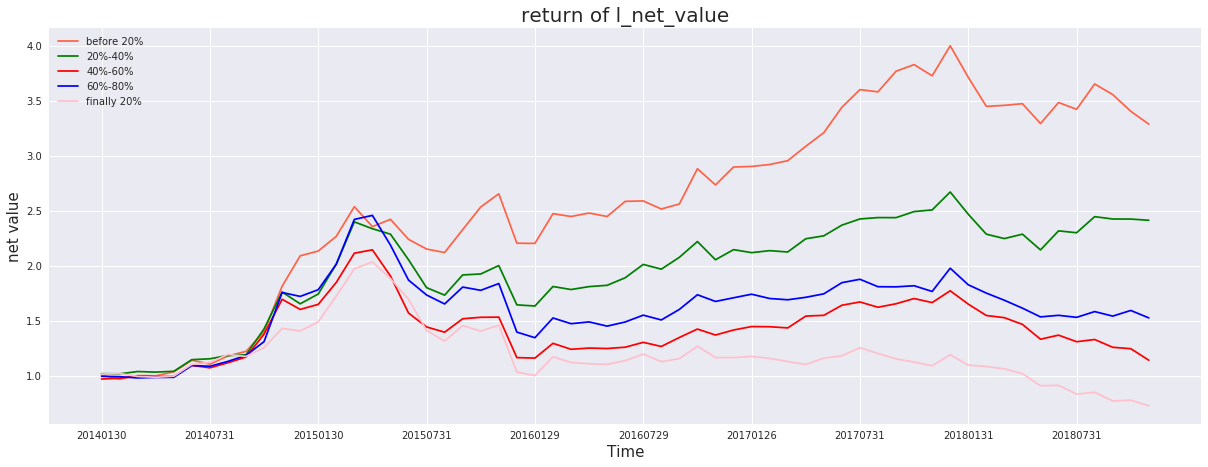
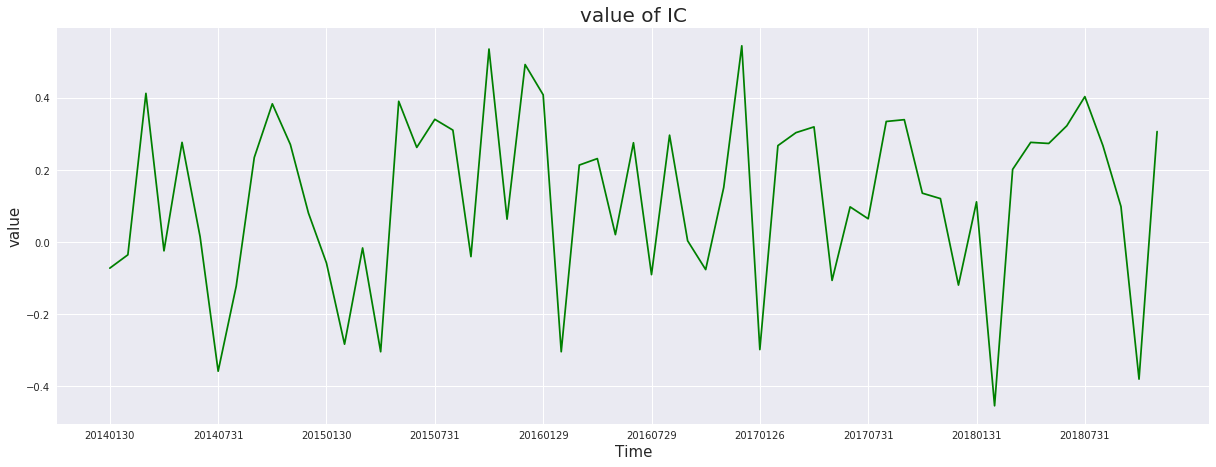
In [32]:
''' 资金因子组合挖掘框架 1.基本信息设置 ''' startdate = "" enddate = "" indexcode = "000016.SH" ''' 2.日历与月历列表获取 ''' tradelist = list(get_trade_days(startdate, enddate, count=None).strftime('%Y%m%d')) #获取月度交易日列表(每月末) mtradelist = [] for s in range(0,len(tradelist)): if s == len(tradelist)-1: break if (tradelist[s+1][4:6]>tradelist[s][4:6]) or (tradelist[s+1][4:6]=='01' and tradelist[s][4:6]=='12'): mtradelist.append(tradelist[s]) ''' 3.因子收益 ''' #准备 columns = ['before 20%','20%-40%','40%-60%','60%-80%','finally 20%'] refdf = pd.DataFrame(columns = columns) icdf = pd.DataFrame(columns = ['IC']) import pandas as pd import numpy as np for t in [s for s in range(0,len(mtradelist)-1)]: daytime = mtradelist[t] nextdaytime = mtradelist[t+1] #获取当日沪深300指数成份股 stocklist = get_index_stocks(indexcode, daytime) #剔除ST和停牌股票 is_st = get_price(stocklist, None, daytime, '1d', ['is_st', 'is_paused'], True, None, 1, is_panel=1)['is_st'].T stock1 = list(is_st[is_st[list(is_st.columns)[0]]==0].index) is_paused = get_price(stocklist, None, daytime, '1d', ['is_st', 'is_paused'], True, None, 1, is_panel=1)['is_paused'].T stock2 = list(is_paused[is_paused[list(is_paused.columns)[0]]==0].index) stock = list(set(stock1)&set(stock2)) #获取所有样本股下月涨跌幅 df = get_price(stock, daytime, nextdaytime, '1d', ['quote_rate'],is_panel=1)['quote_rate'] #计算月涨跌幅 quote_rate = df.iloc[1:].sum()/100 #整理成DataFrame格式 df = pd.DataFrame(list(quote_rate),columns=['quote_rate'],index=quote_rate.index) #添加当月股票因子值 factorname = 'money value' factordf = get_money_flow_step(stock, None, daytime, '1d', ['buy_l','sell_l','act_buy_xl','act_sell_xl','dde_l','net_flow_rate','l_net_value'], 20, is_panel=1) factordf[factorname] = (factordf['sell_l'].fillna(0)-factordf['buy_l'].fillna(0)).rank(axis=1,ascending = False)+(factordf['act_buy_xl'].fillna(0)-factordf['act_sell_xl'].fillna(0)).rank(axis=1,ascending = False) df[factorname]=list(factordf[factorname].sum()) #当期因子RANK值从小到大排序 df = df.sort_values(by = factorname,ascending = True) #设置五组,前20%为一组,后20%为一组,中间三组,并计算每组在下月平均收益率 refstock1 = round(np.mean(list(df.iloc[:int(len(stock)*0.2)]['quote_rate'])),4) refstock2 = round(np.mean(list(df.iloc[int(len(stock)*0.2):int(len(stock)*0.4)]['quote_rate'])),4) refstock3 = round(np.mean(list(df.iloc[int(len(stock)*0.4):int(len(stock)*0.6)]['quote_rate'])),4) refstock4 = round(np.mean(list(df.iloc[int(len(stock)*0.6):int(len(stock)*0.8)]['quote_rate'])),4) refstock5 = round(np.mean(list(df.iloc[int(len(stock)*0.8):]['quote_rate'])),4) # #计算IC值 IC = round(np.corrcoef(df[factorname].rank(axis=0,ascending = True),df['quote_rate'].rank(axis=0,ascending = False))[0,1],3) #录入 refdf.loc[daytime] = [refstock1,refstock2,refstock3,refstock4,refstock5] icdf.loc[daytime] = [IC] #净值计算 refdf = refdf+1 from operator import mul from functools import reduce #添加日期 refdf['day'] = refdf.index #累积收益计算 refsumdf = pd.DataFrame() refsumdf['前20%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['before 20%'])[:list(refdf['day']).index(x)+1])) refsumdf['20%-40%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['20%-40%'])[:list(refdf['day']).index(x)+1])) refsumdf['40%-60%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['40%-60%'])[:list(refdf['day']).index(x)+1])) refsumdf['60%-80%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['60%-80%'])[:list(refdf['day']).index(x)+1])) refsumdf['后20%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['finally 20%'])[:list(refdf['day']).index(x)+1])) #可视化 import matplotlib.pyplot as plt plt.style.use('seaborn') import pandas as pd import numpy as np columns = list(refsumdf.columns) fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 color = ['tomato','green','r','b','pink'] for c in range(0,len(columns)): x1_list=list(refsumdf[columns[c]]) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, color[c]) axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('net value',fontsize=15) axes.set_title('return of {}'.format(factorname),fontsize=20) columns = ['before 20%','20%-40%','40%-60%','60%-80%','finally 20%'] axes.legend(columns) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) #累积IC计算 icdf['day'] = icdf.index icdf['IC累计'] = icdf['day'].apply(lambda x:np.sum(list(icdf['IC'])[:list(icdf['day']).index(x)+1])) del icdf['day'] #可视化 import matplotlib.pyplot as plt import pandas as pd import numpy as np fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 x1_list=list(icdf['IC']) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, 'green') axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('value',fontsize=15) axes.set_title('value of IC',fontsize=20) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 x1_list=list(icdf['IC累计']) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, 'tomato') axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('value',fontsize=15) axes.set_title('Accumulated value of IC',fontsize=20) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) #IC监控项 columns = ['IC序列均值 %','IC序列标准差 %','IR比率','IC>0 占比 %','IC>3% 占比 %','IC<-3% 占比 %','|IC|>3% 占比 %'] #创建DataFrame LDdf = pd.DataFrame(columns = columns) #IC序列均值 icmean = icdf.mean().IC*100 #IC序列标准差 icstd = np.std(list(icdf['IC']), ddof=1)*100 #IR比率 IR = abs(icmean/icstd) #IC>0 占比 icz = len(list(icdf[icdf['IC']>0].index))/len(list(icdf.index))*100 #IC>0.03 占比 icze = len(list(icdf[icdf['IC']>0.03].index))/len(list(icdf.index))*100 #IC<-0.03 占比 iczr = len(list(icdf[icdf['IC']<-0.03].index))/len(list(icdf.index))*100 #|IC|>0.03 占比 icz2 = len(list(icdf[abs(icdf['IC'])>0.03].index))/len(list(icdf.index))*100 #录入 LDdf.loc['值']=[round(icmean,3),round(icstd,3),round(IR,3),round(icz,3),round(icze,3),round(iczr,3),round(icz2,3)] LDdf讯享网
Out[32]:
| IC序列均值 % | IC序列标准差 % | IR比率 | IC>0 占比 % | IC>3% 占比 % | IC<-3% 占比 % | |IC|>3% 占比 % | |
|---|---|---|---|---|---|---|---|
| 值 | 6.856 | 19.615 | 0.35 | 61.017 | 57.627 | 30.508 | 88.136 |
In [31]:
讯享网''' 资金因子组合挖掘框架 1.基本信息设置 ''' startdate = "" enddate = "" indexcode = "000016.SH" ''' 2.日历与月历列表获取 ''' tradelist = list(get_trade_days(startdate, enddate, count=None).strftime('%Y%m%d')) #获取月度交易日列表(每月末) mtradelist = [] for s in range(0,len(tradelist)): if s == len(tradelist)-1: break if (tradelist[s+1][4:6]>tradelist[s][4:6]) or (tradelist[s+1][4:6]=='01' and tradelist[s][4:6]=='12'): mtradelist.append(tradelist[s]) ''' 3.因子收益 ''' #准备 columns = ['before 20%','20%-40%','40%-60%','60%-80%','finally 20%'] refdf = pd.DataFrame(columns = columns) icdf = pd.DataFrame(columns = ['IC']) import pandas as pd import numpy as np for t in [s for s in range(0,len(mtradelist)-1)]: daytime = mtradelist[t] nextdaytime = mtradelist[t+1] #获取当日沪深300指数成份股 stocklist = get_index_stocks(indexcode, daytime) #剔除ST和停牌股票 is_st = get_price(stocklist, None, daytime, '1d', ['is_st', 'is_paused'], True, None, 1, is_panel=1)['is_st'].T stock1 = list(is_st[is_st[list(is_st.columns)[0]]==0].index) is_paused = get_price(stocklist, None, daytime, '1d', ['is_st', 'is_paused'], True, None, 1, is_panel=1)['is_paused'].T stock2 = list(is_paused[is_paused[list(is_paused.columns)[0]]==0].index) stock = list(set(stock1)&set(stock2)) #获取所有样本股下月涨跌幅 df = get_price(stock, daytime, nextdaytime, '1d', ['quote_rate'],is_panel=1)['quote_rate'] #计算月涨跌幅 quote_rate = df.iloc[1:].sum()/100 #整理成DataFrame格式 df = pd.DataFrame(list(quote_rate),columns=['quote_rate'],index=quote_rate.index) #添加当月股票因子值 factorname = 'money value' factordf = get_money_flow_step(stock, None, daytime, '1d', ['buy_l','sell_l','act_buy_xl','act_sell_xl','dde_l','net_flow_rate','l_net_value'], 20, is_panel=1) factordf[factorname] = factordf['dde_l'].fillna(0).rank(axis=1,ascending =False)+factordf['net_flow_rate'].fillna(0).rank(axis=1,ascending =False)+factordf['l_net_value'].fillna(0).rank(axis=1,ascending =False) factordf[factorname] = factordf[factorname].rank(axis=1,ascending =False) df[factorname]=list(factordf[factorname].sum()) #当期因子值rank df = df.sort_values(by = factorname,ascending = True) #设置五组,前20%为一组,后20%为一组,中间三组,并计算每组在下月平均收益率 refstock1 = round(np.mean(list(df.iloc[:int(len(stock)*0.2)]['quote_rate'])),4) refstock2 = round(np.mean(list(df.iloc[int(len(stock)*0.2):int(len(stock)*0.4)]['quote_rate'])),4) refstock3 = round(np.mean(list(df.iloc[int(len(stock)*0.4):int(len(stock)*0.6)]['quote_rate'])),4) refstock4 = round(np.mean(list(df.iloc[int(len(stock)*0.6):int(len(stock)*0.8)]['quote_rate'])),4) refstock5 = round(np.mean(list(df.iloc[int(len(stock)*0.8):]['quote_rate'])),4) # #计算IC值 IC = round(np.corrcoef(df[factorname].rank(axis=0,ascending =True),df['quote_rate'].rank(axis=0,ascending =False))[0,1],3) #录入 refdf.loc[daytime] = [refstock1,refstock2,refstock3,refstock4,refstock5] icdf.loc[daytime] = [IC] #净值计算 refdf = refdf+1 from operator import mul from functools import reduce #添加日期 refdf['day'] = refdf.index #累积收益计算 refsumdf = pd.DataFrame() refsumdf['前20%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['before 20%'])[:list(refdf['day']).index(x)+1])) refsumdf['20%-40%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['20%-40%'])[:list(refdf['day']).index(x)+1])) refsumdf['40%-60%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['40%-60%'])[:list(refdf['day']).index(x)+1])) refsumdf['60%-80%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['60%-80%'])[:list(refdf['day']).index(x)+1])) refsumdf['后20%组累积收益'] = refdf['day'].apply(lambda x:reduce(mul,list(refdf['finally 20%'])[:list(refdf['day']).index(x)+1])) #可视化 import matplotlib.pyplot as plt plt.style.use('seaborn') import pandas as pd import numpy as np columns = list(refsumdf.columns) fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 color = ['tomato','green','r','b','pink'] for c in range(0,len(columns)): x1_list=list(refsumdf[columns[c]]) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, color[c]) axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('net value',fontsize=15) axes.set_title('return of {}'.format(factorname),fontsize=20) columns = ['before 20%','20%-40%','40%-60%','60%-80%','finally 20%'] axes.legend(columns) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) #累积IC计算 icdf['day'] = icdf.index icdf['IC累计'] = icdf['day'].apply(lambda x:np.sum(list(icdf['IC'])[:list(icdf['day']).index(x)+1])) del icdf['day'] #可视化 import matplotlib.pyplot as plt import pandas as pd import numpy as np fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 x1_list=list(icdf['IC']) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, 'green') axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('value',fontsize=15) axes.set_title('value of IC',fontsize=20) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) fig = plt.figure() axes = fig.add_axes([0.1, 0.1, 2, 1]) #插入面板 x1_list=list(icdf['IC累计']) y=np.array(x1_list) x=np.array(range(0,len(x1_list))) axes.plot(x, y, 'tomato') axes.set_xlabel('Time',fontsize=15) axes.set_ylabel('value',fontsize=15) axes.set_title('Accumulated value of IC',fontsize=20) #设置X轴 numlist=[] for s in list(range(0,len(mtradelist),6)): numlist.append(mtradelist[s]) axes.set_xticks(list(range(0,len(mtradelist),6))) axes.set_xticklabels(numlist, fontsize=10) #IC监控项 columns = ['IC序列均值 %','IC序列标准差 %','IR比率','IC>0 占比 %','IC>3% 占比 %','IC<-3% 占比 %','|IC|>3% 占比 %'] #创建DataFrame LDdf = pd.DataFrame(columns = columns) #IC序列均值 icmean = icdf.mean().IC*100 #IC序列标准差 icstd = np.std(list(icdf['IC']), ddof=1)*100 #IR比率 IR = abs(icmean/icstd) #IC>0 占比 icz = len(list(icdf[icdf['IC']>0].index))/len(list(icdf.index))*100 #IC>0.03 占比 icze = len(list(icdf[icdf['IC']>0.03].index))/len(list(icdf.index))*100 #IC<-0.03 占比 iczr = len(list(icdf[icdf['IC']<-0.03].index))/len(list(icdf.index))*100 #|IC|>0.03 占比 icz2 = len(list(icdf[abs(icdf['IC'])>0.03].index))/len(list(icdf.index))*100 #录入 LDdf.loc['值']=[round(icmean,3),round(icstd,3),round(IR,3),round(icz,3),round(icze,3),round(iczr,3),round(icz2,3)] LDdf
Out[31]:
| IC序列均值 % | IC序列标准差 % | IR比率 | IC>0 占比 % | IC>3% 占比 % | IC<-3% 占比 % | |IC|>3% 占比 % | |
|---|---|---|---|---|---|---|---|
| 值 | -11.202 | 20.528 | 0.546 | 28.814 | 22.034 | 66.102 | 88.136 |
查看以上策略详细请 到 supermind量化交易官网查看:资金面专题1--资金因子合成 附阐述和源代码
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/80880.html