
本文发布于公众号【数据魔术师】同名文章
一 什么是禁忌搜索算法?
禁忌搜索算法(Tabu Search Algorithm,简称TS)起源于对于人类记忆功能的模仿,是一种亚启发式算法(meta-heuristics)。它从一个初始可行解(initial feasible solution)出发,试探一系列的特定搜索方向(移动),选择让特定的目标函数值提升最多的移动。为了避免陷入局部最优解,禁忌搜索对已经历过的搜索过程信息进行记录,从而指导下一步的搜索方向。
禁忌搜索是人工智能的一种体现,是局部搜索的一种扩展。禁忌搜索是在邻域搜索(local search)的基础上,通过设置禁忌表(tabu list)来禁忌一些曾经执行过的操作,并利用藐视准则来解禁一些优秀的解。
二 禁忌搜索算法基本步骤:
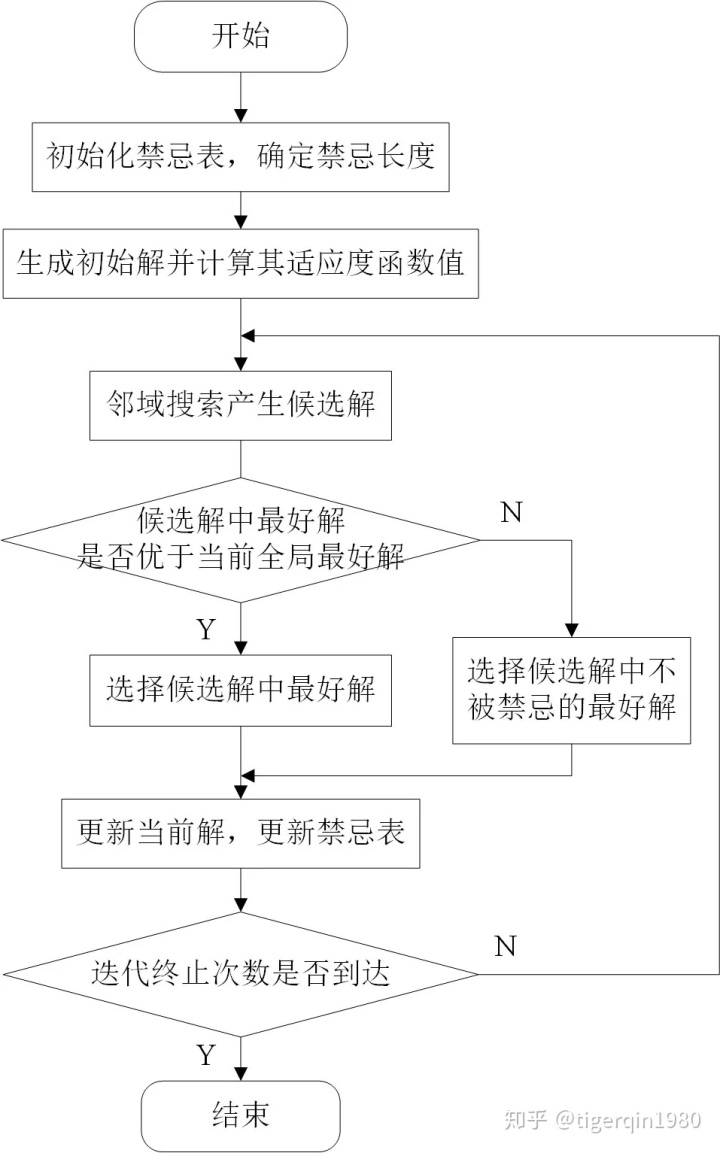
① 初始化
利用贪婪算法等局部搜索算法生成一个初始解,清空禁忌表,设置禁忌长度。
② 邻域搜索产生候选解
根据步骤①产生初始解,通过搜索算子(search operators),如relocation、exchange、2-opt等,产生候选解(candidate solution),并计算各个候选解的适应值(即解对应的目标函数值)。
③ 选择最好的候选解
从步骤②产生的所有候选解中选出适应值最好的候选解,将其与当前最好解(即搜索算法开始到现在找到的最好解)进行比较,如果优于当前最好解,那么就不考虑其是否被禁忌,用这个最好的候选解来更新当前最好解,并且作为下一个迭代的当前解,然后将对应的操作加入禁忌表;如果不优于当前最好解,就从所有候选解中选出不在禁忌状态下的最好解作为新的当前解,然后将对应操作加入禁忌表。
④ 判断终止条件
若满足终止条件,则立即停止并输出当前最好解;否则继续搜索。一般终止条件为是否到达一定的迭代次数或者达到了一个时间限制。
禁忌搜索算法流程图:
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/80663.html