
前言
本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
在工作中的电子文案、ppt,生活中的新闻、广告,都离不开大量的素材,而素材网站随之应运而生
先看下效果图
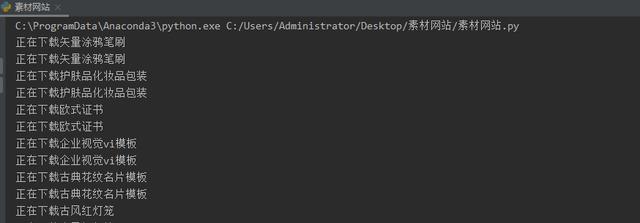
而今天的爬取目标是素材网站
http://www.sccnn.com/讯享网
基本环境配置
- python 3.6
- pycharm
- requests
- parsel
爬虫代码
请求网页
讯享网import requests
import re
url = 'http://www.sccnn.com/shiliangtuku/default({}).html'.format(page)
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/81.0.4044.138 Safari/537.36'
}
response = requests.get(url=url, headers=headers)
response.encoding = response.apparent_encoding
分析网页,解析数据
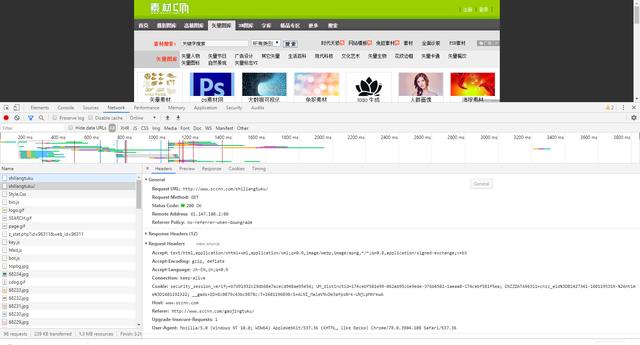
import parsel r = re.findall('<a href="(.*?)" target="_blank">', response.text) for i in urls: page_url = 'http://www.sccnn.com' + i response_2 = requests.get(url=page_url, headers=headers) response_2.encoding = response_2.apparent_encoding selector = parsel.Selector(response_2.text) title = selector.css('#LeftBox h2::text').get() img_url = selector.css('#LeftBox .PhotoDiv img::attr(src)').get()保存数据
讯享网def downlaod(title, url): path = 'D:\\python\\demo\\素材网站\\img\\' + title + '.jpg' response = requests.get(url=url, headers=headers) with open(path, mode='wb') as f: f.write(response.content) print('正在下载{}'.format(title))
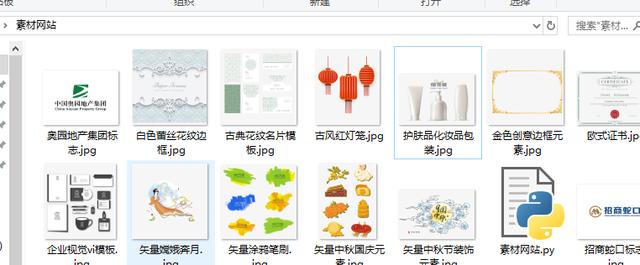
运行效果:
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/80501.html