
目标
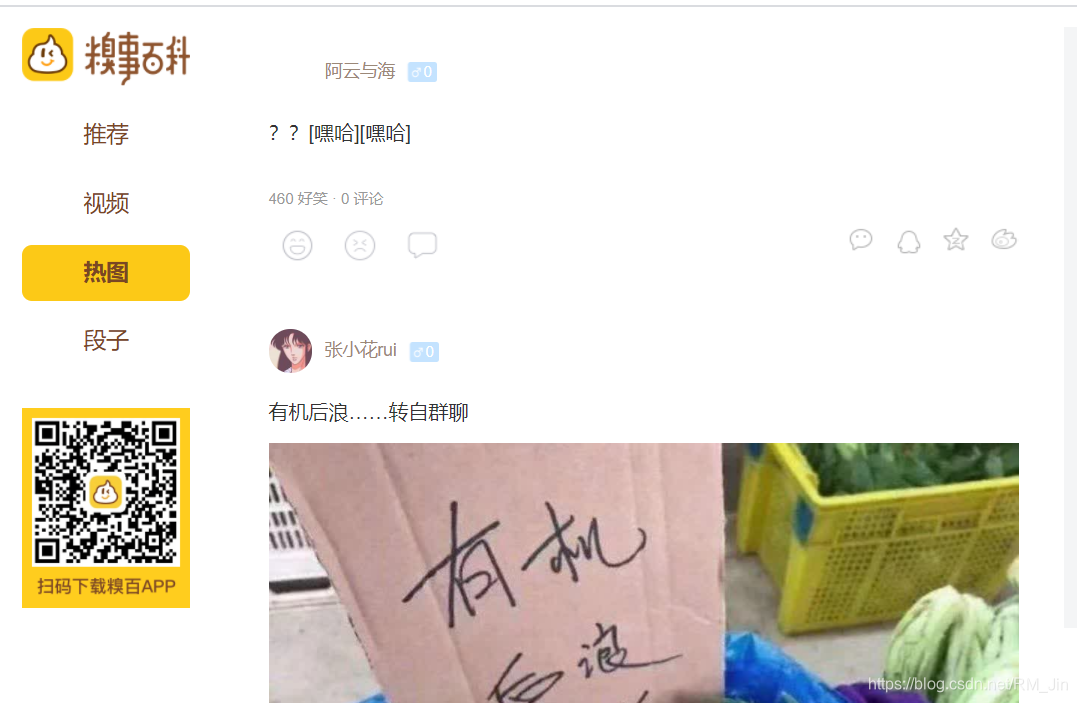
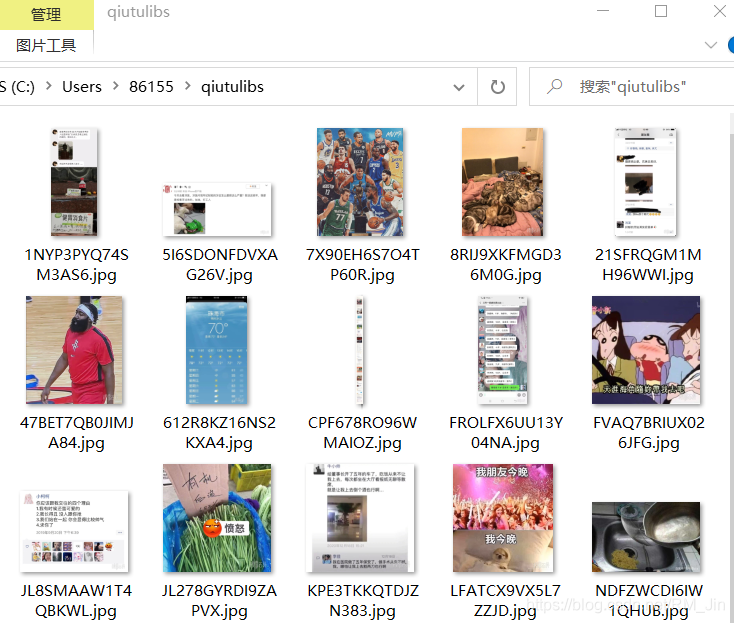
爬取糗事百科上的“热图”的图片并保存在一个新建文件夹当中
讯享网
过程
一、获得当前网页
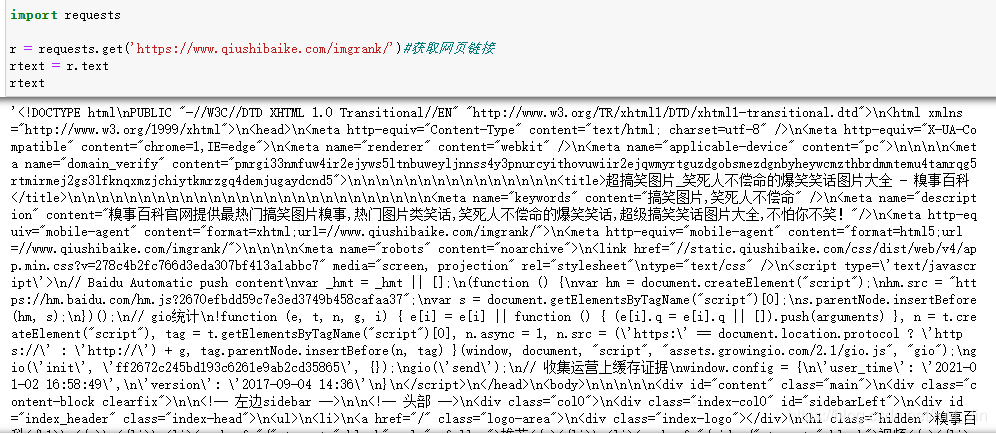
使用的是requests爬虫,在使用requests库爬取网页中有介绍。
import requests r = requests.get('https://www.qiushibaike.com/imgrank/')#获取网页链接 rtext = r.text #rtext #打开用来查看是否获取成功 讯享网
二、解析网页并提取图片
这里使用正则表达式,在正则表达式中有介绍。
首先,我们浏览器打开要爬取的网页,审查元素,定位到图片位置
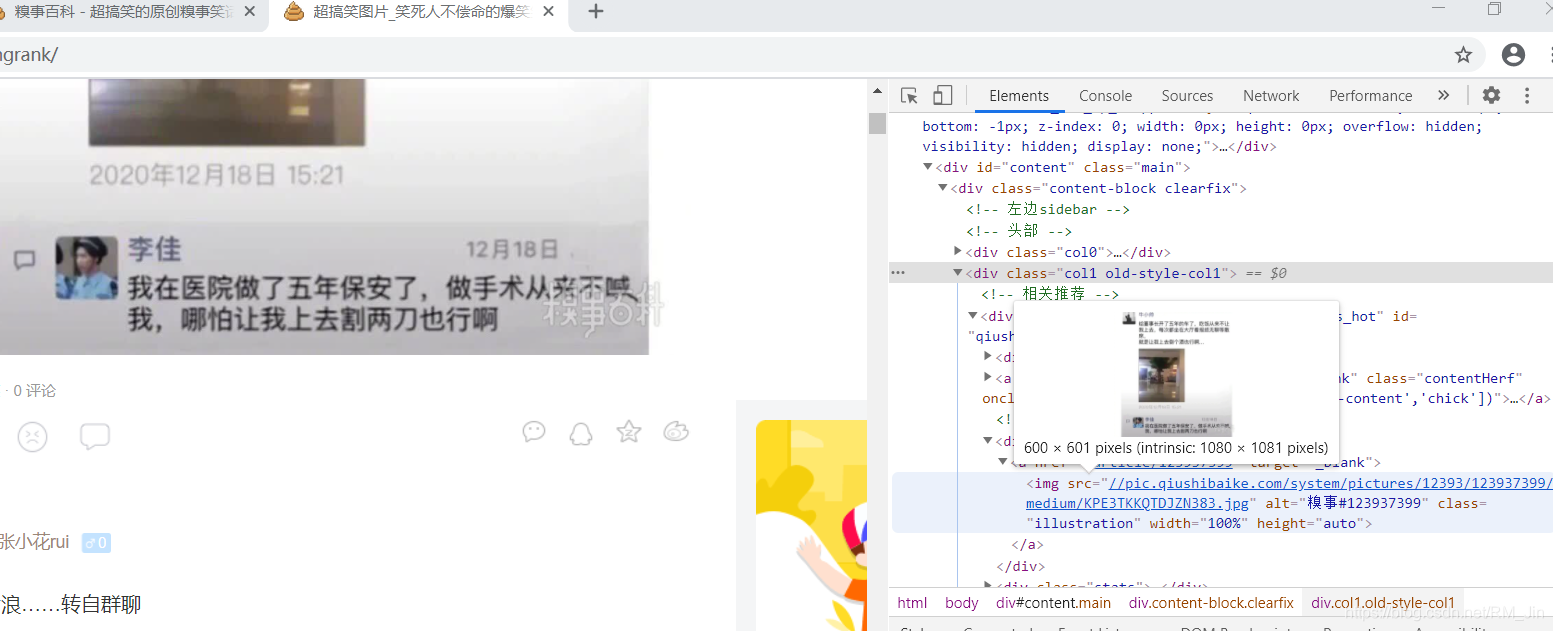
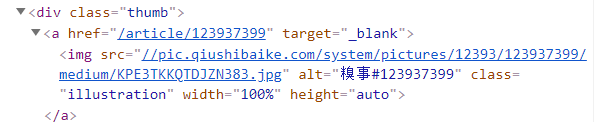
通过观察,所有图片都位于 class=thumb的div的img 下
我们将这片代码拿出来观察
讯享网<div class="thumb"> <a href="/article/" target="_blank"> <img src="//pic.qiushibaike.com/system/pictures/12393//medium/KPE3TKKQTDJZN383.jpg" alt="糗事#" class="illustration" width="100%" height="auto"> </a> </div>
设计正则表达式
ex = '<div class="thumb"> .*?<img src="(.*?)" alt.*?</div>' 讯享网import re ex = '<div class="thumb"> .*?<img src="(.*?)" alt.*?</div>' imglist = re.findall(ex,rtext,re.S)#搜索字符串;用于解析的都用re.S
三、保存图片
需要用到os库,创建一个文件夹qiutulist,将爬取出来的图片保存进去,但是需要注意保存图片的名字不能重复。
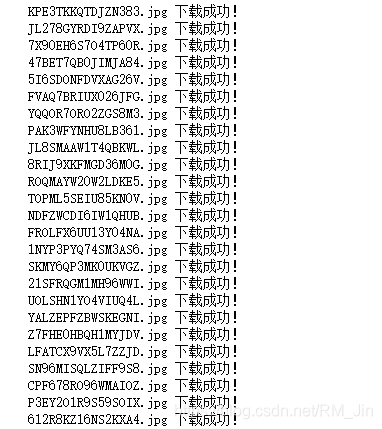
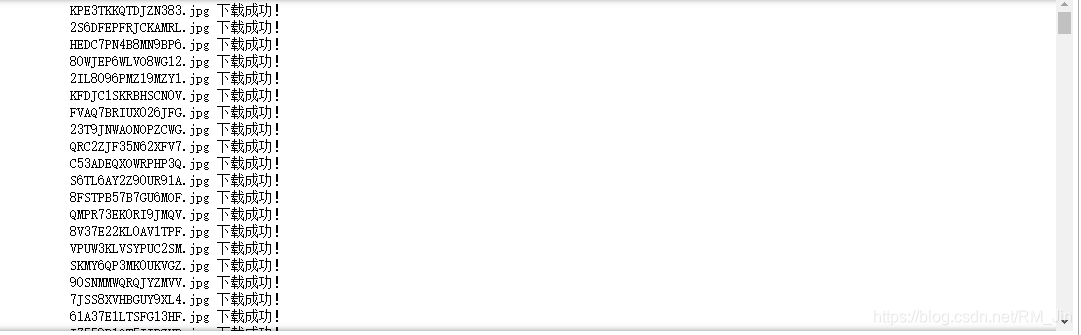
import os if not os.path.exists('./qiutulibs'): os.mkdir('./qiutulibs')#如果该目录不存在,则创新一个 for src in imglist: src = 'http:'+src#拼接成一个完整的链接 imgdata = requests.get(src).content#请求到了图的二进制数据 #生成图片名称 imgname = src.split('/')[-1] #图片存储路径 imgpath = './qiutulibs/'+imgname with open(imgpath,'wb') as fp: fp.write(imgdata) print(imgname,'下载成功!') split()函数语法:str.split(str=“”,num=string.count(str))[n]
参数说明:
str:表示为分隔符,默认为空格,但是不能为空(‘’)。若字符串中没有分隔符,则把整个字符串作为列表的一个元素
num:表示分割次数。如果存在参数num,则仅分隔成 num+1 个子字符串,并且每一个子字符串可以赋给新的变量
[n]:表示选取第n个分片
另外 with open() as fp 的用法
整合
讯享网import requests import re import os#文件 #创建文件夹,用来保存所有图片 if not os.path.exists('./qiutulibs'): os.mkdir('./qiutulibs') r = requests.get('https://www.qiushibaike.com/imgrank/') rtext = r.text ex = '<div class="thumb">.*?<img src="(.*?)" alt.*?</div>' imglist=re.findall(ex,rtext,re.S) #img for src in imglist: src = 'http:'+src#拼接成一个完整的链接 imgdata = requests.get(src).content#请求到了图的二进制数据 #生成图片名称 imgname = src.split('/')[-1] #图片存储路径 imgpath = './qiutulibs/'+imgname with open(imgpath,'wb') as fp: fp.write(imgdata) print(imgname,'下载成功!')
==============================================================================
进阶
实现多页爬取
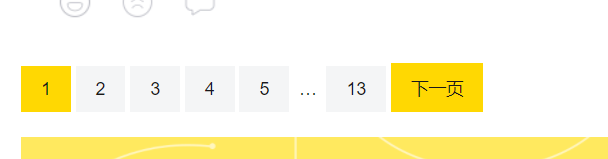
上述方法智能爬取一页的图片,但该系列有13页,这就需要分页爬取
分析
第二页链接:https://www.qiushibaike.com/imgrank/page/2/
第三页链接:https://www.qiushibaike.com/imgrank/page/3/
…
并且https://www.qiushibaike.com/imgrank/page/1/也能打开第一页链接
由此,可以设置一个模板链接,拼接到后面的数字
url='https://www.qiushibaike.com/imgrank/page/' for pagenum in range(1,13): pagen = 'pagenum'#这里要注意字符串的转化,否则会报错 rurl = format(url+pagen)#对应页码的url #把上述代码的解析都放在这个循环里 实现
讯享网#分页爬取 import requests import re import os#文件 #创建文件夹,用来保存所有图片 if not os.path.exists('./qiutulibs'): os.mkdir('./qiutulibs') #设置一个通用url模板 url='https://www.qiushibaike.com/imgrank/page/' #pagenum = 2 https://www.qiushibaike.com/imgrank/page/1/ for pagenum in range(1,13): pagen = 'pagenum' rurl = format(url+pagen)#对应页码的url r = requests.get(rurl) r.encoding='utf-8' rtext = r.text #解析操作 ex = '<div class="thumb">.*?<img src="(.*?)" alt.*?</div>' imglist=re.findall(ex,rtext,re.S) #img for src in imglist: src = 'http:'+src#拼接成一个完整的链接 imgdata = requests.get(src).content#请求到了图的二进制数据 #生成图片名称 imgname = src.split('/')[-1] #图片存储路径 imgpath = './qiutulibs/'+imgname with open(imgpath,'wb') as fp: fp.write(imgdata) print(imgname,'下载成功!')
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/80298.html