
不需建模的策略评估
先复习需要建模的方法 动态programming:我们需要model,P,R
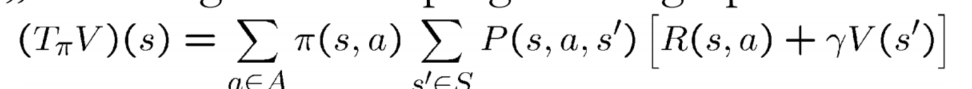
讯享网
无需建模的:
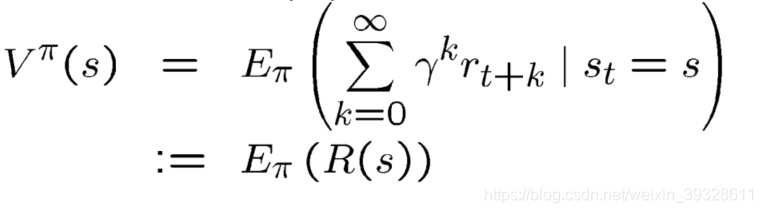
R(s)累计的瞬时reward 其期望为 V π ( s ) V^{\pi}(s) Vπ(s)
V π ( s ) V^{\pi}(s) Vπ(s)的估计
Monte Carlo 方法
V(s)的近似值为1/N Rk的和 ,近似期望
估计值收敛到实数期望,variance收敛到0,方差很大
通过迭代平均来完成 很浪费
- 有first-visit (现在研究的)是重复出现的state只记一次,
- every-visit 则不然
用MC估计**策略
估计Q 而不是V
通过MC评估,策略迭代选择better策略来改善,如果无限次还没完成评估则没有收敛
直接使用Q->用Q的贪婪action
对于非贪婪action则要用软策略
策略随时间改变,则没有收敛
优点:
- 无需建模
- 在非马尔科夫事件中变现更好
缺点: - 每个state需要遍历多次
- slow
- 未使用state之间的dependences
TD方法
Temporal Differences
改善MC方法的缺点:学习快速,可以证明收敛
无需模型学习
是本课程的首个真正的RL
采用Rk来估计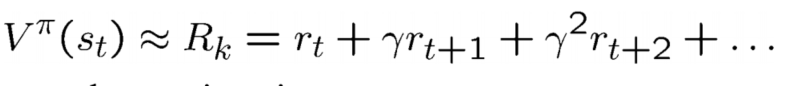
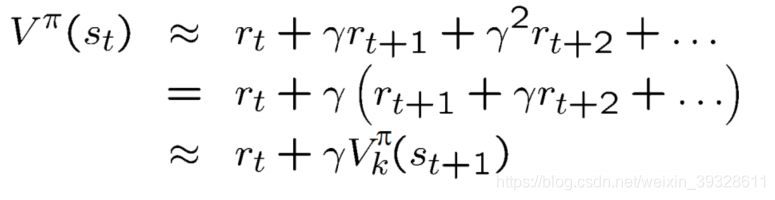
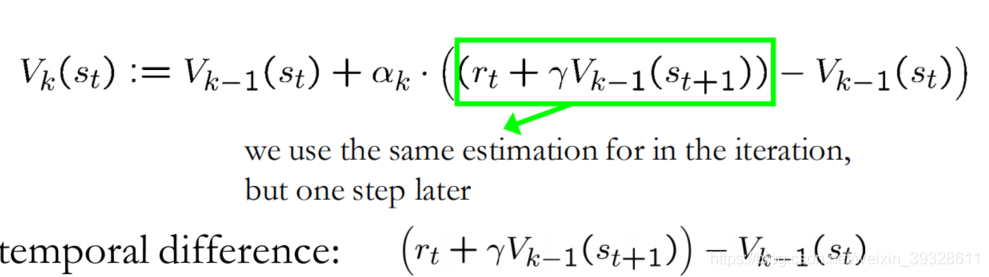
优点:无需建模,无需等到episode结尾,variance小
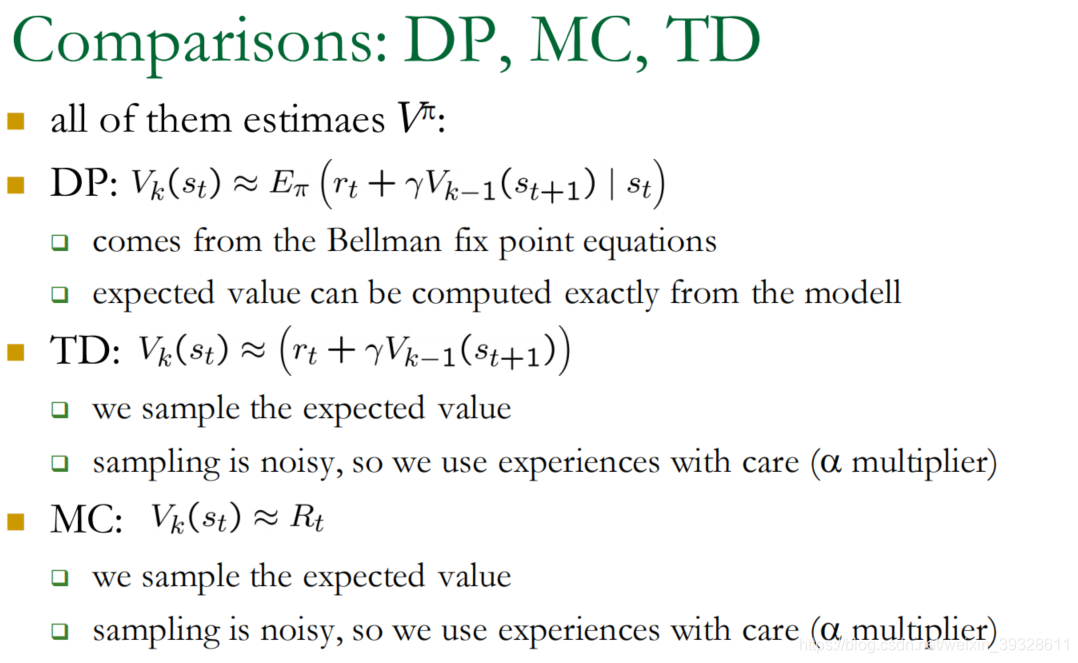
总结
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/79877.html