
古之立大事者,不为超世之才,亦必有坚忍不拔之志——苏轼
写在前面
今天弄了一个简易的爬表情包的脚本,这个脚本是 python 的,下面就将我的思路分享给大家。
网站分析
我们爬取的是 斗图啦 这个网站最新表情页,我们先来分析一下其 <img> 中的属性都有些什么。
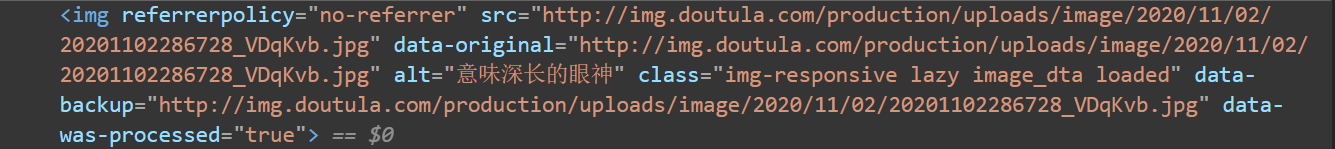
我们在 懒加载 这篇博客介绍过原 src 属性的值指向占位图片, data-original 属性设置图片的才是真实路径,所以这个链接是有用的;alt 属性貌似是图片名称,先记下。还有 class 属性,也记下来(要考的),用于区分 <img> 元素。
需要的库
在我们这个脚本中需要的库如下所示
import urllib from bs4 import BeautifulSoup import requests import re import os 讯享网
说明:
urllib库,此库是python中内置的一款 HTTP 请求库,也就是说此库不跟 pygame 似的需要我们自己安装,可以直接使用。此库还包含了 4 个模块,分别是
request: 最基本的HTTP请求模块,可以用来模拟发送请求。类似于在浏览器地址栏输入地址后按回车一样。error: 异常处理模块,用于捕捉各种出现的请求错误。parse: 工具模块,提供了许多URL处理方法,例如拆分、解析、合并等。robotparser: 主要用来识别网站的robots.txt文件。(用的比较少)
BeautifulSoup库是用Python写的一个 HTML/XML 的解析器,它可以很好的处理。它提供简单又常用的导航,搜索以及修改剖析树的操作。它可以大大节省你的编程时间。requests是 python 实现的最简单易用的 HTTP 库re和os是 python 内置的最普通的库,之前也有介绍 Python 正则表达式的语法以及 re 模块的使用 和 PythonOS模块的详细用法
前提准备
示例代码如下所示:
讯享网# 伪造浏览器用于 HTTP 请求的用户头 ua = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36 Edg/86" url = "http://www.doutula.com/photo/list/?page=1" def save_img(url, imgName): suffix = url.split('.')[-1] newimgName = re.sub(u"([^\u4e00-\u9fa5\u0030-\u0039\u0041-\u005a\u0061-\u007a])","",imgName) # 合并字符串 拼出文件名 filename = newimgName + '.' + suffix ''' os.path.join() 把目录和文件名合成一个路径 ''' path = os.path.join('B:\Practice code\Python\change_Ta\imgs', filename) ''' urllib.request.urlretrieve(url, filename=None) * 将URL表示的网络对象复制到本地文件 * 参数 * url:外部或者本地url * filename:指定了保存到本地的路径(如果未指定该参数,urllib会生成一个临时文件来保存数据); ''' img_data = urllib.request.urlretrieve(url, filename=path)
代码分析如下所示
全局变量:
ua: 表示伪造浏览器用于 HTTP 请求的用户头url: 表示爬取的网址
全局函数:
save_img():用于保存图片的函数,接受两个参数,第一个表示图片的地址,第二个参数表示图片的名称函数代码说明:
url.split('.')[-1]:split()函数指定分隔符 分隔字符串 返回一个数组,[-1]索引值表示最后一位re.sub(u"([^\u4e00-\u9fa5\u0030-\u0039\u0041-\u005a\u0061-\u007a])","",imgName)这段代码的含义就是删除掉名称中的特殊字符,
re.sub()函数在 Python 正则表达式的语法以及 re 模块的使用 有所介绍。os.path.join('B:\Practice code\Python\change_Ta\imgs', filename)这段代码记录的是图片的保存地址,``os.path.join()` 函数在 PythonOS.path模块的详细使用说明 有所介绍
urllib.request.urlretrieve()函数,用于保存图片,接受两个参数,一直为图片的地址,另一个为保存的路径。
主要代码
主要代码如下所示
# 伪造请求头发起请求 并返回一个 requests 对象 res = requests.request('GET', url, headers={
   'User-agent': ua}) # .text 属性根据编码方式获取 HTML 源代码 (编码方式可以通过 encodeing 属性设置) # print(res.encoding) content = res.text # 通过 BeautifulSoup 的构造方法,传入一个字符串或者文件句柄,就可以得到一个 bs 对象,html5lib 是解析方式 soup = BeautifulSoup(content, 'html5lib') image_list = soup.find_all('img', attrs={
   'class': 'img-responsive lazy image_dta'}) for img in image_list: # 获取 'data-original' 属性的值 url_img = img['data-original'] # 获取图片名称 img_name = img['alt'] save_img(url_img, img_name)
主要代码分析如下
通过 BeautifulSoup() 方法返回的 bs 对象,通过其 find_all() 方法筛选其 <img> 标签,这里通过我们之前记录的 class 属性。该方法的返回值是一个包换所有符合条件的列表
通过 for 循环遍历我们的符合条件的列表,每个值都调用一下 save_img() 方法。
完整代码
完整代码如下所示
讯享网import urllib from bs4 import BeautifulSoup import requests import re import os # 伪造浏览器用于 HTTP 请求的用户头 ua = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36 Edg/86" url = "http://www.doutula.com/photo/list/?page=1" def save_img(url, imgName): suffix = url.split('.')[-1] newimgName = re.sub(u"([^\u4e00-\u9fa5\u0030-\u0039\u0041-\u005a\u0061-\u007a])","",imgName) filename = newimgName + '.' + suffix path = os.path.join('B:\Practice code\Python\change_Ta\imgs', filename) img_data = urllib.request.urlretrieve(url, filename=path) # 伪造请求头发起请求 并返回一个 requests 对象 res = requests.request('GET', url, headers={
   'User-agent': ua}) # .text 属性根据编码方式获取 HTML 源代码 (编码方式可以通过 encodeing 属性设置) # print(res.encoding) content = res.text # 通过 BeautifulSoup 的构造方法,传入一个字符串或者文件句柄,就可以得到一个 bs 对象, soup = BeautifulSoup(content, 'html5lib') image_list = soup.find_all('img', attrs={
   'class': 'img-responsive lazy image_dta'}) for img in image_list: # 获取 'data-original' 属性的值 url_img = img['data-original'] img_name = img['alt'] save_img(url_img, img_name)
写在最后
我们可以根据这个思路来获取其他网页的图片,而且也可以将最后一段代码封装称为一个函数,通过 for 循环来获取多页的表情包,示例如下所示
BASE_PAGE_URL = "http://www.doutula.com/photo/list/?page=" PAGE_URL_LIST = [] for i in range(1,30): # 拼接字符串 url = BASE_PAGE_URL + str(i) # 调用主函数 因为我们爬取的表情包的网页的 URL 是由规律的嘛,我们可以通过这种方式来抓取其所有表情包
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/79095.html