
深度学习中的标签平滑正则化(Label Smoothing Regularization)方法原理详解_.我心永恒_的博客-CSDN博客_标签平滑正则化
标签平滑正则化(Label Smoothing Regularization,LSR)
计算交叉熵损失时,即关注正确类的损失,也关注不正确类的损失。
LSR的使用方法

y'是标签平滑操作后的样本标签,ϵ是平滑因子,u是人为设置的一个固态分布,尺寸和y一样。
具体使用方法,可以看下面的例子。
不使用和使用LSR的区别
(1)使用交叉熵损失时:
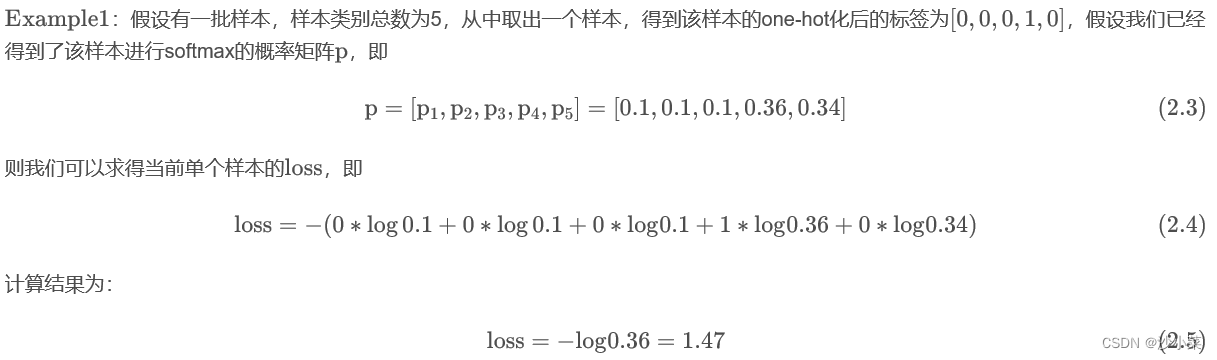
可以发现没有标签平滑计算的损失只考虑正确标签位置的损失,而不考虑其他标签位置的损失,这就会出现一个问题,即不考虑其他错误标签位置的损失,这会使得模型过于关注增大预测正确标签的概率,而不关注减少预测错误标签的概率,最后导致的结果是模型在自己的训练集上拟合效果非常良好,而在其他的测试集结果表现不好,即过拟合,也就是说模型泛化能力差。
(2) 交叉熵损失-使用标签滑动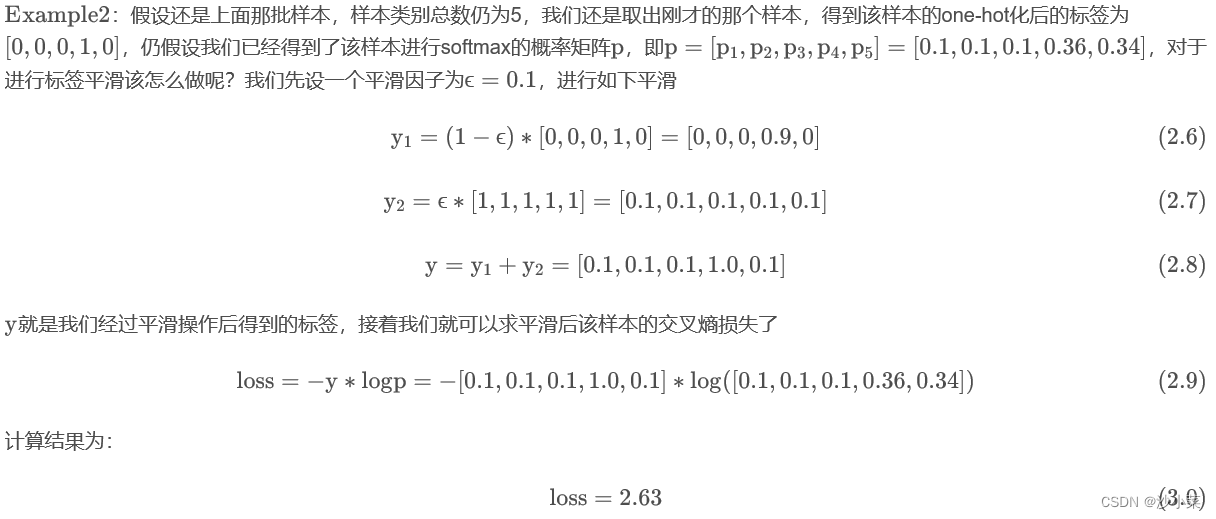
可以看出,平滑过后的样本交叉熵损失就不仅考虑到了训练样本中正确的标签位置(one-hot标签为1的位置)的损失,也稍微考虑到其他错误标签位置(one-hot标签为0的位置)的损失,导致最后的损失增大,导致模型的学习能力提高,即要下降到原来的损失,就得学习的更好,也就是迫使模型往增大正确分类概率并且同时减小错误分类概率的方向前进。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/79081.html