
配置代码的运行环境,具体方法就不累赘了,不然这期内容太多,在此给大家一个链接参考:https://www.byhy.net/tut/auto/selenium/01/大家可以参考上面这篇文章进行环境搭建。
上述步骤是默认大家已有Python编辑器的情况下进行操作的。
如果没有安装过Python编辑器,参考这篇文章进行安装:https://www.byhy.net/tut/py/basic/01/
所有准备工作都做好以后,就可以开始敲代码了
第一步:导入库(导入各个模块,为了让代码成功运行)ps:所有的库安装好之后先导入下试试,测试下是否安装成功
import selenium from selenium import webdriver from selenium.webdriver.chrome.options import Options import time import pandas as pd讯享网
第二步:编写数据获取函数Thelogin1()
1.准备工作,配置运行环境(宁稳网无需登陆,直接打开网页就可以)
讯享网# 设置函数,为了设置运行参数 chrome_options = Options() # 设置目标网址,开头的f可不加 url =f'https://www.ninwin.cn/index.php?m=cb&show_cb_only=Y&show_listed_only=Y' # 增加无头(不打开浏览器) chrome_options.add_argument('--headless') chrome_options.add_argument('--disable-gpu') # 防止被网站识别(伪装) chrome_options.add_experimental_option('excludeSwitches',['enable-automation']) # 将设置的参数传入,运行浏览器驱动,并且运行Chrome浏览器 browser = webdriver.Chrome(chrome_options = chrome_options) #打开网址 browser.get(url) #browser.maximize_window()#窗口最大化,如果是无头模式,就不需要打开窗口 #隐性延时,给浏览器反应时间 browser.implicitly_wait(5) #延时 time.sleep(2)
2.获取第一页网址上的相应数据,定位网页元素
#将所有获取的信息解析之后统一存入列表,方便后期转换 #获取所有可转债的溢价率 buttons = browser.find_elements_by_xpath('//td[@class="cb_premium_id"]') #数据较多,需要一一解析。将最终解析的数据统一存入list_premiumrate list_premiumrate = [] for i in buttons: list_premiumrate.append(i.text) time.sleep(1) #获取转债所属行业大类 buttonss1 = browser.find_elements_by_xpath('//td[@class="bond_code_id industry"][1]') #数据较多,需要一一解析。将最终解析的数据统一存入list_industry1 list_industry1 = [] for i in buttonss1: text = i.get_attribute("innerText")#如果获取的内容在网页上没有显示,那就是隐藏内容,无法通过.text来转换 list_industry1.append(text)#需要通过.get_attribute("innerText")来获取 time.sleep(1) #获取转债所属行业二类 buttonss2 = browser.find_elements_by_xpath('//td[@class="bond_code_id industry"][2]') list_industry2 = [] for i in buttonss2: text = i.get_attribute("innerText") list_industry2.append(text) time.sleep(1)3.获取申购页面的网址,并打开新页面继续获取数据,定位网页元素
讯享网#获取申购页面网址并打开 button1 = browser.find_element_by_xpath('//a[@href="index.php?m=cb&a=cb_subs"]') link_url2 = button1.get_attribute('href')#获取节点下的新网址 browser.get(link_url2)#打开新网址 browser.implicitly_wait(5) #获取申购页面下的全部信息 #1.获取转债名称 buttons2 = browser.find_elements_by_xpath('//td[@class="cb_name_id"]') list_name = [] for i in buttons2: list_name.append(i.text) #2.获取转债上市情况 buttons3 = browser.find_elements_by_xpath('//td[@class="bond_date_id"]//span') list_state = [] for i in buttons3: list_state.append(i.text) #3.获取转债评级 buttons4 = browser.find_elements_by_xpath('//td[@class="bond_rating_id rating"]') list_rating = [] for i in buttons4: list_rating.append(i.text) #4.获取转债规模 buttons5 = browser.find_elements_by_xpath('//td[@class="stock_price_id"][1]') list_size = [] for i in buttons5: list_size.append(i.text) #5.获取转债转股价值 buttons6 = browser.find_elements_by_xpath('//td[@class="cb_value_id"]') list_2 = [] for i in buttons6: list_2.append(i.text) #获取申购下的行业信息(这个数据隐藏在里面,取出来比较麻烦) list_industry = [] list_industry11 = [] list_company = [] buttons2 = browser.find_elements_by_xpath("//td[@class='stock_name_id stock_name']") for i in buttons2: list_company.append(i.text)#存储公司名称信息 information = i.get_attribute('title').split("—")#获取title标签中的内容 information1 = information[1]#取切片后的第二个内容 list_industry11.append(information1) information = information[0].split(":")#再切片 information = information[2] list_industry.append(information)
4.将获取到的数据进行整理,合成表格数据,方便阅读
#利用字典对数据进行整理 dictall = {} dict2 = {} dictall["转债名称"] = list_name dictall["正股名称"] = list_company dictall["转债规模"] = list_size dictall["转债评级"] = list_rating dictall["转债上市情况"] = list_state dictall["转股价值"] = list_2 dictall["所属行业大类"] = list_industry dictall["所属行业二类"] = list_industry11 dict2["溢价率"] = list_premiumrate dict2["所属行业大类"] = list_industry1 dict2["所属行业二类"] = list_industry2 #将所有数据变成表格数据 list_columns = ["转债名称","正股名称","转债上市情况","转债规模","转债评级","转股价值","所属行业大类","所属行业二类"] df_data = pd.DataFrame(dictall,columns = list_columns) #数据转换 df_data['转股价值'] = df_data['转股价值'].astype('float') df_data['转债规模'] = df_data['转债规模'].astype('float') #部分列标题重命名+数据转换 list_columns2 = ["所属行业大类","所属行业二类","溢价率"] df_data2 = pd.DataFrame(dict2,columns = list_columns2) df_data2['溢价率'] = df_data2['溢价率'].str.strip('%').astype('float') df_data2['溢价率'] = df_data2['溢价率']/100 #计算所有行业大类下的平均溢价率 df_data22 = df_data2.groupby("所属行业大类").mean() df_data22 = df_data22.reset_index() df_data22 = df_data22.rename(columns = {"溢价率":"平均数溢价率"}) #计算所有行业大类下的中位数溢价率 df_data33 = df_data2.groupby("所属行业大类").median() df_data33 = df_data33.reset_index() df_data33 = df_data33.rename(columns = {"溢价率":"中位数溢价率"}) #合并溢价率表格 df_premiumrate = pd.merge(df_data22,df_data33,on= '所属行业大类', how = 'left') #取出需要的平均数溢价率 list_price1 = [] for i in df_data["所属行业大类"]: i = " "+ i if len(i) > 4: i = i[0:5] premiumrate1 = df_premiumrate[df_premiumrate["所属行业大类"] == i].iat[0,1] list_price1.append(premiumrate1) #取出需要的中位数溢价率 list_price2 = [] for i in df_data["所属行业大类"]: i = " "+ i if len(i) > 4: i = i[0:5] premiumrate2 = df_premiumrate[df_premiumrate["所属行业大类"] == i].iat[0,2] list_price2.append(premiumrate2) #取出得到的平均数溢价率和中位数溢价率作为新的列添加到表格中 df_data["平均数溢价率"] = list_price1 df_data["中位数溢价率"] = list_price25.计算预估价格
讯享网df_data["上市价格预估1"] = df_data["转股价值"] * df_data["平均数溢价率"] + df_data["转股价值"] df_data["上市价格预估2"] = df_data["转股价值"] * df_data["中位数溢价率"] + df_data["转股价值"] df_data = df_data.round(2)#所有数据保留2位小数
6.退出设置
time.sleep(3)#等待 #browser.close()#关闭浏览器。如果是无头模式,不需要 browser.quit()#完全退出 return df_data#返回处理好的数据第三步:调用数据获取函数
讯享网df_data = Thelogin1()
完整代码如下:
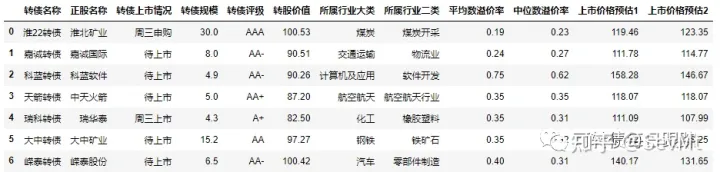
import selenium from selenium import webdriver from selenium.webdriver.chrome.options import Options import time import pandas as pd #预测未上市可转债价格 def Thelogin1():#模拟登录 chrome_options = Options() url =f'https://www.ninwin.cn/index.php?m=cb&show_cb_only=Y&show_listed_only=Y' # 增加无头(不打开浏览器) chrome_options.add_argument('--headless') chrome_options.add_argument('--disable-gpu') # 防止被网站识别(伪装) chrome_options.add_experimental_option('excludeSwitches',['enable-automation']) browser = webdriver.Chrome(chrome_options = chrome_options) browser.get(url)#打开网址 #browser.maximize_window()#窗口最大化 browser.implicitly_wait(5) time.sleep(2) #获取所有可转债的溢价率 buttons = browser.find_elements_by_xpath('//td[@class="cb_premium_id"]') list_premiumrate = [] for i in buttons: list_premiumrate.append(i.text) time.sleep(1) #获取转债所属行业大类 buttonss1 = browser.find_elements_by_xpath('//td[@class="bond_code_id industry"][1]') #print(buttonss1) list_industry1 = [] for i in buttonss1: text = i.get_attribute("innerText")#如果获取的内容在网页上没有显示,那就是隐藏内容,无法通过.text来转换 list_industry1.append(text)#需要通过.get_attribute("innerText")来获取 time.sleep(1) #获取转债所属行业二类 buttonss2 = browser.find_elements_by_xpath('//td[@class="bond_code_id industry"][2]') list_industry2 = [] for i in buttonss2: text = i.get_attribute("innerText") list_industry2.append(text) time.sleep(1) #获取申购页面网址并打开 button1 = browser.find_element_by_xpath('//a[@href="index.php?m=cb&a=cb_subs"]') link_url2 = button1.get_attribute('href')#获取节点下的新网址 #print(link_url2) browser.get(link_url2)#打开新网址 browser.implicitly_wait(5) #获取申购下的全部信息 buttons2 = browser.find_elements_by_xpath('//td[@class="cb_name_id"]') list_name = [] for i in buttons2: list_name.append(i.text) buttons3 = browser.find_elements_by_xpath('//td[@class="bond_date_id"]//span') list_state = [] for i in buttons3: list_state.append(i.text) buttons4 = browser.find_elements_by_xpath('//td[@class="bond_rating_id rating"]') list_rating = [] for i in buttons4: list_rating.append(i.text) buttons5 = browser.find_elements_by_xpath('//td[@class="stock_price_id"][1]') list_size = [] for i in buttons5: list_size.append(i.text) buttons6 = browser.find_elements_by_xpath('//td[@class="cb_value_id"]') list_2 = [] for i in buttons6: list_2.append(i.text) #获取申购下的行业信息 list_industry = [] list_industry11 = [] list_company = [] buttons2 = browser.find_elements_by_xpath("//td[@class='stock_name_id stock_name']") for i in buttons2: list_company.append(i.text) information = i.get_attribute('title').split("—")#获取title标签中的内容 information1 = information[1] list_industry11.append(information1) information = information[0].split(":") information = information[2] list_industry.append(information) dictall = {} dict2 = {} dictall["转债名称"] = list_name dictall["正股名称"] = list_company dictall["转债规模"] = list_size dictall["转债评级"] = list_rating dictall["转债上市情况"] = list_state dictall["转股价值"] = list_2 dictall["所属行业大类"] = list_industry dictall["所属行业二类"] = list_industry11 dict2["溢价率"] = list_premiumrate dict2["所属行业大类"] = list_industry1 dict2["所属行业二类"] = list_industry2 list_columns = ["转债名称","正股名称","转债上市情况","转债规模","转债评级","转股价值","所属行业大类","所属行业二类"] df_data = pd.DataFrame(dictall,columns = list_columns) df_data['转股价值'] = df_data['转股价值'].astype('float') df_data['转债规模'] = df_data['转债规模'].astype('float') list_columns2 = ["所属行业大类","所属行业二类","溢价率"] df_data2 = pd.DataFrame(dict2,columns = list_columns2) df_data2['溢价率'] = df_data2['溢价率'].str.strip('%').astype('float') df_data2['溢价率'] = df_data2['溢价率']/100 #df_data['上市价格预测'] = df_data['溢价率'] * df_data['转股价值'] + df_data['转股价值'] #计算行业大类下的平均溢价率 df_data22 = df_data2.groupby("所属行业大类").mean() df_data22 = df_data22.reset_index() df_data22 = df_data22.rename(columns = {"溢价率":"平均数溢价率"}) #计算行业大类下的中位数溢价率 df_data33 = df_data2.groupby("所属行业大类").median() df_data33 = df_data33.reset_index() df_data33 = df_data33.rename(columns = {"溢价率":"中位数溢价率"}) #合并表格 df_premiumrate = pd.merge(df_data22,df_data33,on= '所属行业大类', how = 'left') #平均数溢价率 list_price1 = [] for i in df_data["所属行业大类"]: i = " "+ i if len(i) > 4: i = i[0:5] premiumrate1 = df_premiumrate[df_premiumrate["所属行业大类"] == i].iat[0,1] list_price1.append(premiumrate1) #中位数溢价率 list_price2 = [] for i in df_data["所属行业大类"]: i = " "+ i if len(i) > 4: i = i[0:5] premiumrate2 = df_premiumrate[df_premiumrate["所属行业大类"] == i].iat[0,2] list_price2.append(premiumrate2) df_data["平均数溢价率"] = list_price1 df_data["中位数溢价率"] = list_price2 df_data["上市价格预估1"] = df_data["转股价值"] * df_data["平均数溢价率"] + df_data["转股价值"] df_data["上市价格预估2"] = df_data["转股价值"] * df_data["中位数溢价率"] + df_data["转股价值"] df_data = df_data.round(2) time.sleep(3)#等待 #browser.close()#关闭浏览器 browser.quit()#完全退出 return df_data df_data = Thelogin1() 显示结果例图:
您的点赞分享就是我更新的动力
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/77614.html