
本文作者王良辰,京东中台架构师,擅长分布式系统及高可用、高并发系统架构与设计。曾经为企业开发过多个通用脚手架,推崇以技术手段提升开发效率、约束开发行为。
什么是Explain
Explain被称为执行计划,在语句之前增加 explain 关键字,MySQL 会在查询上设置一个标记,模拟MySQL优化器来执行SQL语句,执行查询时,会返回执行计划的信息,并不执行这条SQL。(注意,如果 from 中包含子查询,仍会执行该子查询,将结果放入临时表中)。
Explain可以用来分析SQL语句和表结构的性能瓶颈。通过explain的结果,可以了解到如数据表的查询顺序、数据查询操作的操作类型、哪些索引可以被命中、哪些索引实际会命中、每个数据表有多少行记录被查询等信息。
Explain命令扩展
explain extended
在explain的基础上提供一些额外的查询信息,在explian extended执行以后,通过show warnings命令可以得到优化后的查询语句,可以看出优化器做了哪些工作,还可以通过某些数据估算表连接的行数。
explain partitions
用于分析使用了分区的表,会显示出可能用到的分区。
两点重要提示
1. Explain结果是基于数据表中现有数据的。
2. Explain结果与MySQL版本有很大的关系,不同版本的优化器的优化策略不同。
本文示例使用的数据库表
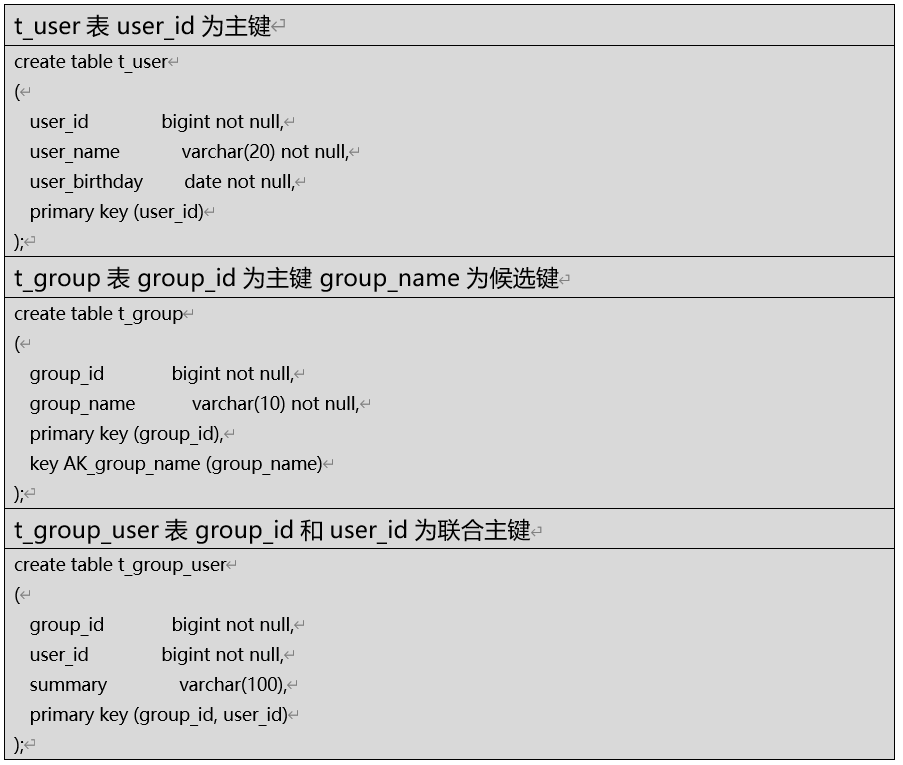
Explain命令(关键字)
explain简单示例
mysql>explain select * from t_user;

在查询中的每个”表”会输出一行,这里的“表”的意义非常广泛,不仅仅是数据库表,还可以是子查询、一个union 结果等。
explain结果列说明
【id列】
id列是一个有顺序的编号,是查询的顺序号,有几个 select 就显示几行。id的顺序是按 select 出现的顺序增长的。id列的值越大执行优先级越高越先执行,id列的值相同则从上往下执行,id列的值为NULL最后执行。
【select_type列】
select_type列的值标明查询的类型:
1)simple:表明当前行对应的select是简单查询,不包含子查询和union
2)primary:表明当前行对应的select是复杂查询中最外层的 select
3)subquery:表明当前行对应的select是包含在 select 中的子查询(不在 from 子句中)
4)derived:表明当前行对应的select是包含在 from 子句中的子查询。
MySQL会创建一个临时表来存放子查询的查询结果。用如下的语句示例说明:
explain select (select 1 fromt_user where user_id=1) from (select * from t_group where group_id=1) tmp;
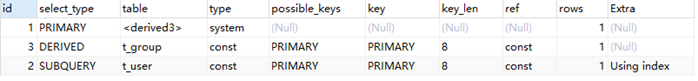
*注意,在资料收集过程中,发现不同版本的MySQL表现不一致,经反复对比,5.7及以后版本的输出如下:

很显然,MySQL在这方面进行了优化.
*注意,MySQL不同版本Explain表现差异很大,有些场景,从语句层面看,是要使用到索引,但经过优化器分析,结合表中现有数据,如果MySQL认为全表扫描性能更优,则会使用全表扫描。
5)union:表明当前行对应的select是在 union 中的第二个和随后的 select
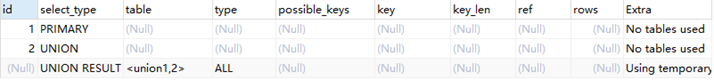
6)union result:表明当前行对应的select是从 union 临时表检索结果的 select
explain select 1 union all select 2 fromdual;

【table列】
table列的结果表明当前行对应的select正在访问哪个表。当查询的子句中有子查询时,table列是 格式,表示当前的select依赖 id=N结果行对应的查询,要先执行 id序号=N 的查询。当存在 union 时,UNION RESULT 的 table 列的值为,N1和N2表示参与 union 的select 行的id序号。
【type列】
type列的结果表明当前行对应的select的关联类型或访问类型,也就是优化器决定怎么查找数据表中的行,以及查找数据行记录的大概范围。该列的取值优化程度的优劣,从最优到最差依次为:null>system> const > eq_ref > ref > range > index > ALL。一般来说,要保证查询达到range级别,最好达到ref。
1)null,MySQL优化器在优化阶段分解查询语句,在优化过程中就已经可以得到结果,那么在执行阶段就不用再访问表或索引。
explain select min(user_id) from t_user;

这时的函数min,在索引列user_id中选取最小值,可以直接查找索引来完成,不需要执行时再访问数据表。
2)const和system:const出现在用 primary key(主键) 或 unique key(唯一键) 的所有列与常数比较时,优化器对查询进行优化并将其部分查询转化成一个常量。最多有一个匹配行,读取1次,速度非常快。而system是const的特例,表中数据只有一条匹配时为system。此时可以用explain extended+show warnings查看执行结果。
explain extended select * from (select * from t_user where user_id = 1) tmp;
show warnings;


MySQL5.7及以后版本优化后:


3)eq_ref:primary key(主键)或 unique key(唯一键) 索引的所有构成部分被join使用 ,只会返回一条符合条件的数据行。这是仅次于const的连接类型。
explain select * from t_group_user gu left join t_group g ong.group_id = gu.group_id;

4) ref:与eq_ref相比,ref类型不是使用primary key(主键) 或 unique key(唯一键)等唯一索引,而是使用普通索引或者联合唯一性索引的部分前缀,索引和某个值相比较,可能会找到符合条件的多个数据行。
1. 如下示例,使用的group_name是普通索引
explain select * from t_group where group_name= 'group1';

2.关联表查询
explain select g.group_id from t_group gleft join t_group_user gu on gu.group_id = g.group_id;

5)range:出现在 in(),between ,> ,= 等操作符中。使用一个索引来查询给定范围的行。
6)index:扫描全表索引(index是从索引中读取的,所有字段都有索引,而all是从硬盘中读取),比ALL要快。
explain select * from t_group;

7)all:即全表扫描,需要从头到尾去查找所需要的行。一般这种情况下这需要增加索引来进行查询优化了
explain select * from t_user;

【possible_keys列】
这一列的结果表明查询可能使用到哪些索引。但有些时候也会出现出现possible_keys 列有结果,而 后面的key列显示 null 的情况,这是因为此时表中数据不多,优化器认为查询索引对查询帮助不大,所以没有走索引查询而是进行了全表扫描。
如果possible_keys列的结果是null,则表明没有相关的索引。这时,可以通过优化where子句,增加恰当的索引来提升查询性能。
【key列】
这一列表明优化器实际采用哪个索引来优化对该表的访问。如果没有使用索引,则该列是 null。
【key_len列】
这一列表明了在索引里使用的字节数,通过这个值可以大致估算出具体使用了联合索引中的前几个列。
key_len计算规则这里不再赘述,不同的数据类型所占的字节数是不一致的。
【ref列】
这一列表明了在key列记录的索引中,表查找值所用到的列或常量,常见的有:const(常量),字段名,如user.user_id
【rows列】
这一列表明优化器大概要读取并检测的行数。跟实际的数据行数大部分情况是不一致的。
【Extra列】
顾名思义,这一列表明的是额外信息,这一列的取值对优化SQL非常有参考意义。常见的重要取值如下:
1)using index:所有被查询的字段都是索引列(称为覆盖索引),并且where条件是索引的前导列,出现这样的结果,是性能高的表现。
explainselect group_id,group_name from t_group;

2)using where:被查询的列未被索引覆盖,where条件也并非索引的前导列,表示 MySQL 执行器从存储引擎接收到查询数据,再进行“后过滤”(Post-filter)。所谓“后过滤”,就是先读取整行数据,再检查此行是否符合 where 句的条件,符合就留下,不符合便丢弃。
explain select * from t_user whereuser_name='user1';

3)using where Using index:被查询的列被索引覆盖,并且where条件是索引列之一但是不是索引的前导列,也就是没有办法直接通过索引来查询到符合条件的数据
explain select * from t_group where group_name = 'group1';

4)null:被查询的列没有被索引覆盖,但where条件是索引的前导列,此时用到了索引,但是部分列未被索引覆盖,必须通过“回表查询”来实现,不是纯粹地用到了索引,也不是完全没用到索引
explain select * from t_user where user_id='1';

5)using index condition:与using where类似,查询的列不完全被索引覆盖,where条件中是一个前导列的范围;这种情况未能通过示例显现,可能跟MySQL版本有关系。
6) using temporary:这表明需要通过创建临时表来处理查询。出现这种情况一般是要进行优化的,用索引来优化。创建临时表的情况:distinct,group by,orderby,子查询等
explain select distinct user_name from t_user;

explain select distinct group_name fromt_group; --group_name是索引列

7) usingfilesort:在使用order by的情况下出现,mysql会对结果使用一个外部索引排序,而不是按索引次序从表里读取行。此时mysql会根据联接类型浏览所有符合条件的记录,并保存排序关键字和行指针,然后排序关键字并按顺序检索行信息。这种情况下要考虑使用索引来优化的。
explain select * from t_user orderby user_name;

explain select * from t_group order bygroup_name; --group_name是索引列

查询优化建议
结合前面的描述,首先看 type列的结果,如果有类型是 all 时,表示预计会进行全表扫描(fulltable scan)。通常全表扫描的代价是比较大的,建议创建适当的索引,通过索引检索避免全表扫描。
再来看下 Extra 列的结果,如果有出现 Using temporary 或者 Using filesort 则要多加关注: Using temporary ,表示需要创建临时表以满足需求,通常是因为GROUP BY的列没有索引,或者GROUP BY和ORDER BY的列不一样,也需要创建临时表,建议添加适当的索引。 Using filesort ,表示无法利用索引完成排序,也有可能是因为多表连接时,排序字段不是驱动表中的字段,因此也没办法利用索引完成排序,建议添加适当的索引。 Using where ,通常是因为全表扫描或全索引扫描时(type 列显示为 ALL 或index),又加上了WHERE条件,建议添加适当的索引。索引使用情况分析
数据库表
主键索引:demo_id
联合索引:c1,c2,c3
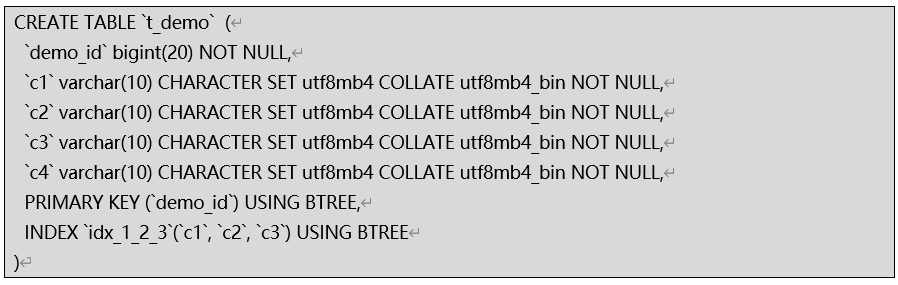
实例说明
实例一:
explain select * from t_demo where c1='d1'and c2='d2' and c3='d3';
explain select * from t_demo where c2='d2'and c1='d1' and c3='d3';
explain select * from t_demo where c3='d3'and c1='d1' and c2='d3';

几个Sql表现一致
type=ref,ref=const,const,const
执行常量等值查询时,改变索引列的顺序并不会更改explain的执行结果,优化器会进行优化,推荐按照索引顺序列编写sql语句。
实列二:
explain select * from t_demo where c1='d1'and c2>'d2' and c3='d3';

explain select * from t_demo where c1='d1'and c3>'d3' and c2='d2';

第一个例子范围右侧索引失效,使用到了两个索引。
第二个例子,由于优化器优化的原因,使用到了全部的三个索引。
实例三:
explain select * from t_demo wherec1>'c' and c2='d2' and c3='d3';

explain select * from t_demo wherec1>'e' and c2='d2' and c3='d3';

从上面两个实例可以发现,同样使用最左的索引列范围查询,有些情况未用到索引,做了全表扫描(第一个例子);有些情况使用到了索引(第二个例子)。
经反复验证,发现如下规律(不一定可靠),也可能与数据的第一行或最小值相关。
1. 跟存储的数据有关
2. 在大于条件下,如果条件数据小于列数据,则索引无效;如果条件数据大于列数据,则索引有效;
在设计查询条件时,请注意规避。
针对第一个例子,可以采用覆盖索引的方式优化。
实例四:
explain select * from t_demo where c1='d1'and c2='d2' order by c3;

explain select * from t_demo where c1='d1'order by c3;

explain select * from t_demo where c1='d1'and c3='d3' order by c2;

order by排序使用到索引和没使用到索引的情况
实例五:
explain select * from t_demo where c1='d1'and c4='d4' order by c1,c2;

条件列包含没有索引的列,出现了Using filesort
实例六:
explain select * from t_demo where c1='d1'and c4='d4' group by c1,c2;

性能非常差的场景,同时出现了Using temporary和Using filesort
总结
1. 两种方式的排序filesort和index,Usingindex是指MySQL扫描索引本身完成排序。index效率高,filesort效率低。
2. order by满足两种情况会使用Using index。
1)order by语句使用索引最左前列。
2)使用where子句与order by子句条件列组合满足索引最左前列。
3. 尽量在索引列上完成排序,遵循索引建立(索引创建的顺序)时的**左前缀法则。
4. group by与order by很类似,都是先排序后分组,遵照索引创建顺序的**左前缀法则。
—————END—————
喜欢本文的朋友,欢迎关注公众号 程序员小灰,收看更多精彩内容
点个[在看],是对小灰最大的支持!讯享网
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/77272.html