
目录
什么是k8s调度
nodeName
nodeSelector
配置示例
节点亲和性
亲和性与反亲和性
Taints污点与容忍
cordon、drain、delete
cordon隔离
drain驱逐
delete删除
什么是k8s调度
调度器通过 kubernetes 的 watch 机制来发现集群中新创建且尚未被调度到 Node 上的 Pod。调度器会将发现的每一个未调度的 Pod 调度到一个合适的 Node 上来运行。
kube-scheduler 是 Kubernetes 集群的默认调度器,并且是集群控制面的一部分。如果你真的希望或者有这方面的需求,kube-scheduler 在设计上是允许你自己写一个调度组件并替换原有的 kube-scheduler。
在做调度决定时需要考虑的因素包括:单独和整体的资源请求、硬件/软件/策略限制、亲和以及反亲和要求、数据局域性、负载间的干扰等等。
nodeName
nodeName 是节点选择约束的最简单方法,但一般不推荐。如果 nodeName 在 PodSpec 中指定了,则它优先于其他的节点选择方法。
使用 nodeName 来选择节点的一些限制:
- 如果指定的节点不存在。
- 如果指定的节点没有资源来容纳 pod,则pod 调度失败。
- 云环境中的节点名称并非总是可预测或稳定的
nodeSelector
nodeSelector 是节点选择约束的最简单推荐形式。
配置示例
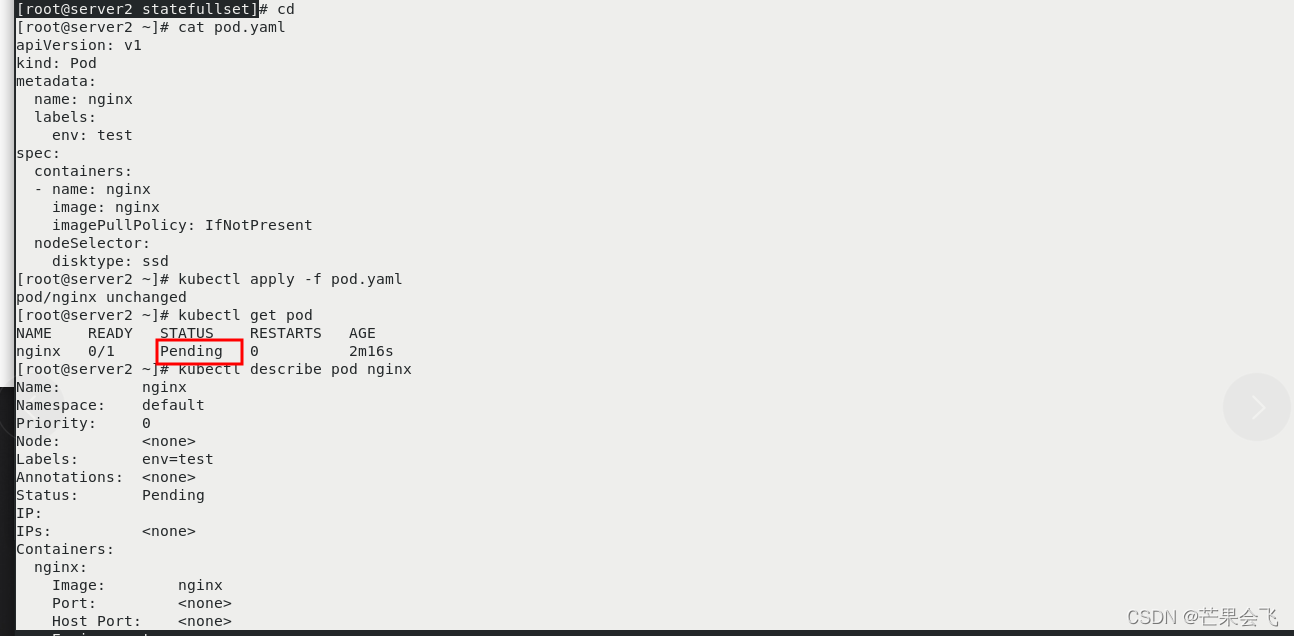
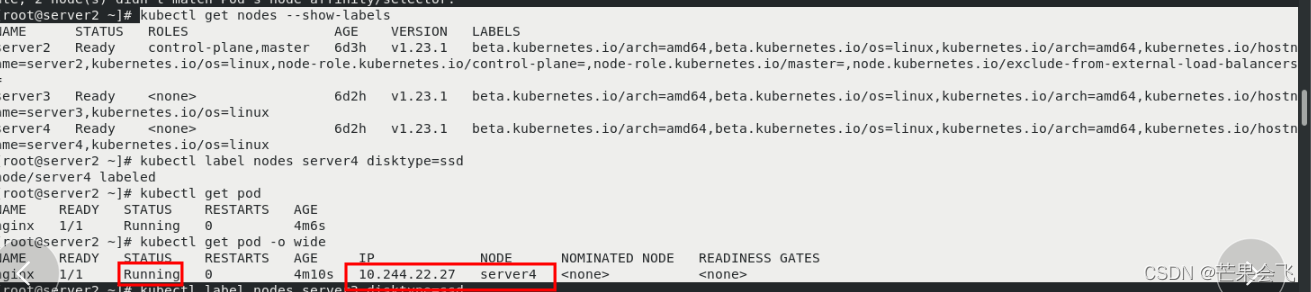
cd vim pod.yaml kubectl apply -f pod.yaml kubectl get pod 状态一直是pending kubectl describe pod nginx kubectl get nodes --show-labels kubectl label nodes server4 disktype=ssd kubectl get pod 状态已经就绪 kubectl get pod -o wide 查看节点在4上讯享网

节点亲和性
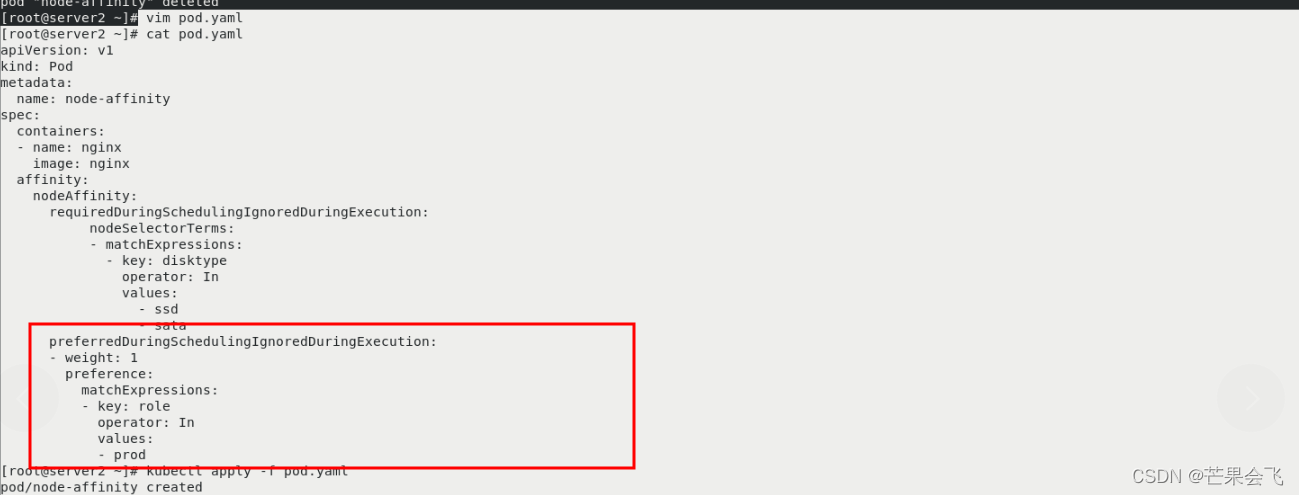
亲和性调度可以分成软策略和硬策略两种方式:
- 软策略就是如果现在没有满足调度要求的节点的话,pod就会忽略这条规则,继续完成调度的过程。
- 硬策略比较强硬,如果没有满足条件的节点的话,就不断重试直到满足条件为止。
亲和与反亲和:
nodeSelector 提供了一种非常简单的方法来将 pod 约束到具有特定标签的节点上。亲和/反亲和功能极大地扩展了约束的类型。
可以发现规则是“软”/“偏好”,而不是硬性要求,因此,如果调度器无法满足该要求,仍然调度该 pod
我们可以使用节点上的 pod 的标签来约束,而不是使用节点本身的标签,来允许哪些 pod 可以或者不可以被放置在一起。
节点亲和参数:
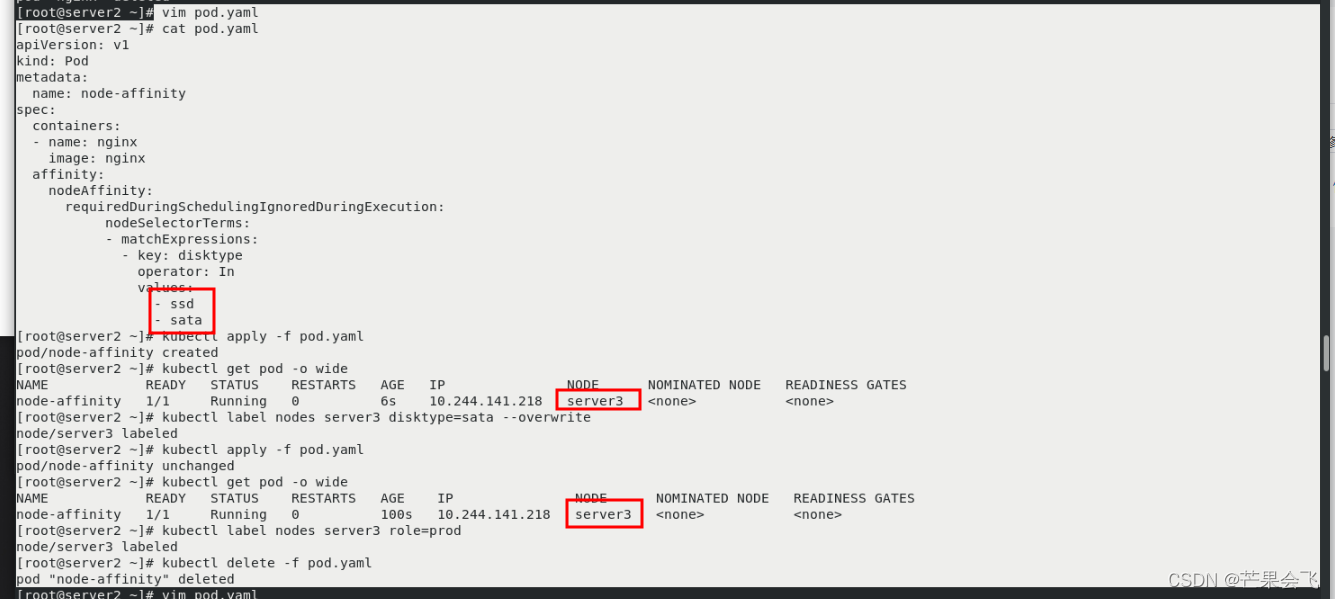
- requiredDuringSchedulingIgnoredDuringExecution 必须满足
- preferredDuringSchedulingIgnoredDuringExecution 倾向满足
- IgnoreDuringExecution 表示如果在Pod运行期间Node的标签发生变化,导致亲和性策略不能满足,则继续运行当前的Pod。
nodeaffinity还支持多种规则匹配条件的配置如:
- In:label 的值在列表内
- NotIn:label 的值不在列表内
- Gt:label 的值大于设置的值,不支持Pod亲和性
- Lt:label 的值小于设置的值,不支持pod亲和性
- Exists:设置的label 存在
- DoesNotExist:设置的 label 不存在
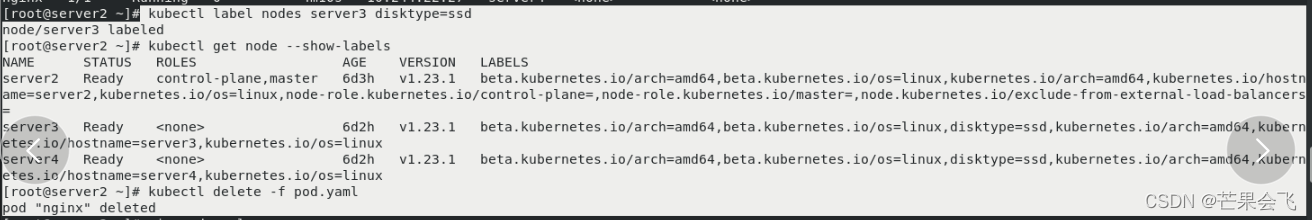
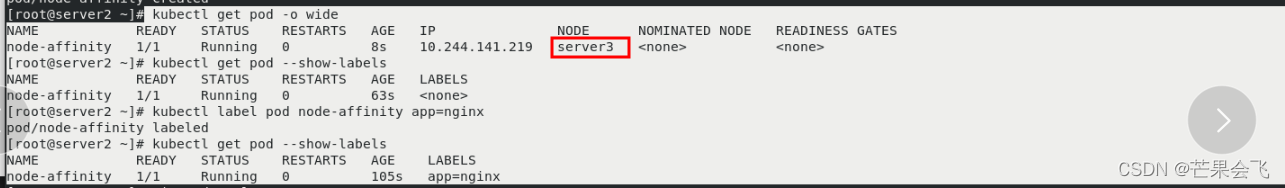
讯享网kubectl label nodes server3 disktype=ssd kubectl get node --show-labels kubectl delete -f pod.yaml vim pod.yaml kubectl apply -f pod.yaml kubectl get pod -o wide 查看节点在3上 kubectl label nodes server3 disktype=sata --overwrite kubectl apply -f pod.yaml kubectl get pod -o wide kubectl label nodes server3 role=prod kubectl delete -f pod.yaml vim pod.yaml kubectl apply -f pod.yaml kubectl get pod -o wide kubectl get pod --show-labels kubectl label pod node-affinity app=nginx kubectl get pod --show-labels
亲和性与反亲和性
pod 亲和性和反亲和性:
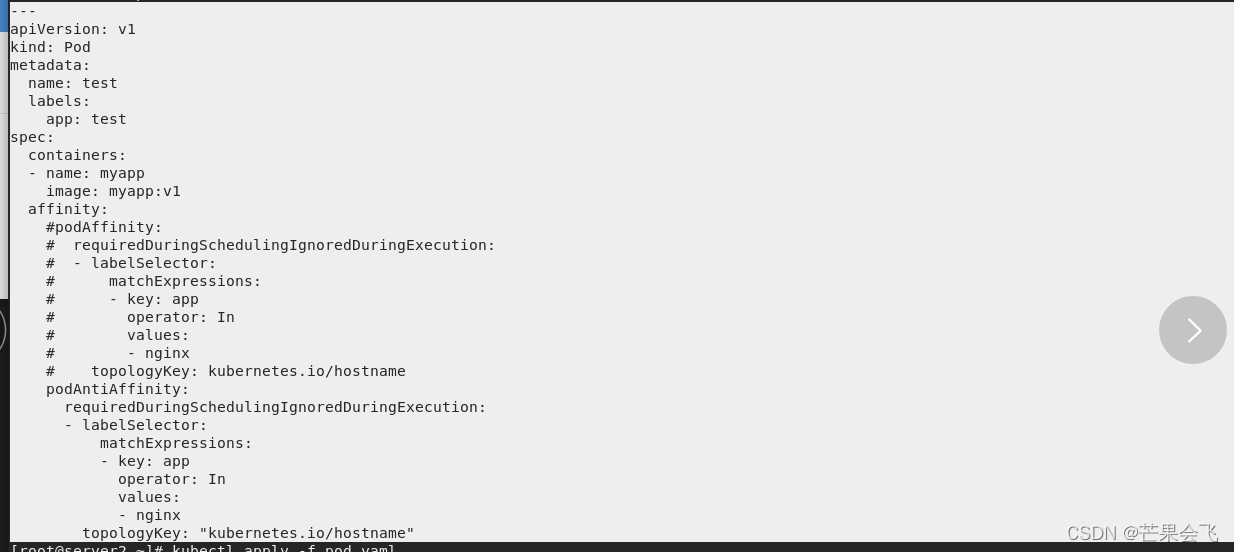
- podAffinity主要解决POD可以和哪些POD部署在同一个拓扑域中的问题(拓扑域用主机标签实现,可以是单个主机,也可以是多个主机组成的cluster、zone等。)
- podAntiAffinity主要解决POD不能和哪些POD部署在同一个拓扑域中的问题。它们处理的是Kubernetes集群内部POD和POD之间的关系。
- Pod 间亲和与反亲和在与更高级别的集合(例如 ReplicaSets,StatefulSets,Deployments等)一起使用时,它们可能更加有用。可以轻松配置一组应位于相同定义拓扑(例如,节点)中的工作负载。
- Pod 间亲和与反亲和需要大量的处理,这可能会显著减慢大规模集群中的调度。
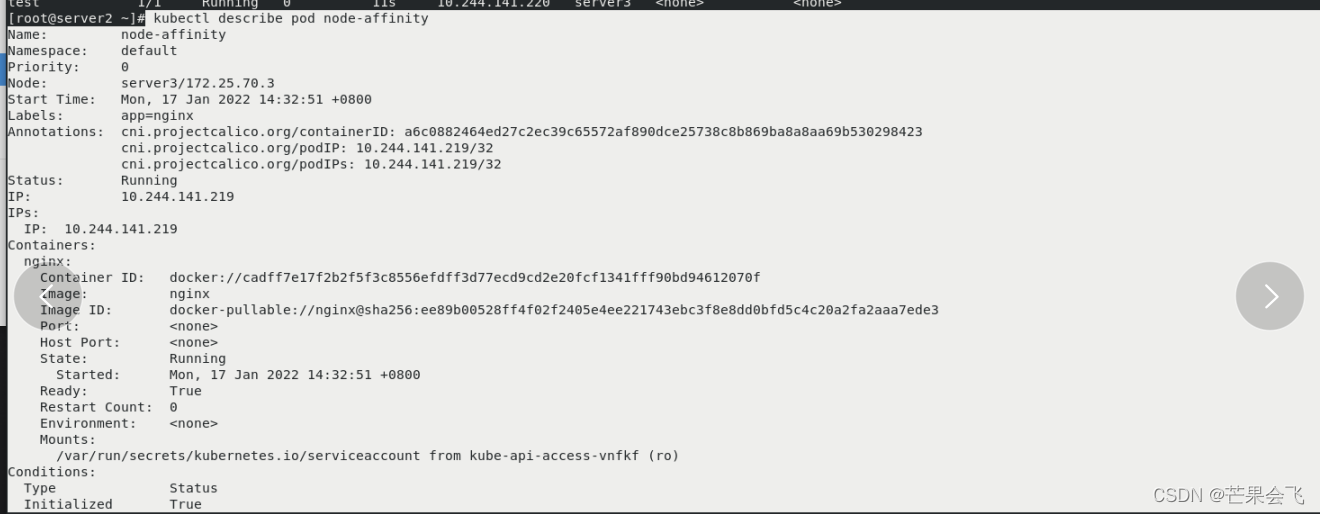
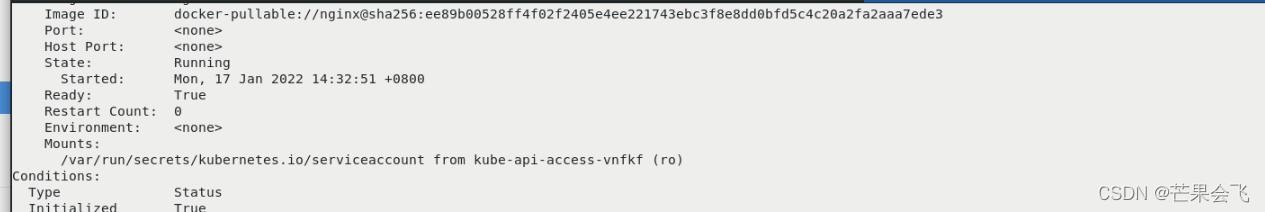
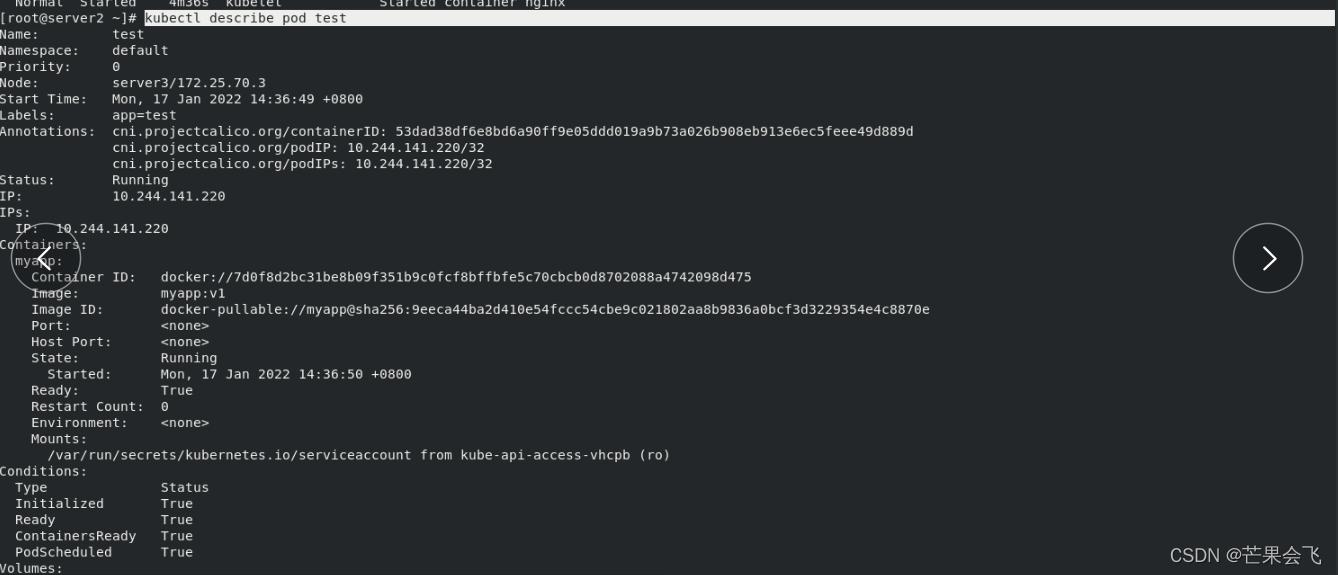
vim pod.yaml kubectl apply -f pod.yaml kubectl get pod kubectl get pod -o wide 节点全部在3上 kubectl describe pod node-affinity kubectl describe pod test kubectl get pod --show-labels kubectl delete pod test vim pod.yaml kubectl apply -f pod.yaml kubectl get pod -o wide 节点分别在3和4上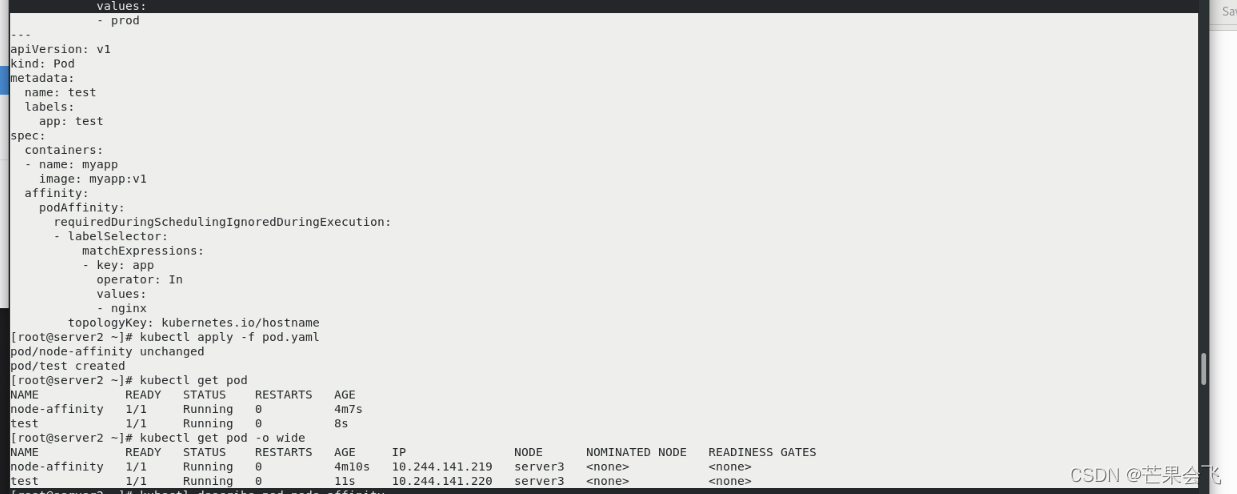


Taints污点与容忍
NodeAffinity节点亲和性,是Pod上定义的一种属性,使Pod能够按我们的要求调度到某个Node上,而Taints则恰恰相反,它可以让Node拒绝运行Pod,甚至驱逐Pod。
Taints(污点)是Node的一个属性,设置了Taints后,所以Kubernetes是不会将Pod调度到这个Node上的,于是Kubernetes就给Pod设置了个属性Tolerations(容忍),只要Pod能够容忍Node上的污点,那么Kubernetes就会忽略Node上的污点,就能够(不是必须)把Pod调度过去。
可以使用如下命令 kubectl taint 给节点增加或操作 taint:
kubectl taint nodes node1 key=value:NoSchedule 创建
kubectl describe nodes server1 |grep Taints 查询
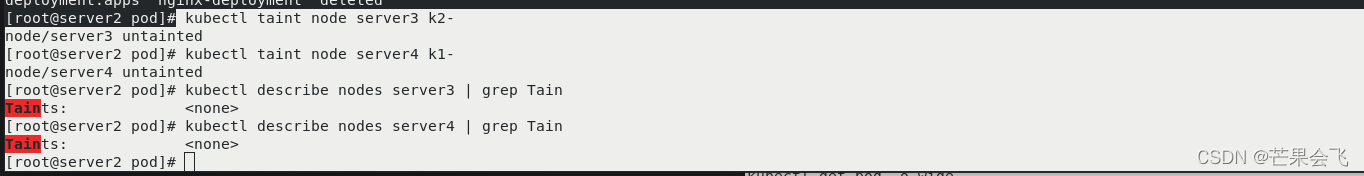
kubectl taint nodes node1 key:NoSchedule- 删除
其中[effect] 可取值: [ NoSchedule | PreferNoSchedule | NoExecute ]
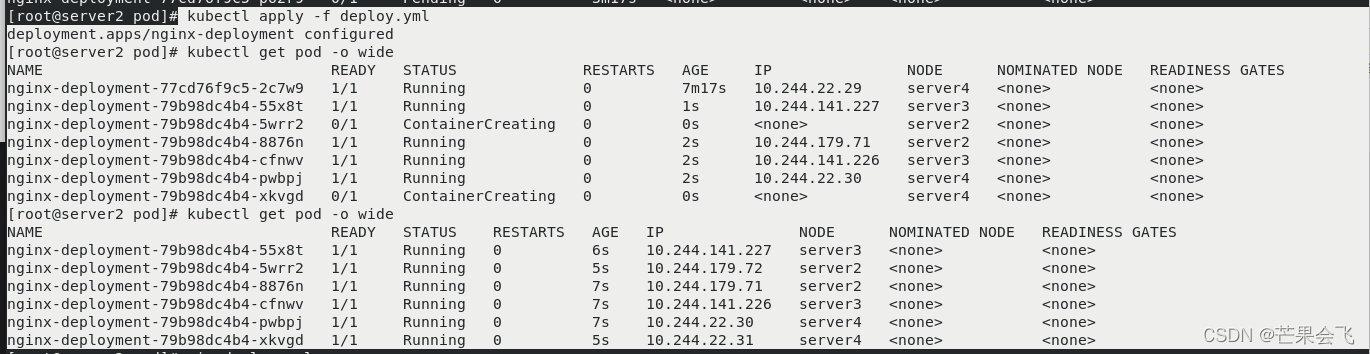
- NoSchedule:POD 不会被调度到标记为 taints 节点。
- PreferNoSchedule:NoSchedule 的软策略版本。
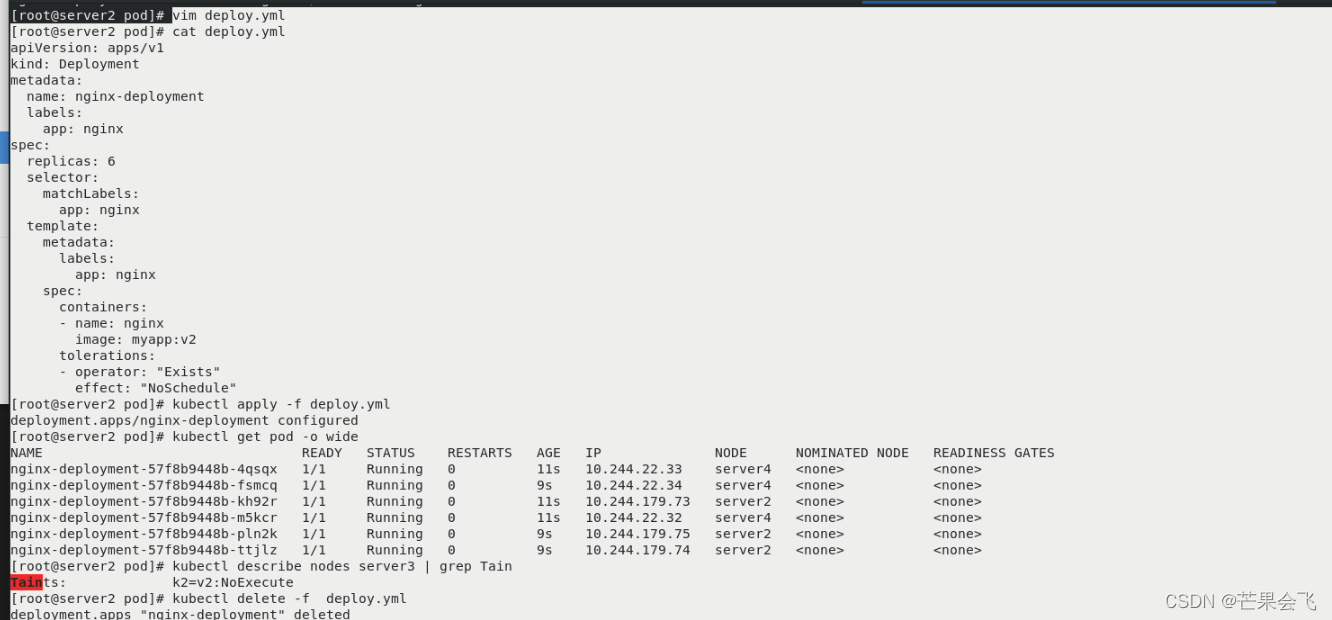
- NoExecute:该选项意味着一旦 Taint 生效,如该节点内正在运行的 POD 没有对应 Tolerate 设置,会直接被逐出。
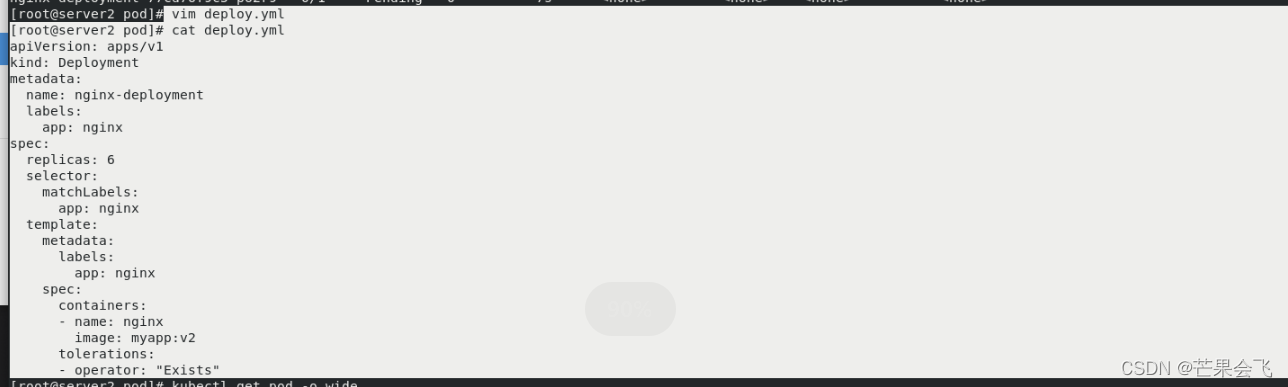
tolerations中定义的key、value、effect,要与node上设置的taint保持一致:
- 如果 operator 是 Exists ,value可以省略。
- 如果 operator 是 Equal ,则key与value之间的关系必须相等。
- 如果不指定operator属性,则默认值为Equal。
还有两个特殊值:
- 当不指定key,再配合Exists 就能匹配所有的key与value ,可以容忍所有污点。
- 当不指定effect ,则匹配所有的effect。
讯享网kubectl describe nodes server2 | grep Tain 查看2上的污点 kubectl delete -f pod.yaml cd pod/ ls vim deploy.yml kubectl apply -f deploy.yml kubectl get pod kubectl get pod -o wide kubectl taint nodes server4 k1=v1:NoSchedule kubectl get pod -o wide vim deploy.yml kubectl apply -f deploy.yml kubectl get pod -o wide kubectl taint nodes server3 k2=v2:NoExecute kubectl get pod -o wide vim deploy.yml kubectl apply -f deploy.yml kubectl get pod -o wide vim deploy.yml kubectl apply -f deploy.yml kubectl get pod -o wide kubectl describe nodes server3 | grep Tain kubectl delete -f deploy.yml kubectl taint node server3 k2- kubectl taint node server4 k1- kubectl describe nodes server3 | grep Tain kubectl describe nodes server4 | grep Tain

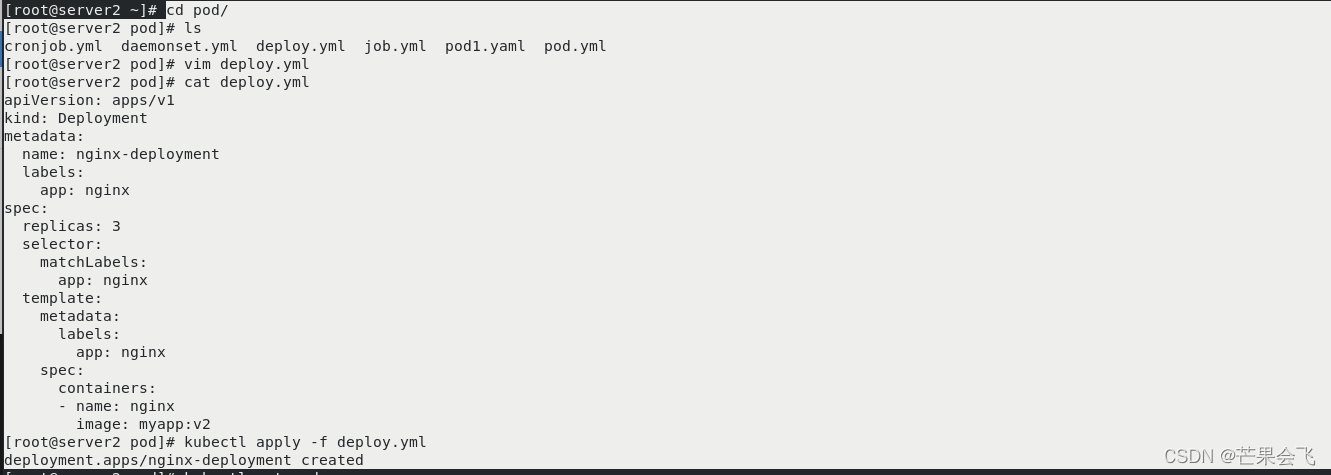
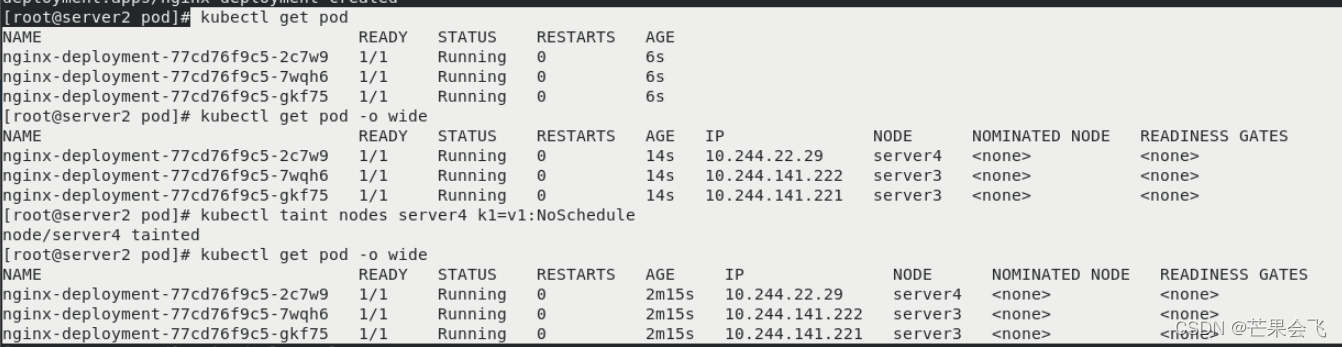
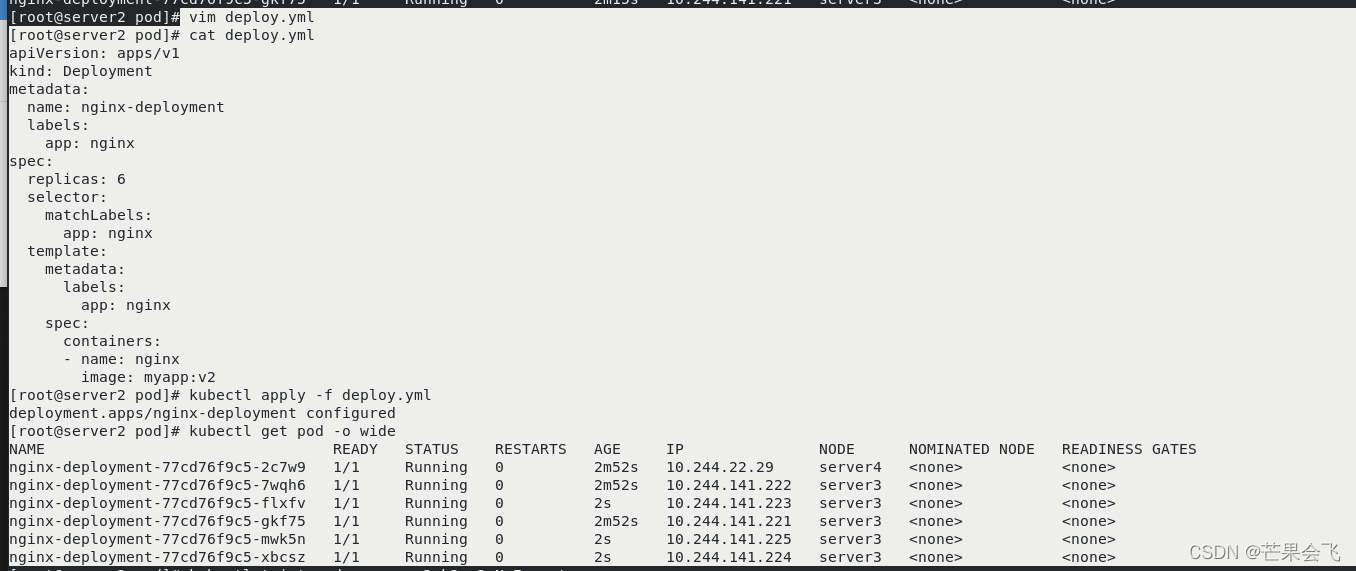
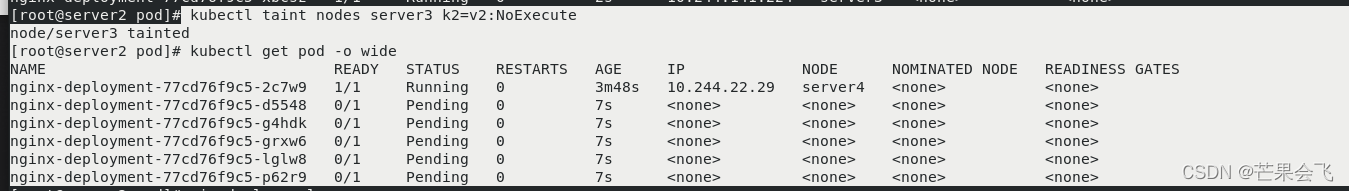
cordon、drain、delete
影响Pod调度的指令还有:cordon、drain、delete,后期创建的pod都不会被调度到该节点上,但操作的暴力程度不一样。
cordon隔离
cordon停止调度:
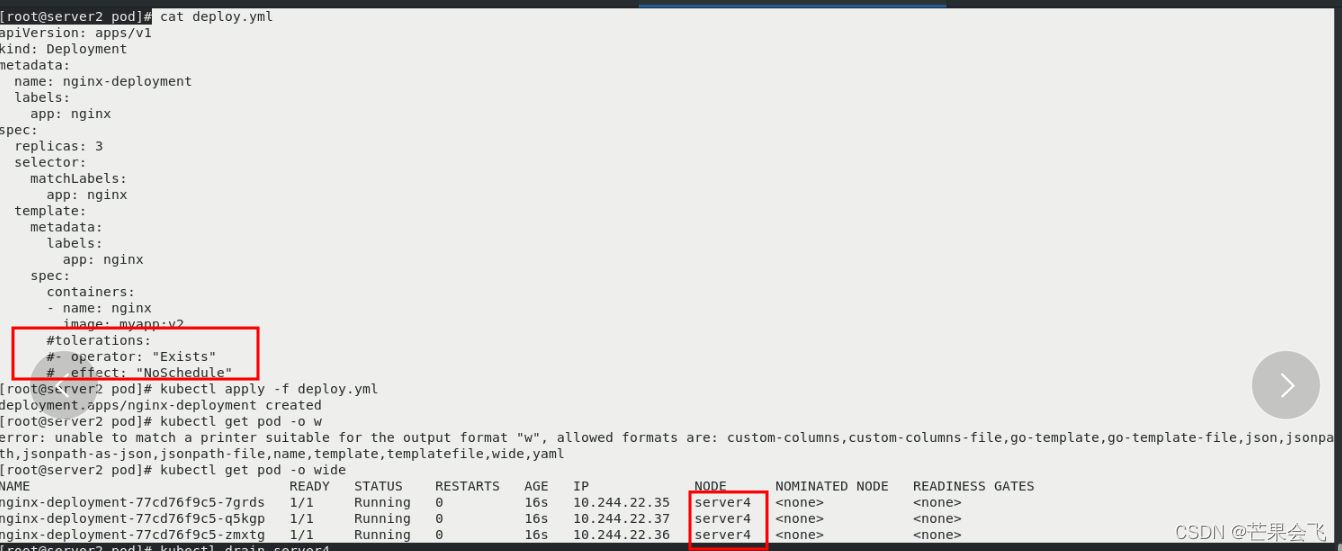
影响最小,只会将node调为SchedulingDisabled,新创建pod,不会被调度到该节点,节点原有pod不受影响,仍正常对外提供服务。
禁用server3 kubectl get node vim deploy.yml 【注释掉容忍项】 kubectl apply -f deploy.yml kubectl get pod -o wide 三个pod都在4上,3不参加调用了被禁掉了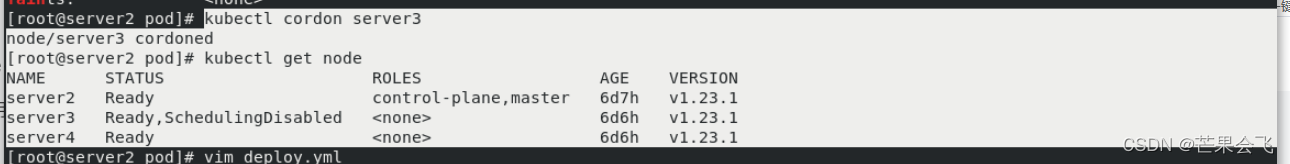
drain驱逐
drain驱逐节点:
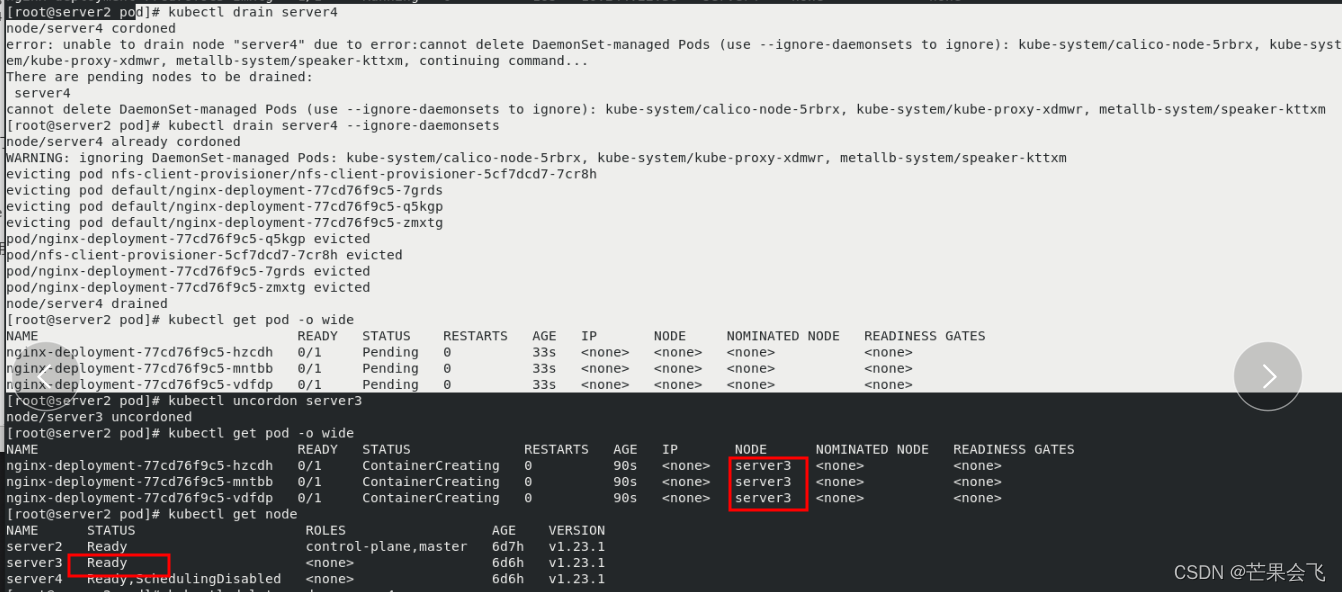
首先驱逐node上的pod,在其他节点重新创建,然后将节点调为SchedulingDisabled。
讯享网kubectl drain server4 kubectl drain server4 --ignore-daemonsets kubectl get pod -o wide 可以看到pod是pending状态,因为3禁用了,4被驱离了 kubectl uncordon server3 取消3上的禁止 kubectl get pod -o wide 现在容器都在3上 kubectl get node 3是正常状态了
delete删除
delete删除节点:
最暴力的一个,首先驱逐node上的pod,在其他节点重新创建,然后,从master节点删除该node,master失去对其控制,如要恢复调度,需进入node节点,重启kubelet服务
kubectl delete nodes server4 kubectl get node 没有4了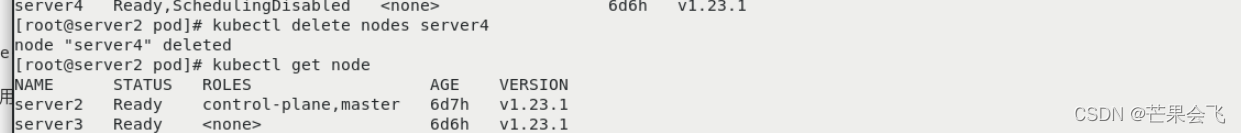
server4连接集群
讯享网systemctl restart kubelet

server2
kubectl get node 4又回来了 kubectl get pod -n kube-system kubectl delete -f deploy.yml 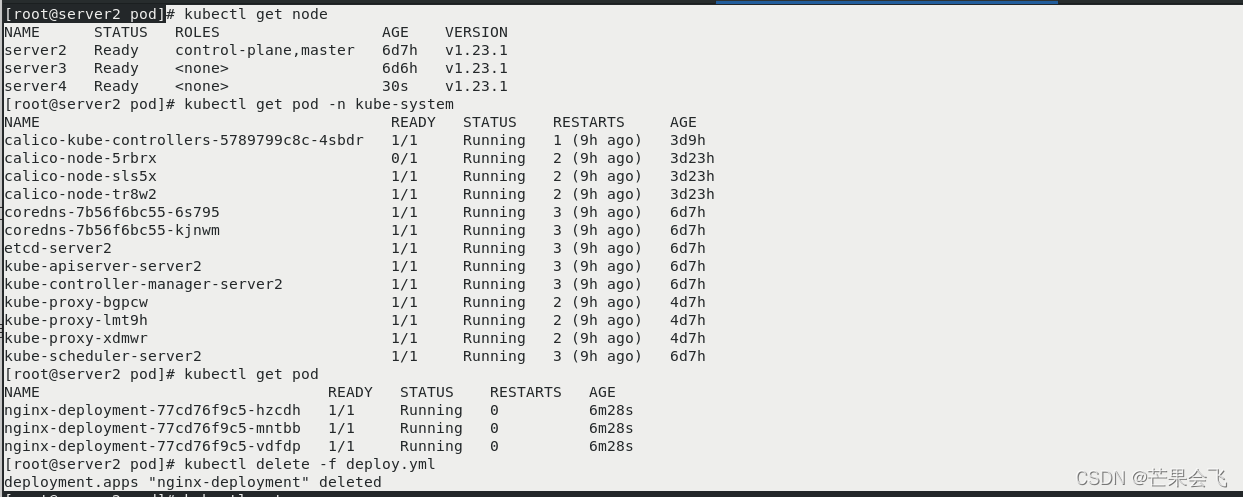
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/76865.html