
Python爬取武汉店铺出租转让信息
- 爬虫第一步是找网站,找规律
这里我选择的 今天信息网

讯享网
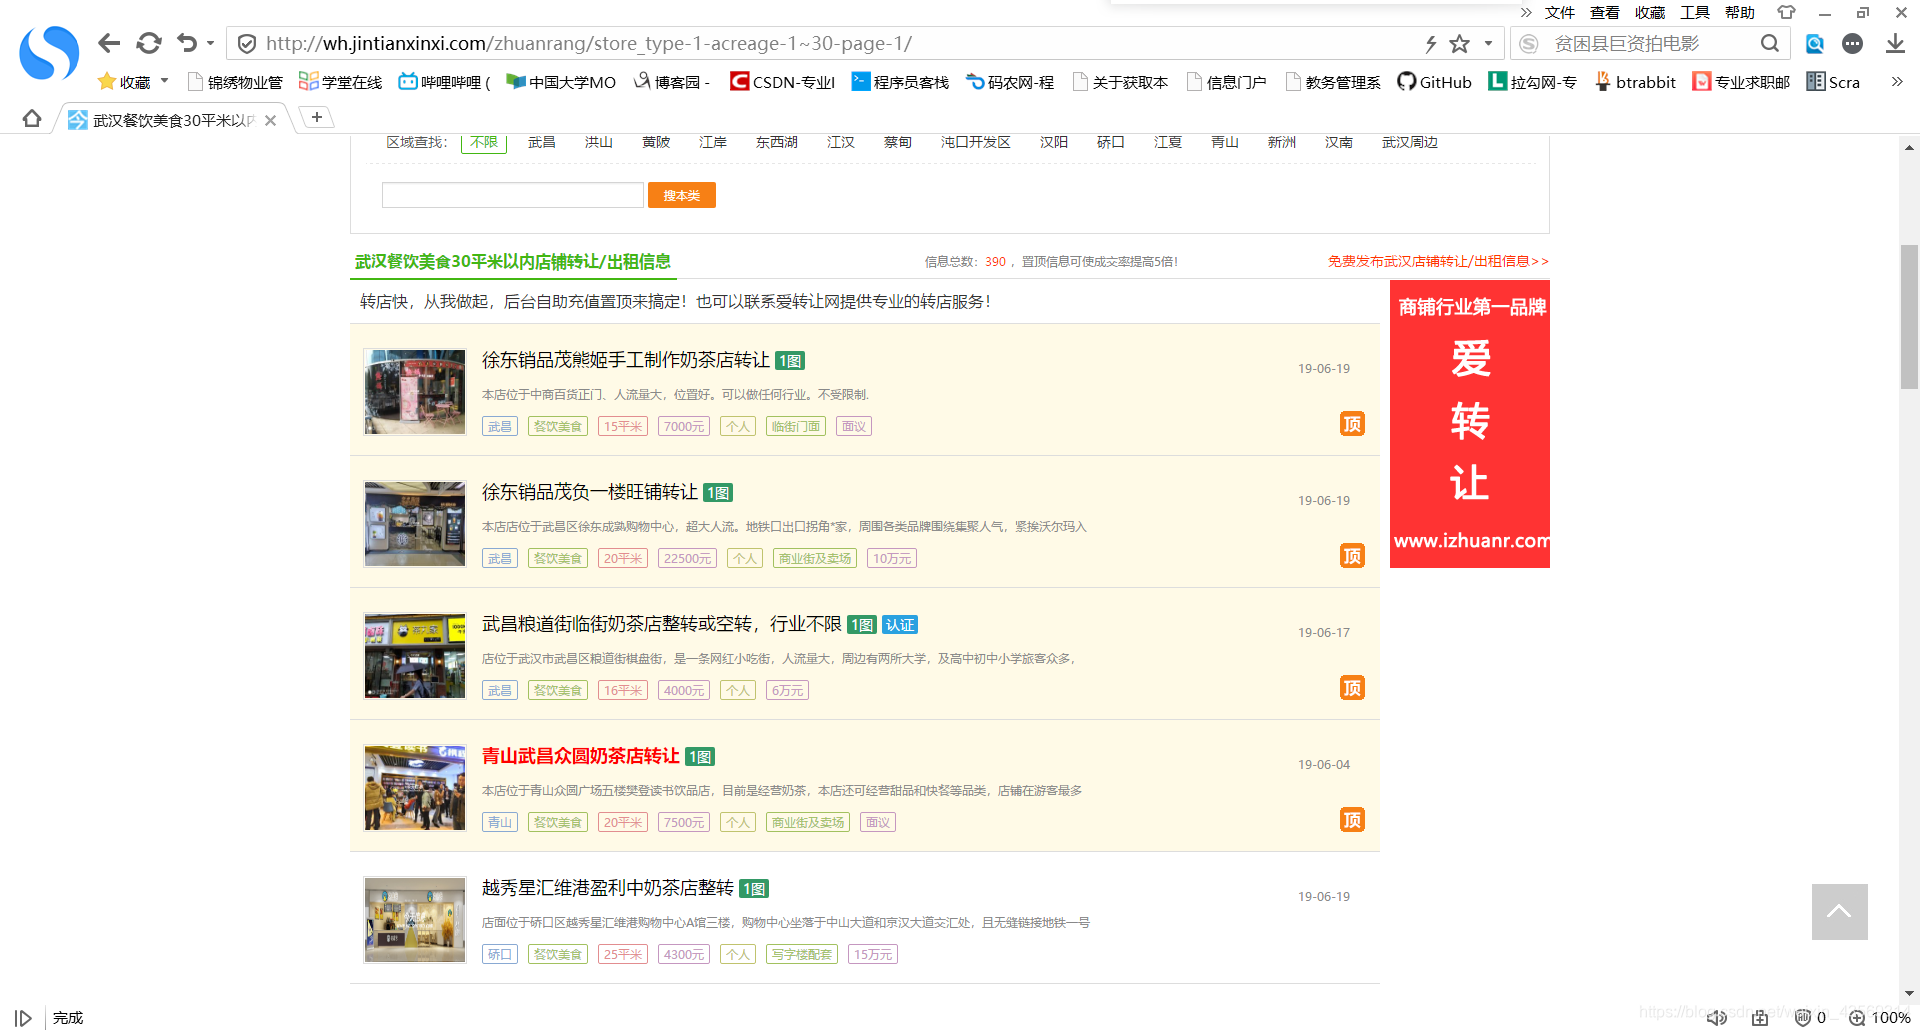
分析其url不难发现其中包含了许多的信息,url:http://wh.jintianxinxi.com/zhuanrang/store_type-1-acreage-1~30-page-1/
一共有390条信息,他们不可能把390条信息放在一张网页上,于是分成了15页
其中的 page-1 为我们很好的指明了方向
这样就可以很容易的通过循环完成对15个网页的信息爬取 - 解析数据用的是 BeautifulSoup 的 selec() 函数
其具体操作流程如下:
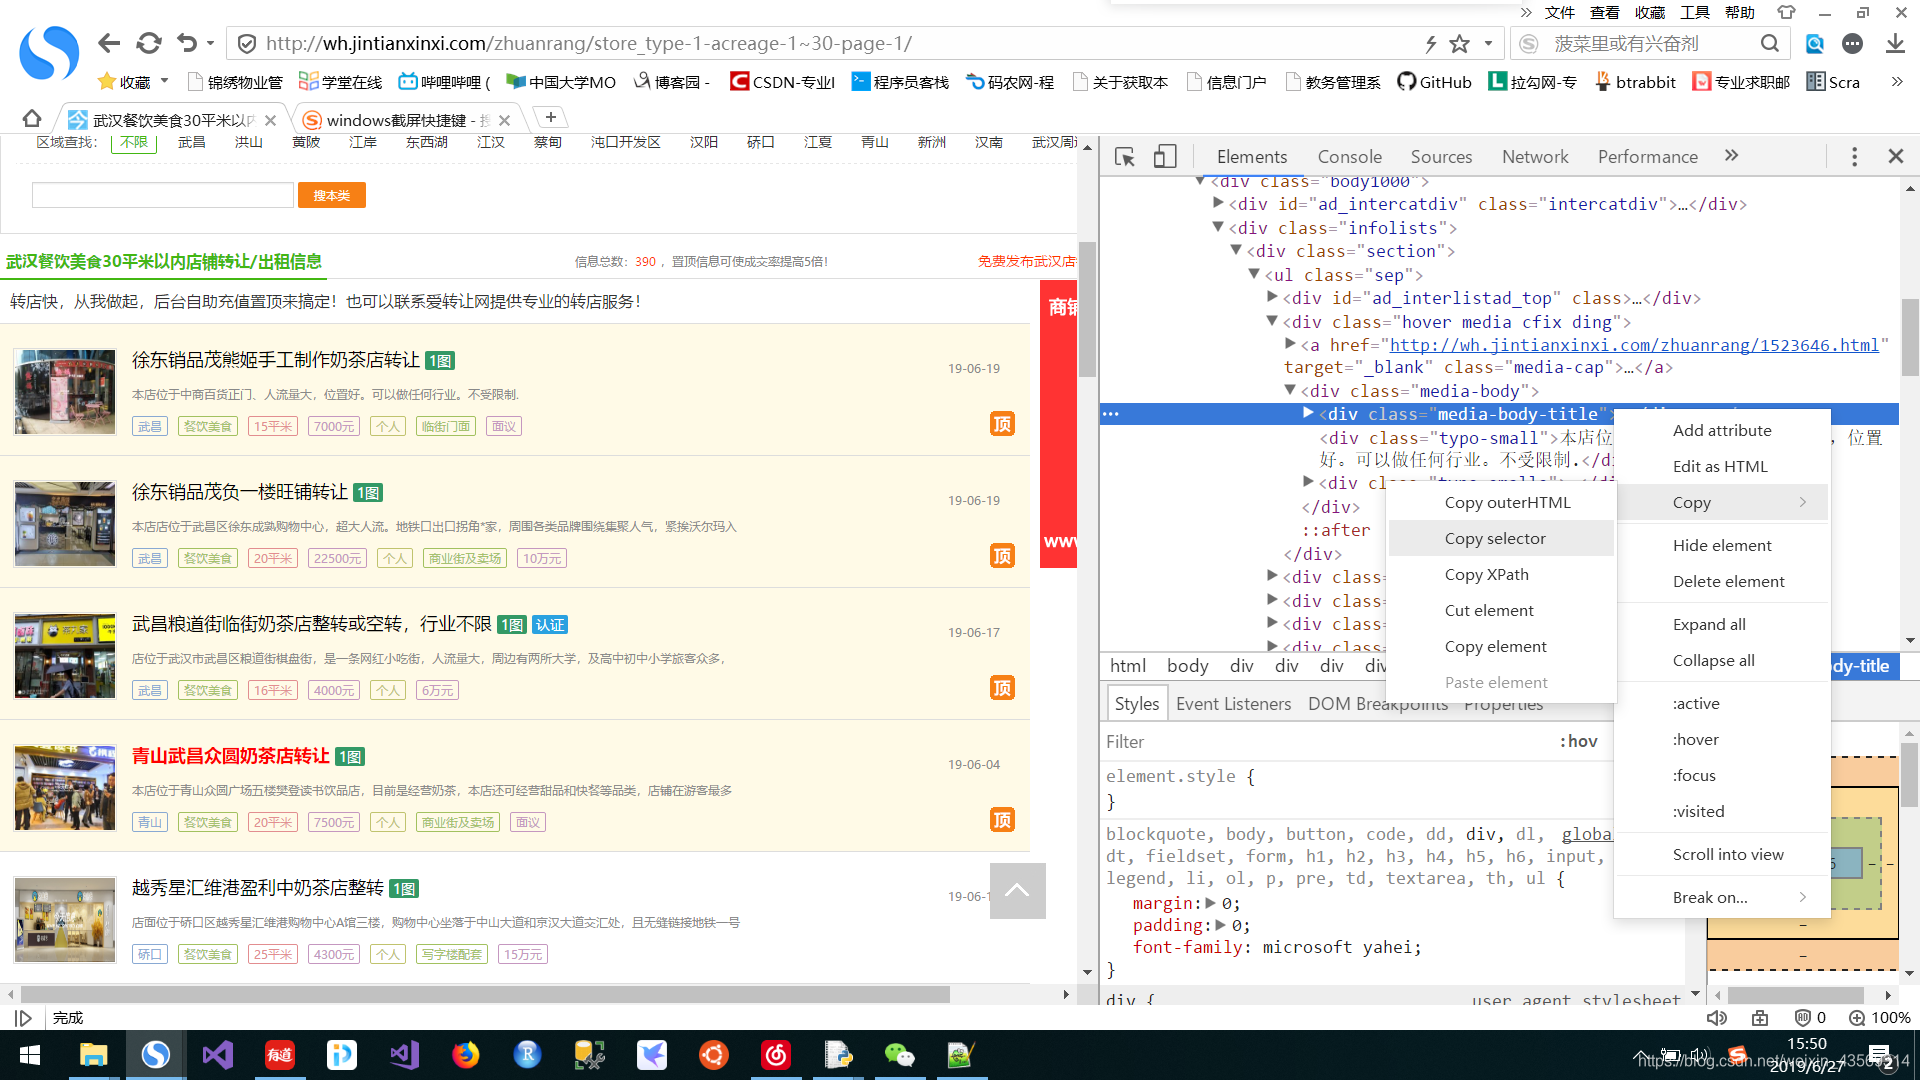
选取需要的信息,审查元素,然后复制选择器
第二步就是将该字符串作为 selec() 函数的传递参数了,具体可以参考
https://blog.csdn.net/amao1998/article/details/
讲解的还是比较细致 - 以 json 格式保存数据,先将数据以 字典 的格式进行存储,然后转化成 json 格式,以追加的形式打开文件,进行写入。
附上源码:
import requests from bs4 import BeautifulSoup import json #避免解析出来的信息为空,从而抛出错误 def transText(text): if text!=[]: text=text[0].getText() else: text = '' return text #以json格式保存数据 def save_info(info): with open("商铺信息.json",'a',encoding='utf-8') as f: f.write(json.dumps(info,ensure_ascii=False,indent=4)) #发出请求,粗加工返回的内容 def get_url(url,headers): response = requests.get(url, headers=headers) #通过response.apparent_encoding分析页面可能的编码方式,然后编码 response.encoding = response.apparent_encoding
    html = response.text return html

#使用BeautifulSoup解析数据 def parse_soup(html): soup = BeautifulSoup(html, 'html.parser') shop_list = soup.select('body > div.body1000 > div.bodybgcolor > div > div.body1000 > div.infolists > div.section > ul > div ') for i in range(1,len(shop_list)): shop = shop_list[i] info = {
   } info["标题"] = transText(shop.select('div > div.media-body-title > a')) info["简介"] = transText(shop.select('div > div.typo-small')) info["地区"] = transText(shop.select('div > div.typo-smalls > font.xx1')) info["类型"] = transText(shop.select('div > div.typo-smalls > font.xx2')) info["面积"] = transText(shop.select('div > div.typo-smalls > font.xx3')) info["租金"] = transText(shop.select('div > div.typo-smalls > font.xx4')) info["位置"] = transText(shop.select('div > div.typo-smalls > font.xx6')) info["转让费"] = transText(shop.select('div > div.typo-smalls > font.xx7')) save_info(info) if __name__ == "__main__": headers = {
   'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'} for j in range(1,16): print('*第{}页*'.format(j)) url = "http://wh.jintianxinxi.com/zhuanrang/store_type-1-acreage-1~30-page-{}/".format(j)
        html = get_url(url,headers) parse_soup(html) print("OVER!")
讯享网
最终效果图:

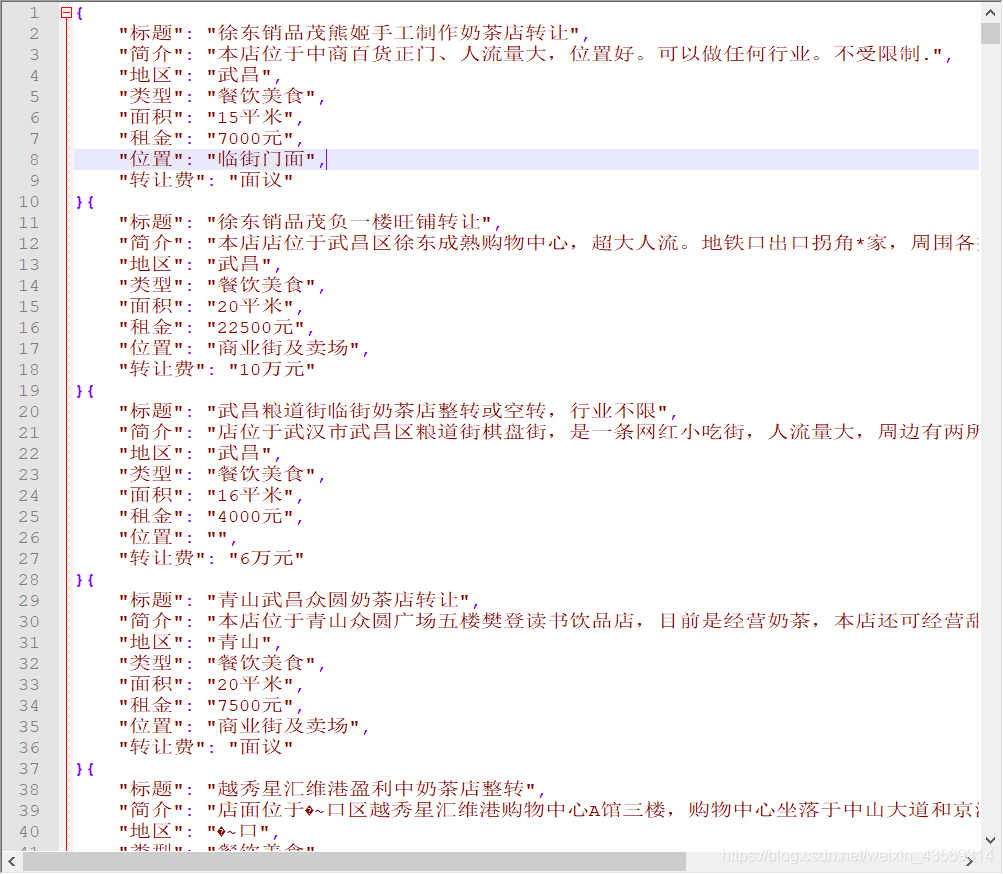
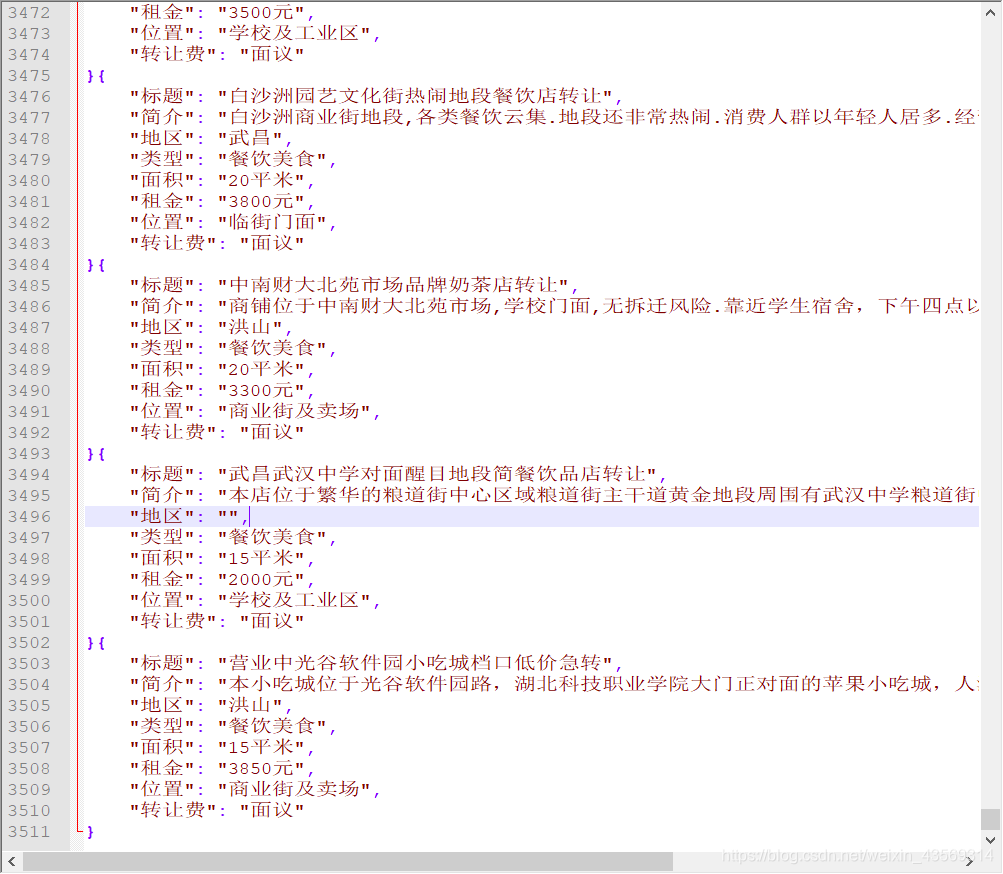
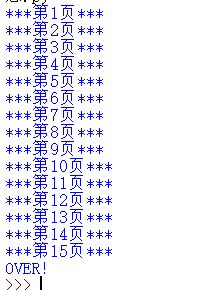
一共390条信息,一条信息占据9行,390*9=3510,至此,所有信息采集完成,完结撒花~
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/76572.html