
在数据分析和数据挖掘以及搜索引擎中,我们经常需要知道个体间差异的大小,进而评价个体的相似性和类别。常见的比如数据分析中比如相关分析,数据挖掘中的分类聚类(K-Means等)算法,搜索引擎进行物品推荐时。
相似度就是比较两个事物的相似性。一般通过计算事物的特征之间的距离,如果距离小,那么相似度大;如果距离大,那么相似度小。比如两种水果,将从颜色,大小,维生素含量等特征进行比较相似性。
问题定义:有两个对象X,Y,都包含N维特征,X=(x1,x2,x3,……..,xn),Y=(y1,y2,y3,……..,yn),计算X和Y的相似性。常用的有五种方法,如下。
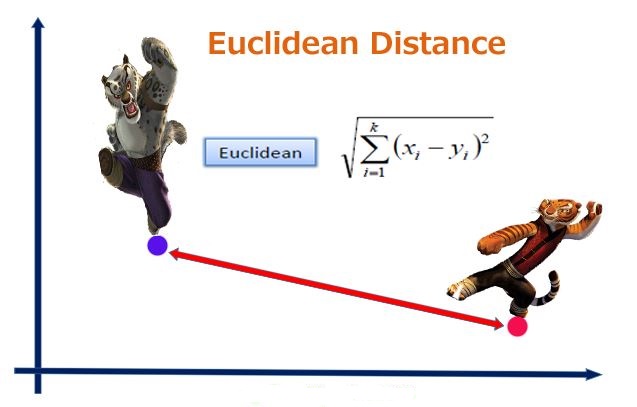
1、欧几里得距离(Eucledian Distance)
欧氏距离是最常用的距离计算公式,衡量的是多维空间中各个点之间的绝对距离,当数据很稠密并且连续时,这是一种很好的计算方式。
讯享网
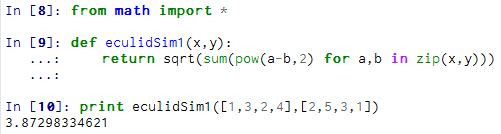
代码:
2、曼哈顿距离(Manhattan Distance)
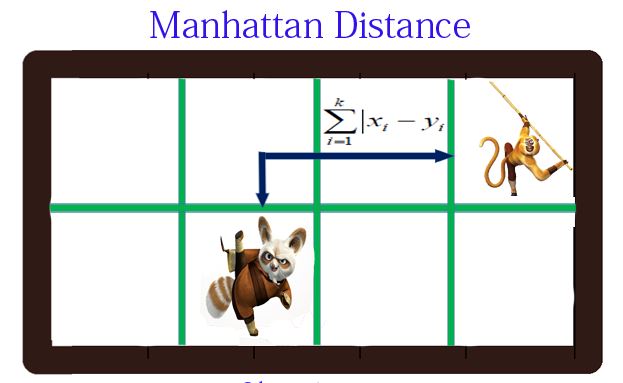
Manhattan distance = |x1 – x2| + |y1 – y2|,p1 at (x1, y1) and p2 at (x2, y2).
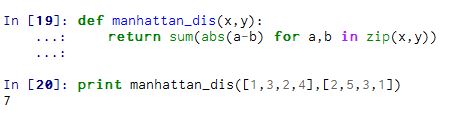
代码:
3、明可夫斯基距离(Minkowski distance)
公式:
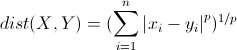
从公式我们可以看出,
- 当p==1,“明可夫斯基距离”变成“曼哈顿距离”
- 当p==2,“明可夫斯基距离”变成“欧几里得距离”
- 当p==∞,“明可夫斯基距离”变成“切比雪夫距离”
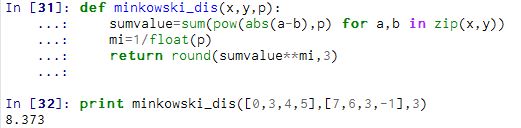
代码:
4、(余弦相似度)Cosine Similarity
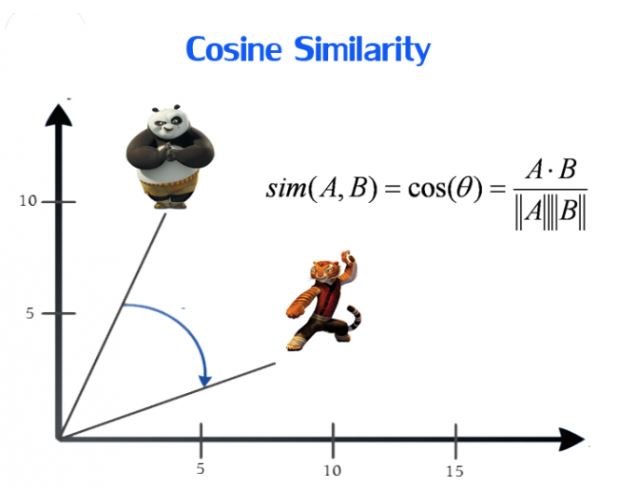
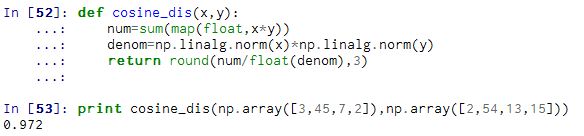
代码:
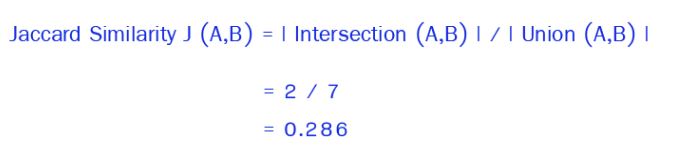
5、Jaccard Similarity
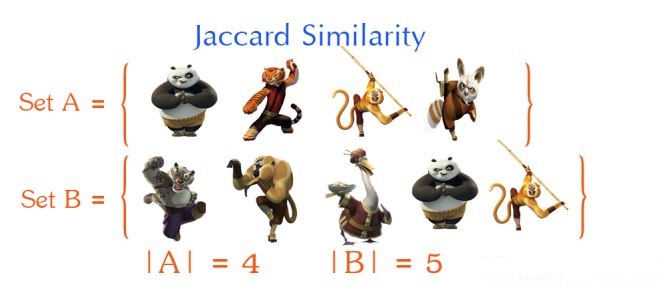
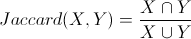
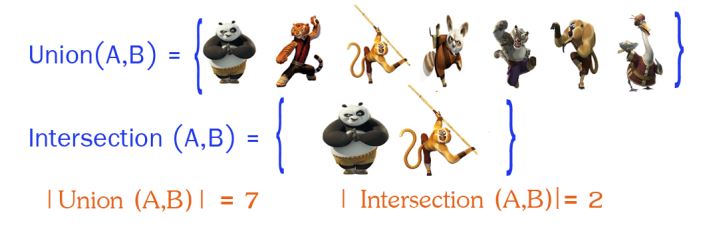
然后利用公式进行计算:
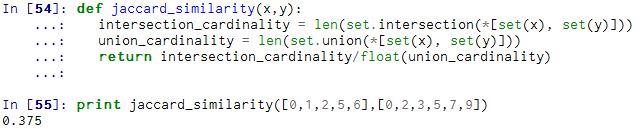
代码:
六、皮尔森相关系数(Pearson Correlation Coefficient)
又称相关相似性,通过Peason相关系数来度量两个用户的相似性。计算时,首先找到两个用户共同评分过的项目集,然后计算这两个向量的相关系数。
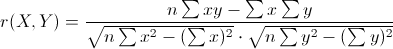
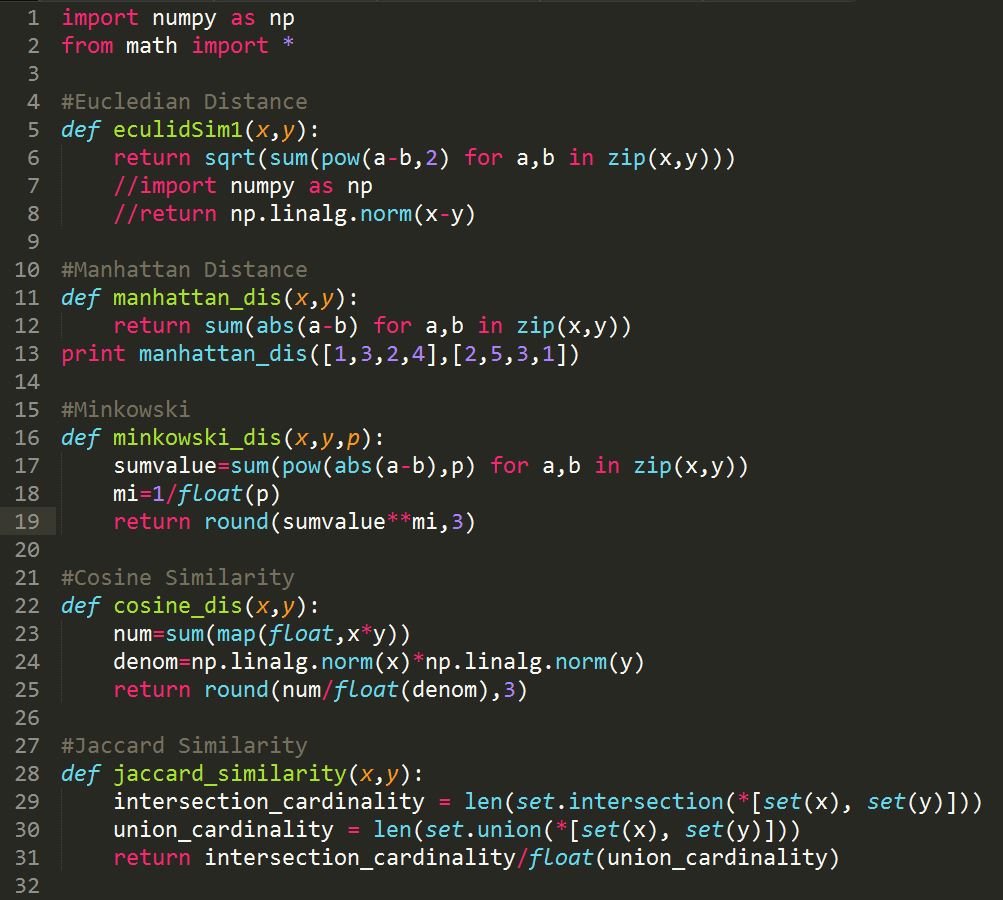
实现汇总:
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/75985.html