

讯享网
title
Third Time’s the Charm? Image and Video Editing with StyleGAN3
author
Yuval Alaluf
Link
论文地址
Code

作者研究分析了Stylegan3的结构,并与之前的结构进行比较,调查了其独特的优点和缺点。通过实验证明了:虽然Stylegan3可以用未对齐的数据训练,但仍然可以使用对齐的数据训练,而且不会妨碍模型生成未对齐图像的能力。
作者通过在Stylegan3 不同潜空间的解耦分析,发现Stylegan3下的 W/W+ 空间比 Stylegan2 对应的空间更纠缠,由此提出了使用 StyleSpace 进行细粒度编辑的好处。(本文提出的一种潜空间)
作者发现通过未对齐的数据训练编码器时,技术会遇到困难。作者实验发现:即使单独训练对齐数据,仍然可以反转未对齐的图像。最后,作者引入了一种新颖的视频反转和编辑工作流程,它利用finetuned的Stylegan3 生成器的功能来减少纹理粘连并扩展已编辑视频的视野。
Stylegan3结构分析

在mapping network部分,并无变化,通过全连接网络将初始latent code z ~N(0,1) [512] 转换成w,并加入可学习的latent space W。
与Stylegan2相比,Stylegan3的synthesis network由固定数量的卷积层构成,与输出图像分辨率无关。Stylegan2中的constant 4*4被傅里叶特征(Fourier feat)取代,其中四个参数(sin a , cos a , x , y)通过学习仿射层从w0获取。在剩下的层中,每个wi被送入一个独立的学习仿射层,产生的modulation factors用来调整卷积核权重。
在Stylegan2中,这些仿射层输出所跨越的空间被称为StyleSpace(S空间),本文中我们类似地定义了Stylegan3的S空间。
由于生成图像的平移、旋转是由w0中特定参数控制得到,所以很容易通过一些其他的变换来生成结果。作者提出了一种transformation:
y = G ( w ; ( r , t x , t y ) ) y = G(w;(r,t_{x},t_y)) y=G(w;(r,tx,ty))
它甚至可以应到到仅由aligned data训练的生成器中,使其可以生成平移或旋转的图像。
而相对的,在unaligned data训练的生成器,可以将w0设置成平均latent code w,来强制生成大致对齐的图像。作者认为这可能由于以下原因:(1)训练的数据分布中平均姿态大致对齐和居中(2)Stylegan3中的平移和旋转变换主要由第一层控制,而Stylegan3设计的核心是等方差性:早期层的平移或旋转会被保留,然后在结果中才出现。(所以才会大致对齐)
Analysis
Rotation Control
作者进行了一系列实验,发现只改变w1时,会影响最终生成的图像的旋转情况,而当固定w0和w1时,最终生成的图像都具有相同的头部姿势。因此作者认为平移和旋转主要有w0和w1控制,后续层不会进一步影响。
Disentanglement Analysis
作者同样进行了一些实验,发现了在Stylegan3中S空间更加解纠缠。
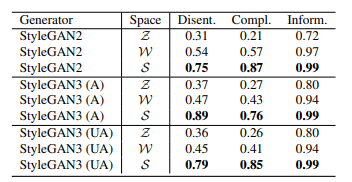
Image Editing
作者实验了在不同潜空间编辑的效果(w / w+ / s)

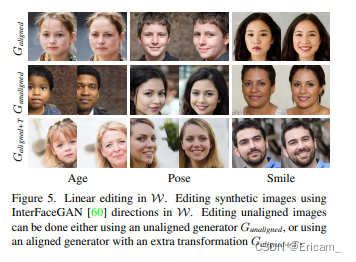
在w空间,作者使用Interfacegan来寻找linear directions,对于aligned数据,编辑过程和Stylegan2很类似,而对于unaligned数据,作者提出了两种方法:
(1)使用在aligned数据上预训练的属性分类器来寻找unaligned数据属性的directions,但这样会存在一些问题,比如分类器在unaligned数据上得分可能不准确,导致生成的directions没效果,同时如果使用unaligned生成器,可能会需要很多独立的directions集合。
(2)使用aligned生成器来生成数据,然后使用一些用户定义的transformations来完成平移和旋转。
实验发现:(1)通过在aligned数据训练的分类器,在unaligned数据中分类分数不够准确,导致伪对齐的图像始终处于域外(2)编辑线性空间方向很难解纠缠
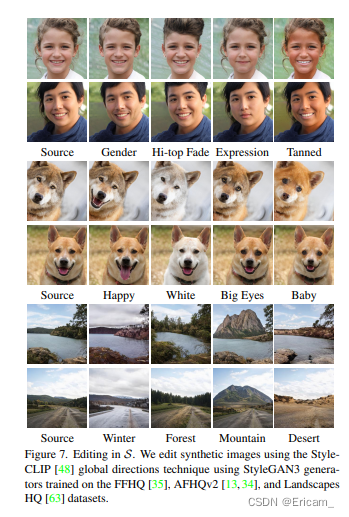
在w+空间,之前的一些工作证明了在w+空间非线性编辑会产生更加真实、令人信服的解纠缠的图像,作者使用了StyleClip进行实验,发现在Stylegan3中表现不好,仍然无法很好的解纠缠。

基于以上原因,作者开始探索S空间,并发现S空间相较于W、W+空间解纠缠。
Stylegan3 Inversion
Designing the Encoder Network
为了能够encoding aligned and unaligned数据,反演策略必须支持这两种输入类型。
如何encoding unaligned images?
作者选择利用在aligned data上训练的生成器来设计一个仅在aligned data上训练的encoder。如上文所示,这种方案可用于编辑和生成aligned and unaligned图像。而且,利用这种方案,编码器不需要正确捕获unaligned image的高度和姿势,简化了训练目标,使其可以专注于捕获输入身份和其他图像特征。
给定一个通过aligned images训练的encoder,如何扩展它使其能够encoding和editing unaligned images?假设给定一张 x u n a l i g n e d x_{unaligned} xunaligned,计算它和 x a l i g n e d x_{aligned} xaligned的平移旋转差异,生成 ( r , t x , t y ) (r,t_{x},t_{y}) (r,tx,ty),最终反演方案:
w a l i g n e d = E ( x a l i g n e d ) y u n a l i g n e d = G ( W a l i g n e d ; r ( r , t x , t y ) ) w_{aligned} = E(x_{aligned})\\ y_{unaligned} = G(W_{aligned};r(r,t_{x},t_{y})) waligned=E(xaligned)yunaligned=G(Waligned;r(r,tx,ty))
Inverting Images into StyleGAN3
作者使用了如上的反演方案来测试对比,encoder选用了 R e s t y l e p s p Restyle_{psp} Restylepsp和 R e s t y l e e 4 e Restyle_{e4e} Restylee4e。
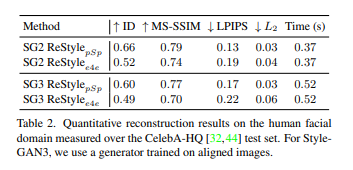
定性评价 Stylegan3 encoder和Stylegan2 encoder视觉上对应,而且Stylegan3可以忠实的再现输入位置。
定量评价 除了推理时间,加入了ID、L2距离等来做评价。Stylegan3 encoder的性能稍差。
通过潜在空间操作的可编辑性
Restyle_e4e encoder实现了真实而有意义的编辑,同时保留了输入身份,相较于Restyle_psp,重建质量更高。两者在Stylegan3之间的差距比Stylegan2要大。(观察第二行最后,psp会产生很大的伪影)

Inverting and Editing Videos
这一块不作描述,感兴趣的话可以阅读论文。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/75838.html