
一、实验目标
给定38张图像作为训练集,10张图像作为测试集。对每张测试图像,在训练集中检索出最相似的图像,按照相似度降序排名。
二、数据集概况
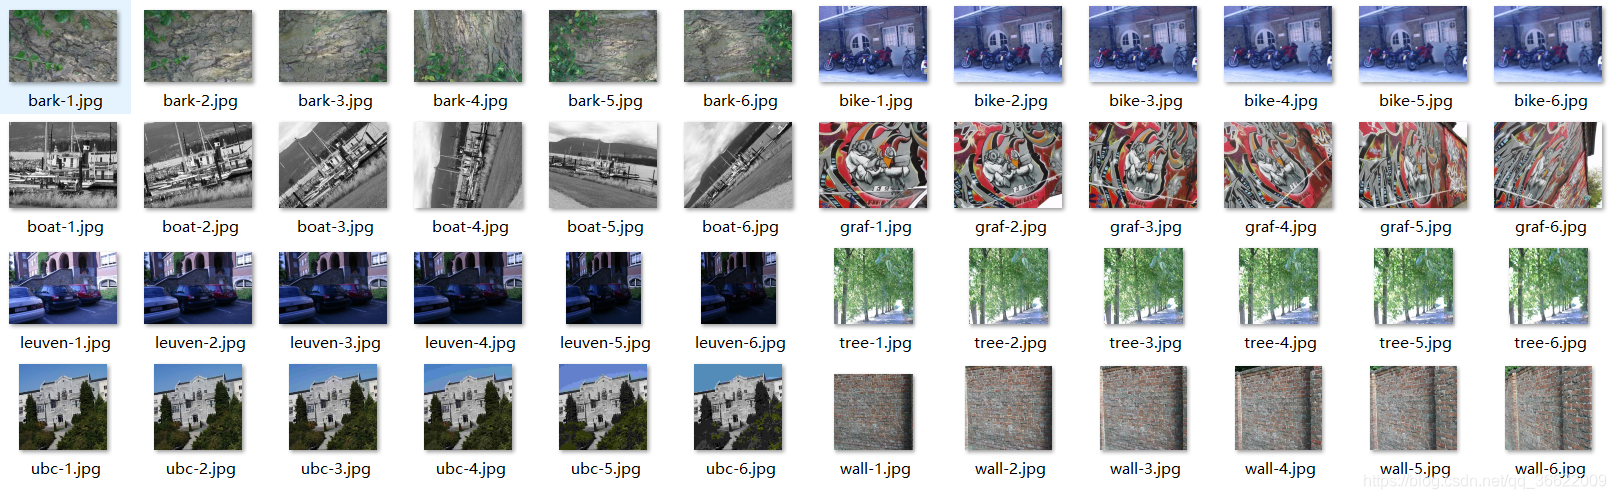
一共8组,每组6张图片。brak、boat、graf、wall组的图片经过了旋转或者由不同视角拍摄;bike组的图片经过了不同程度的模糊;leuven组的光照条件逐渐变暗;tree组的图片主要是焦点不同;ubc组的图片似乎经过了分割。将其中的38张作为训练集生成模型,随机选择10张作为测试集(比例约为20.1%)。
三、训练模型
1.用SIFT特征来表示图像。
要计算两幅图像之间的相似度,首先要用一种合适的数据形式来表示一幅图像。我们选取SIFT特征来表示图像,原因是因为它具有旋转、尺度不变特性,对数据集中经过旋转、缩放或分割处理的图像也能有较好的匹配效果。除了使用SIFT算法来提取图像特征外,还可以使用BRIEF算法、ORB算法等。不过在本次实验中还是选择基础的SIFT算法。使用Python提取SIFT特征的代码如下:
def extract_features(image_paths): sift_det = cv2.xfeatures2d.SIFT_create() imgDes_list = [] # 所有图像的所有sift descriptor的列表 for i, image_path in enumerate(image_paths): img = cv2.imread(image_path) gray = cv2.cvtColor(img, cv2.COLOR_RGB2GRAY) kp, img_des = sift_det.detectAndCompute(gray, None) # 以第一幅图像为例,kp是这幅图像的所有keypoints。img_des是这幅图像的keypoint descriptor的列表, #它的shape为(3765, 128)。即第一幅图像中提取到了3765个关键点,每个关键点对应一个描述符,而一个描述#符是一个128维的向量。 imgDes_list.append(img_des) return imgDes_list讯享网
2.使用Bag of words算法来得到visual words和visual vocabulary。
以第一幅图像为例,它的img_des的shape为(3765,128),如果行和列的个数相乘就有个数据。如果每幅图像都有几十万个数据,我们要通过这些数据来计算图像间的相似度的话,这个效率就太低了。
为了提高效率,出现了应用于图像的Bag of words算法。也就是说我们可以把一个128维的descriptor看做一个整体,算作一个visual word,每幅图像就是一个装了很多visual words的词袋。把数据集中的所有visual words集合起来放入一个词典中。假设词典中一共有n个单词,那么每幅图像就可以表示为一个n维向量,它的shape为(1,n)。每维向量代表词典中每个单词在图像中出现的频次。这样两个图像进行比较的时候数据量会小一些。但我们知道一幅图像中的visual words数量也上千了,图像数目多了之后,这个n值也会变得很庞大。在本次数据集中,得到的这个n值为。
为了进一步降低数据量,提高计算效率,我们可以使用聚类算法,把n个visual words聚类为k簇,用每一簇的中心点作为一个visual word。在本次实验中我们设置k为1000。这样每个图像就会用一个单词的统计直方图向量来表示,它的shape为(1,k)。
下面展示这部分代码:
(1)首先使用collect_all_des函数把训练集所有图像的descriptors收集起来,存入all_des这个numpy数组中,它的shape为(, 128)。
讯享网def collect_all_des(imgDes_list): all_des = imgDes_list[0] # imgDes_list的len为38。 for img_des in imgDes_list[1:]: #img_des的shape为(3765, 128) all_des = np.vstack((all_des, img_des)) # img_des垂直堆叠 return all_des # all_des的shape为(, 128)
(2)把得到的all_des聚类为k簇。在聚类算法中选择了k-means,在本实验中对k-means进行了实现,但效率太差,因此还是选择了scipy中的api进行模型训练。
def k_means_cluster(k, all_des): vocabulary, variance = kmeans(all_des, k, 1) # vocabulary是聚类中心列表,shape为(1000, 128)。 return vocabulary, variance(3)将每幅图像表示为visual words的频数统计向量
讯享网def calculate_histogram(imgDes_list, vocabulary): # 计算特征直方图向量 img_histogram_list = np.zeros((len(imgDes_list), len(vocabulary)), "float32") for i in range(len(imgDes_list)): img_words_labels, distance = vq(imgDes_list[i], vocabulary) # 使用vq函数根据聚类中心对图像的所有sift descriptors进行分类,就像贴标签 for label in img_words_labels: #图像1有3765个label。 label∈[0,1000) img_histogram_list[i][label] += 1 return img_histogram_list
3.使用tf-idf weighting优化每幅图像的词频向量。
我们可以考虑到如果有个单词在所有图像中都出现过,那么这个单词用来区别不同图像的作用就降低了。也就是说单词在数据集中出现频率越高,对检索精度的贡献度就越低。我们可以把单词在数据集中的出现频率作为一个权重,对词频向量做一次处理。
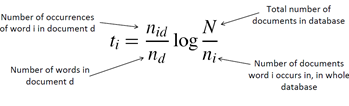
此外,查看每幅图像关键点的数量,可以发现差别是非常大的,这会导致图像的词频向量的数值差别也比较大,因此考虑对词频向量归一化后再进行比较。

具体代码如下:
def idf_and_norm(img_histogram_list): words_occurrences = np.sum((img_histogram_list > 0) * 1, axis=0) # 求出每个word在所有图片中出现的频数 idf = np.array(np.log((1.0 * len(img_histogram_list) + 1) / (1.0 * words_occurrences + 1)),'float32') img_book_list = img_histogram_list * idf img_book_list = preprocessing.normalize(img_book_list, norm='l2') # 归一化 return idf, img_book_list处理完毕后,就可以把img_book_list保存成模型了。查询时,将处理过的图像词频向量与模型中的词频向量进行比较,根据相似度排名给出结果即可。
四、模型测试
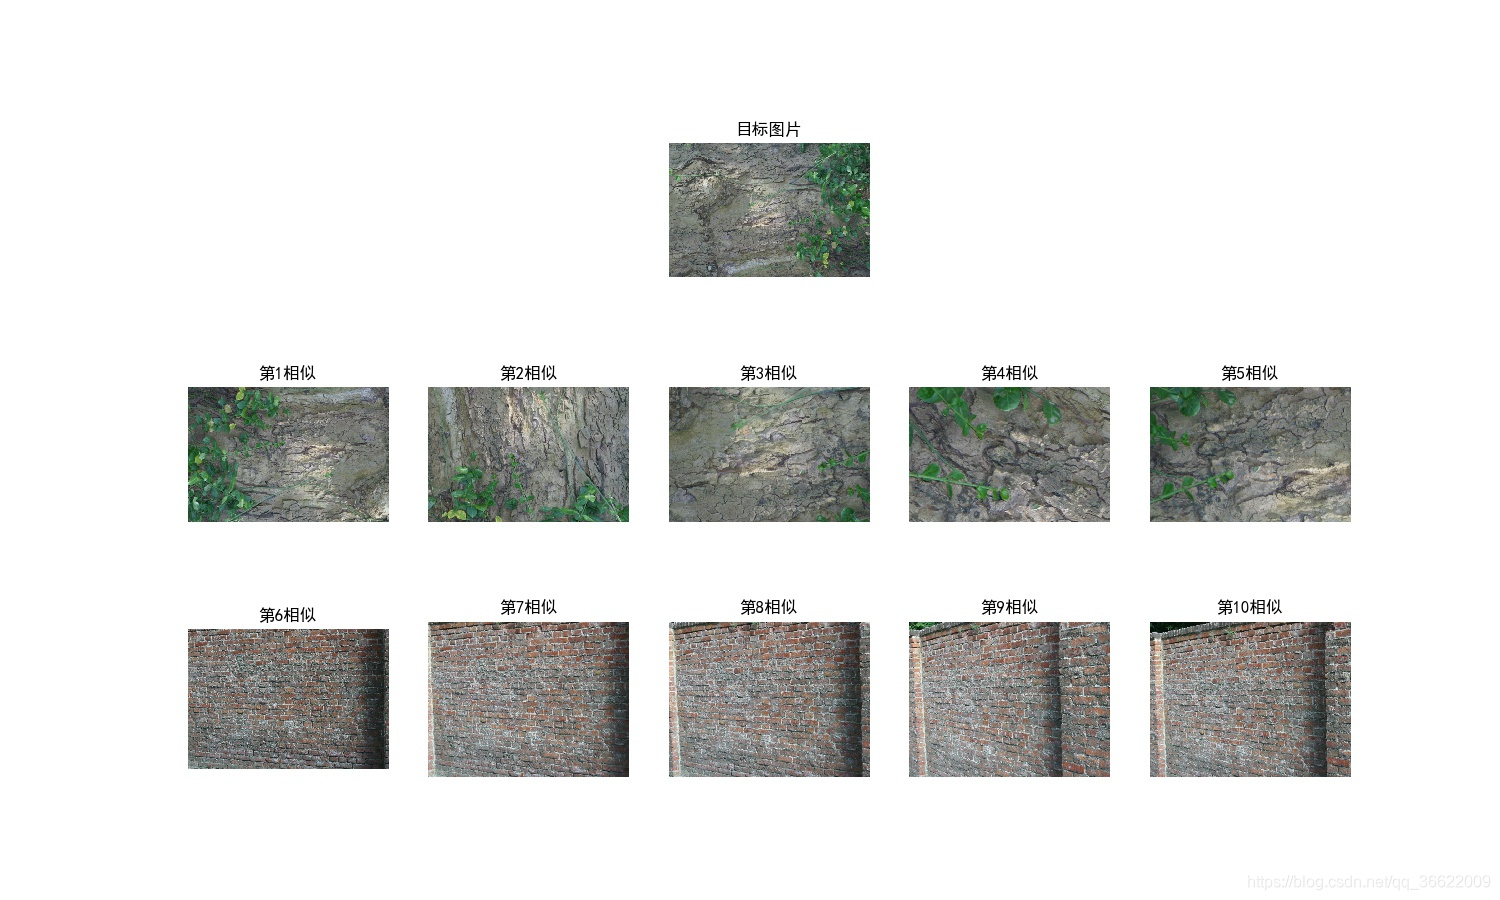
对测试集中的十张图像逐一测试,将得到的结果图像保存在queryResult文件夹中。在这里以第一幅测试图像的结果做个说明:如图所示,列出了与目标图像相似的10个结果。其中正确的有前5张图像,同时也是全部的5张图像。
根据如下公式,计算平均presion和recall。
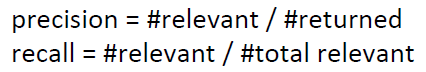
将 10张查询图像的precision和recall都求出来后再求平均,得到的结果是:
| 图像index |
returned |
relevant |
total relevant |
precision |
recall |
| 1 |
10 |
5 |
5 |
50% |
100% |
| 2 |
10 |
3 |
5 |
30% |
60% |
| 3 |
10 |
4 |
4 |
40% |
100% |
| 4 |
10 |
4 |
4 |
40%
|
100% |
| 5 |
10 |
5 |
5 |
50% |
100% |
| 6 |
10 |
5 |
5 |
50% |
100% |
| 7 |
10 |
5 |
5 |
50% |
100% |
| 8 |
10 |
4 |
4 |
40% |
100% |
| 9 |
10 |
4 |
4 |
40% |
100% |
| 10 |
10 |
5 |
5 |
50% |
100% |
| Average |
|
|
|
44% |
96% |
参考
1.图像检索:BoW图像检索原理与实战
2.lucifer726/bag-of-words-
3.上课ppt
4.数据集来源:http://www.robots.ox.ac.uk/~vgg/data/affine/
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/75231.html