
一、ES基本概念
1.1 文档
Es是面向文档得,文档是所有可搜索的最小单位
日志文件中的日志项
一本电影具体信息/一张唱片相信信息
MP3播放器里的一首歌/一篇PDF文档中的具体内容
文档被序列化为JSON格式,保存到ES中
JSON对象由字段组成,
每个字段都有对应的字段类型(字符串/数值/布尔/日期/二进制/范围类型)
每个文档都有一个Unique ID
可以自己指定ID
或者选自ES自动生成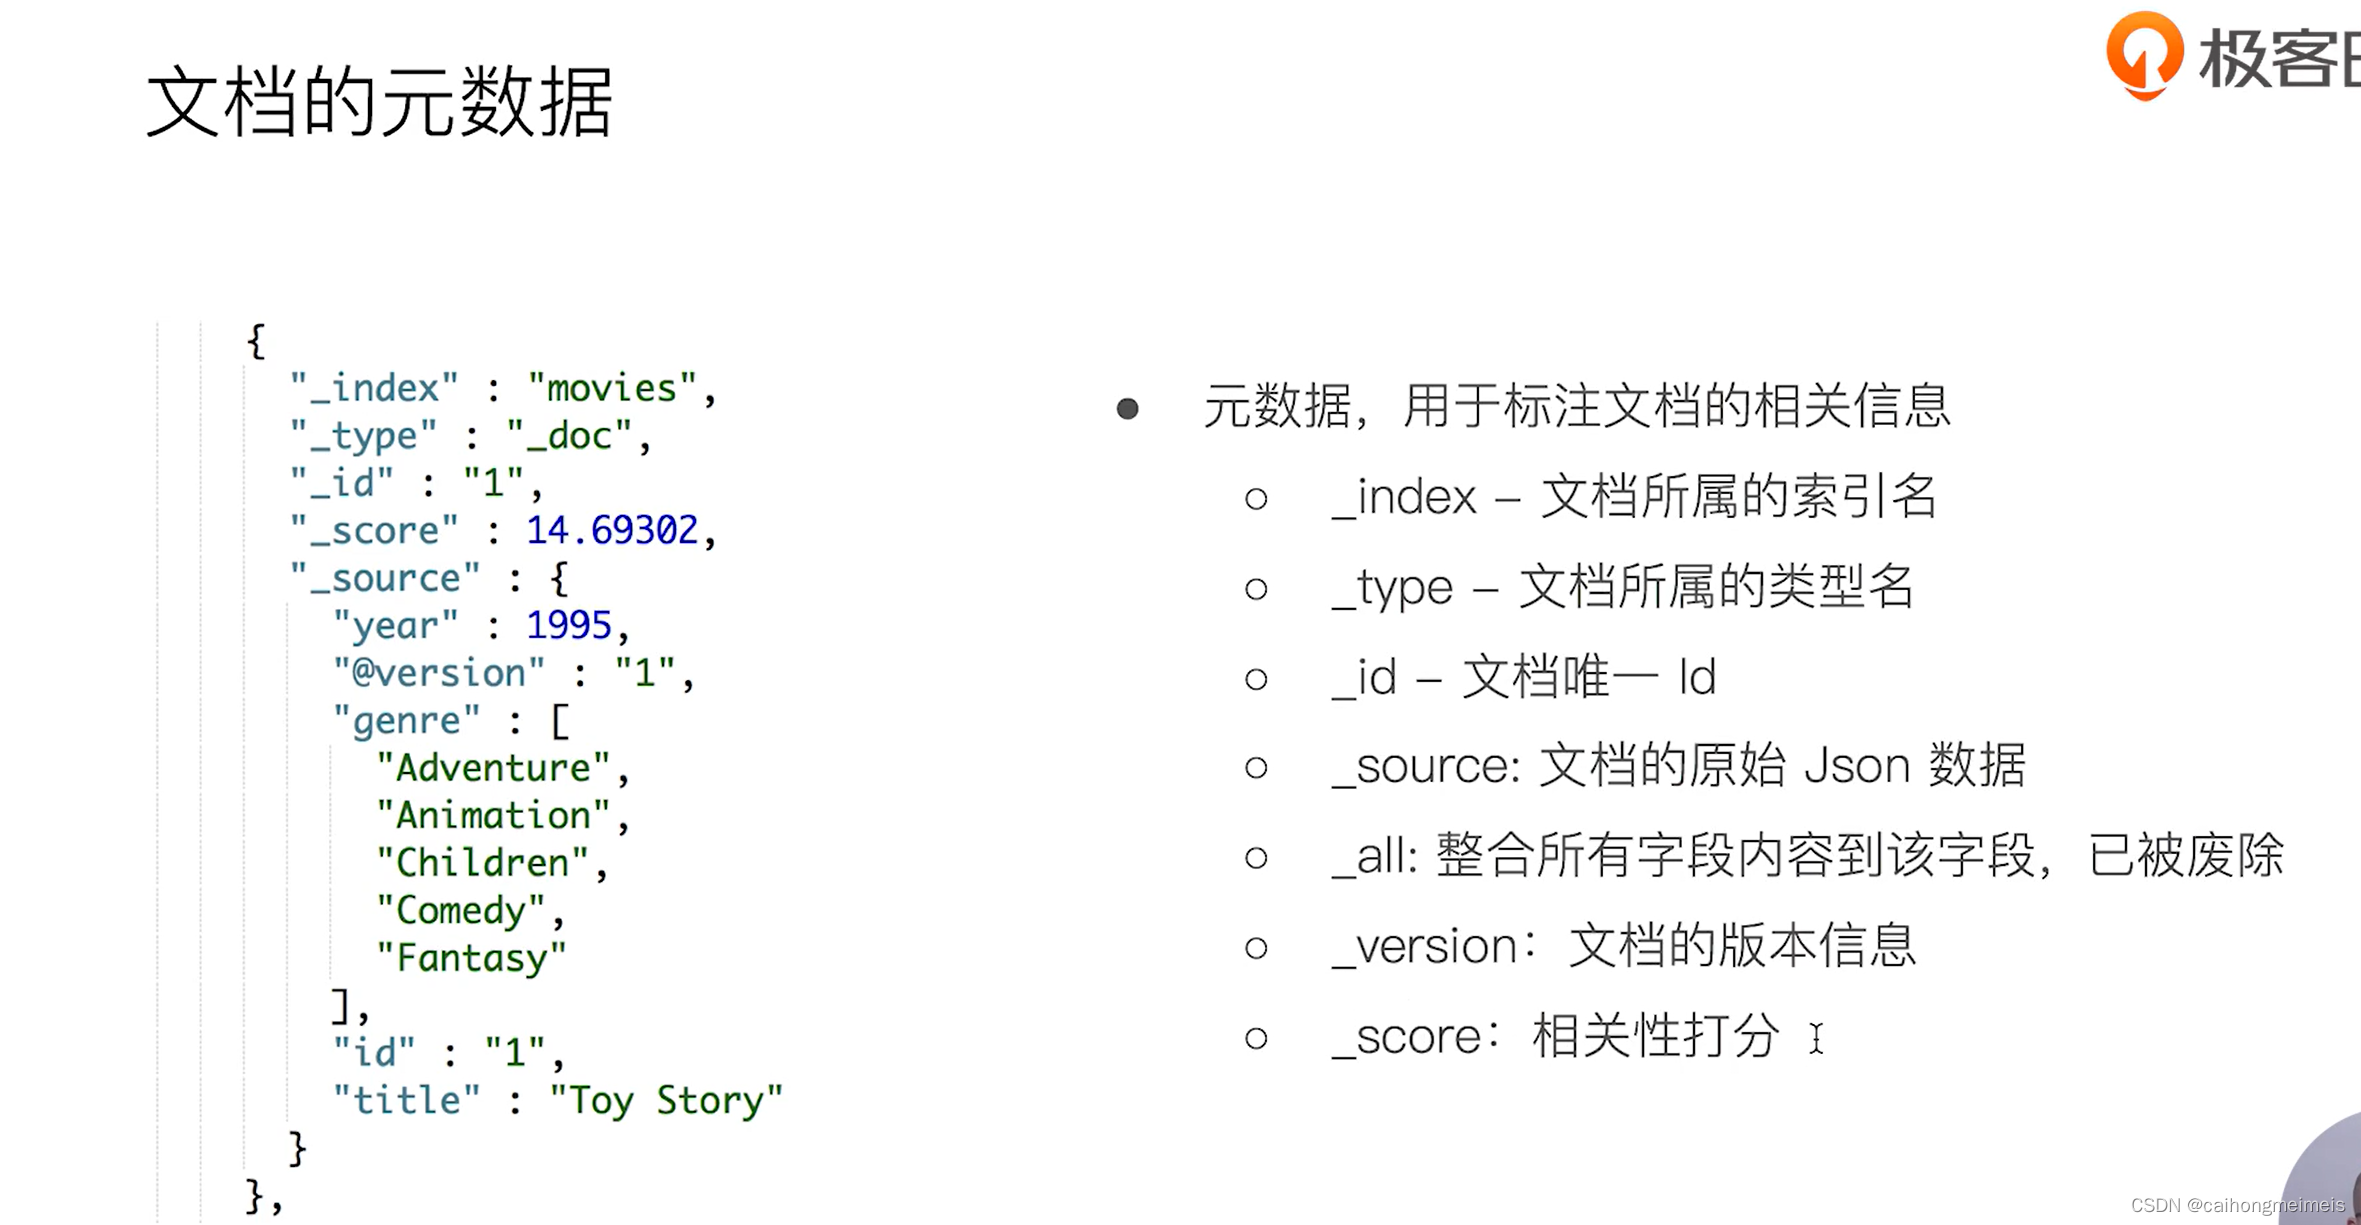
讯享网
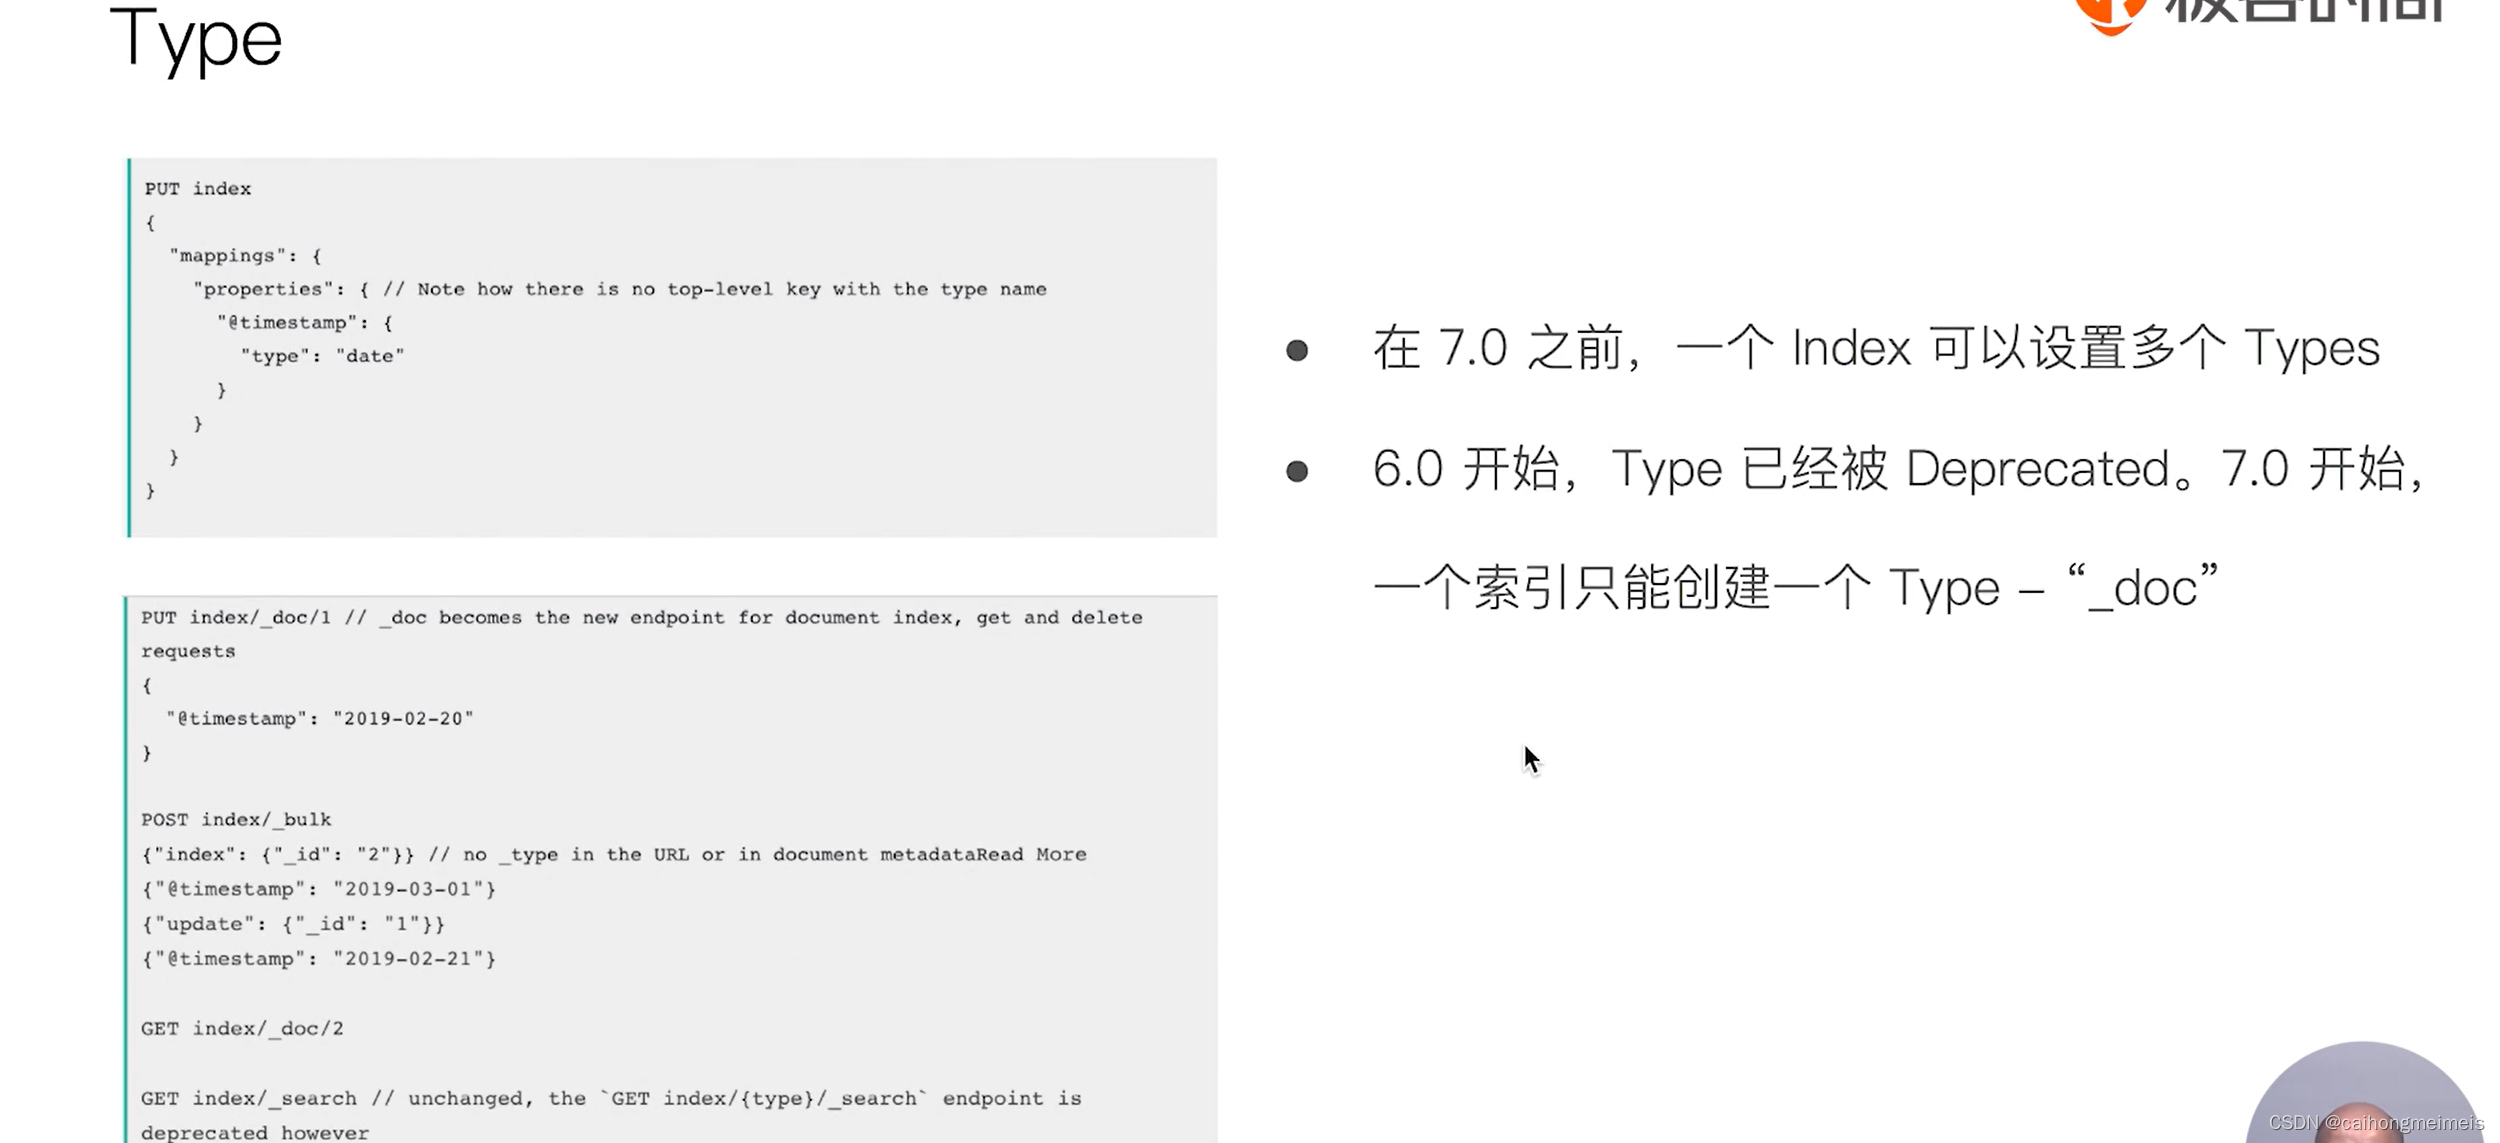
1.2 索引

索引类型
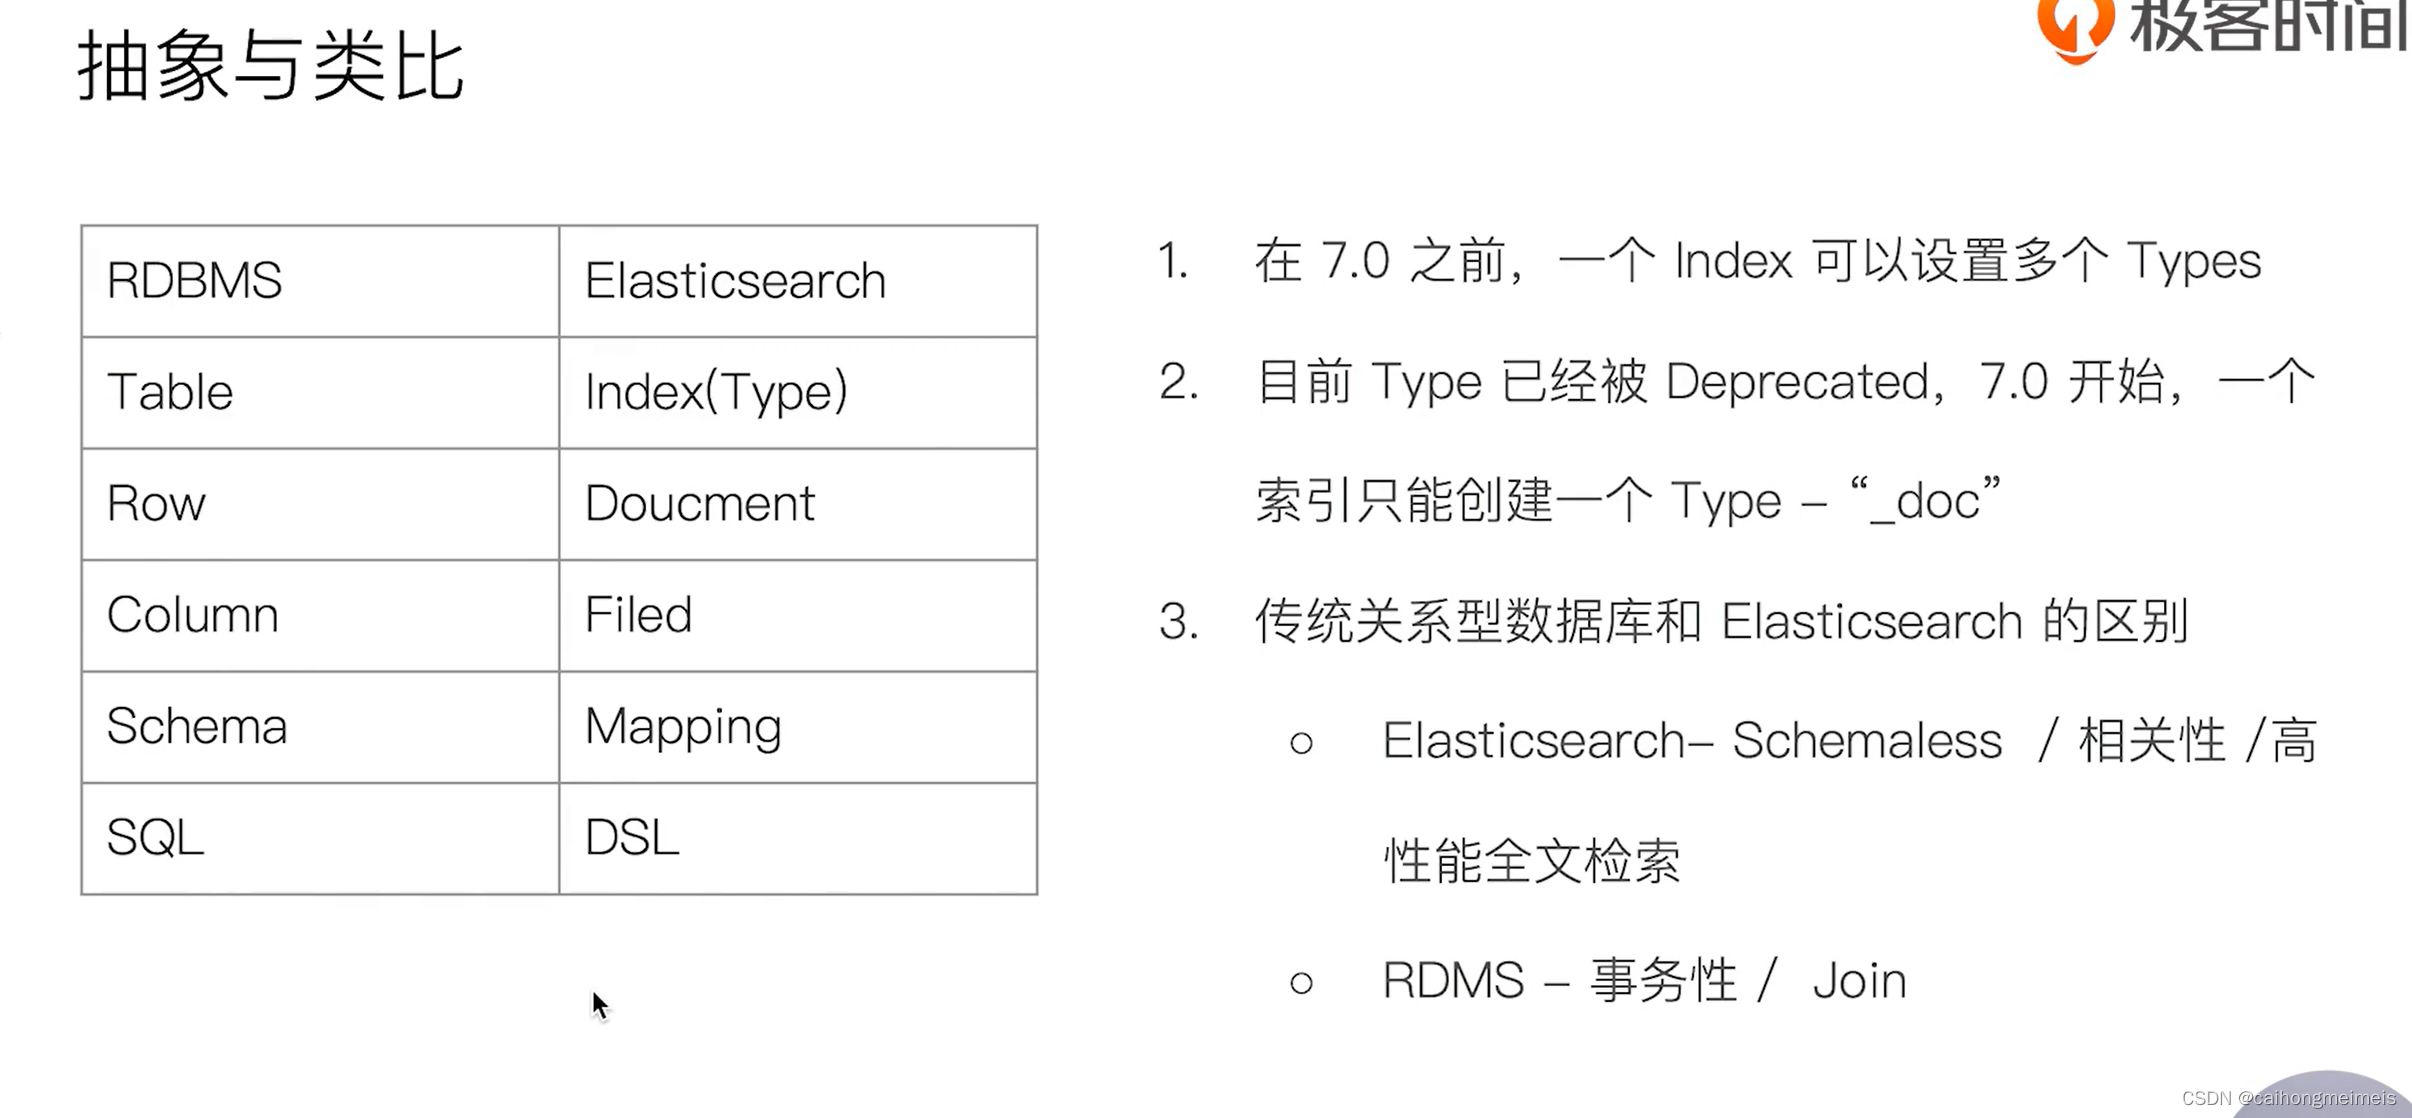
关系型数据库与ES对比
二、节点、集群、分片和副本
2.1 节点
节点是一个ES实例
本质上就是一个JAVA进程
一台机器上可以运行多个ES进程,但是生产环境一般建议一台机器上只运行一个ES实例
每个节点都有一个名字,通过配置文件配置,或者启动时候 -E node.name=node1 指定
每一个节点启动之后,会分配以一个UID,保存在data目录下
2.2 Master-eligible nodes 和 Master Node
每个节点启动后,默认是一个Master eligible 节点
可以设置 node.master: false 禁止
Master-eligible 节点可以参加选主流程,成为Master节点
当第一个节点启动的时候,他会将自己选举成Master节点
每个节点上都保存了集群的状态,只有Master节点才能修改集群状态信息
集群状态(Cluster State),维护一个集群中,必要的信息
所有的节点信息
所有的索引和其相关的Mapping与Setting信息
分片的路由信息
任意节点都能修改信息会导致数据的不一致性
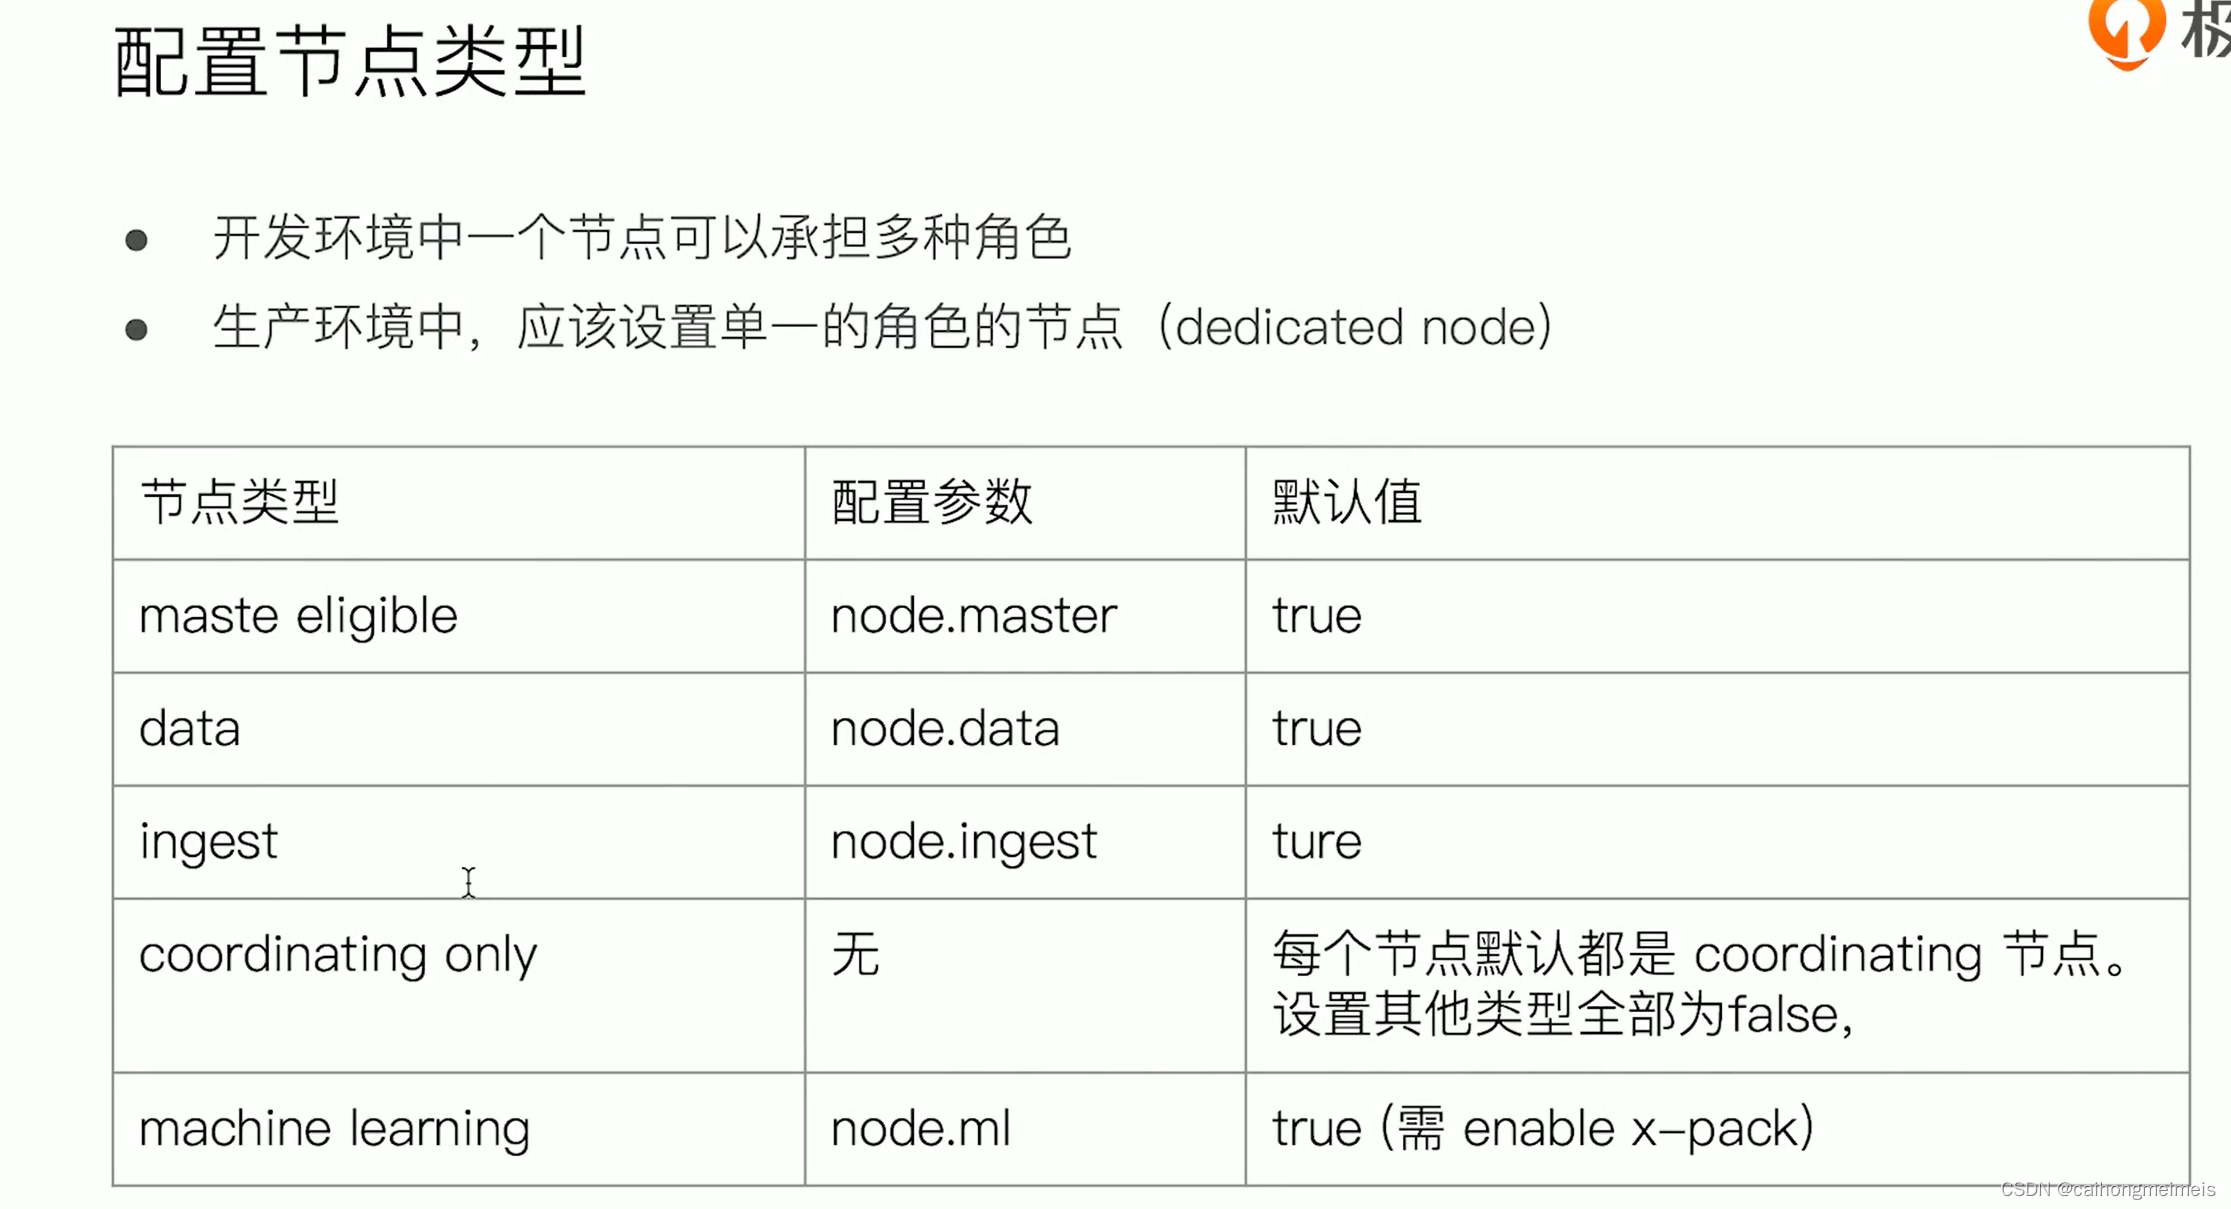
2.3 节点类型,Data Node & Coordinating Node
Data Node
可以保存数据的节点,叫做 Data Node。负责保存分片数据。
Coordinating Node
负责接收Client的请求,将请求转发到合适的节点,最终把结果汇聚到一起
默认每个节点都是Coordinating Node
其他节点类型
Hot & Warm Node
不同硬件配置的Data Node,用户实现Hot & Warm架构,降低集群部署成本。
Machine Learning Node
负责跑机器学习的Job,用来做异常检测
Tribe Node
Tribe Node 连接到不同的ES集群,并且支持将这些集群当成一个单独的集群部署
配置节点类型
分片(Primary Shard & Replica Shard)
主分片,用以解决数据水平扩展的问题。通过主分片,可以将数据分布到集群内的所有节点之上
一个分片是一个运行的lucene的实例
主分片数在索引创建时指定,后续不允许修改,除非Reindex
副本,用以解决数据高可用问题。分片是主分片的拷贝
副本分片数,可以动态调整
增加副本数,还可以在一定程度上提高服务的可用性(读取的吞吐)
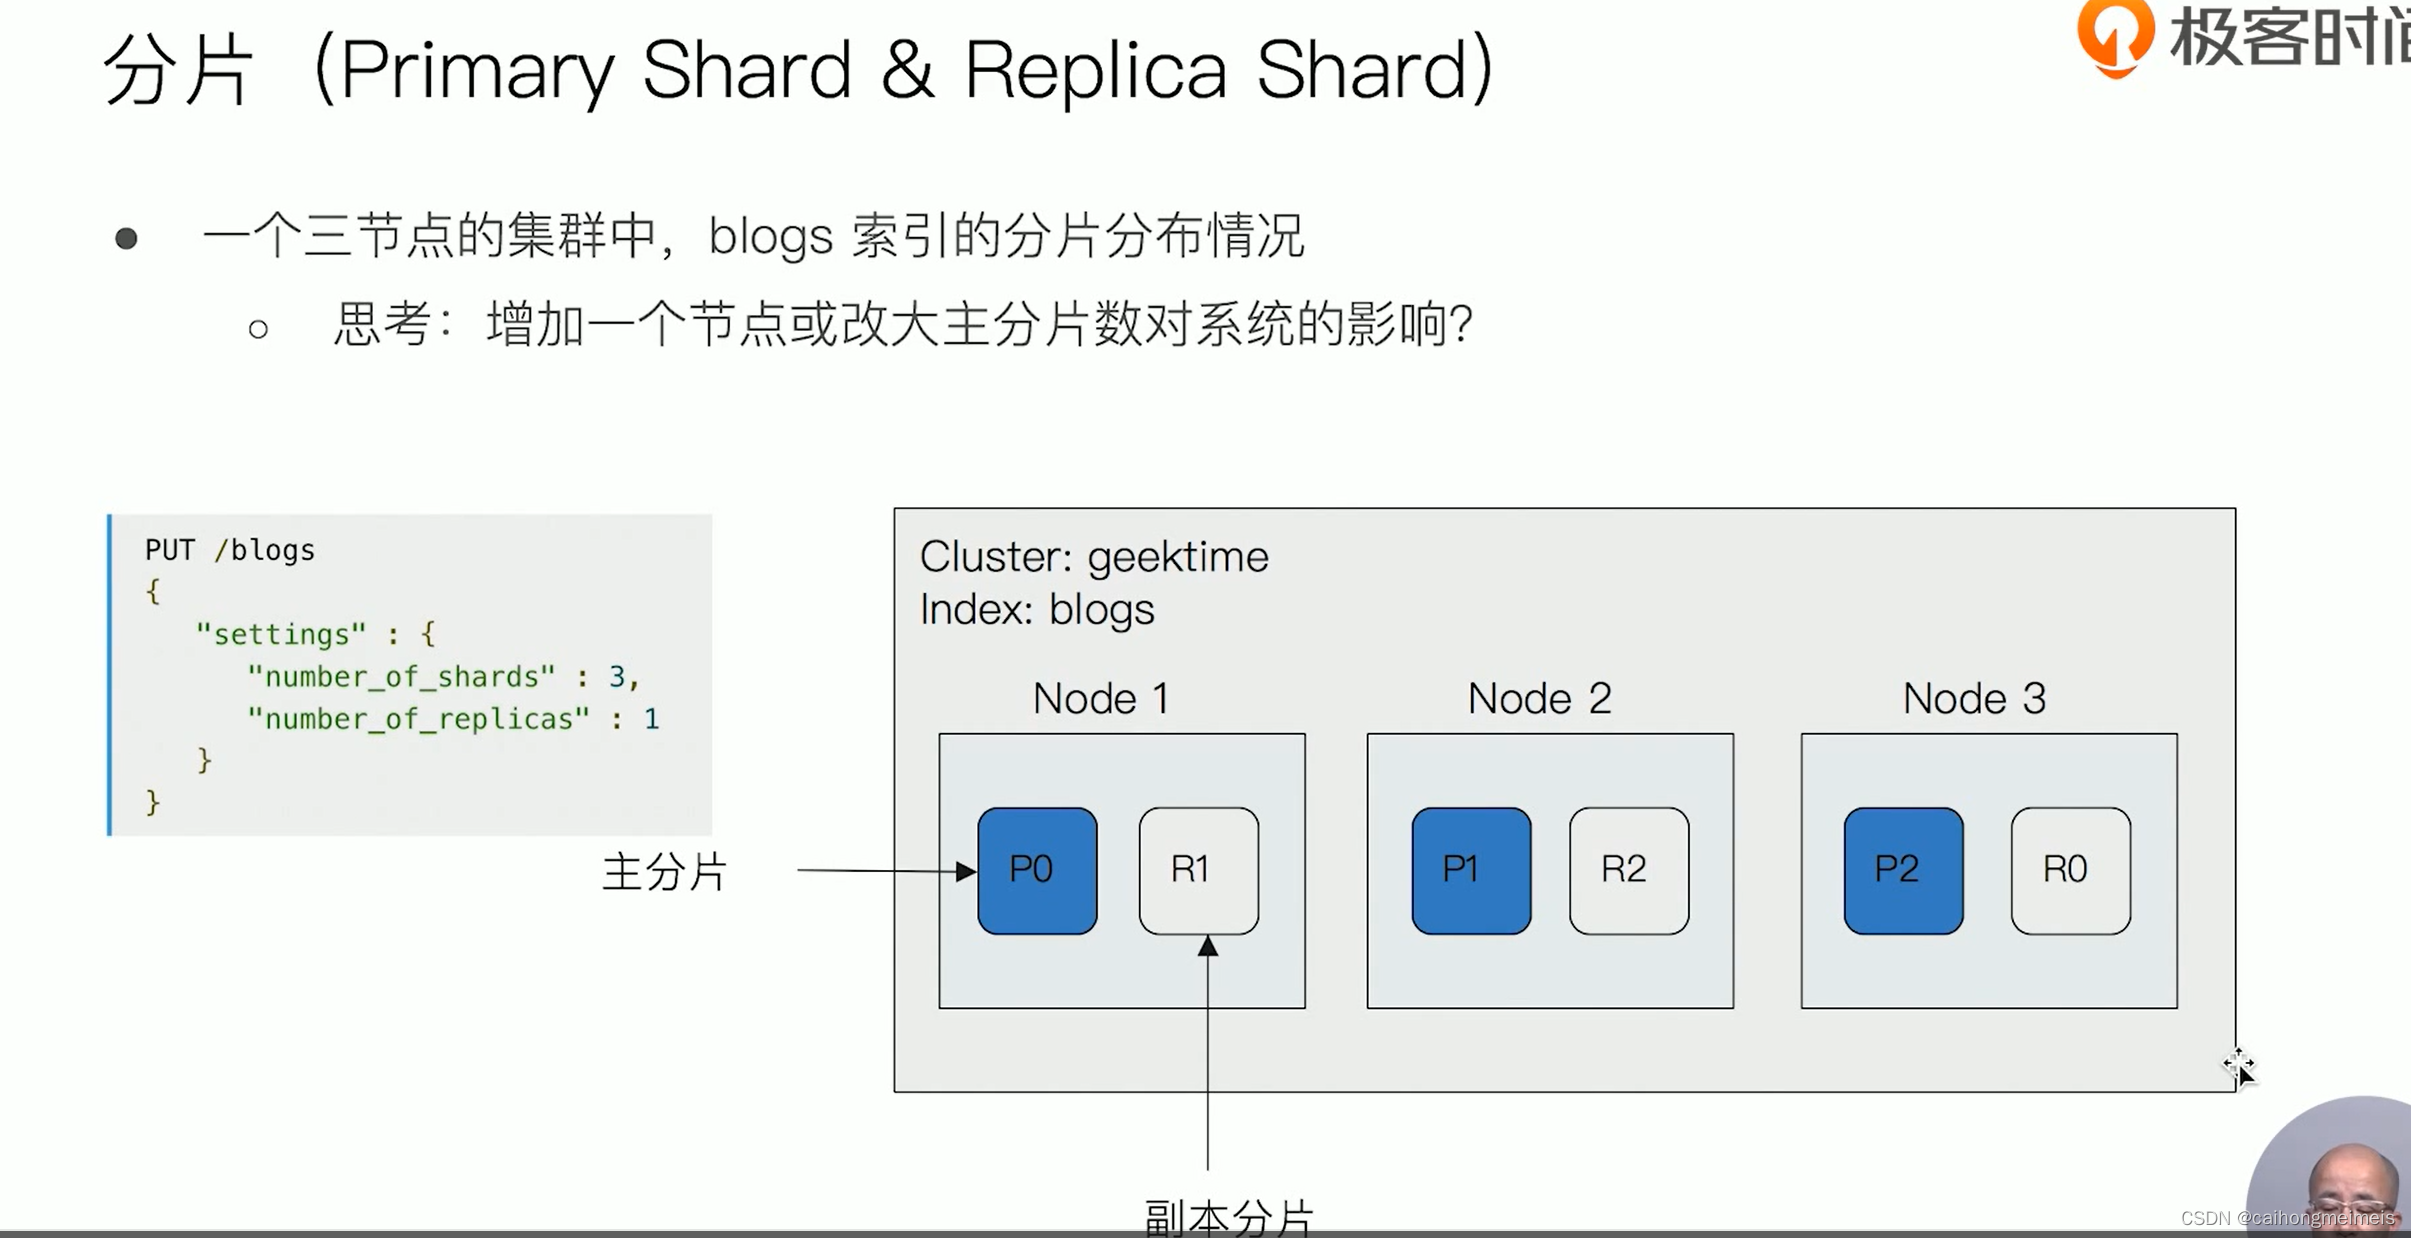
分片的设定
对于生产环境的分片设定,需要提前做好容量规划
分片数设置过小
导致后续无法增加节点实现水平扩展
单个分片的数据太大,导致数据重新分配耗时
分片数设置过大,7.0开始,默认主分片设置成1,解决 over-sharding的问题
影响搜索结果的相关性打分,影响统计结果的准确性
单个节点上过多的分片,会导致资源浪费,同时会影响性能
查看集群的 健康状况
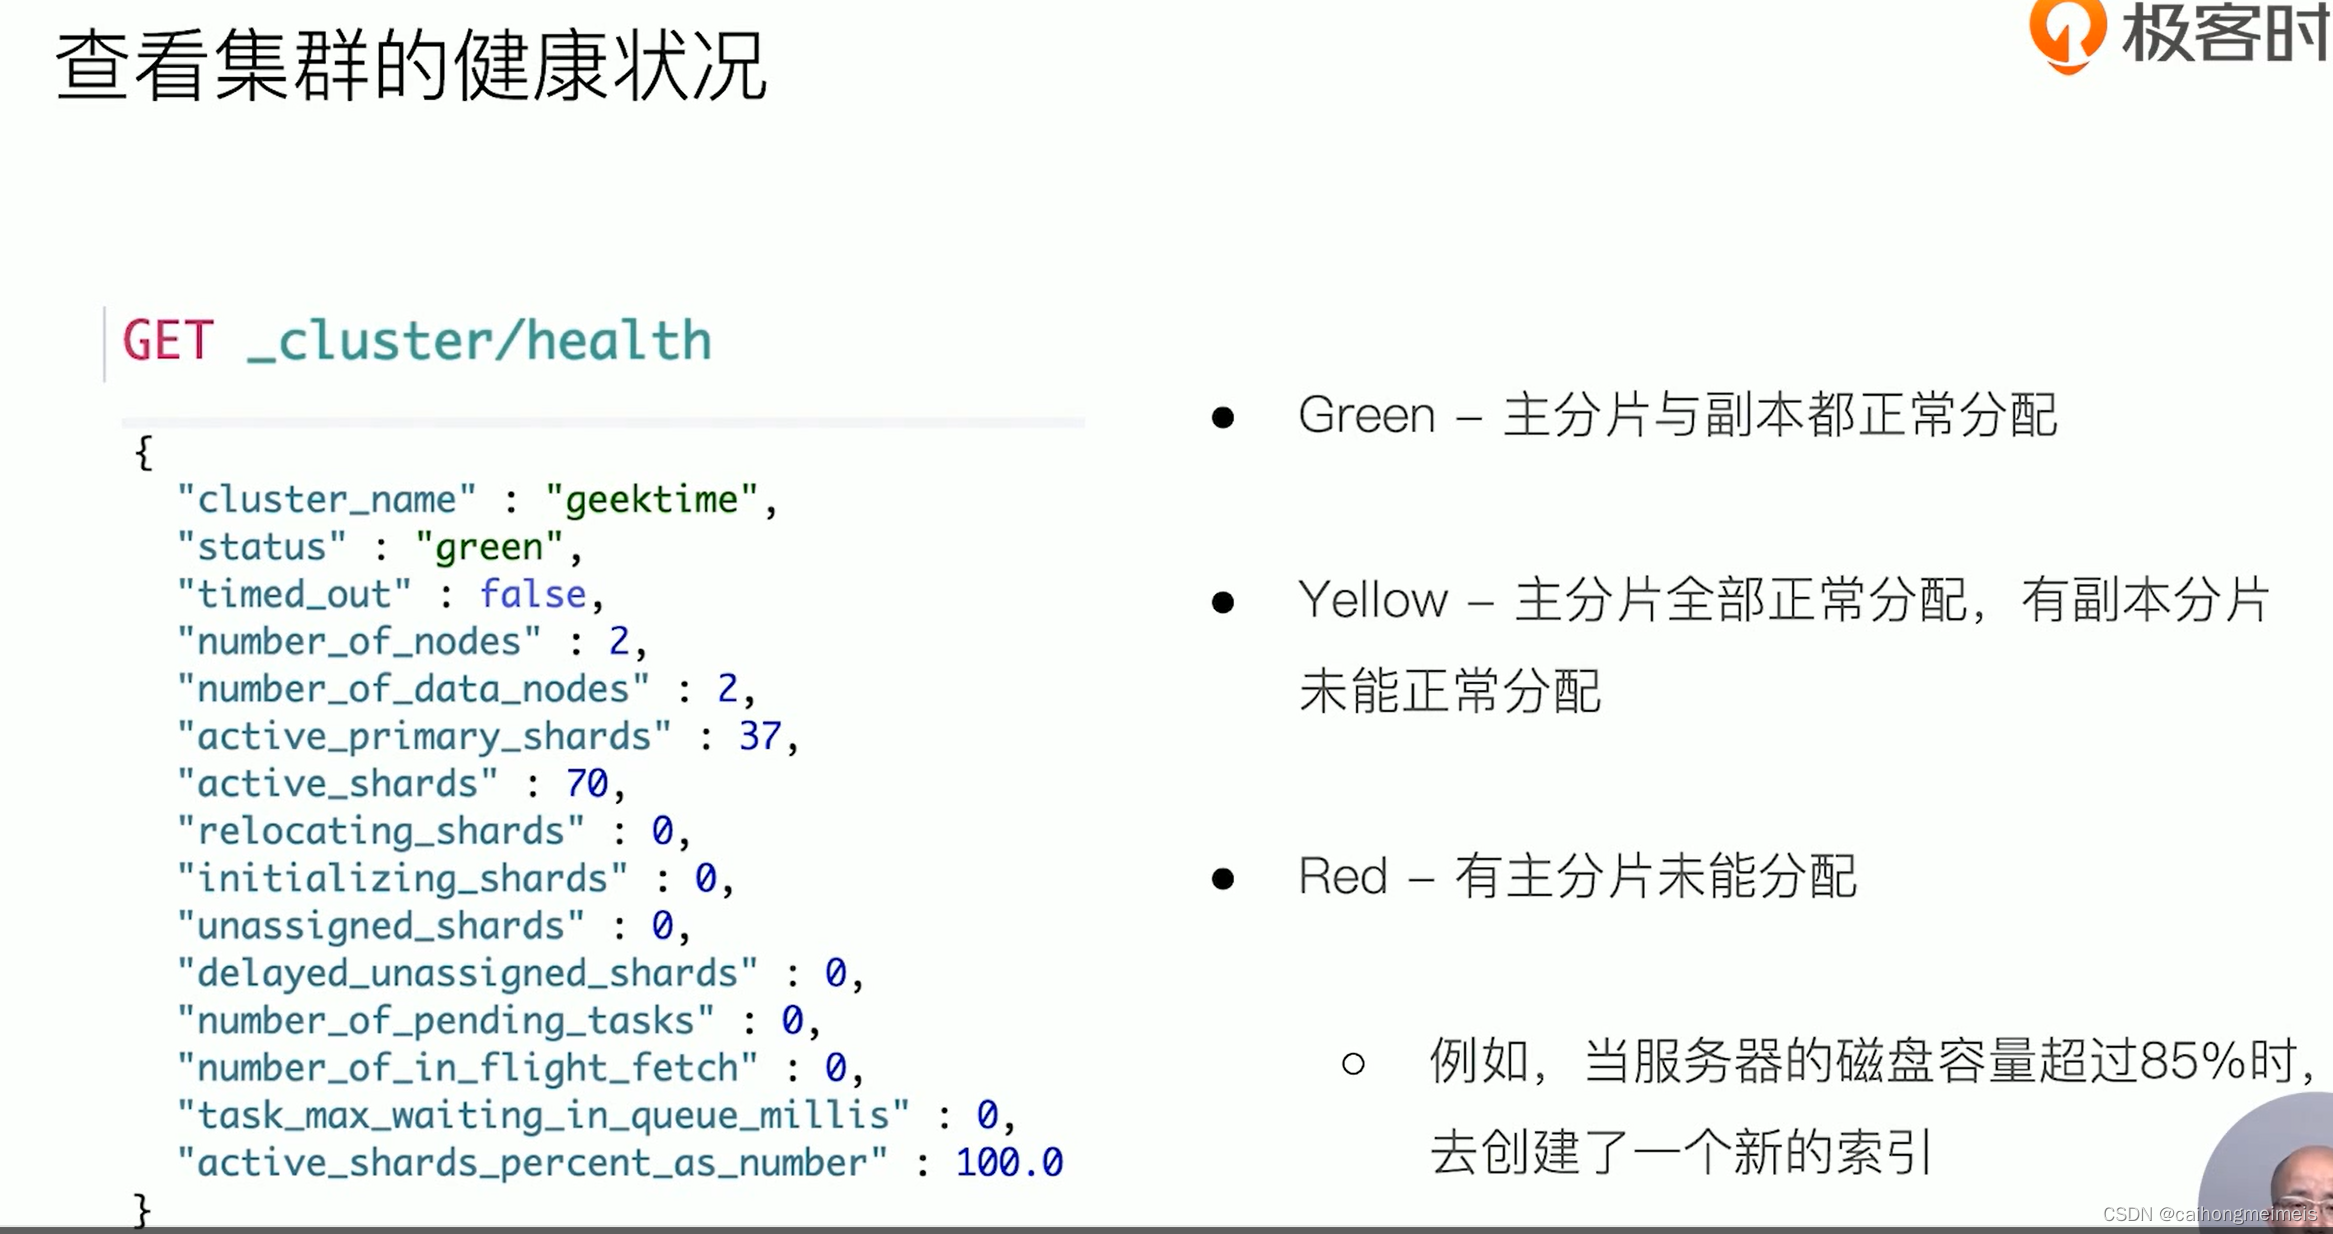
三、 文档基本的CRUD与批量操作
 3.1 create 文档创建
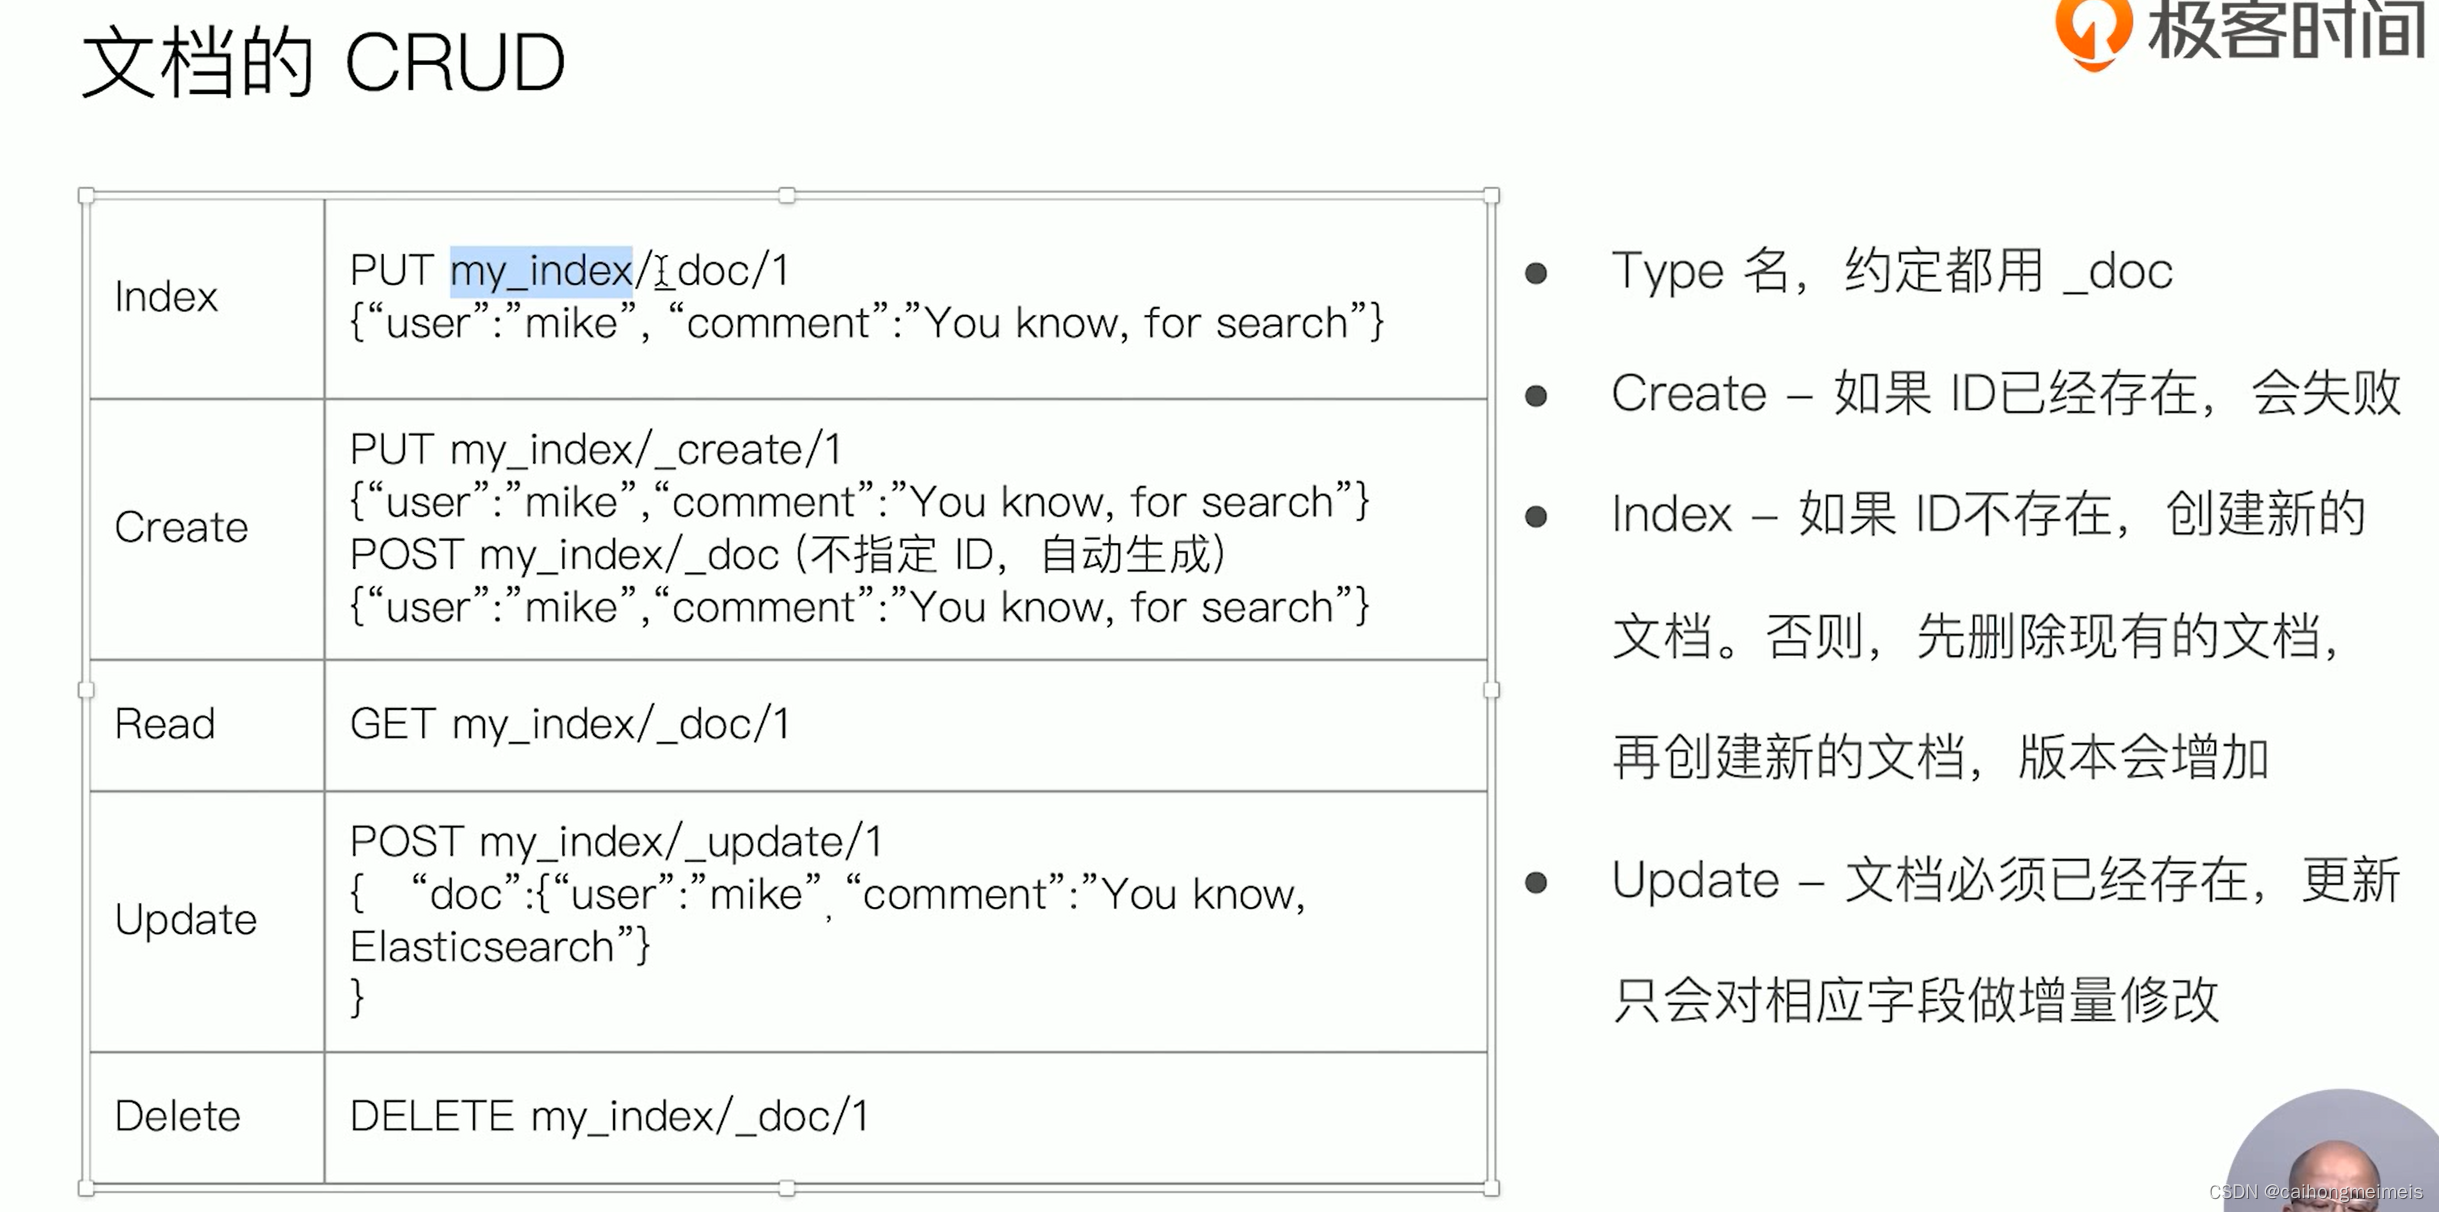 3.1 create 文档创建
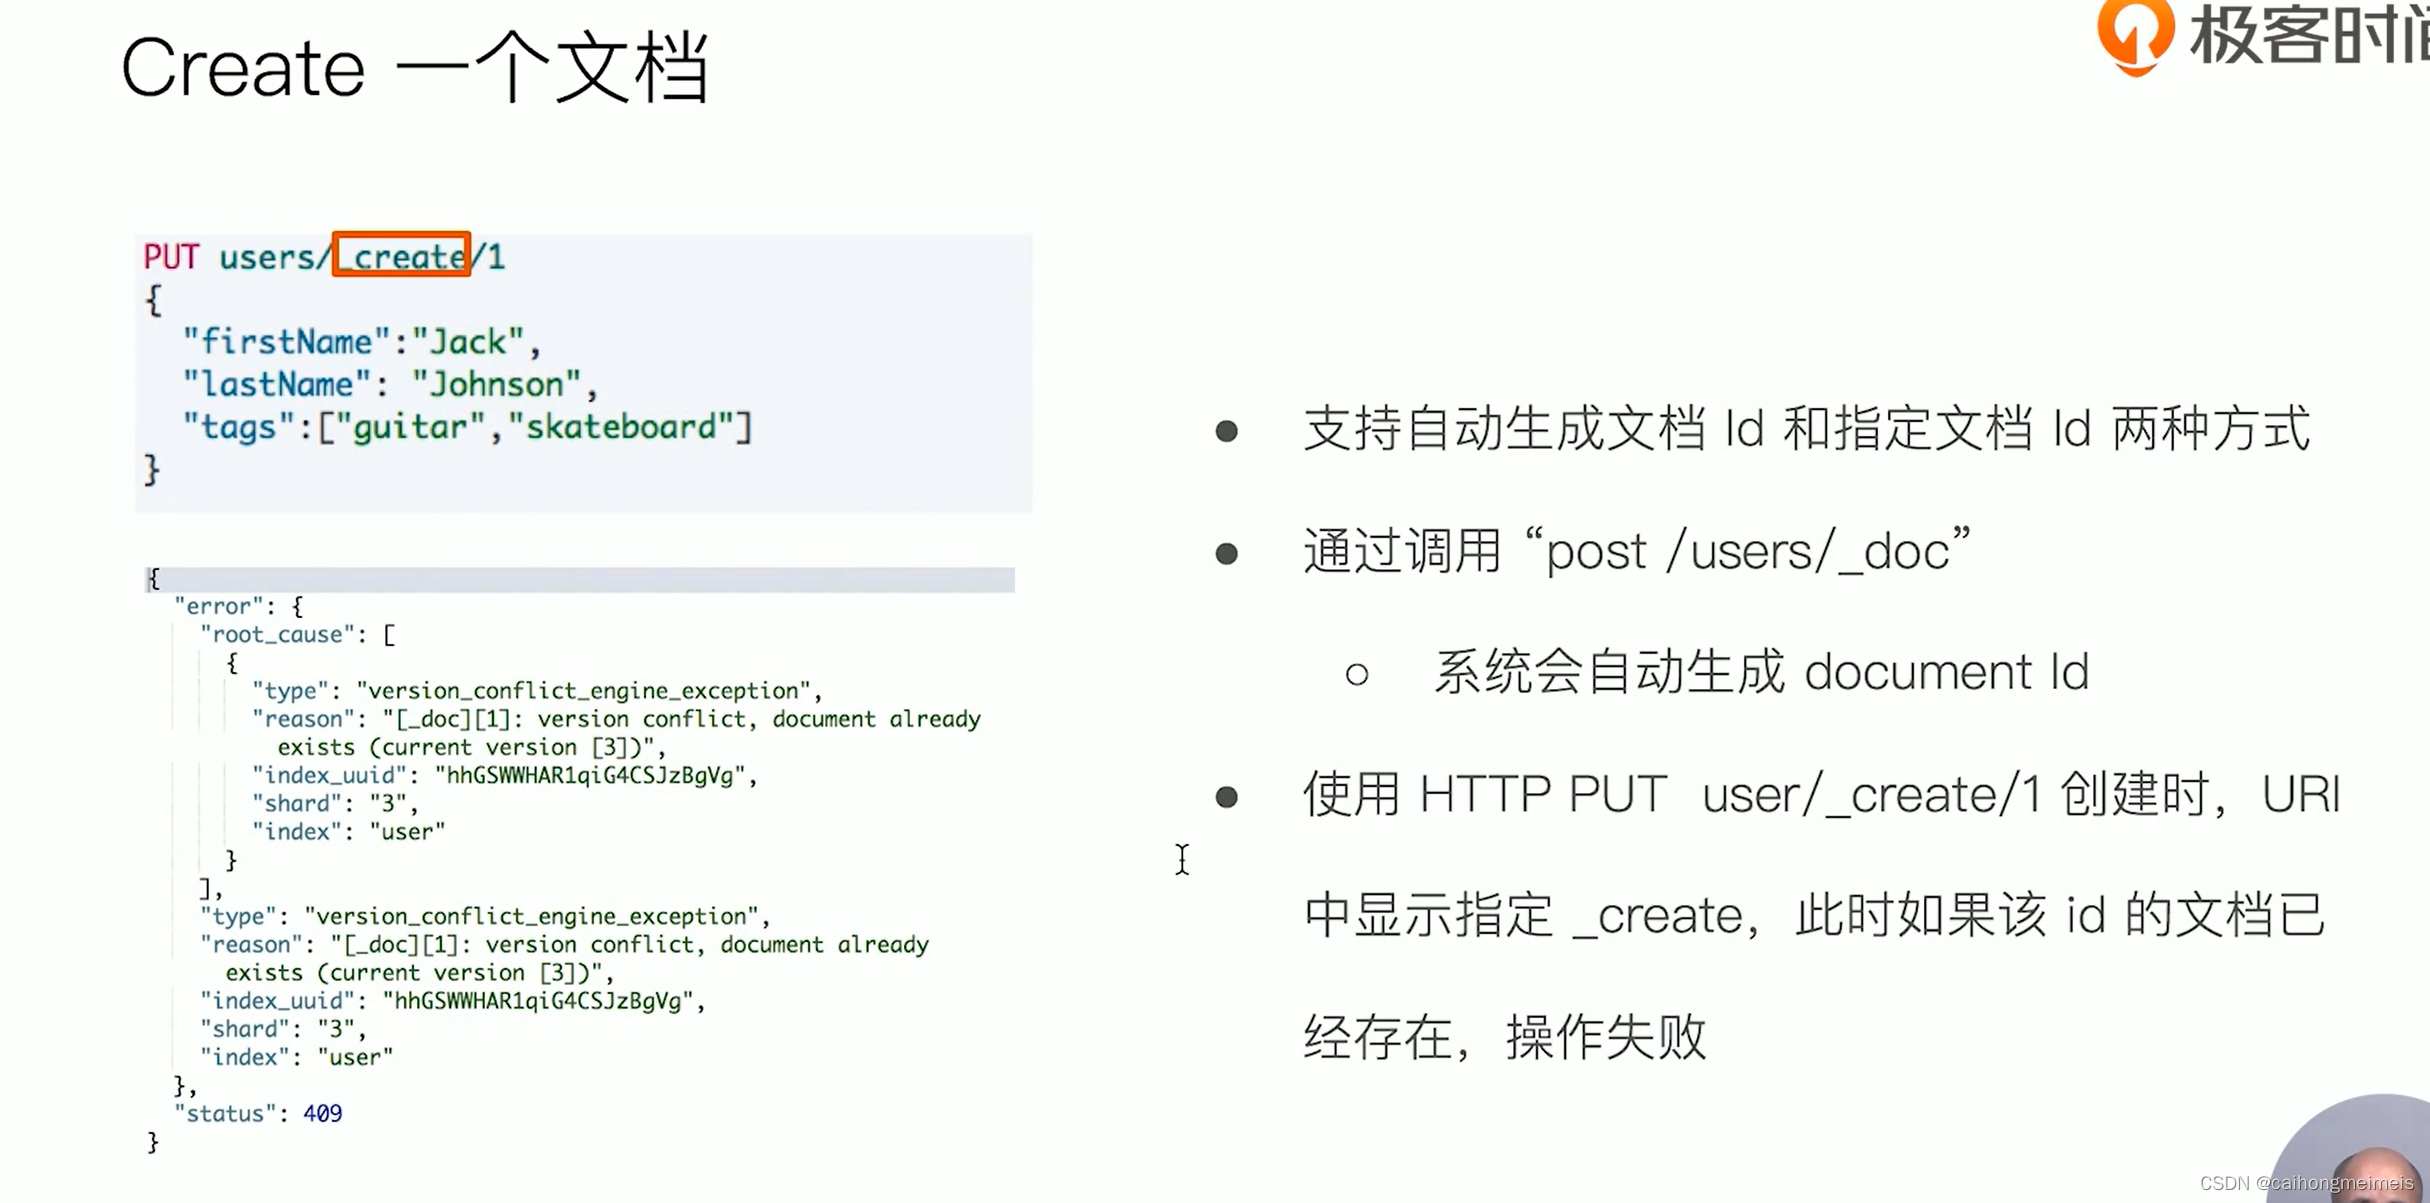
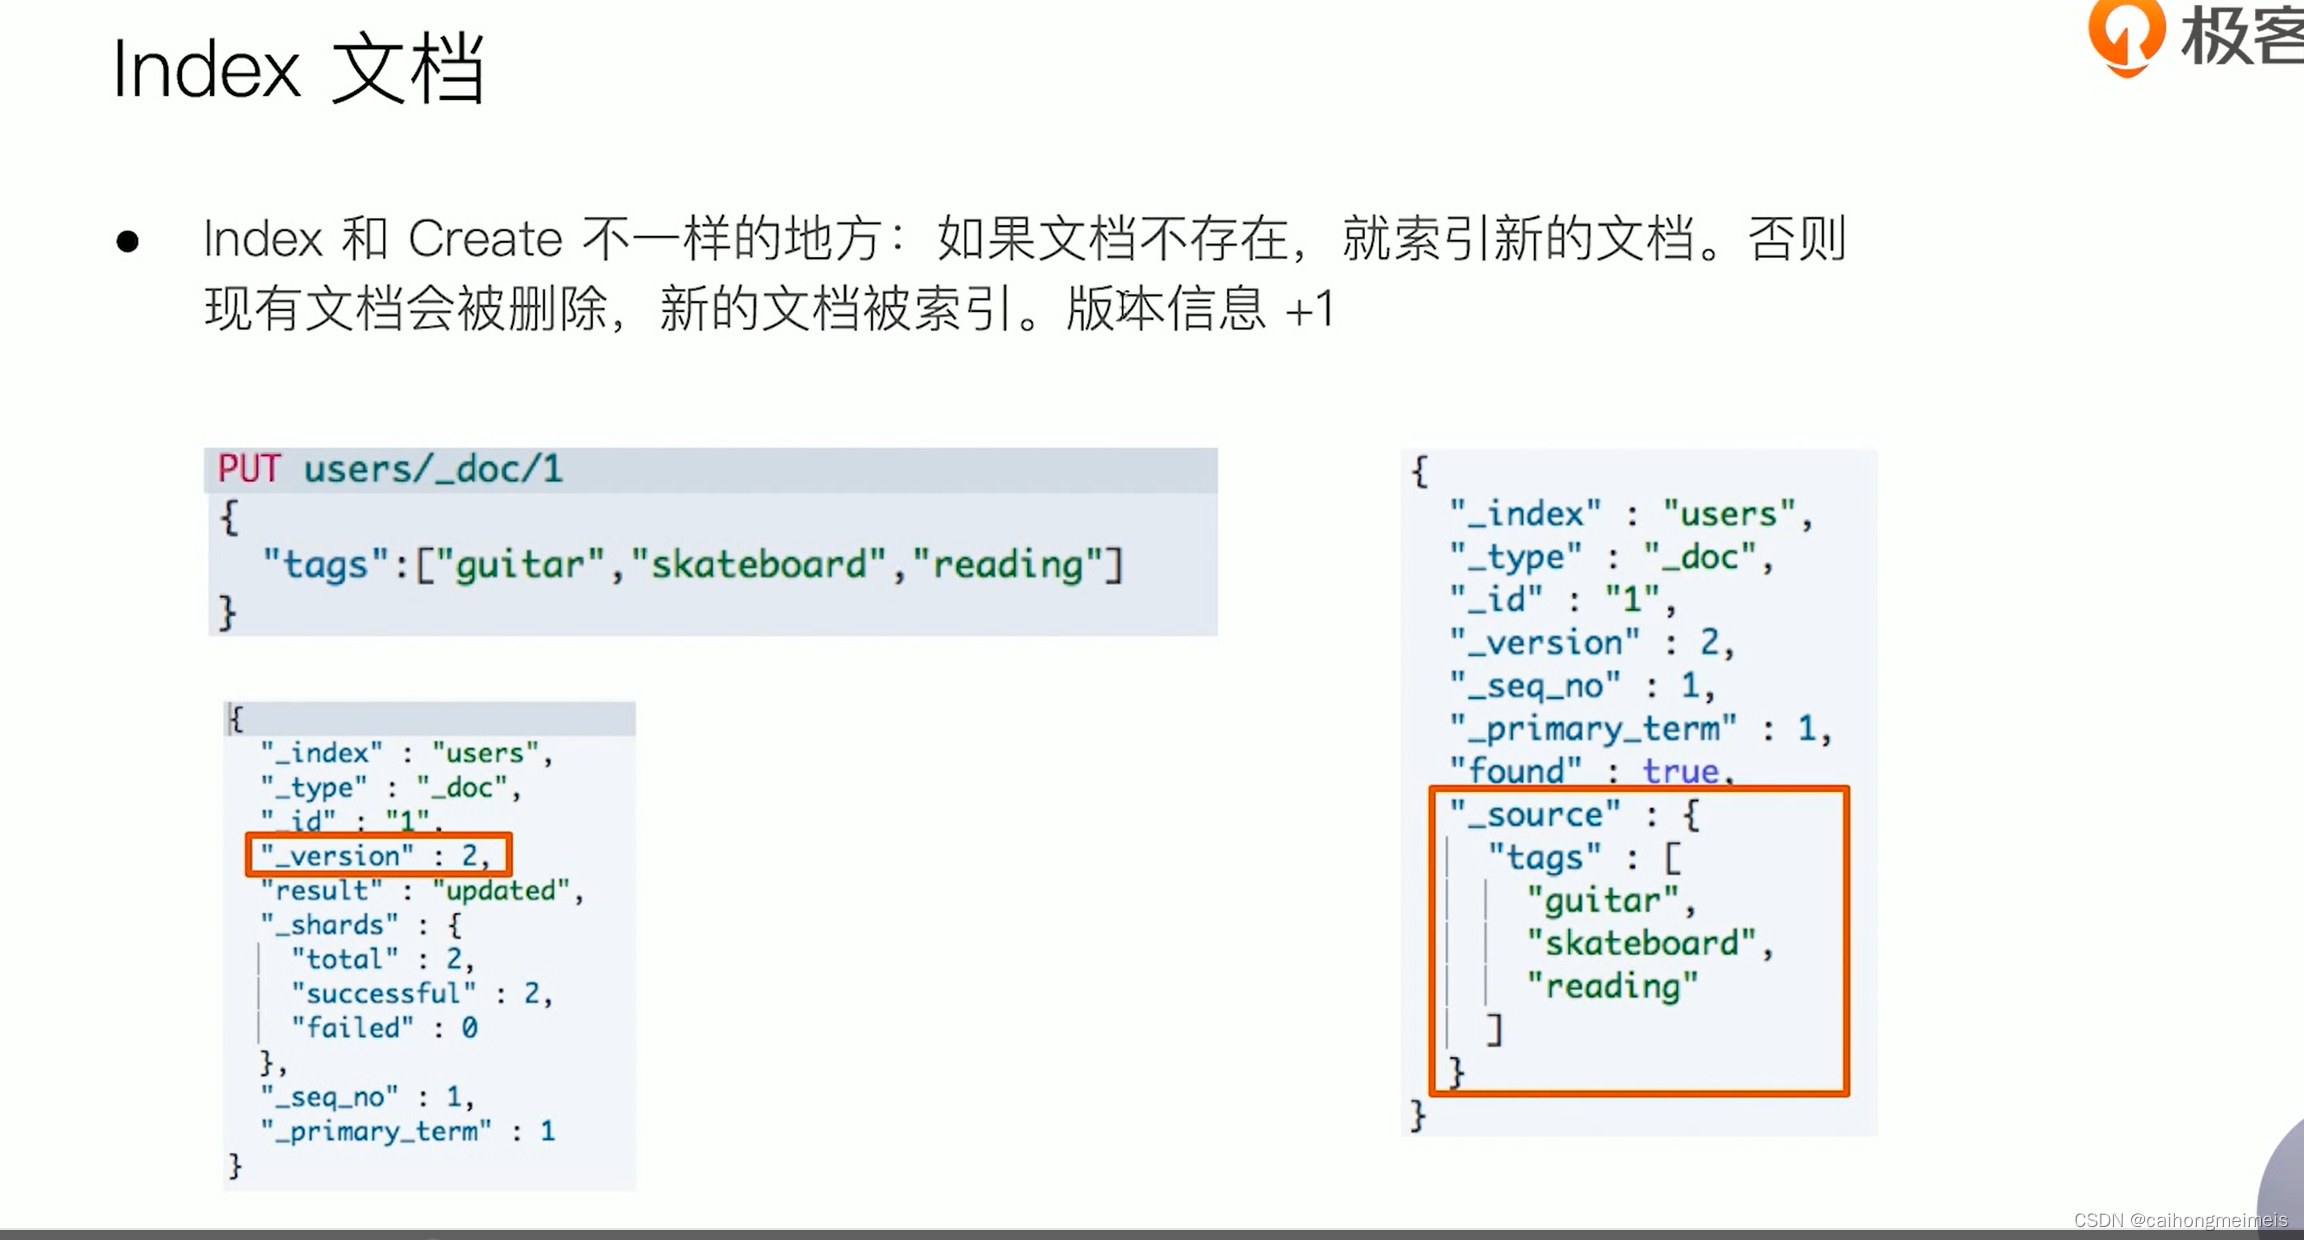
3.2 Index文档
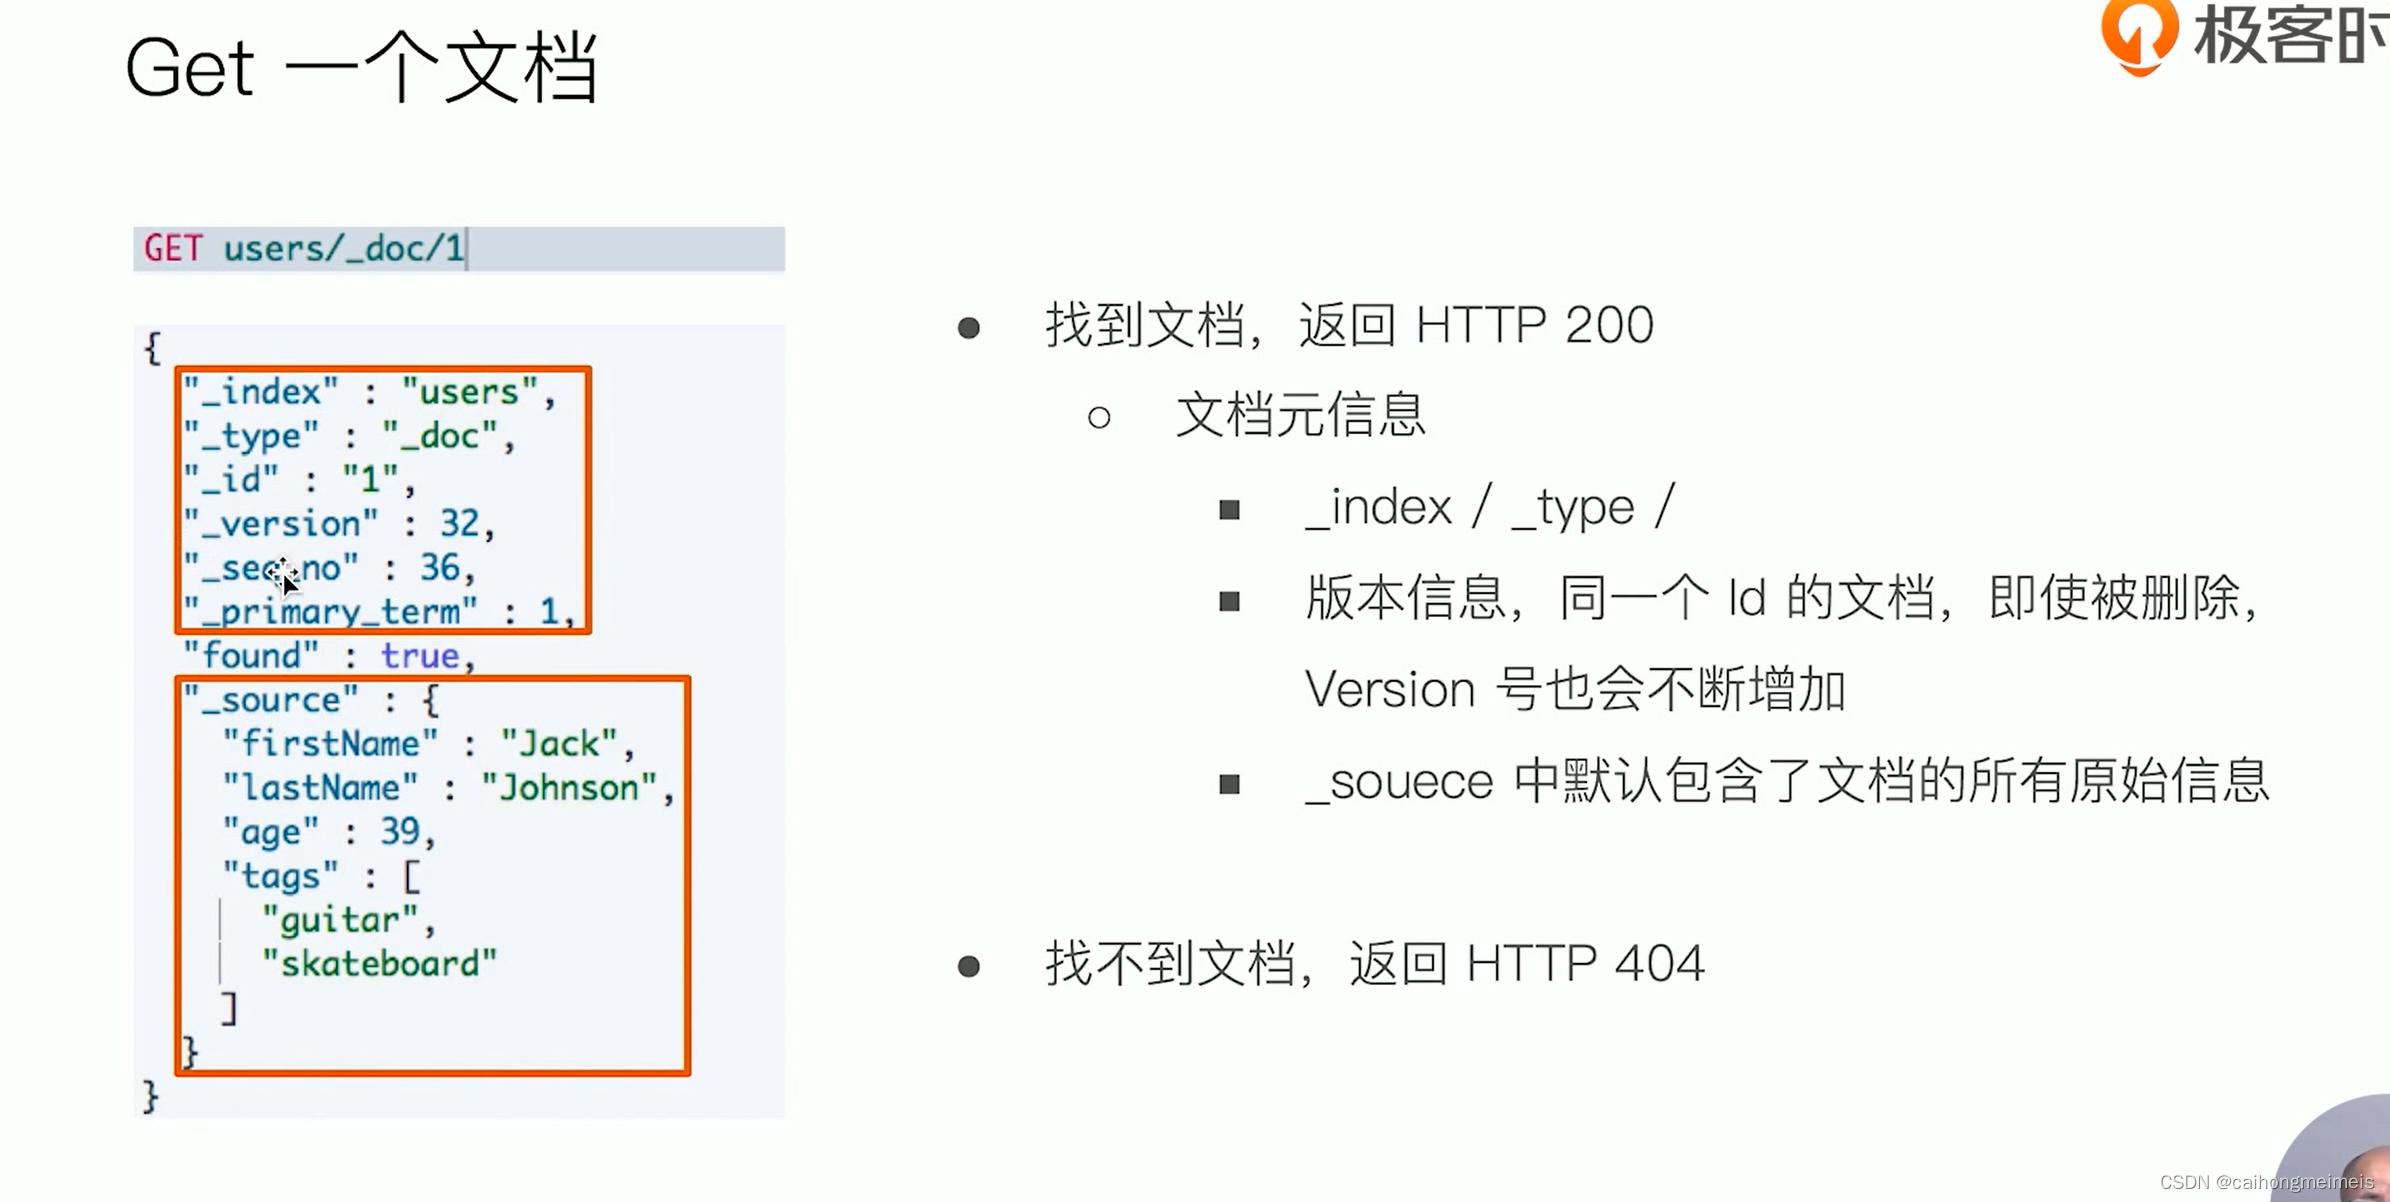
3.3 get 文档查询
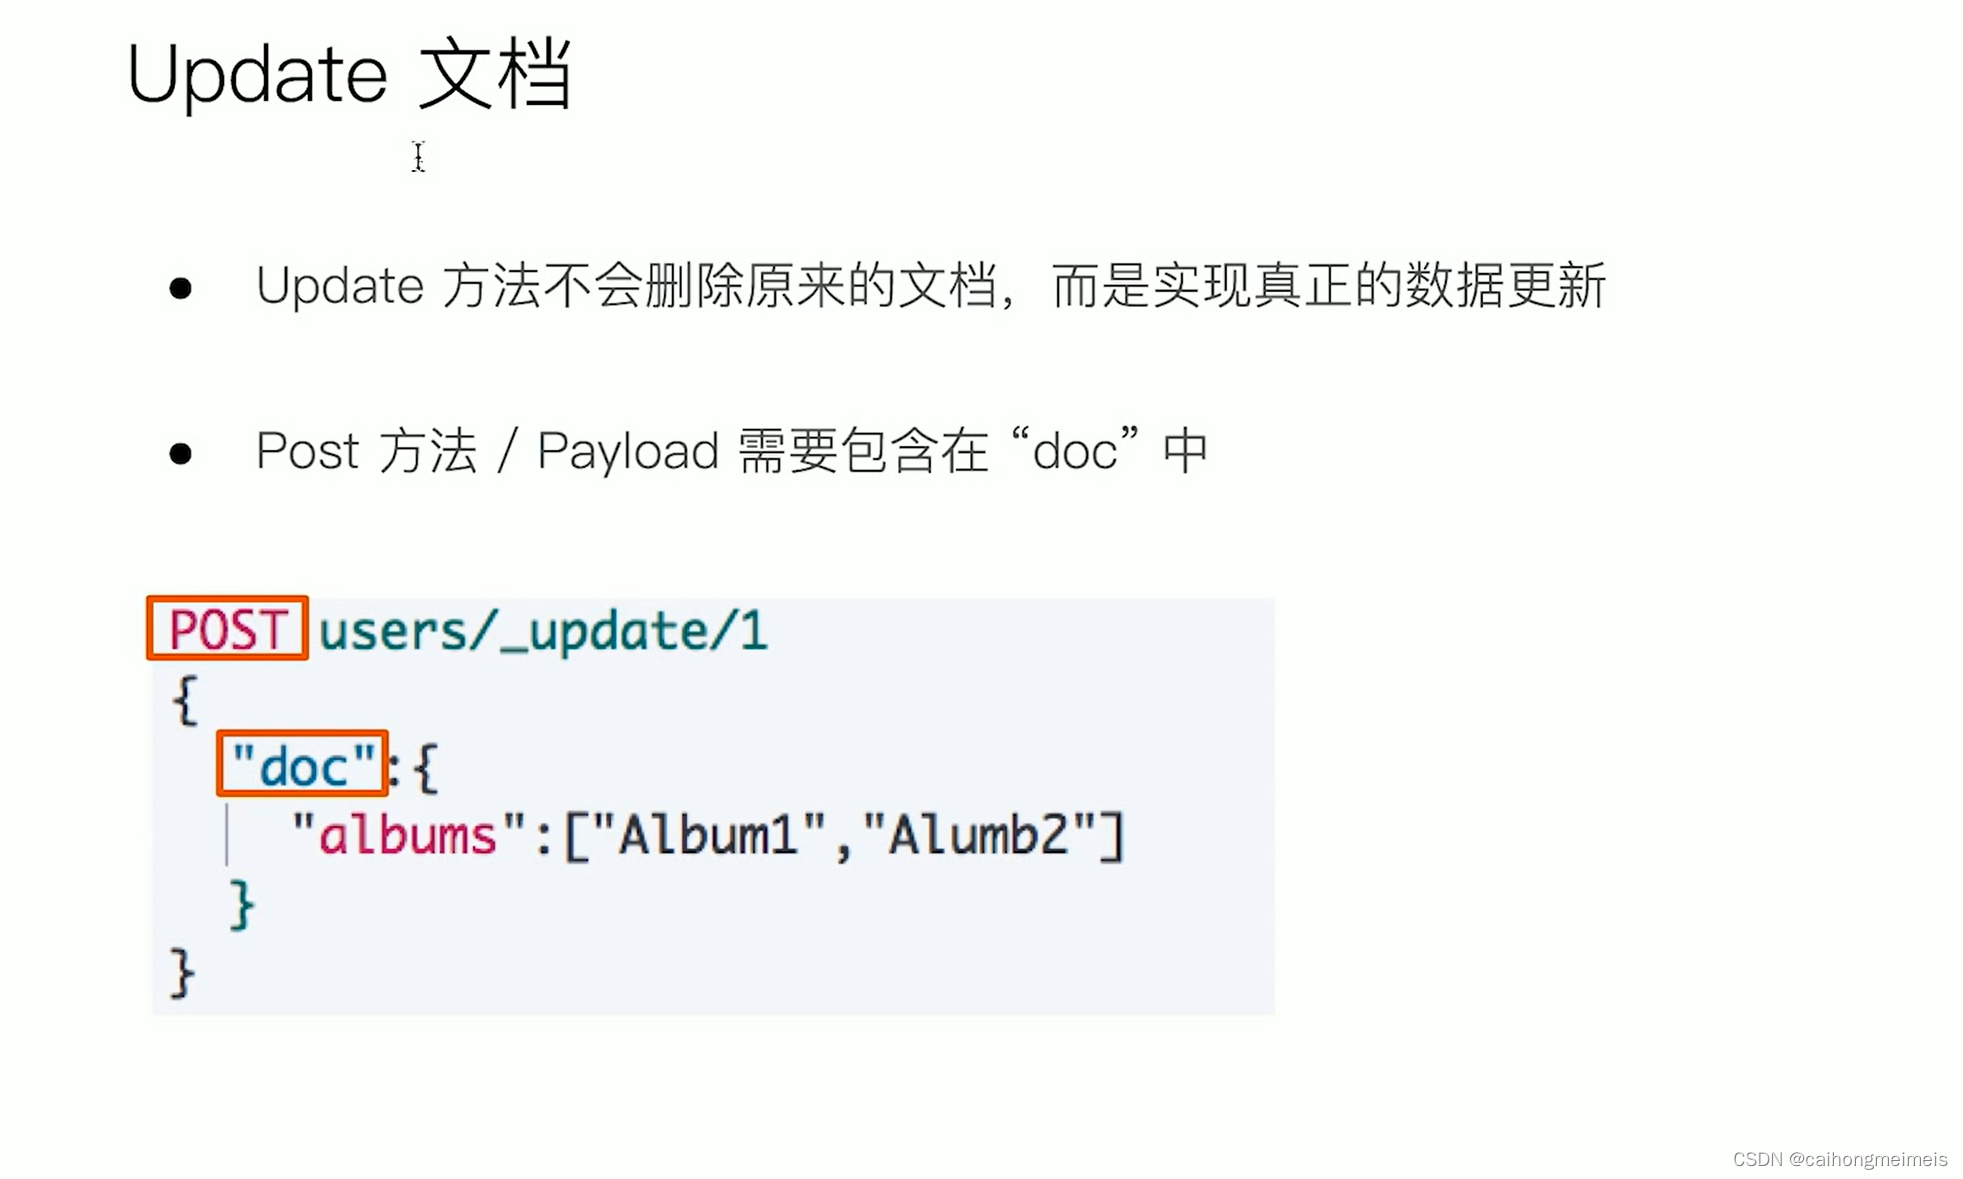
3.4 文档更新
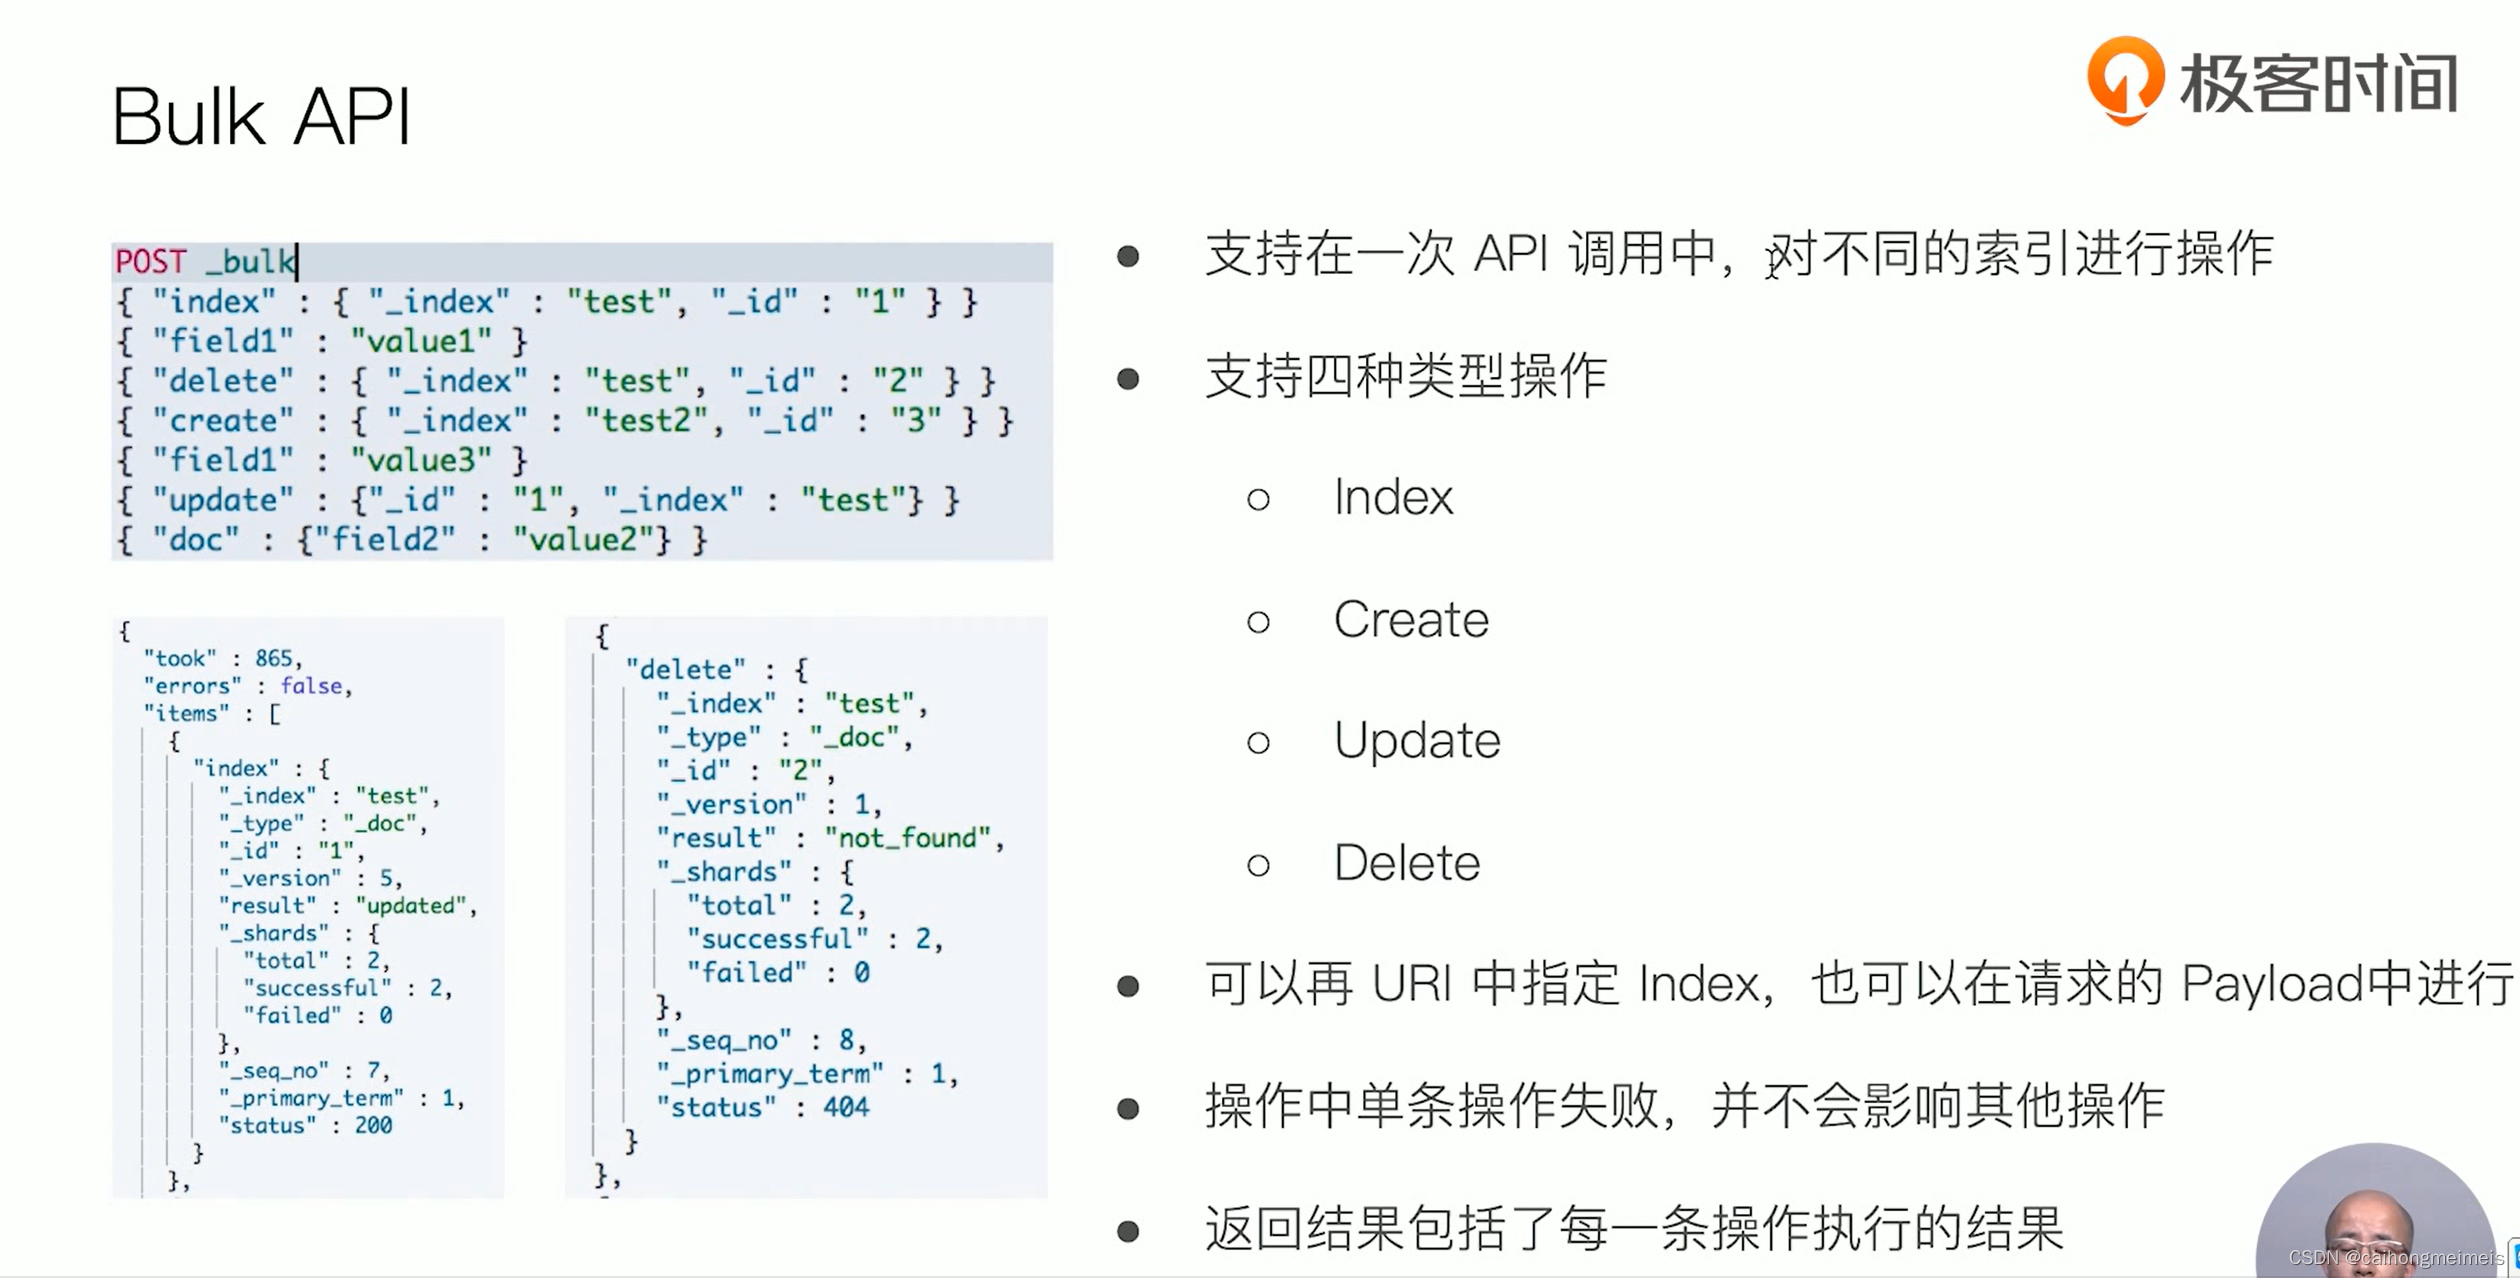
3.5 Buk Api 批量数据操作
四、倒排索引
关键字在页码中的页码关联
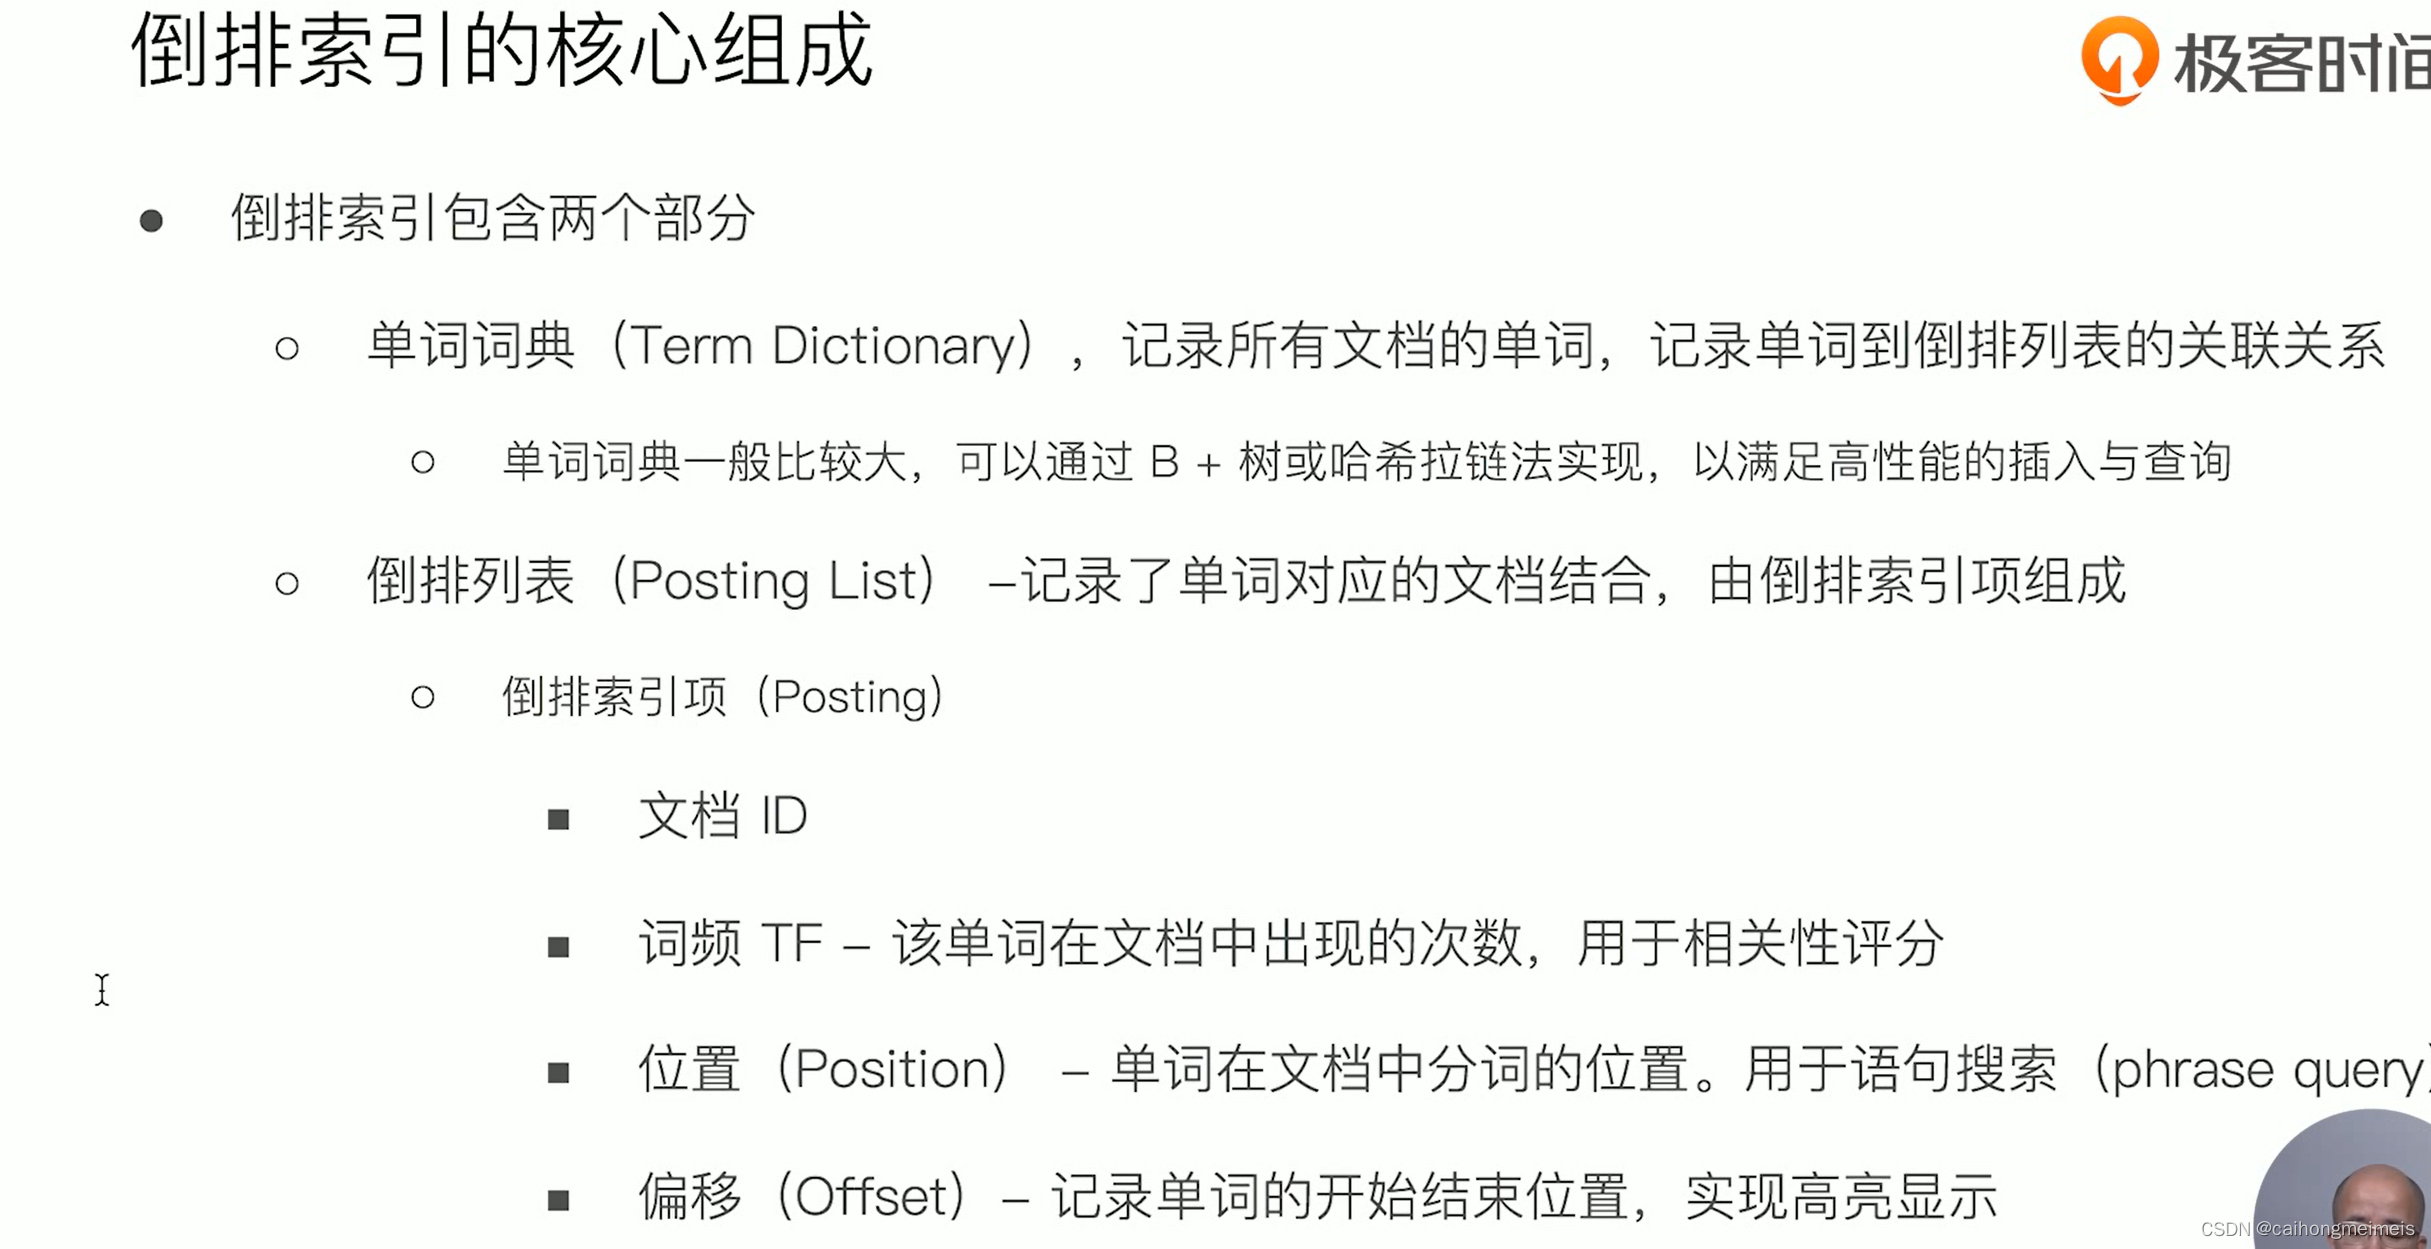
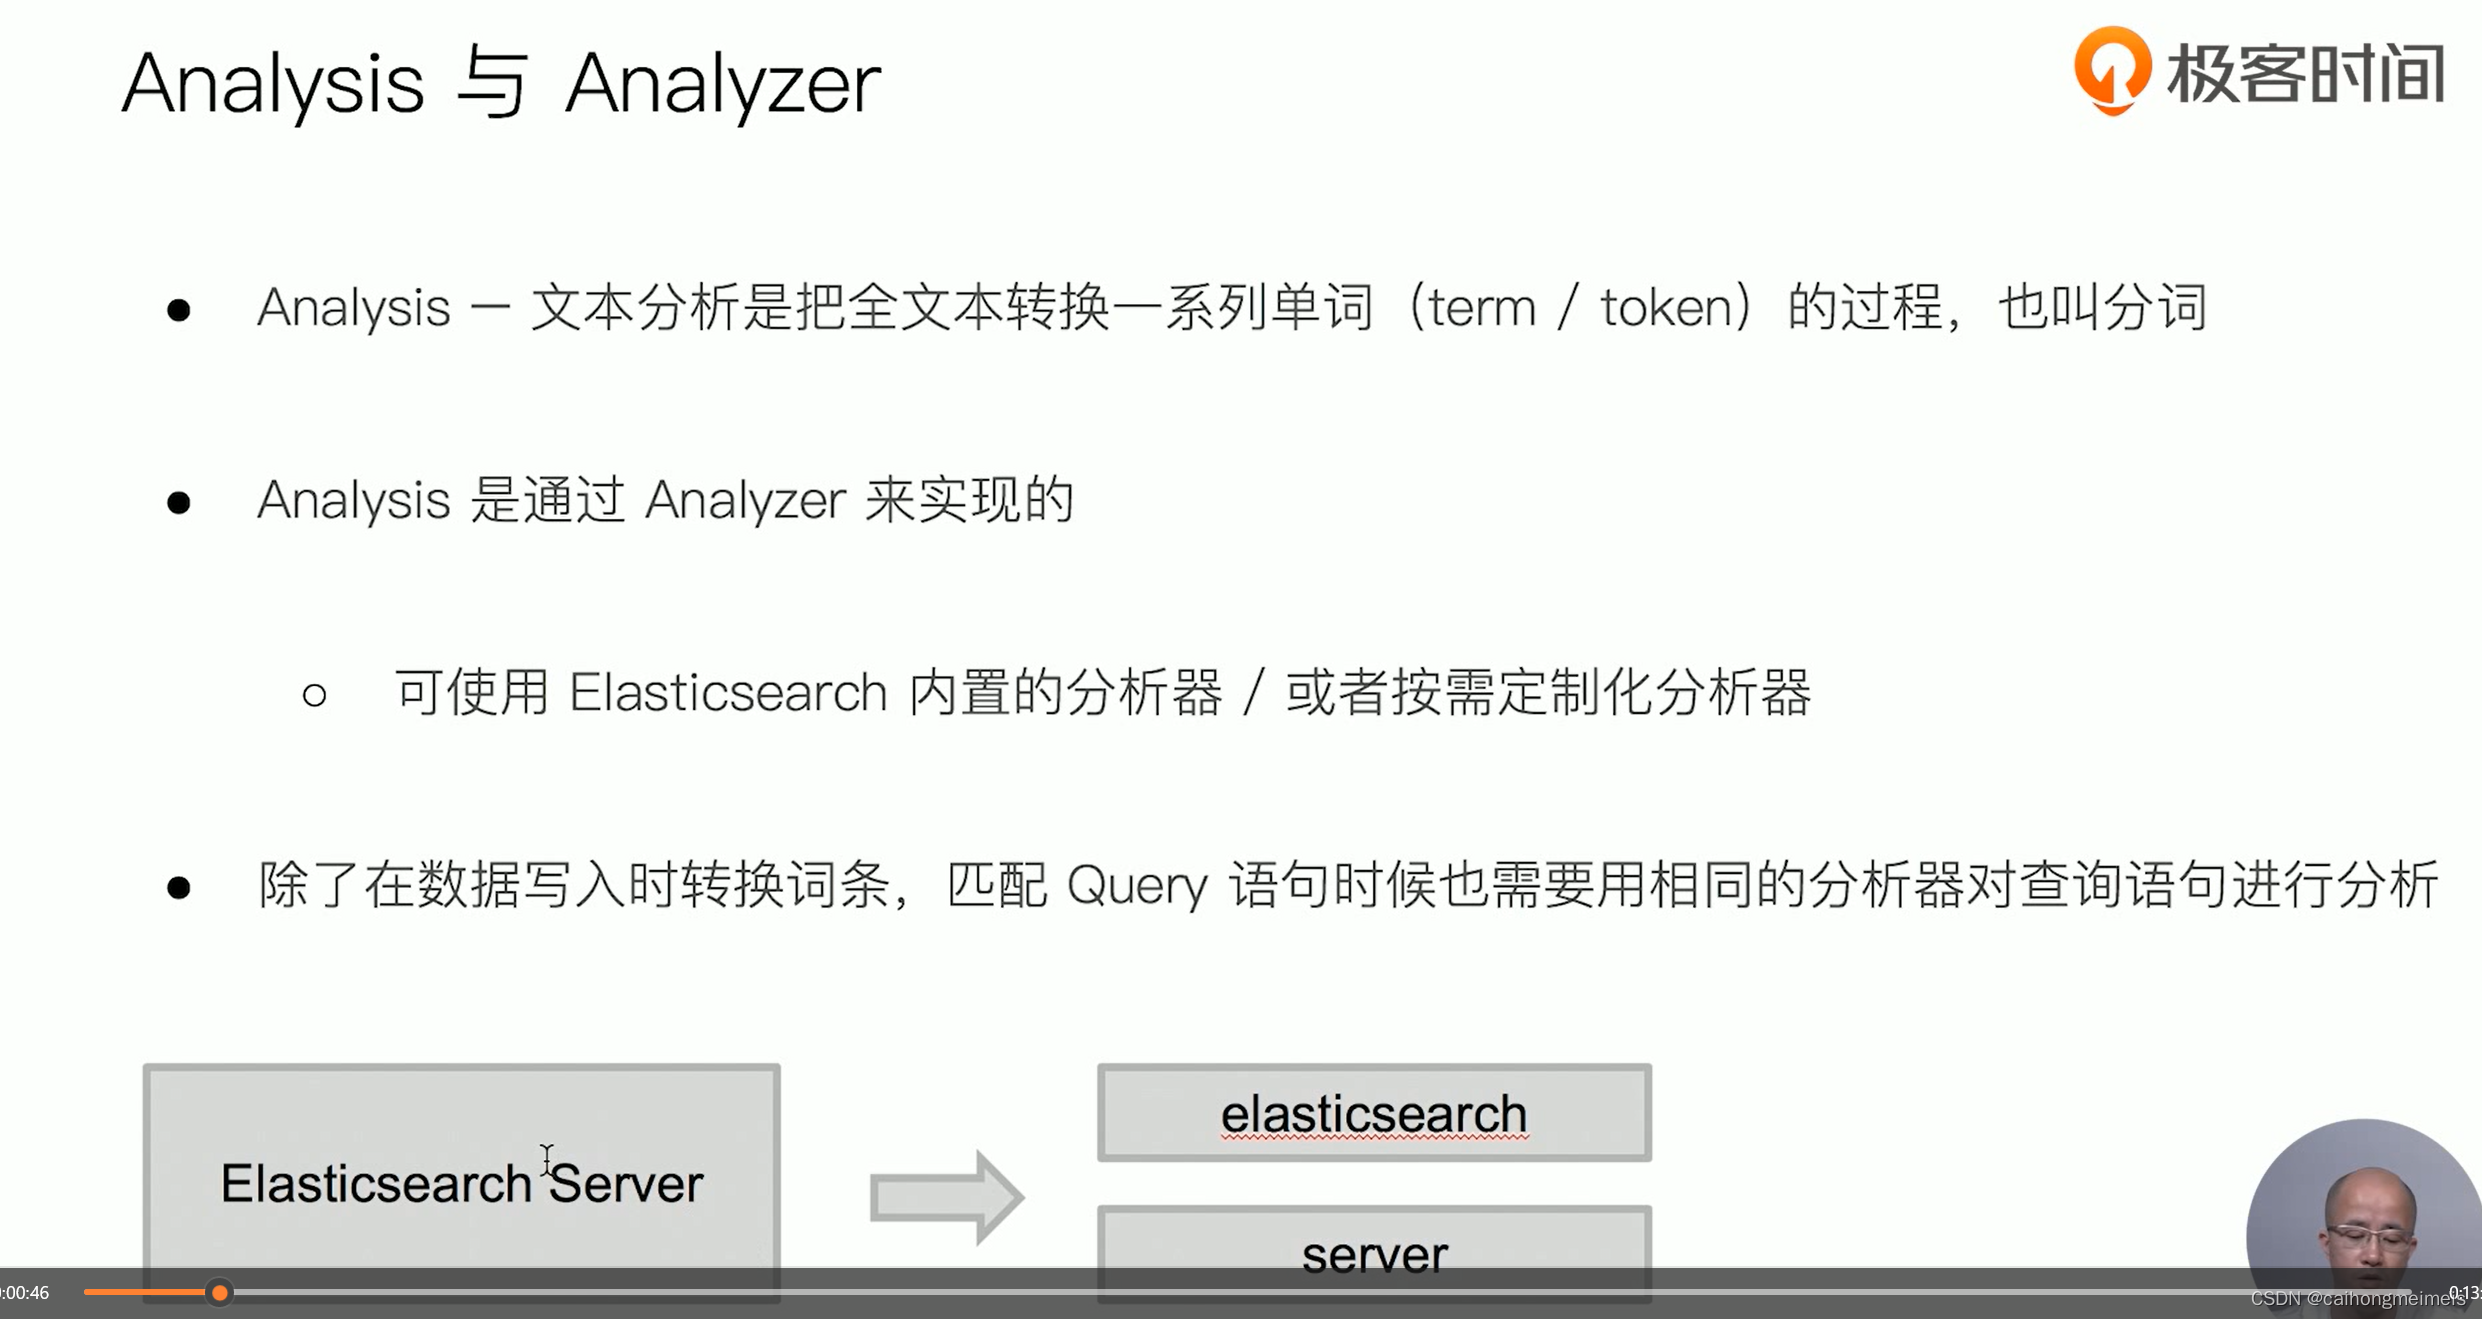
5、Analysis与Analyzer
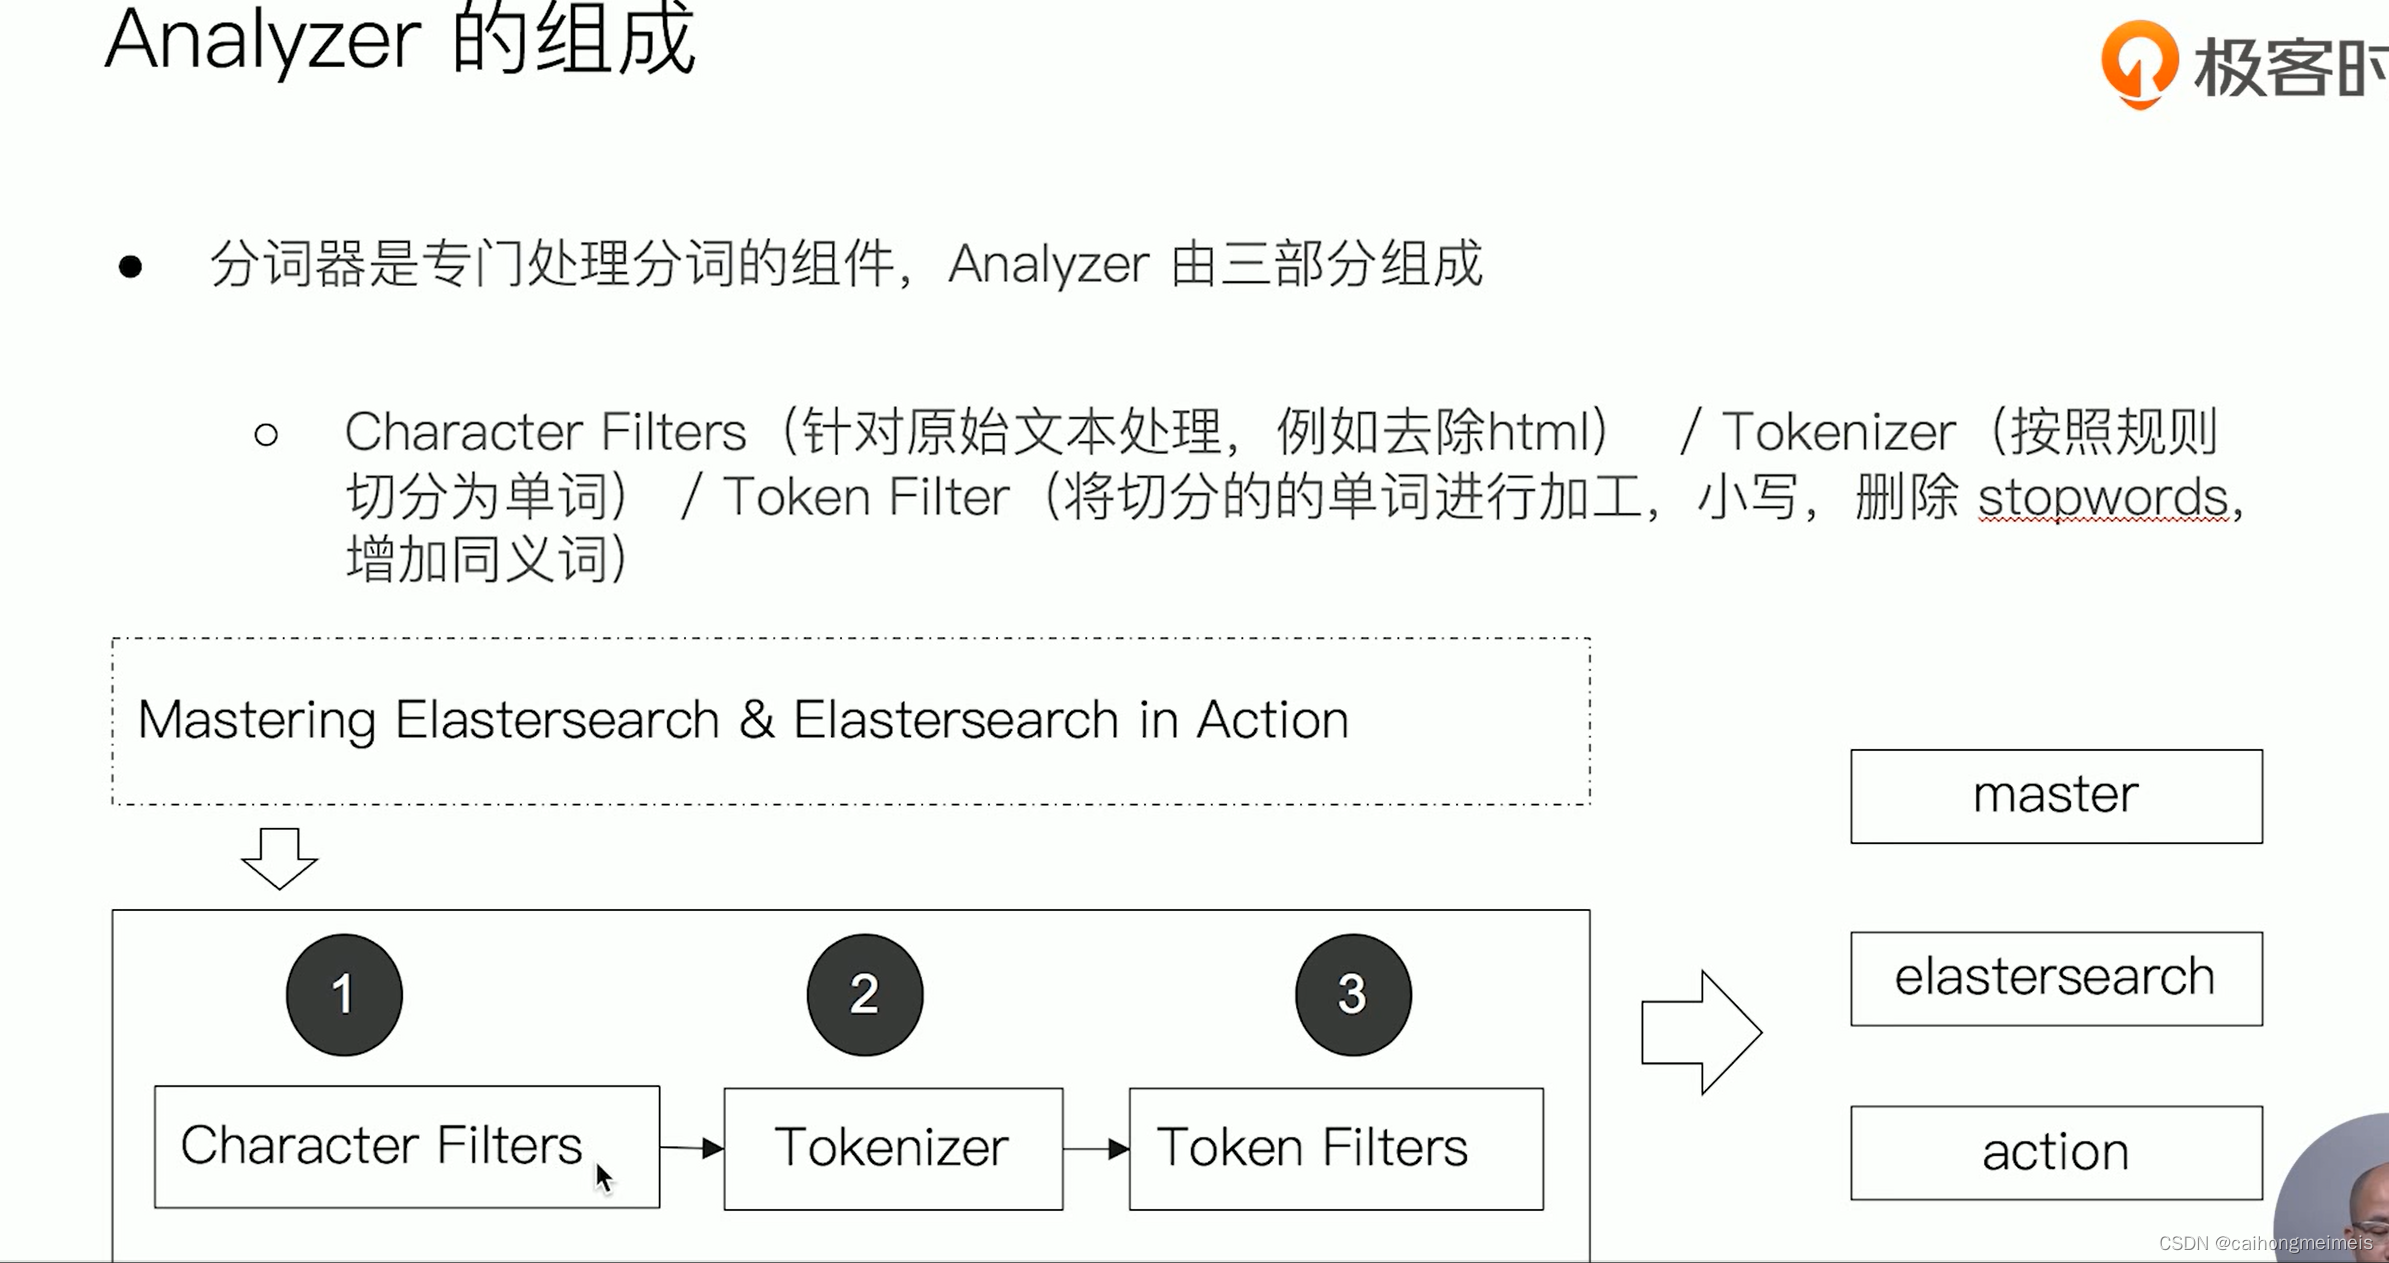
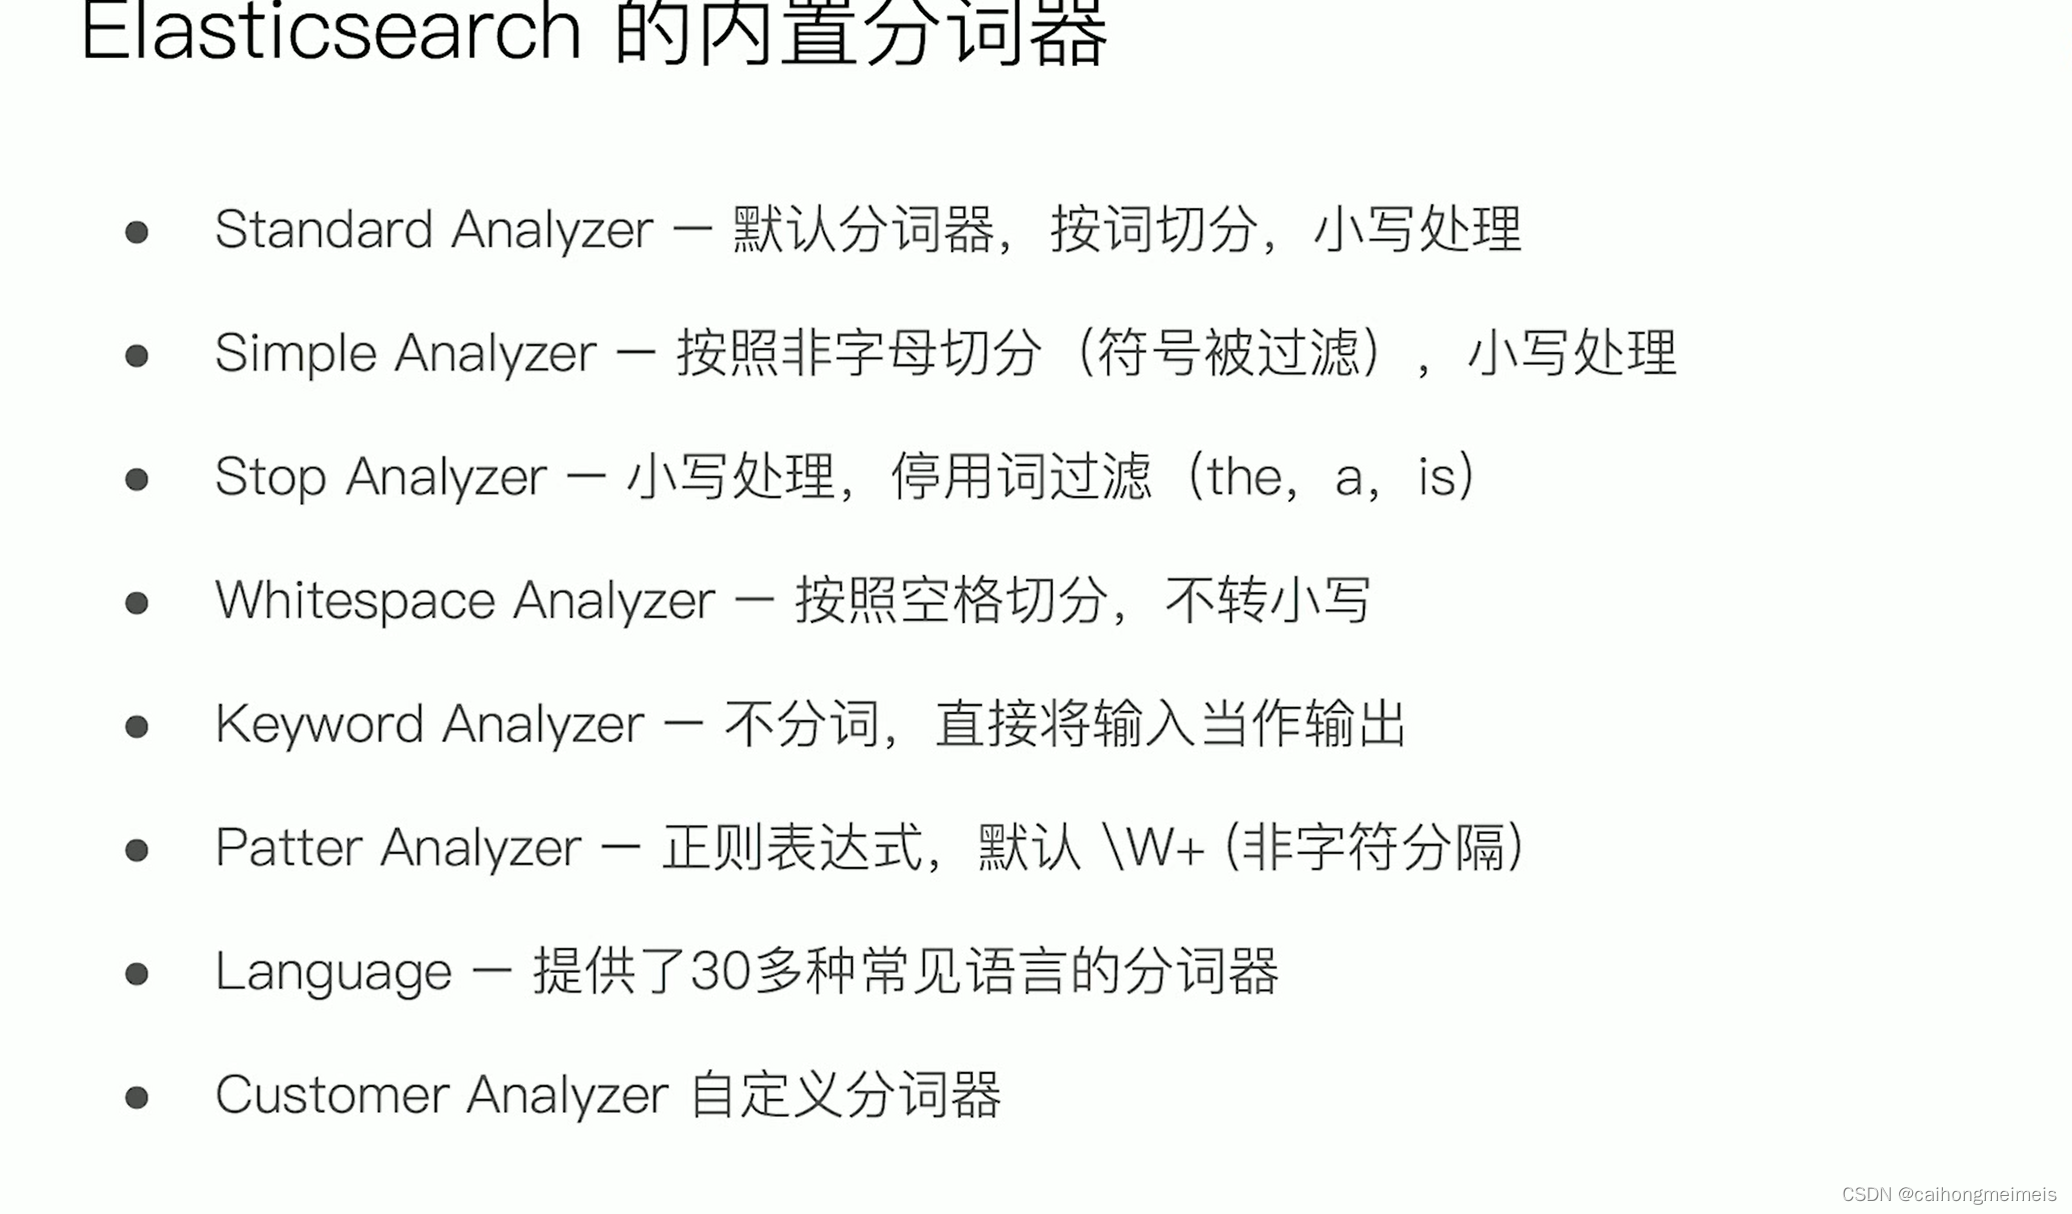
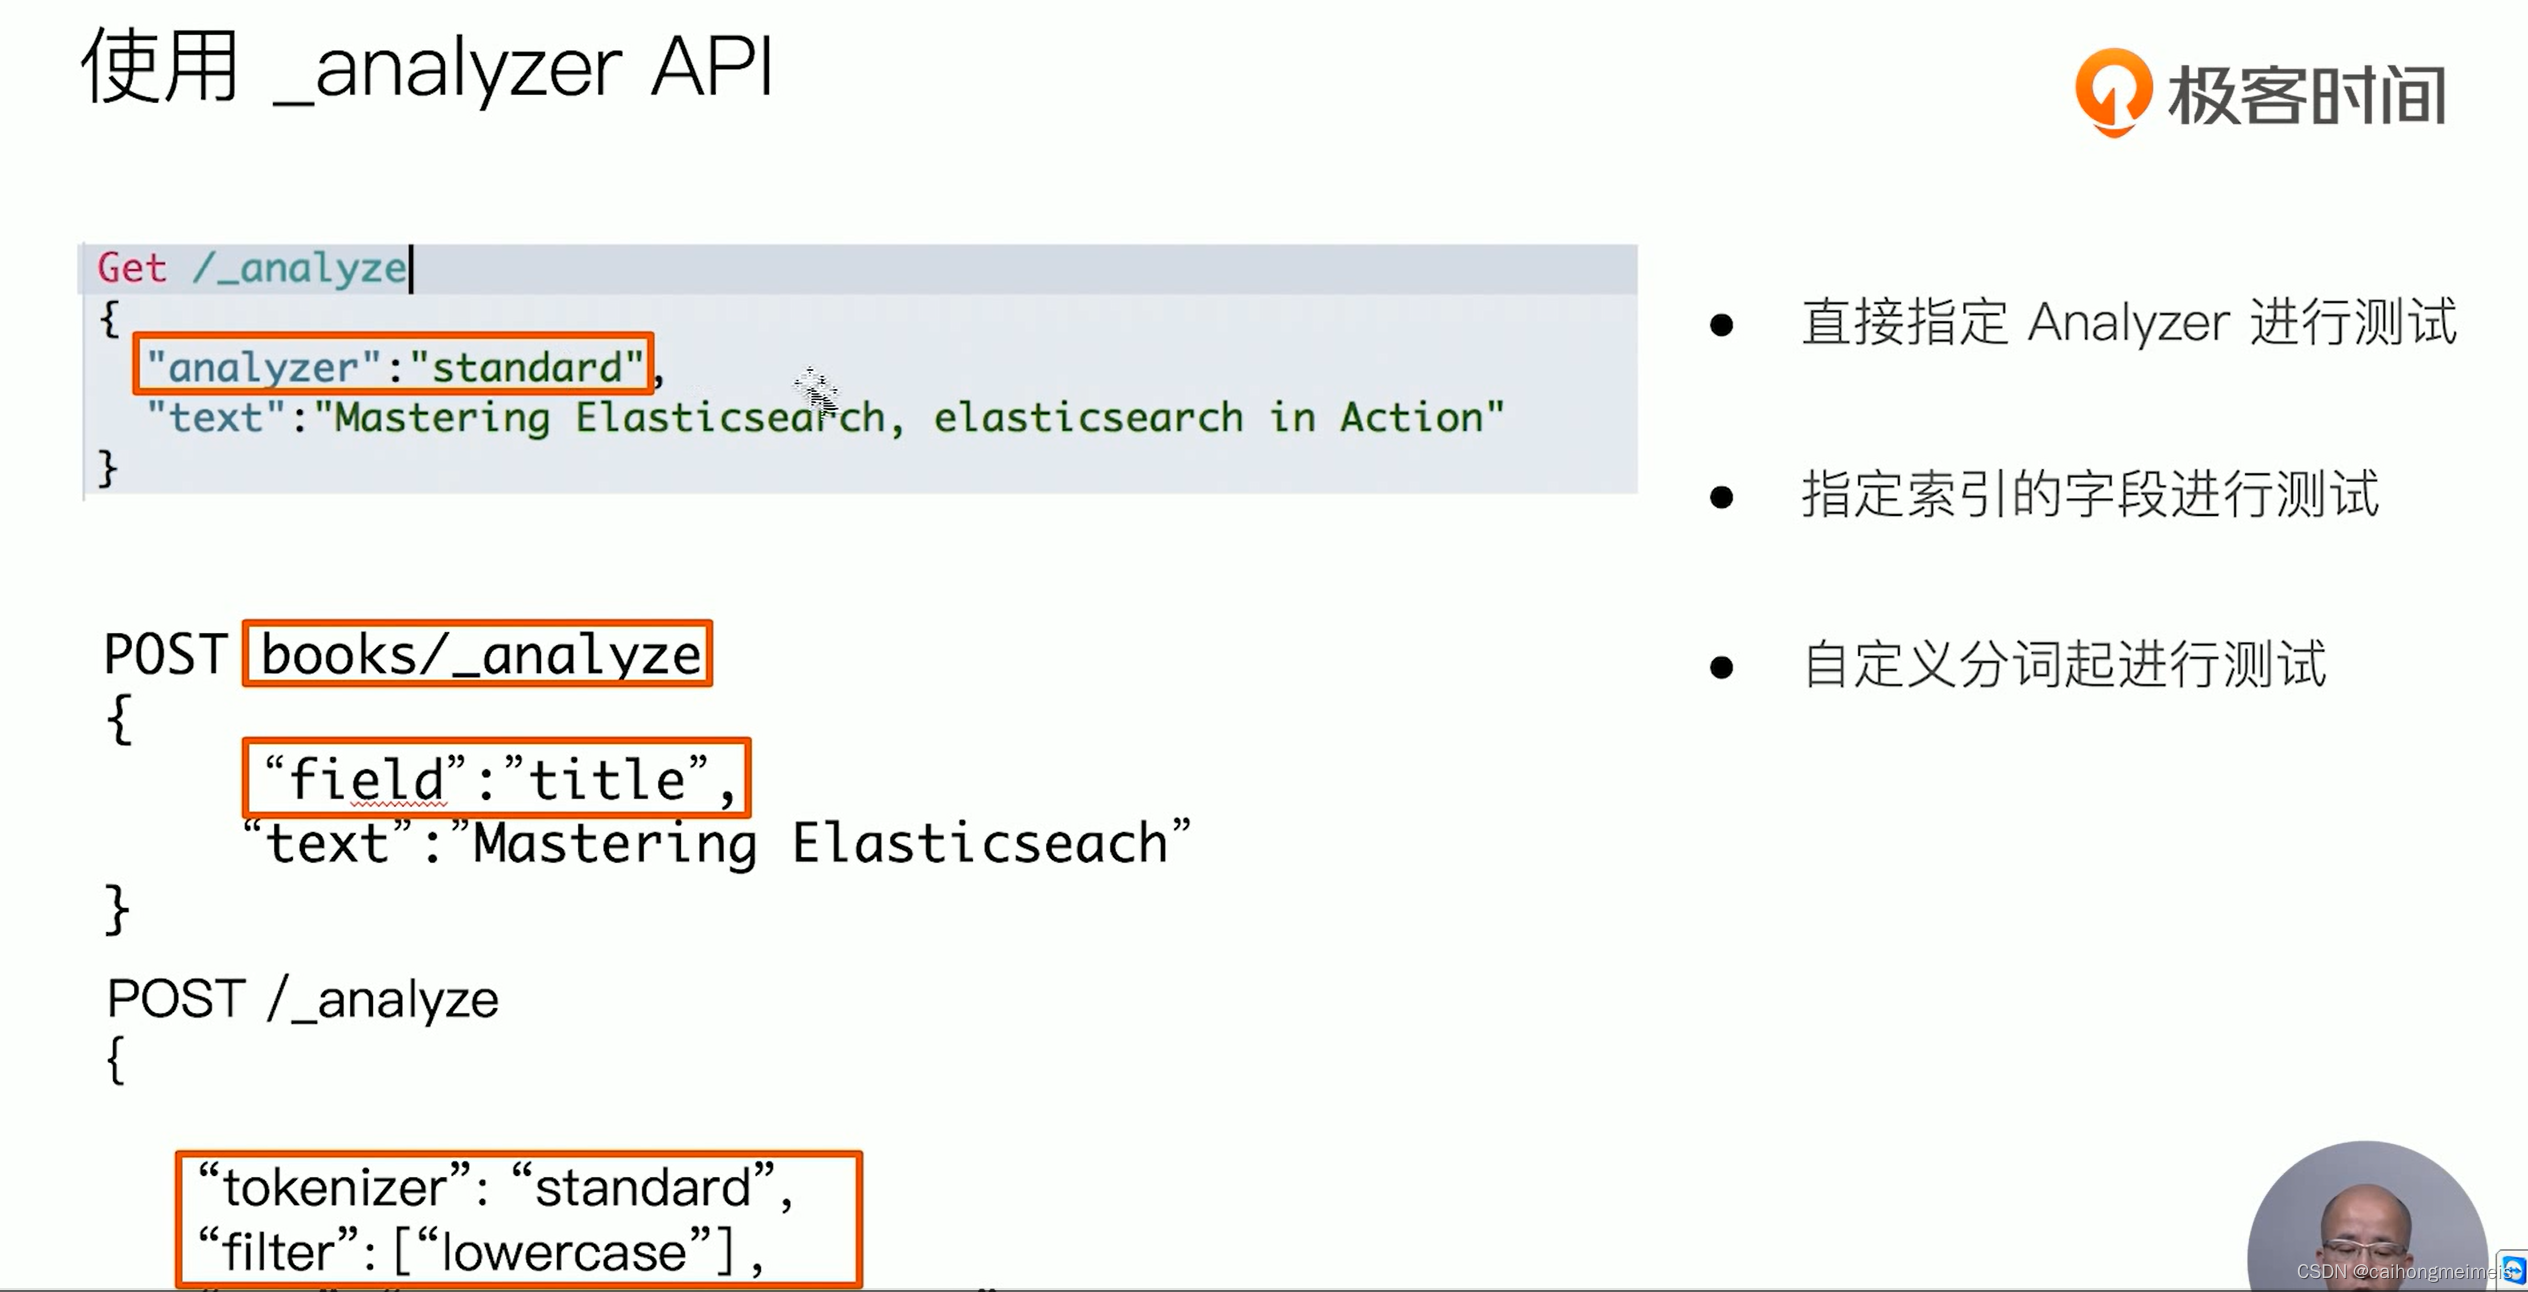
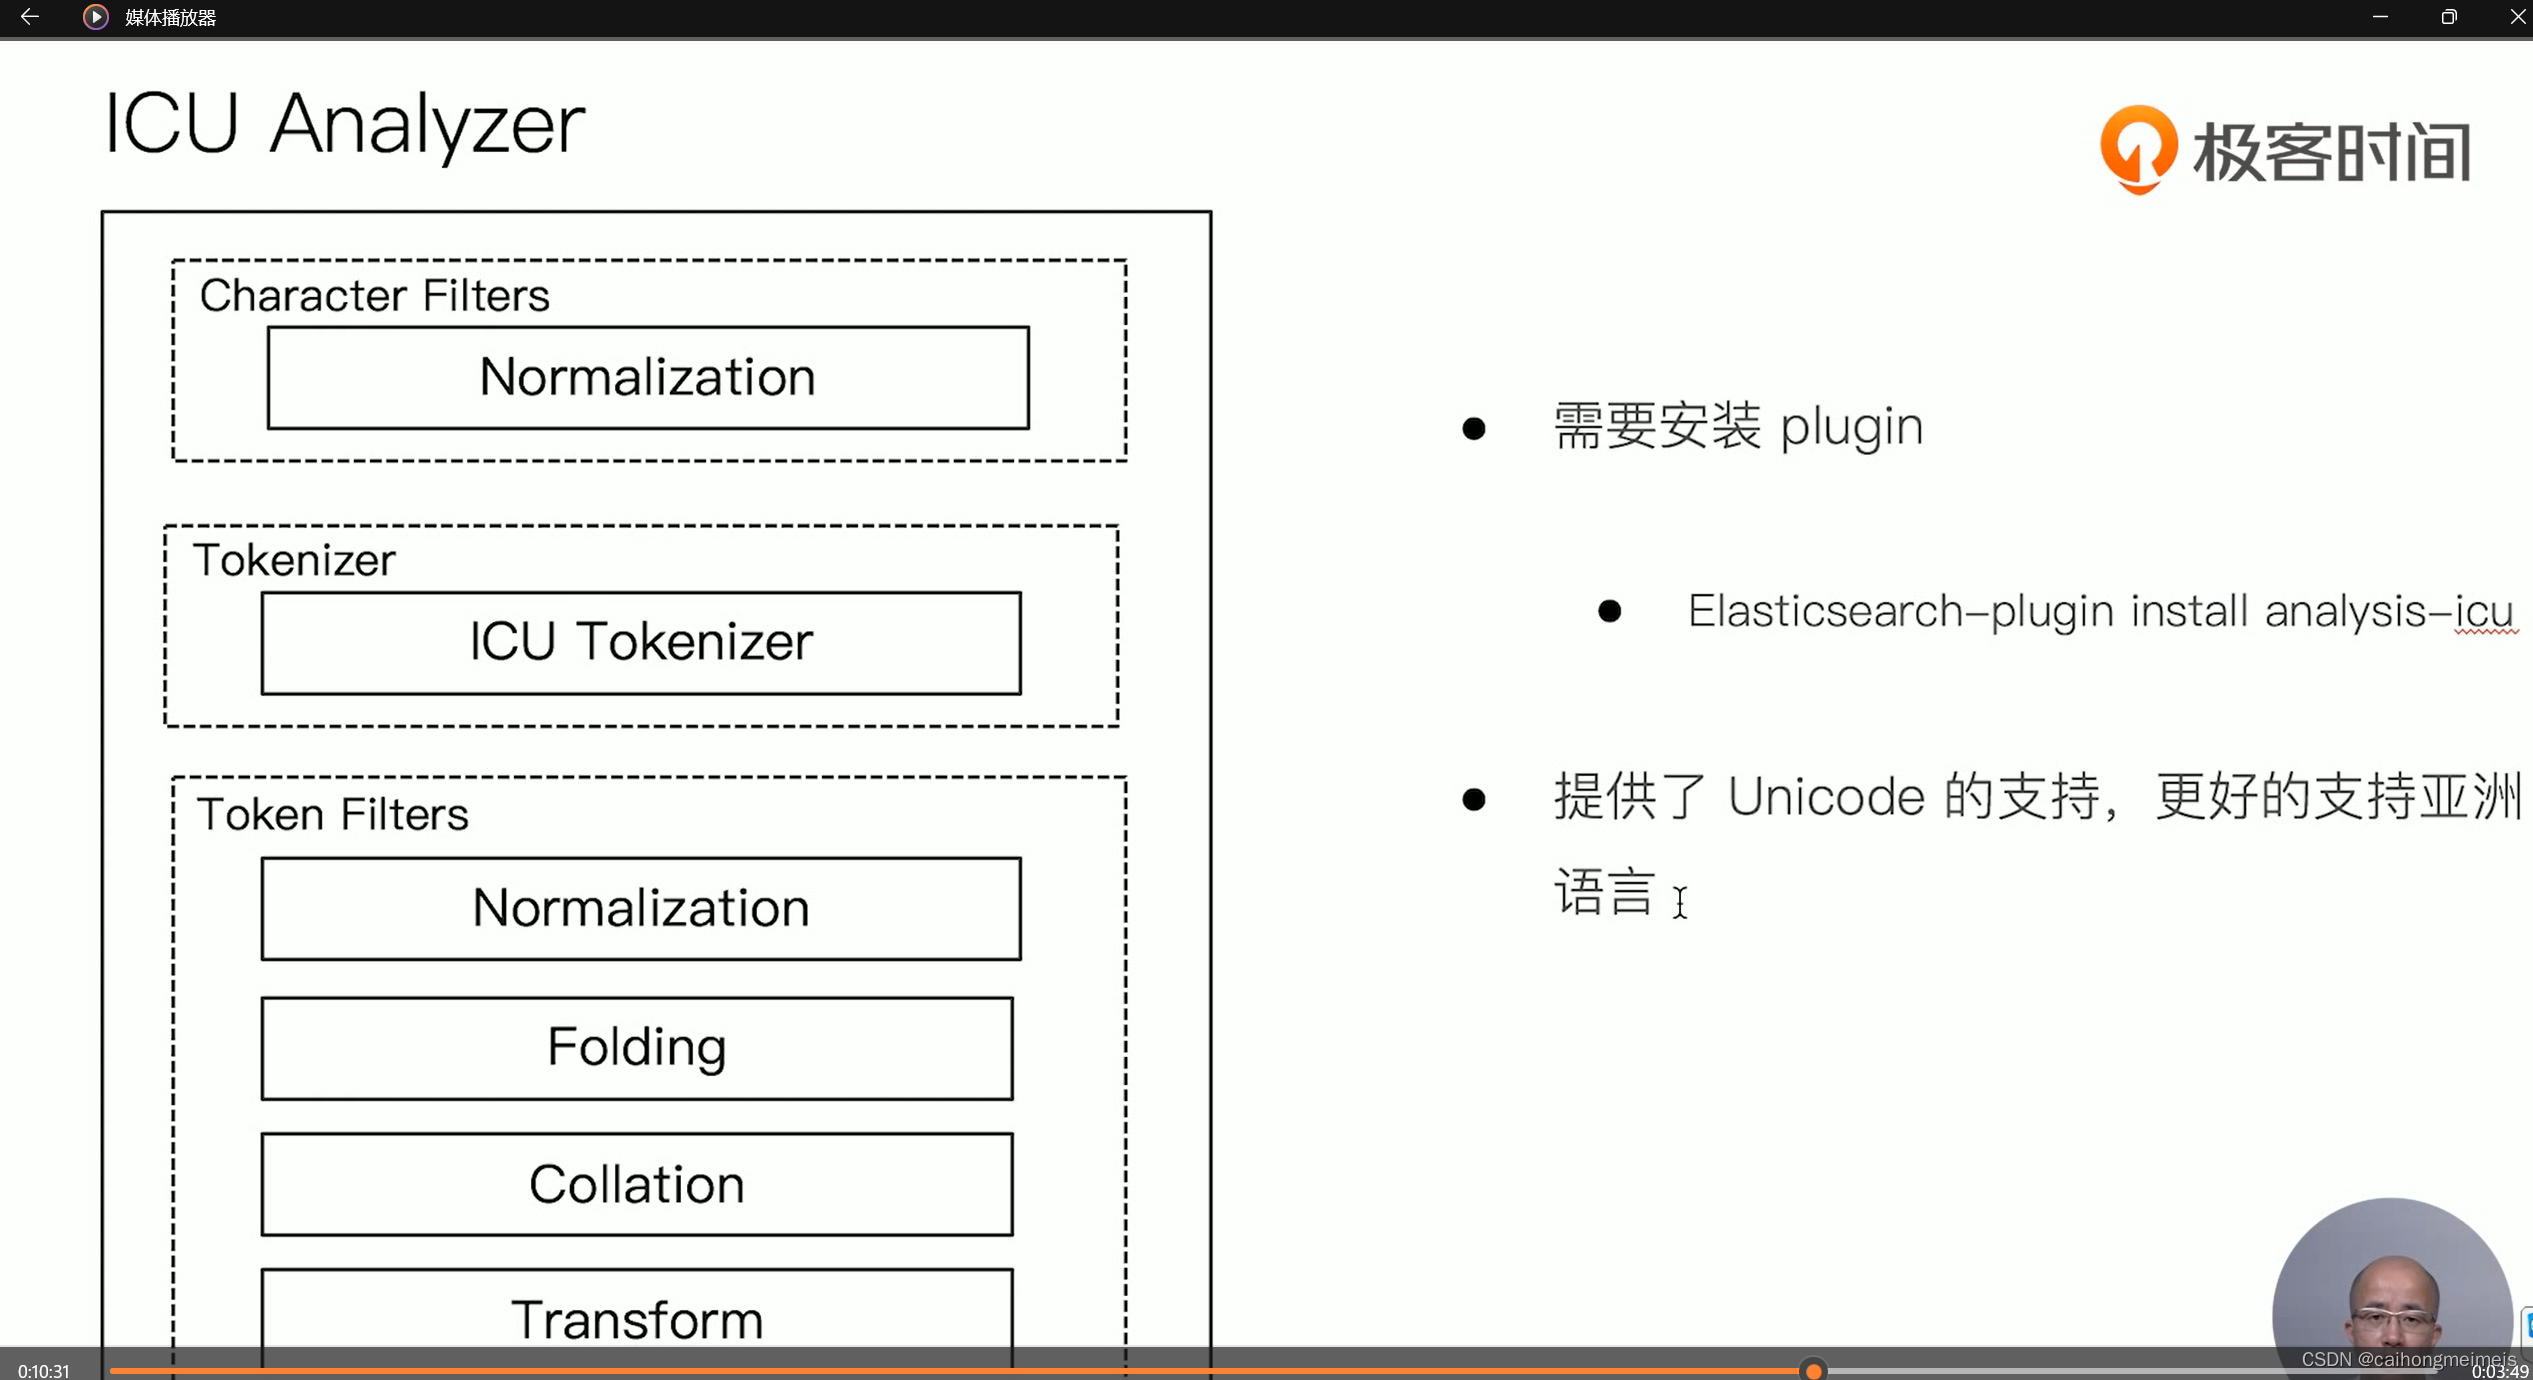
Thulac分词器
五、search API
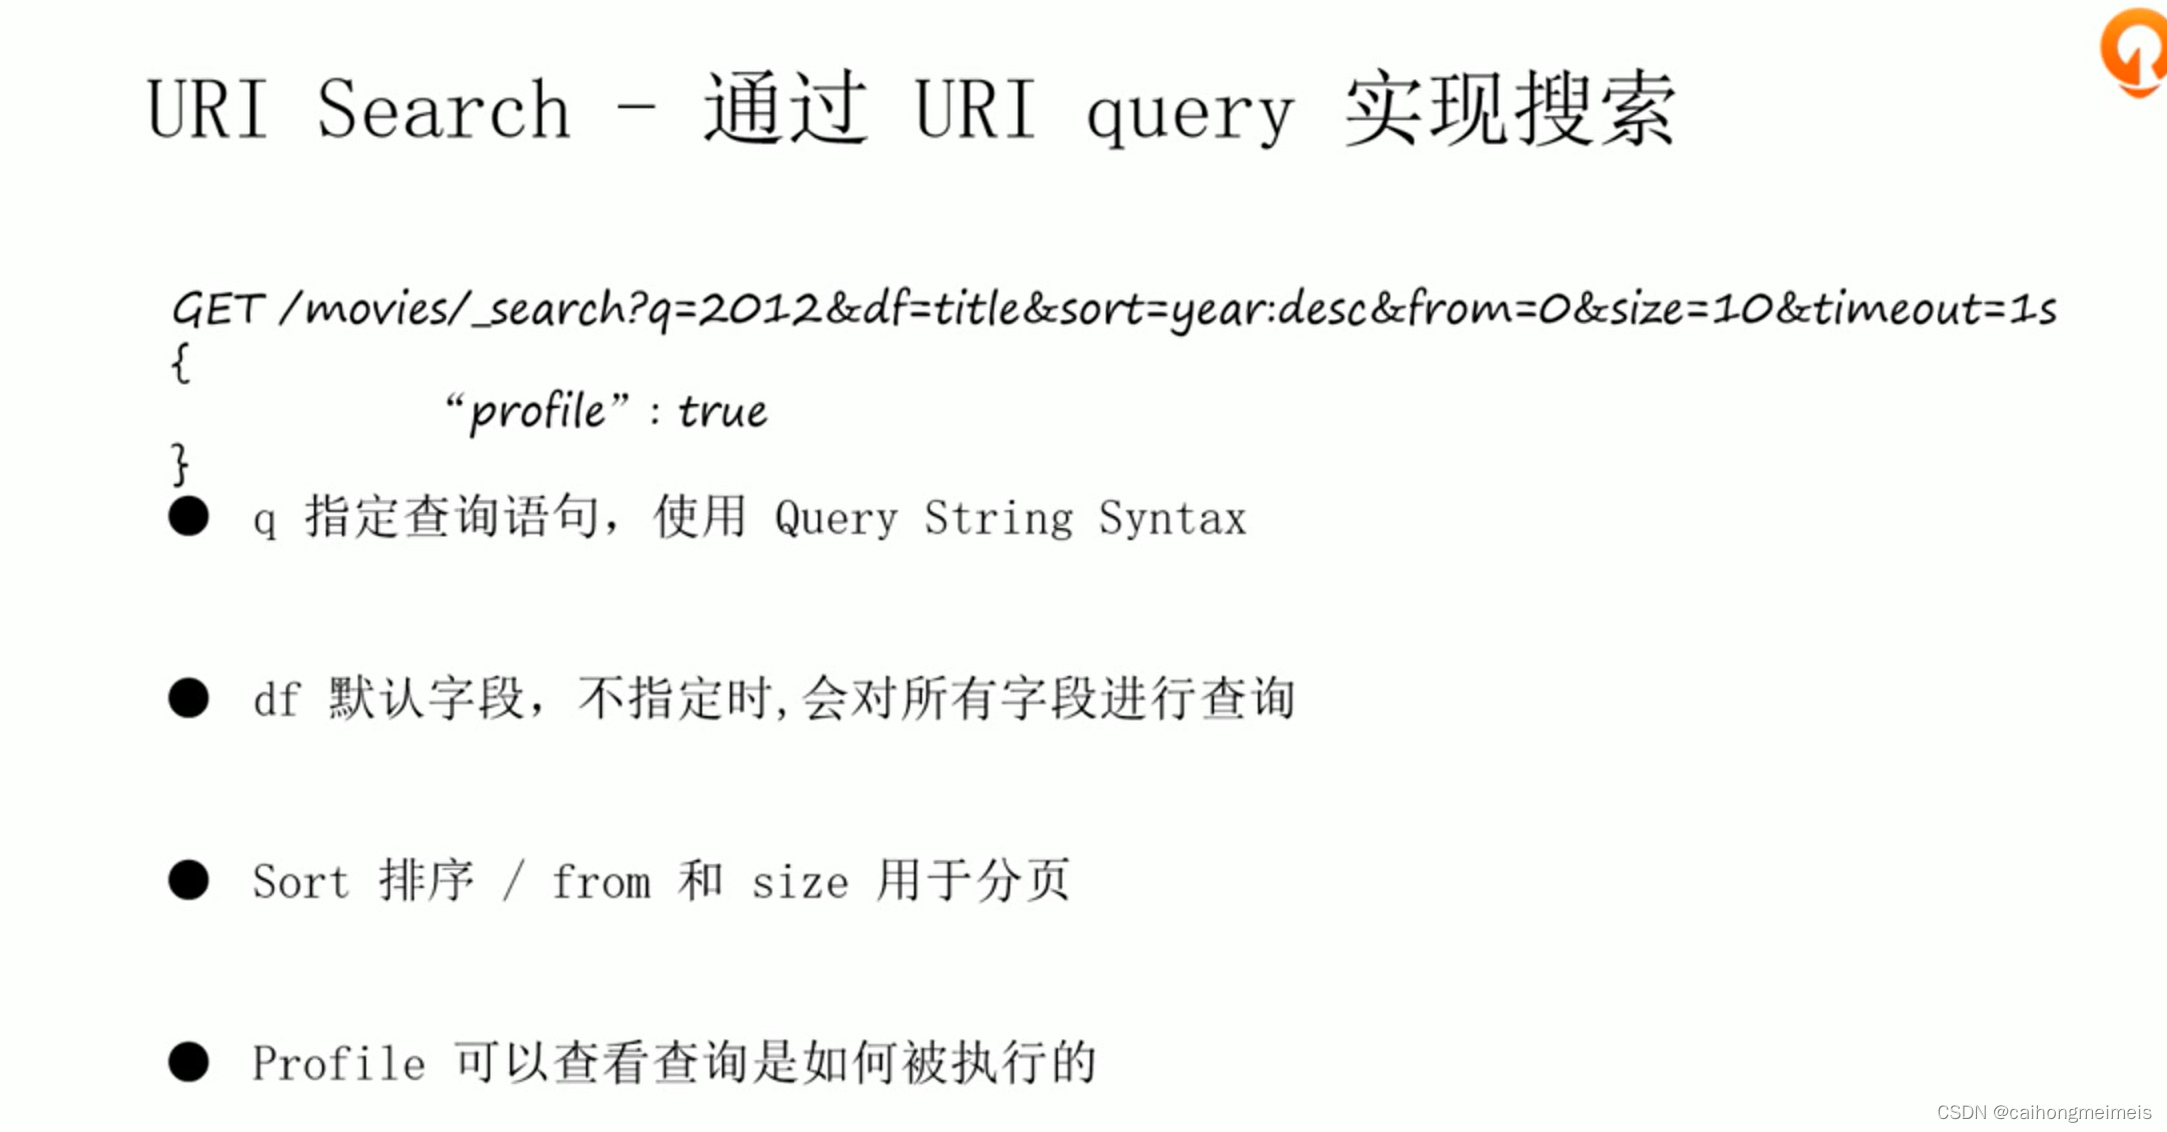
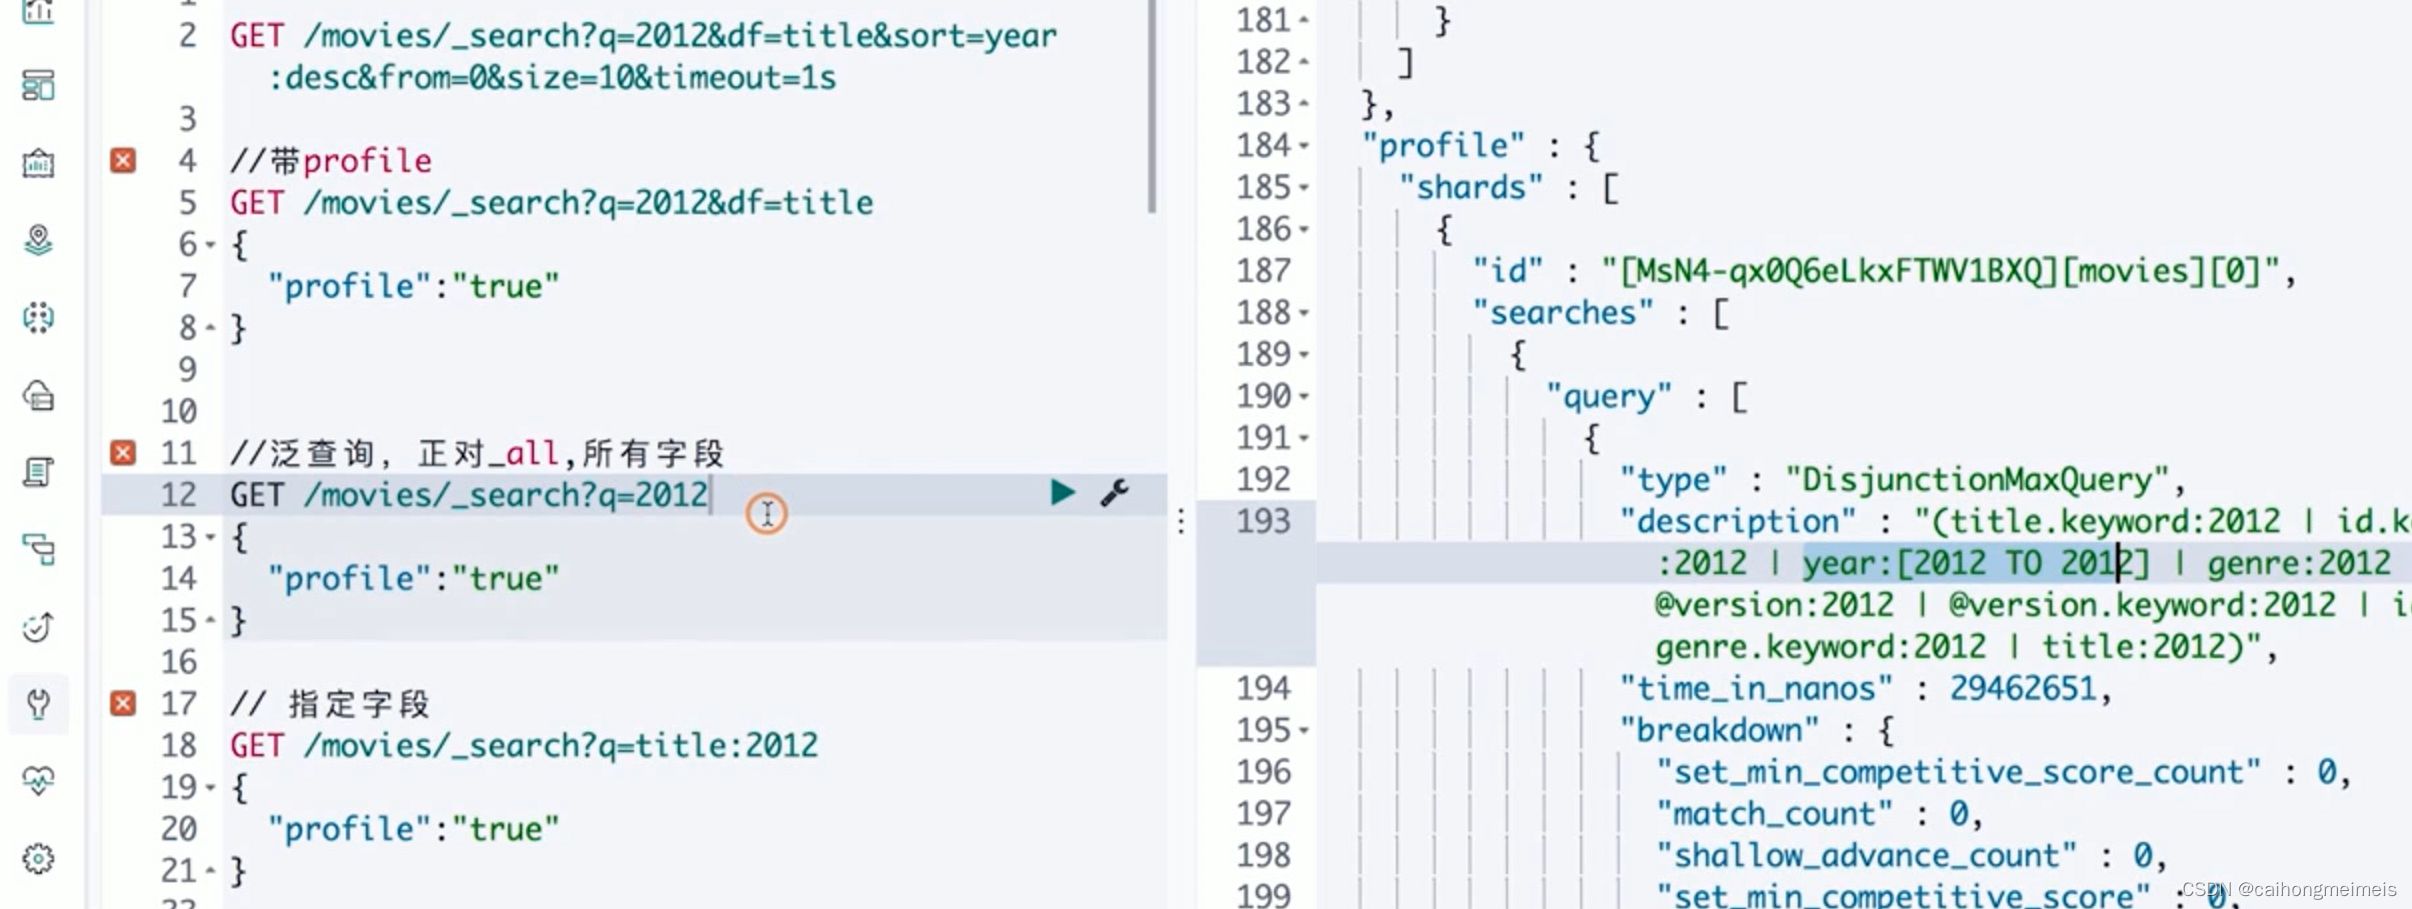
5.1 URI Search
在URL 中使用查询参数
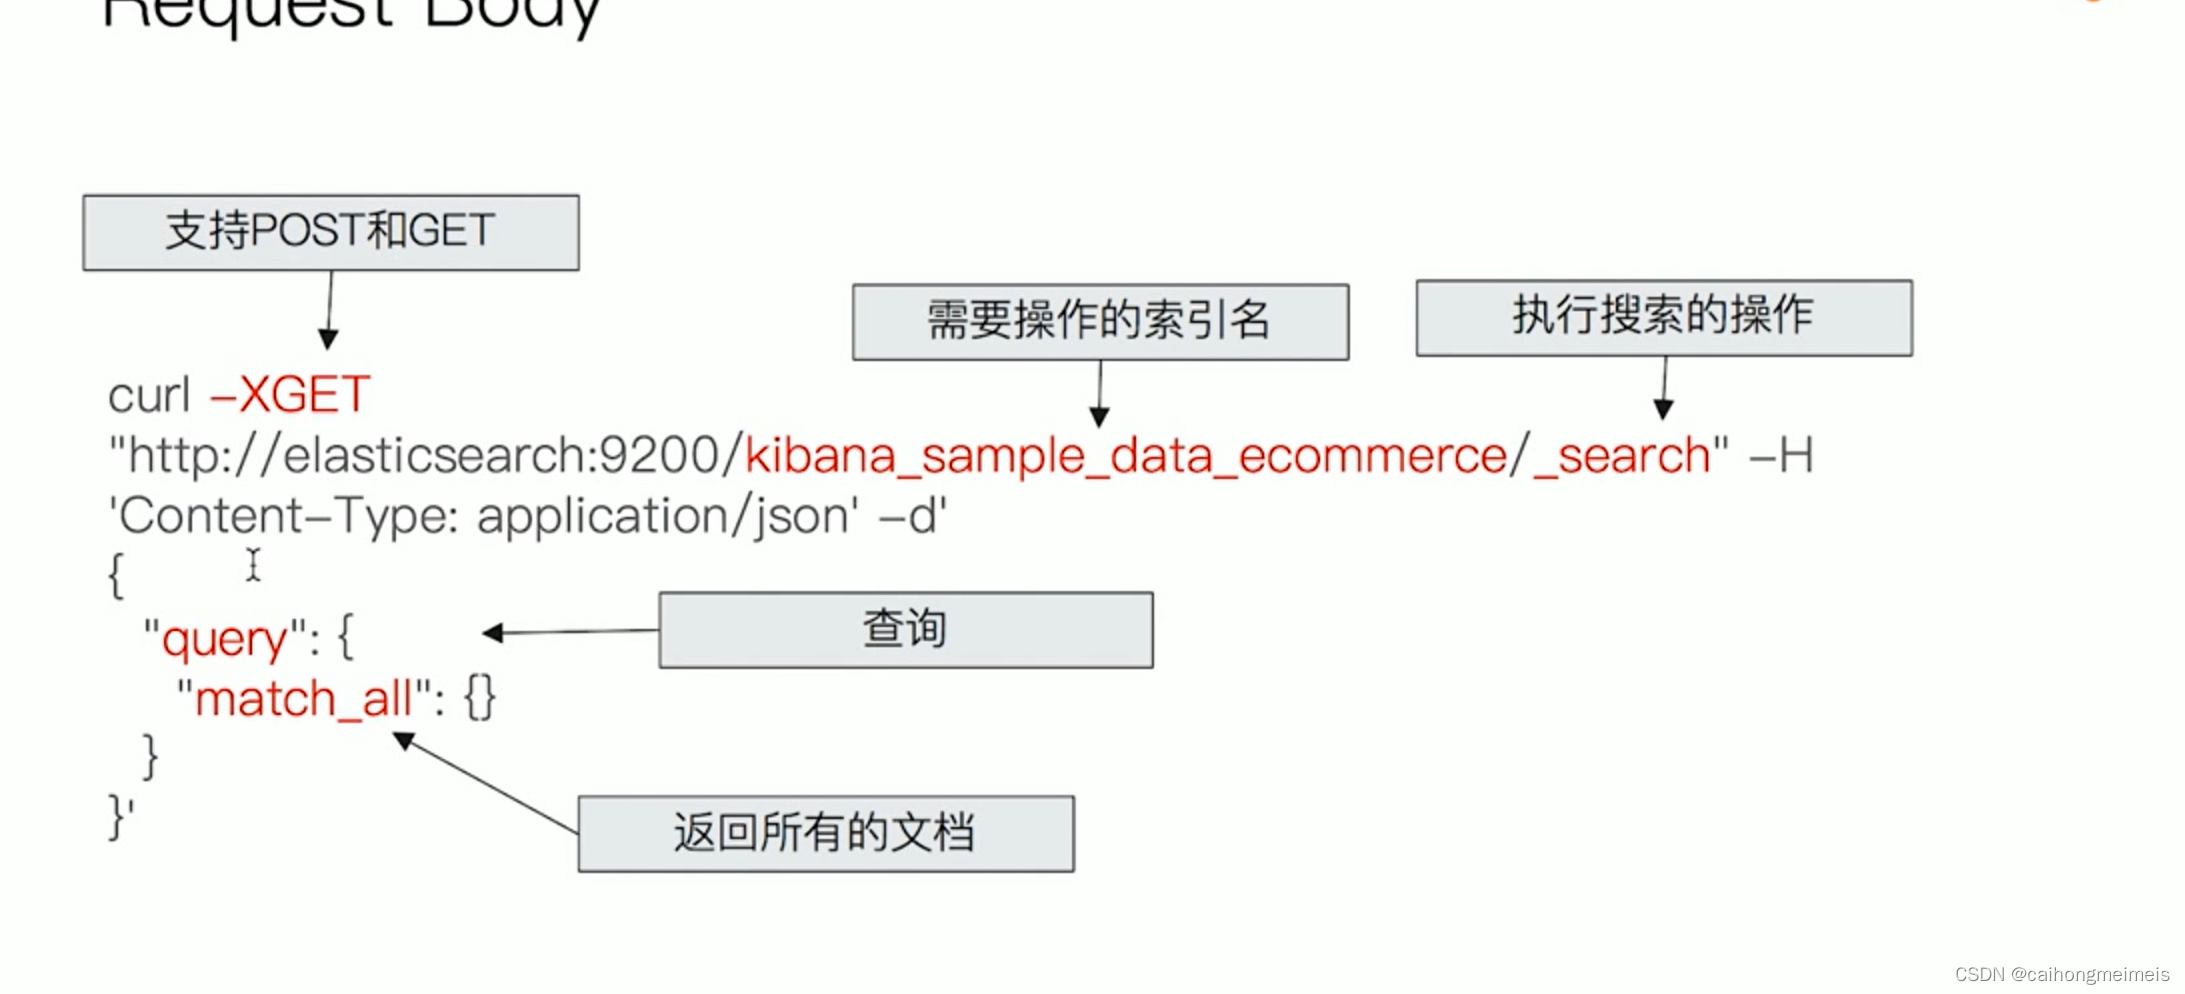
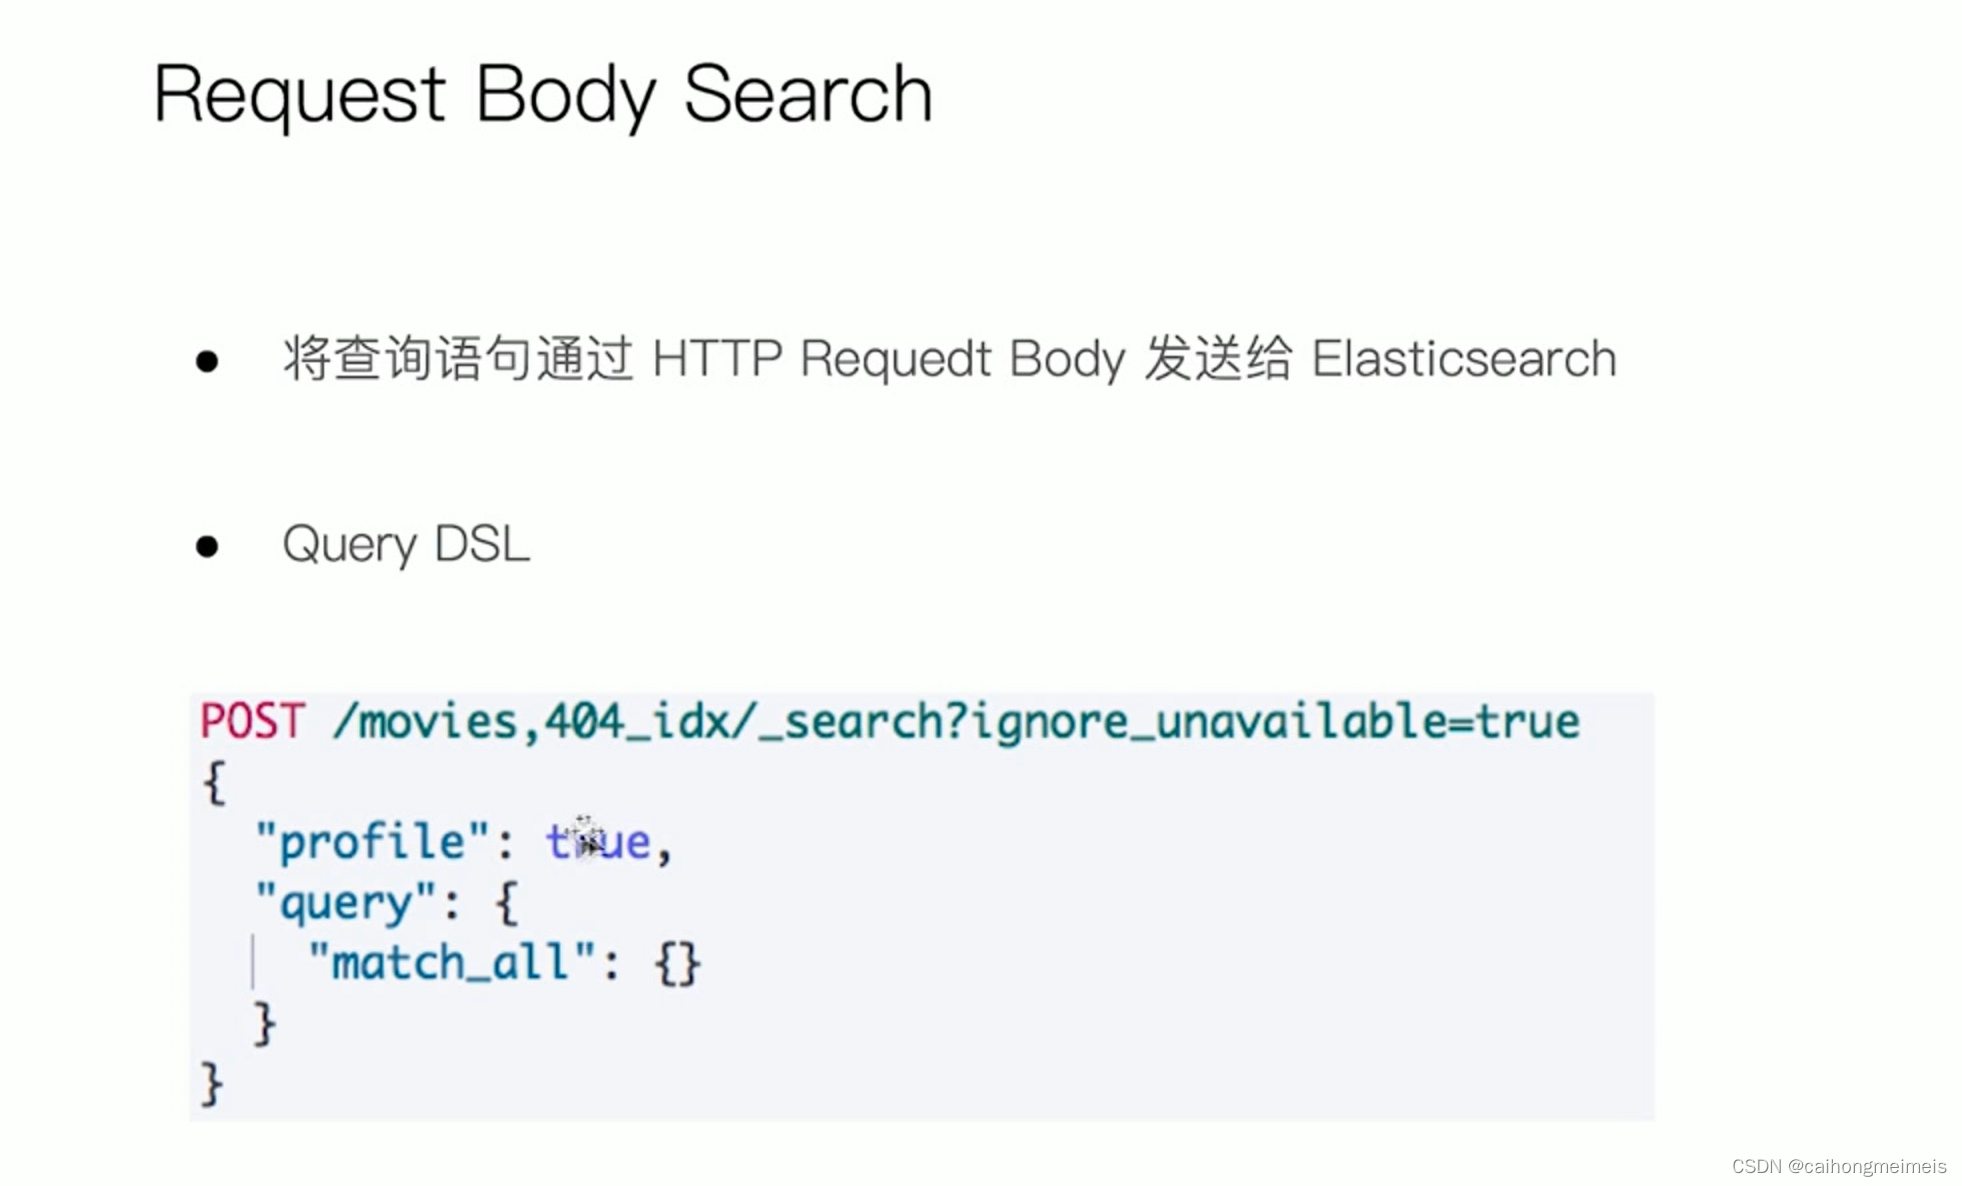
5.2 Request Body Search
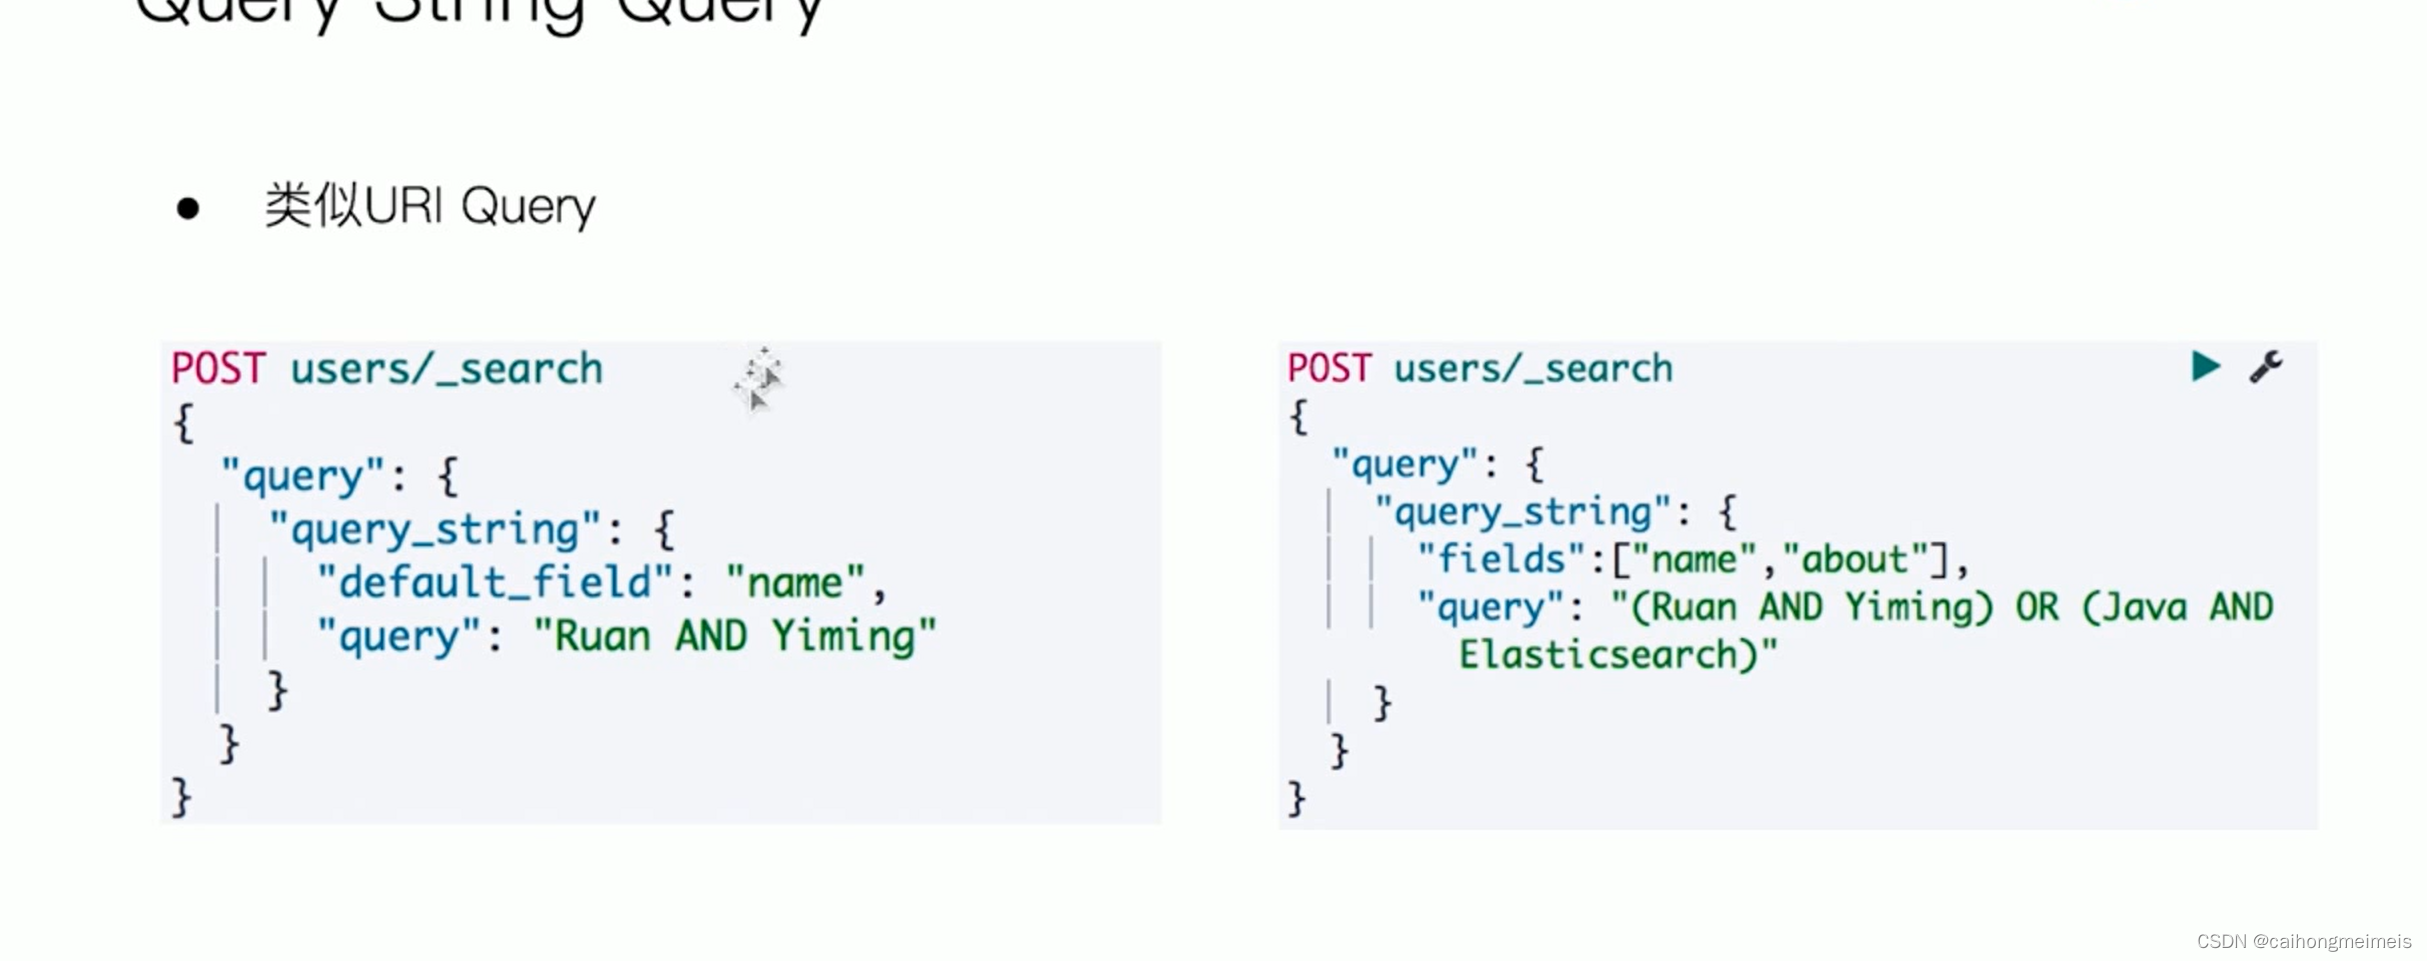
使用Elasticsearch 提供的,基于JSON 格式的更加完备的 Query Domain Specific Language(DSL)
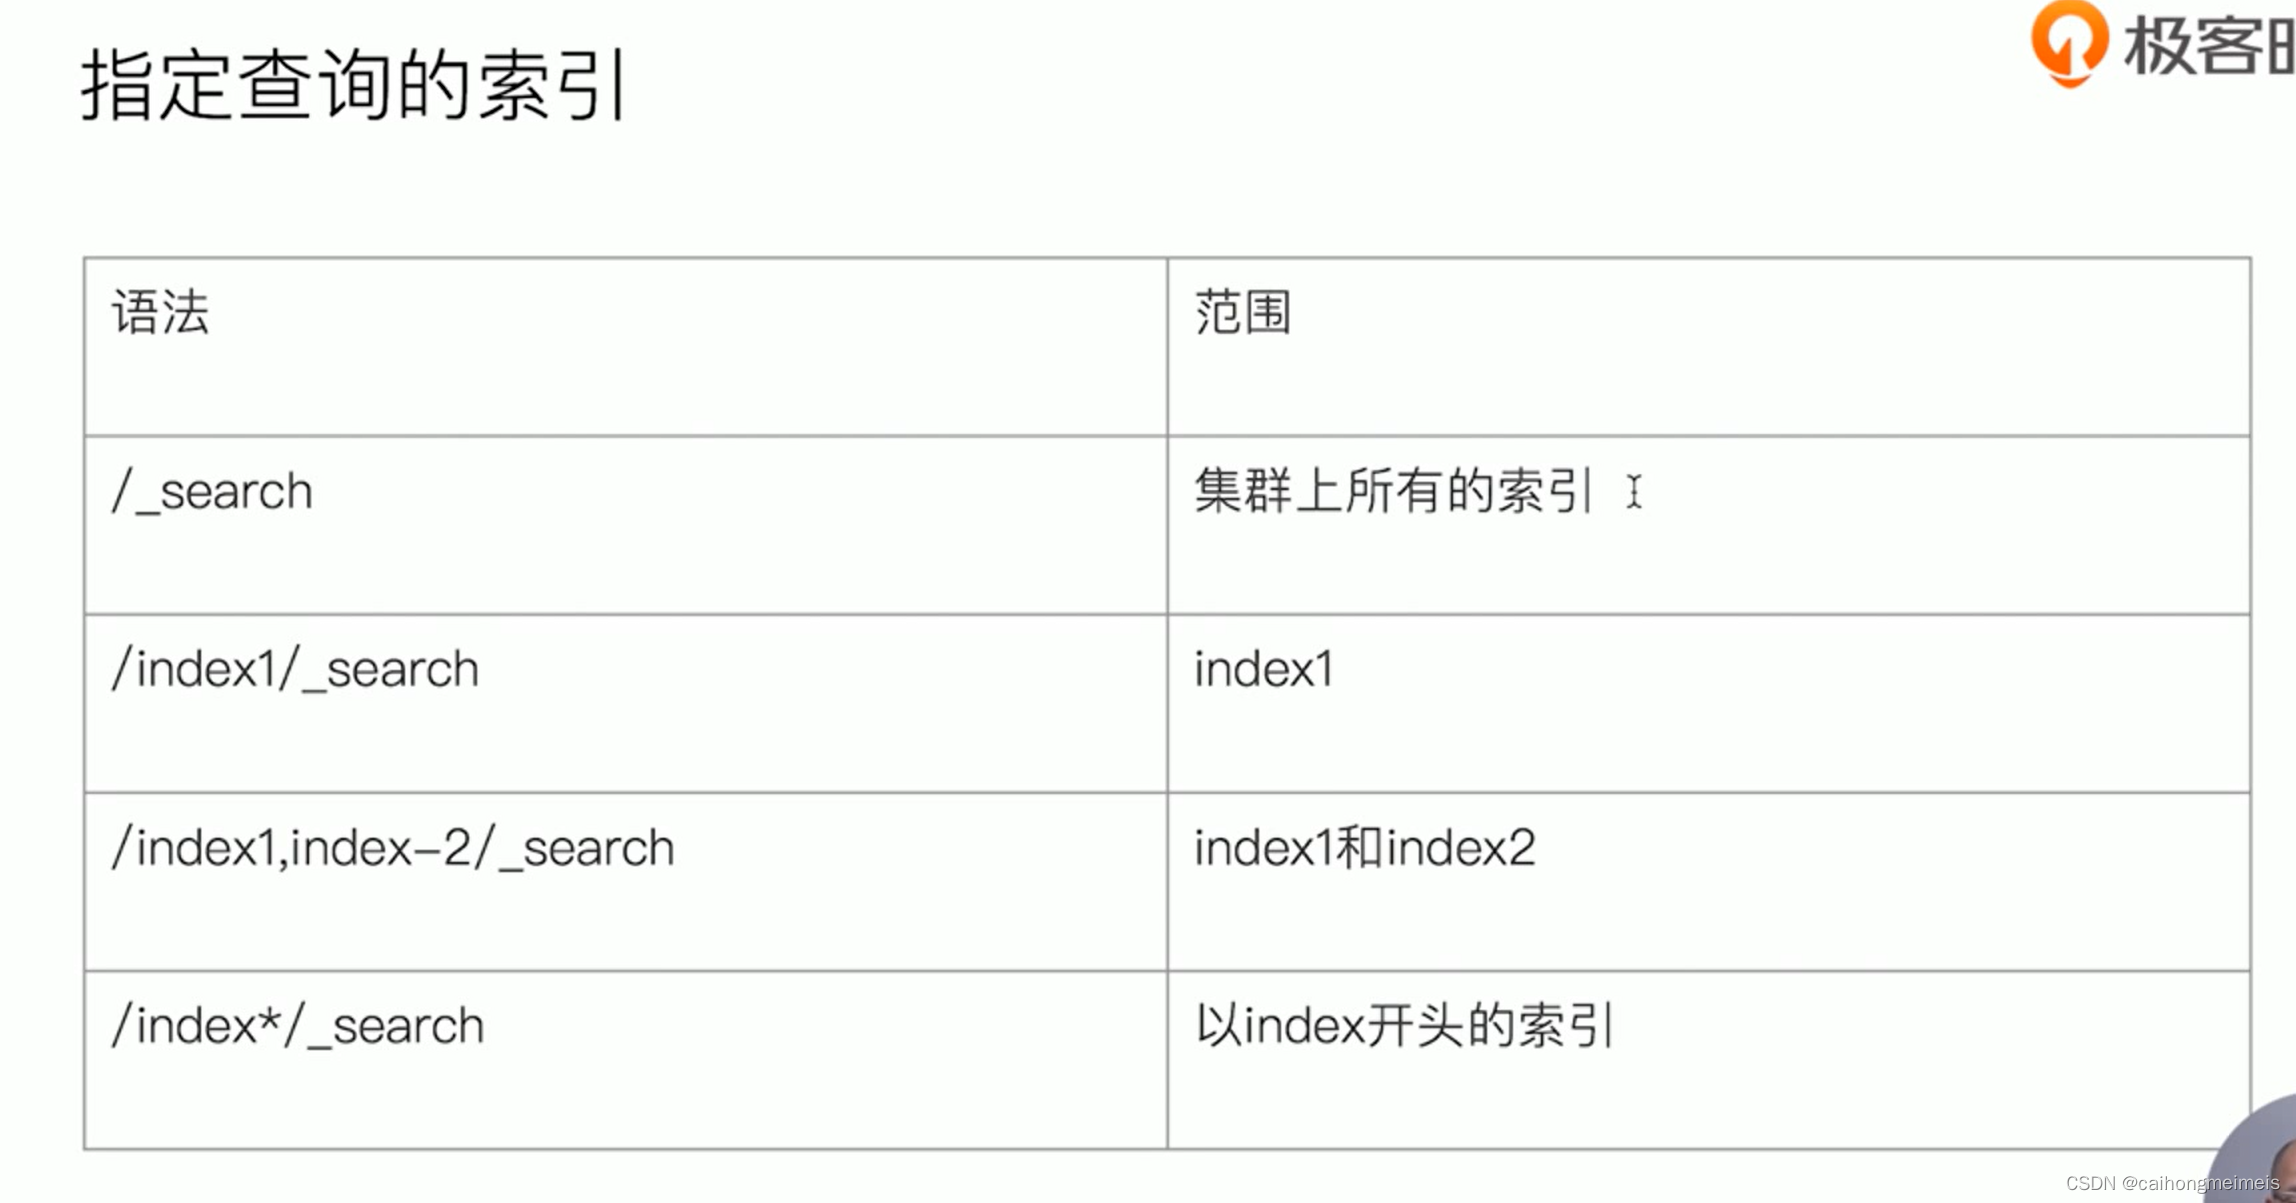
Request Body
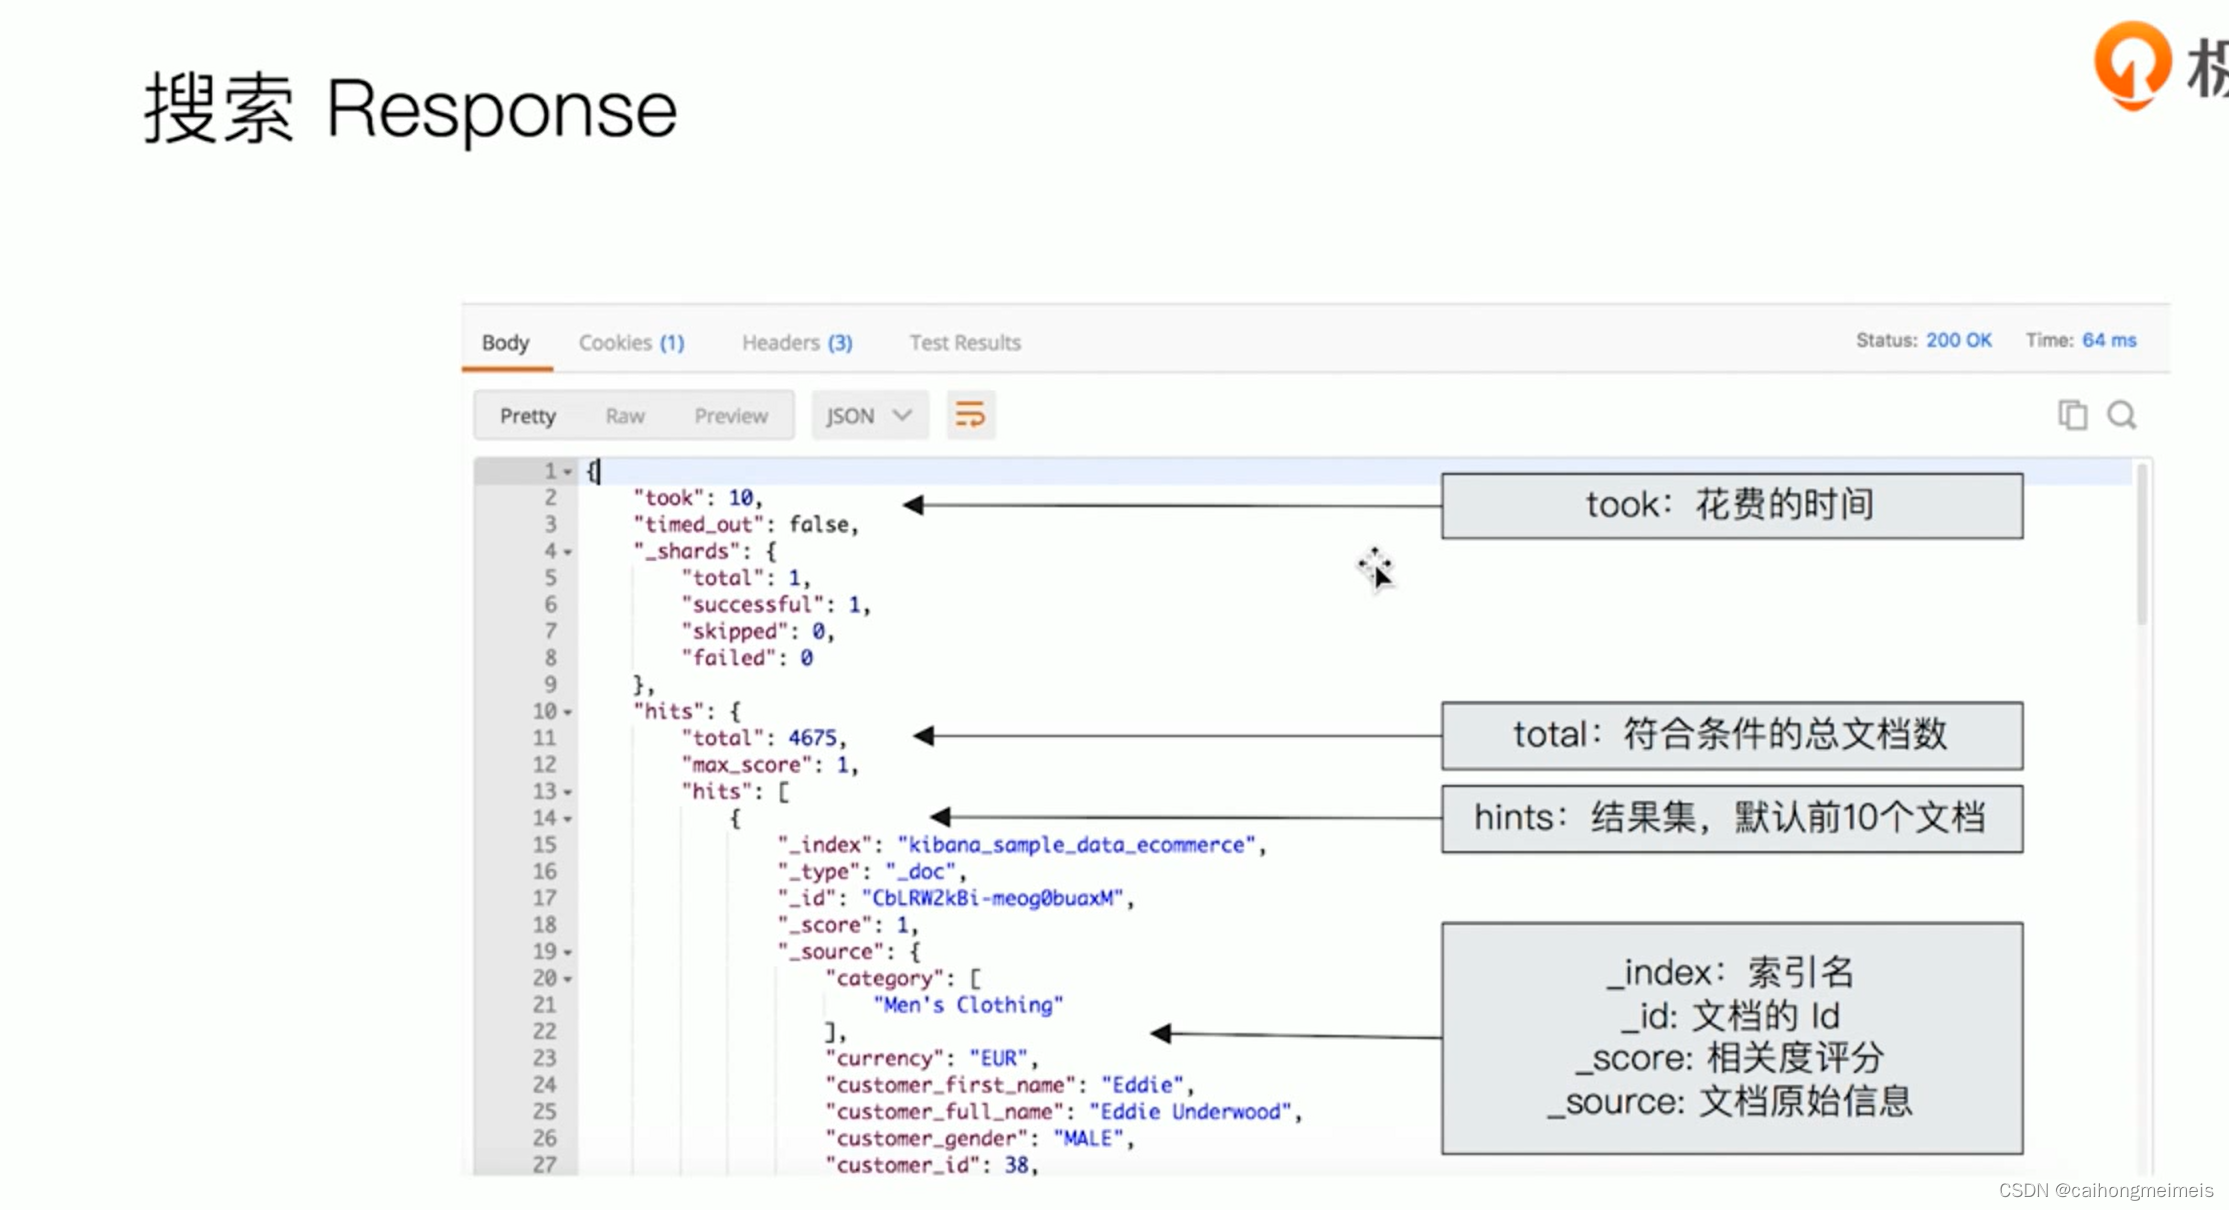
搜索 Response
URI Search - 通过URI query 实现搜索
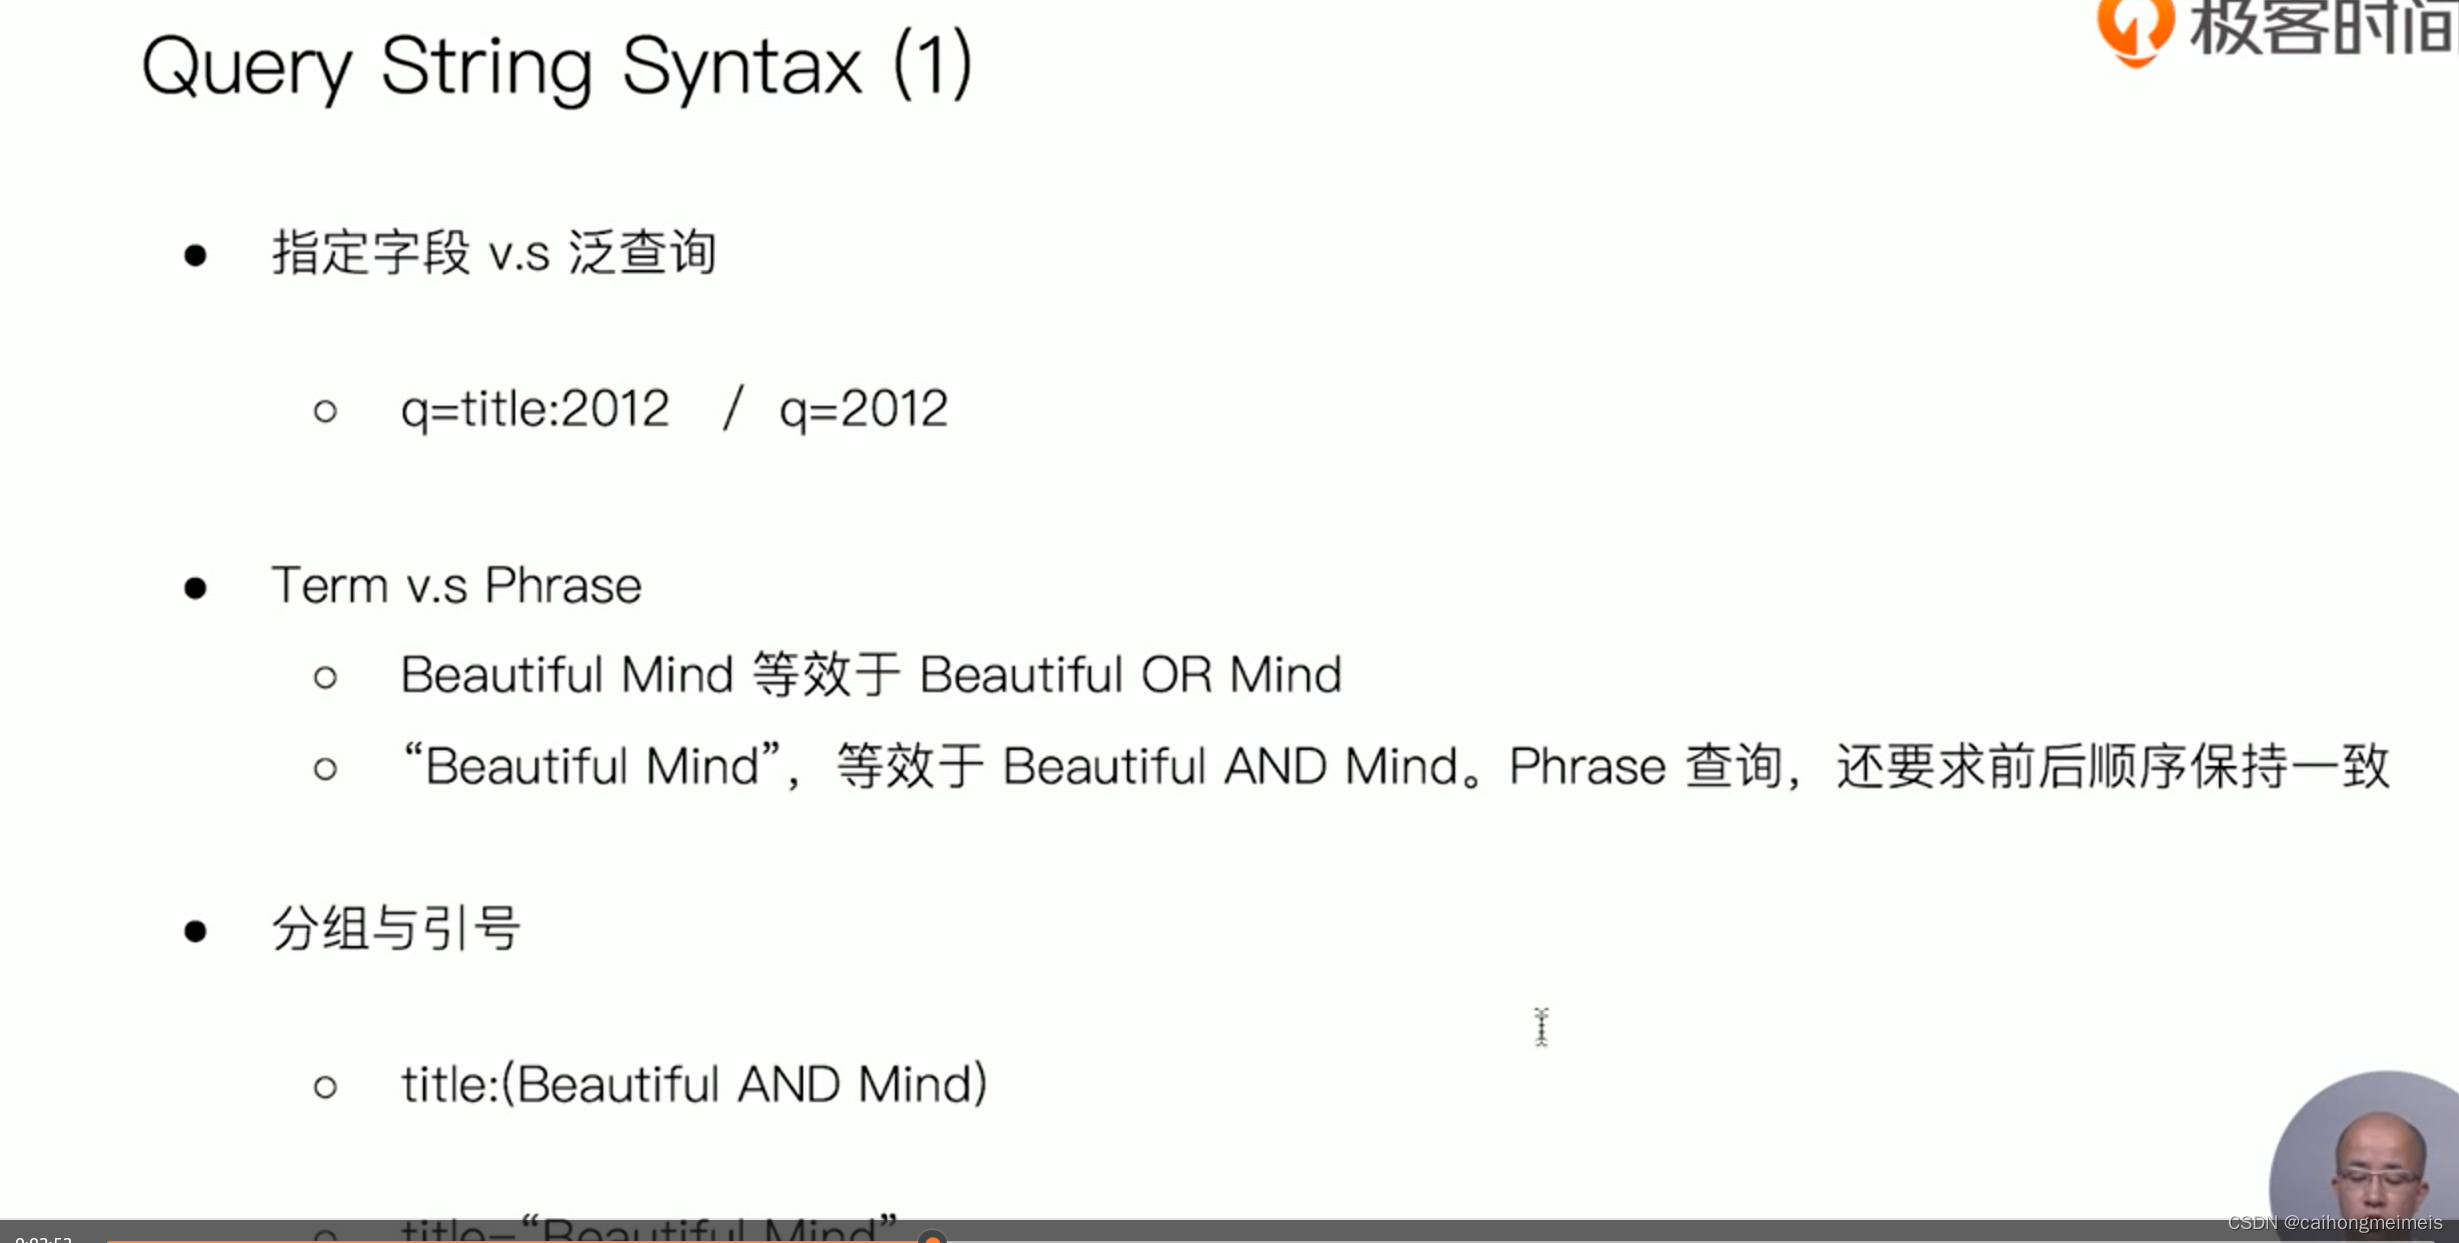
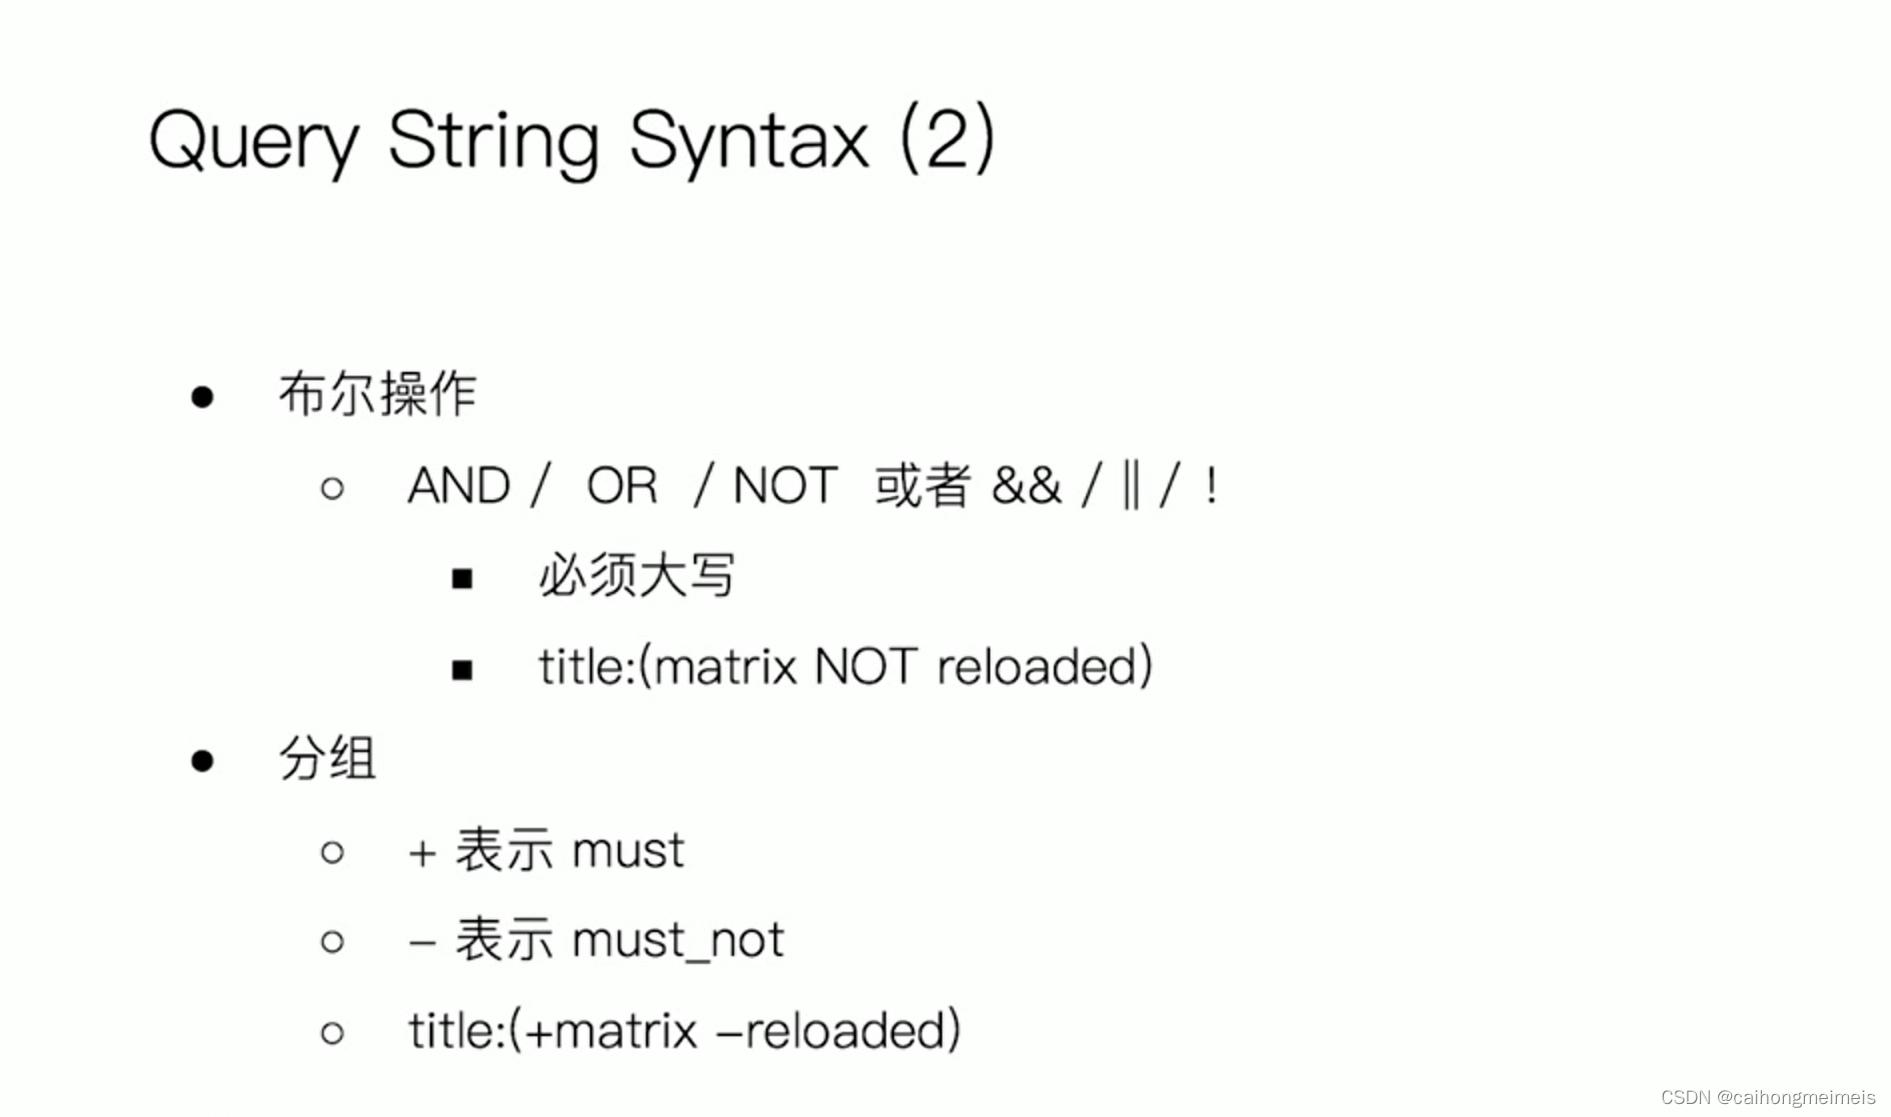
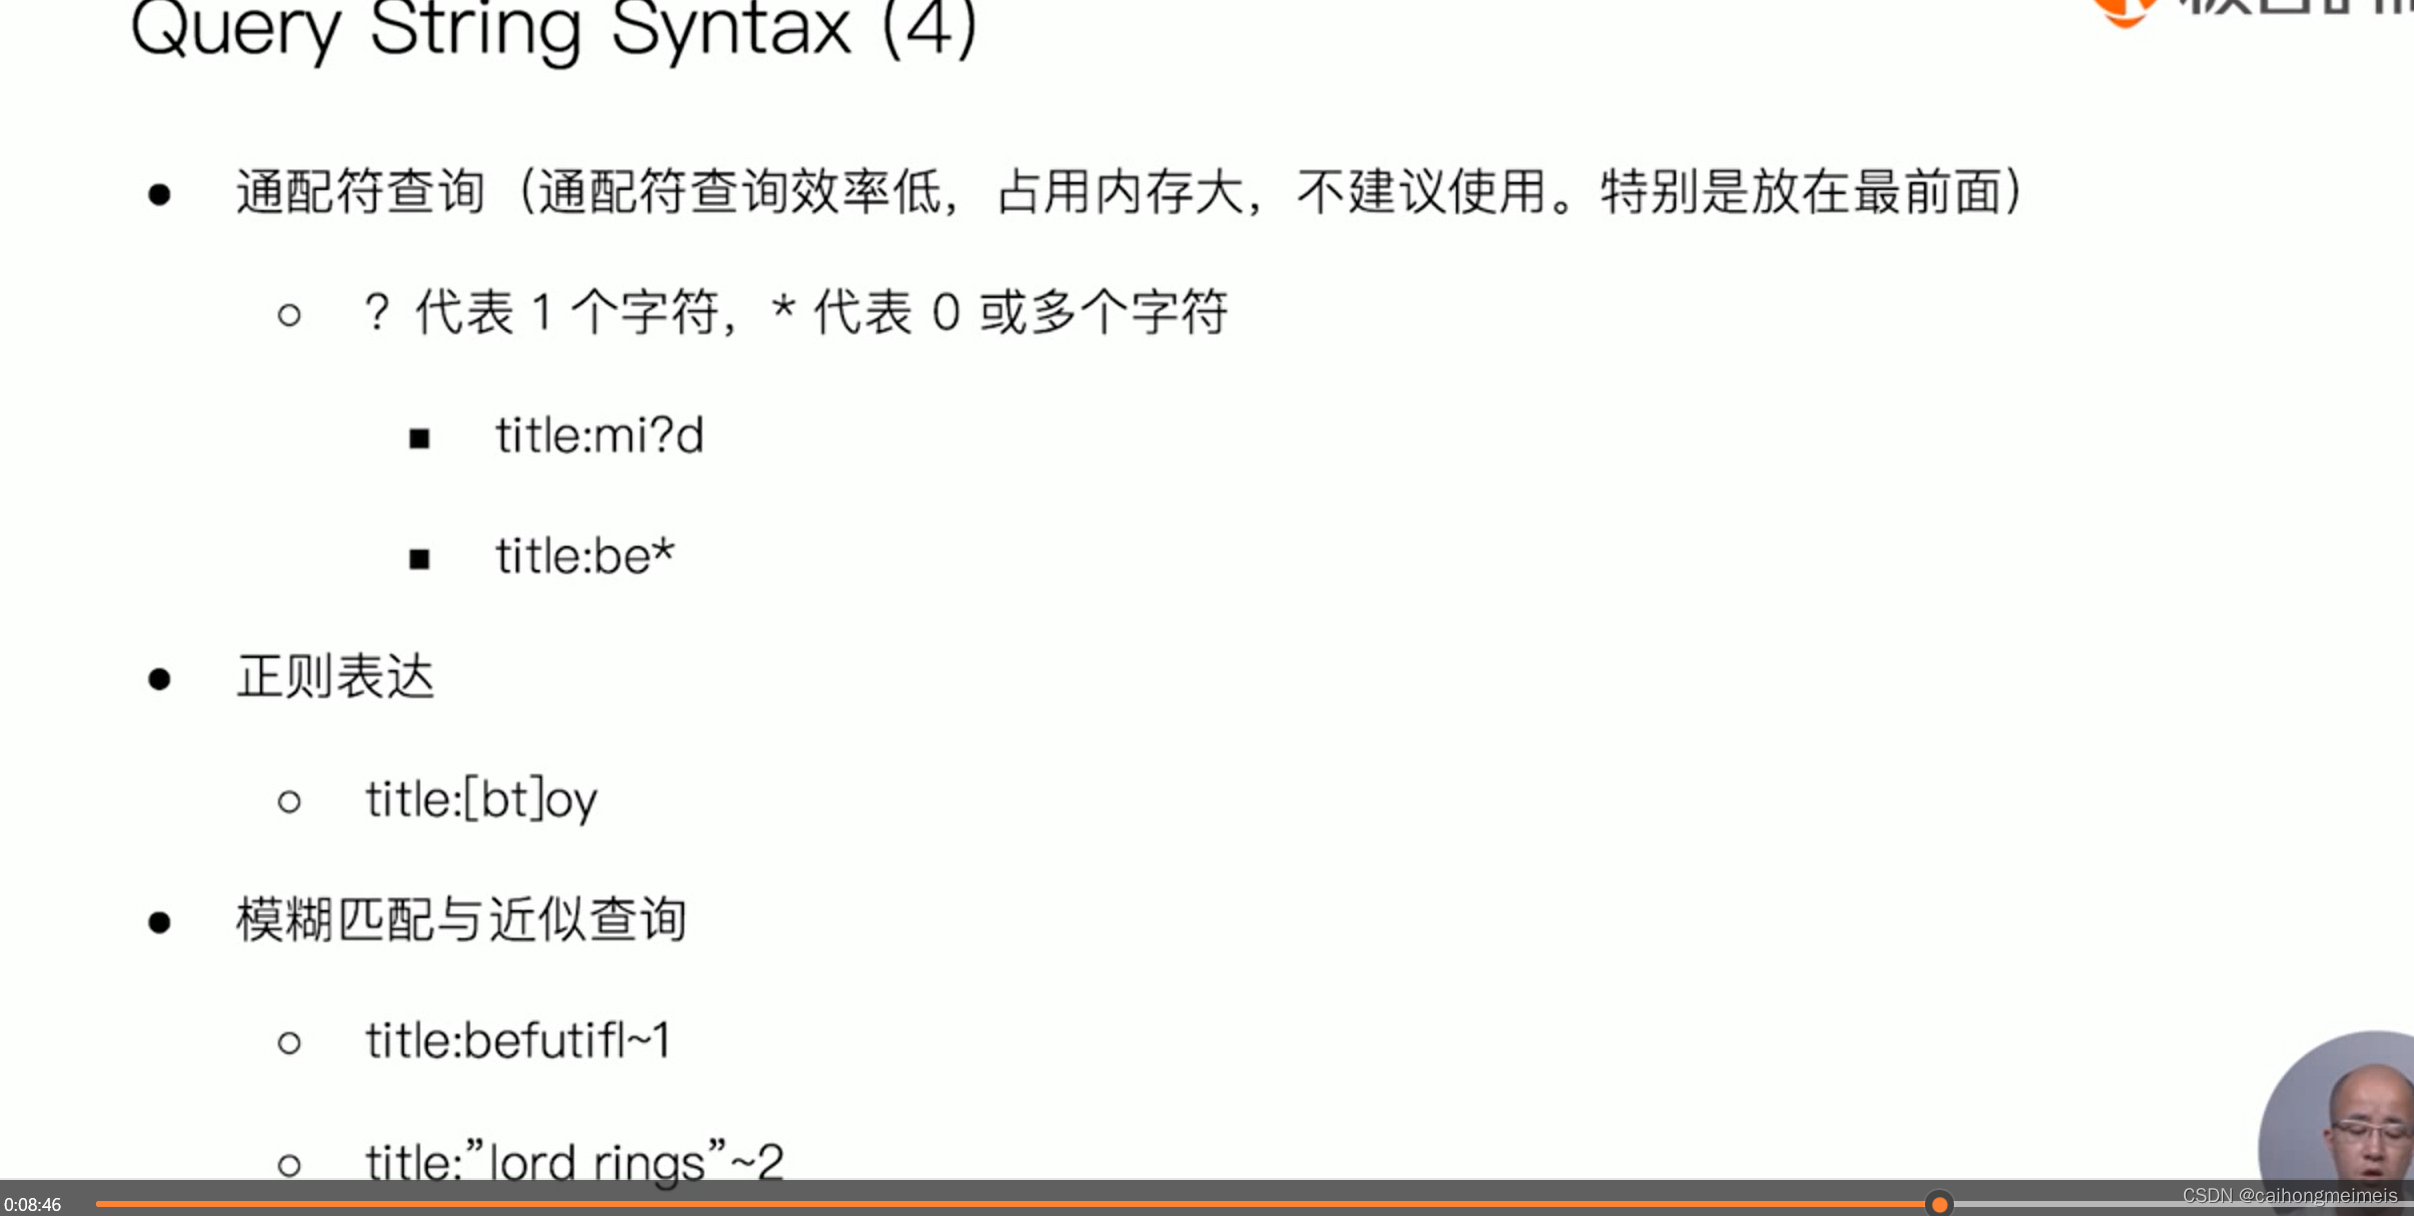
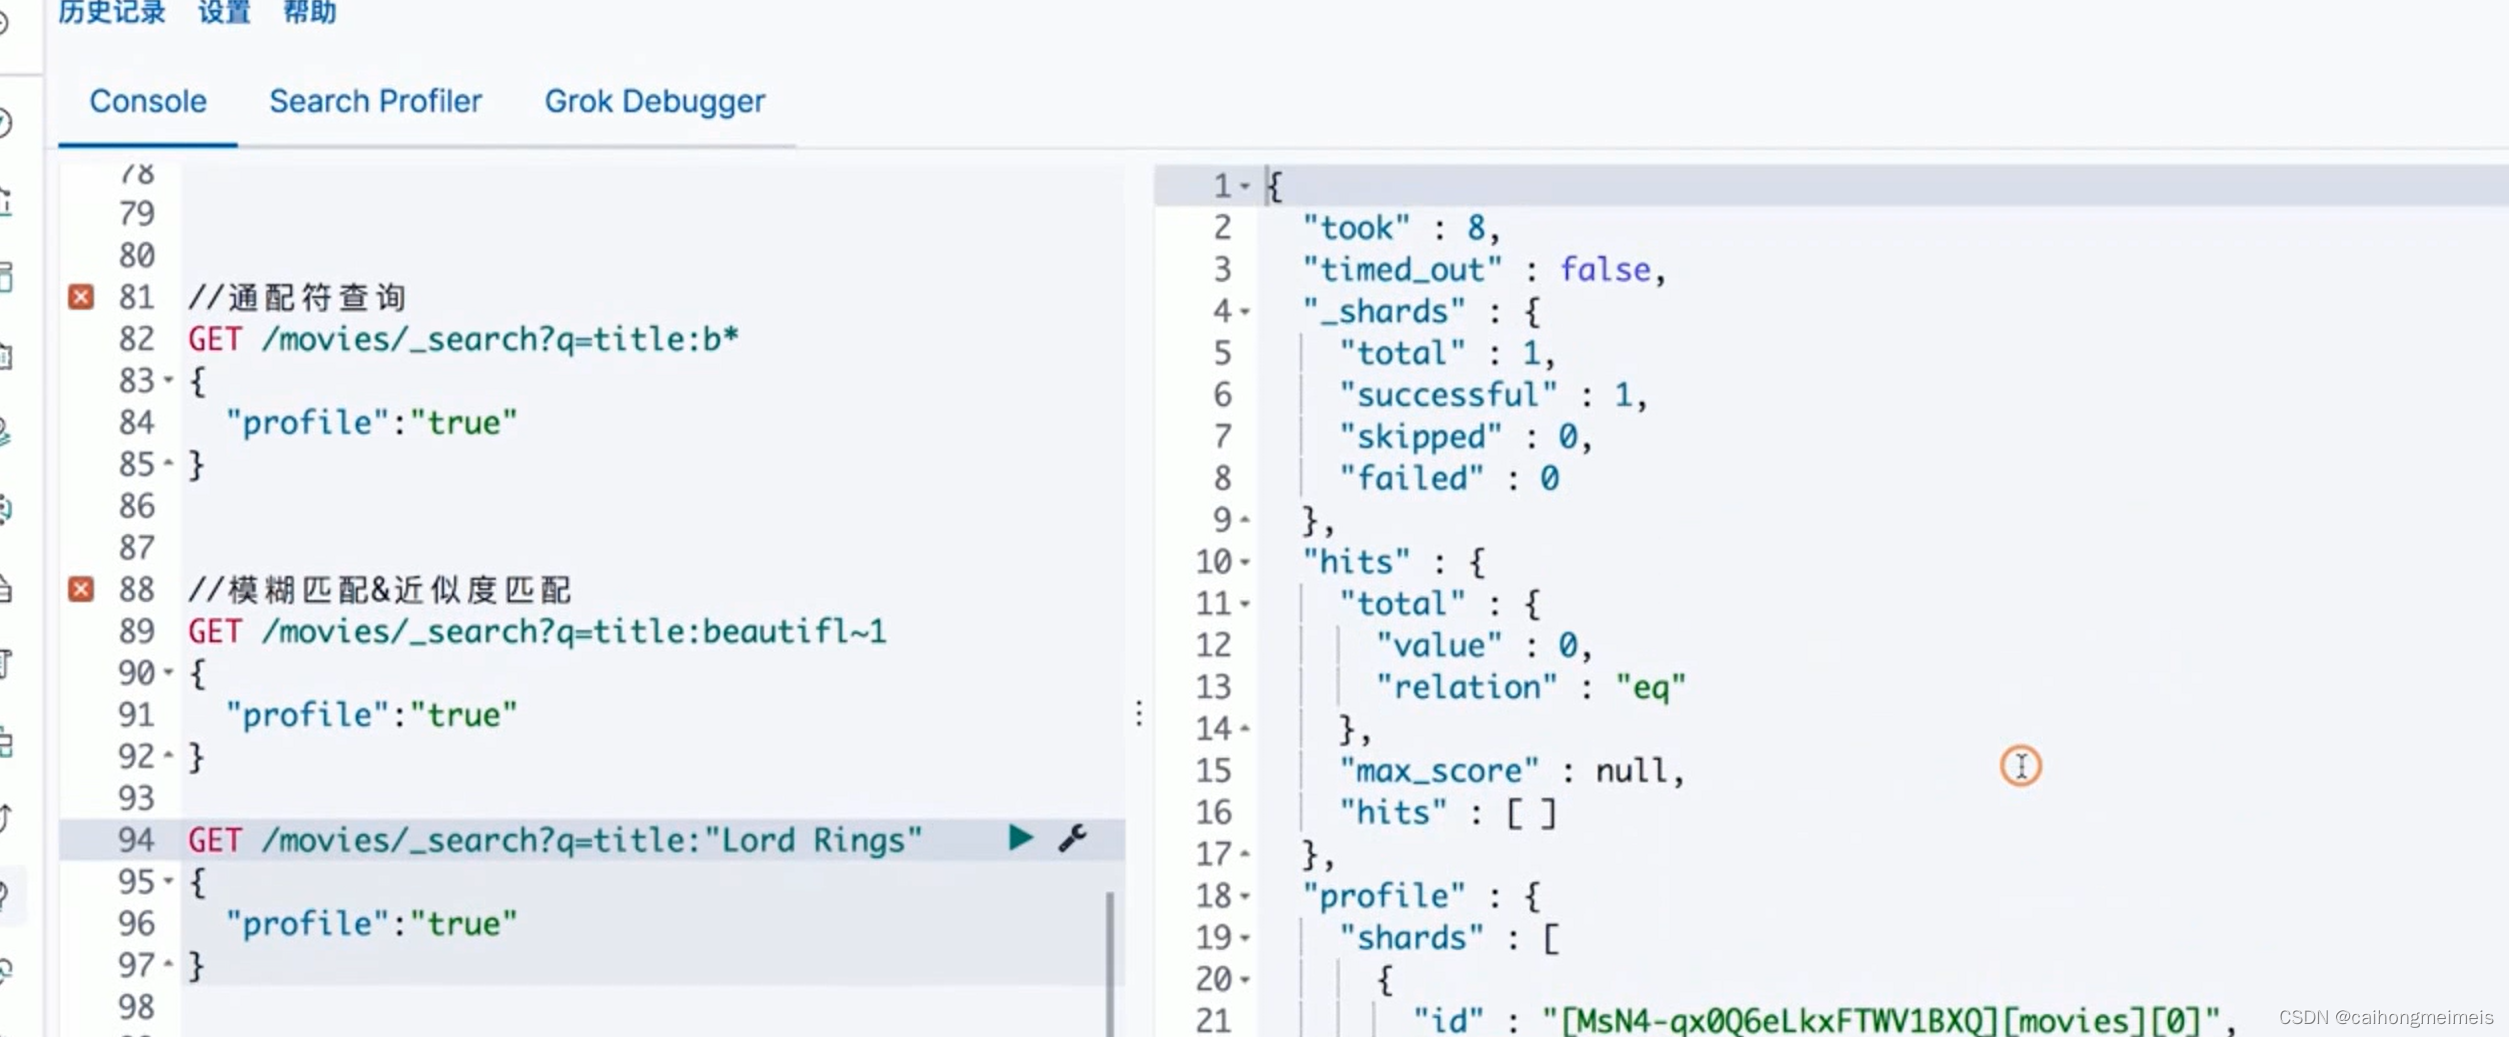
六、Request Body Search
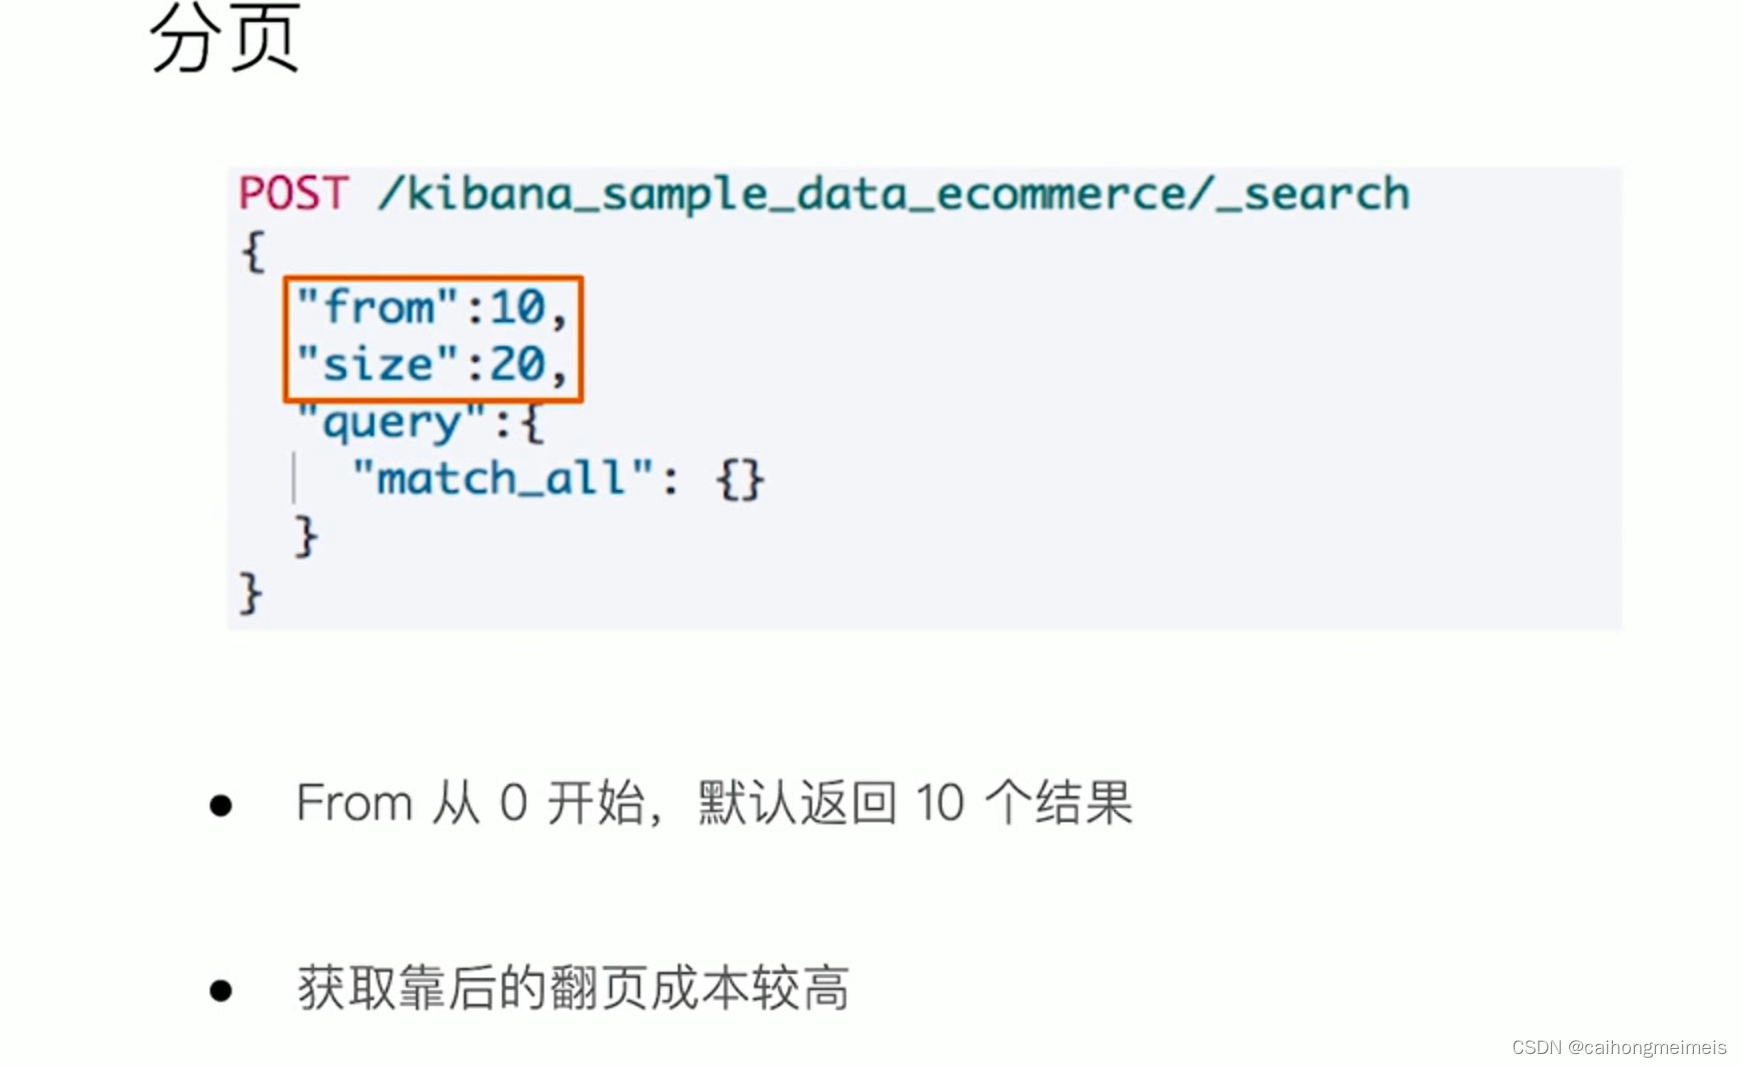
分页
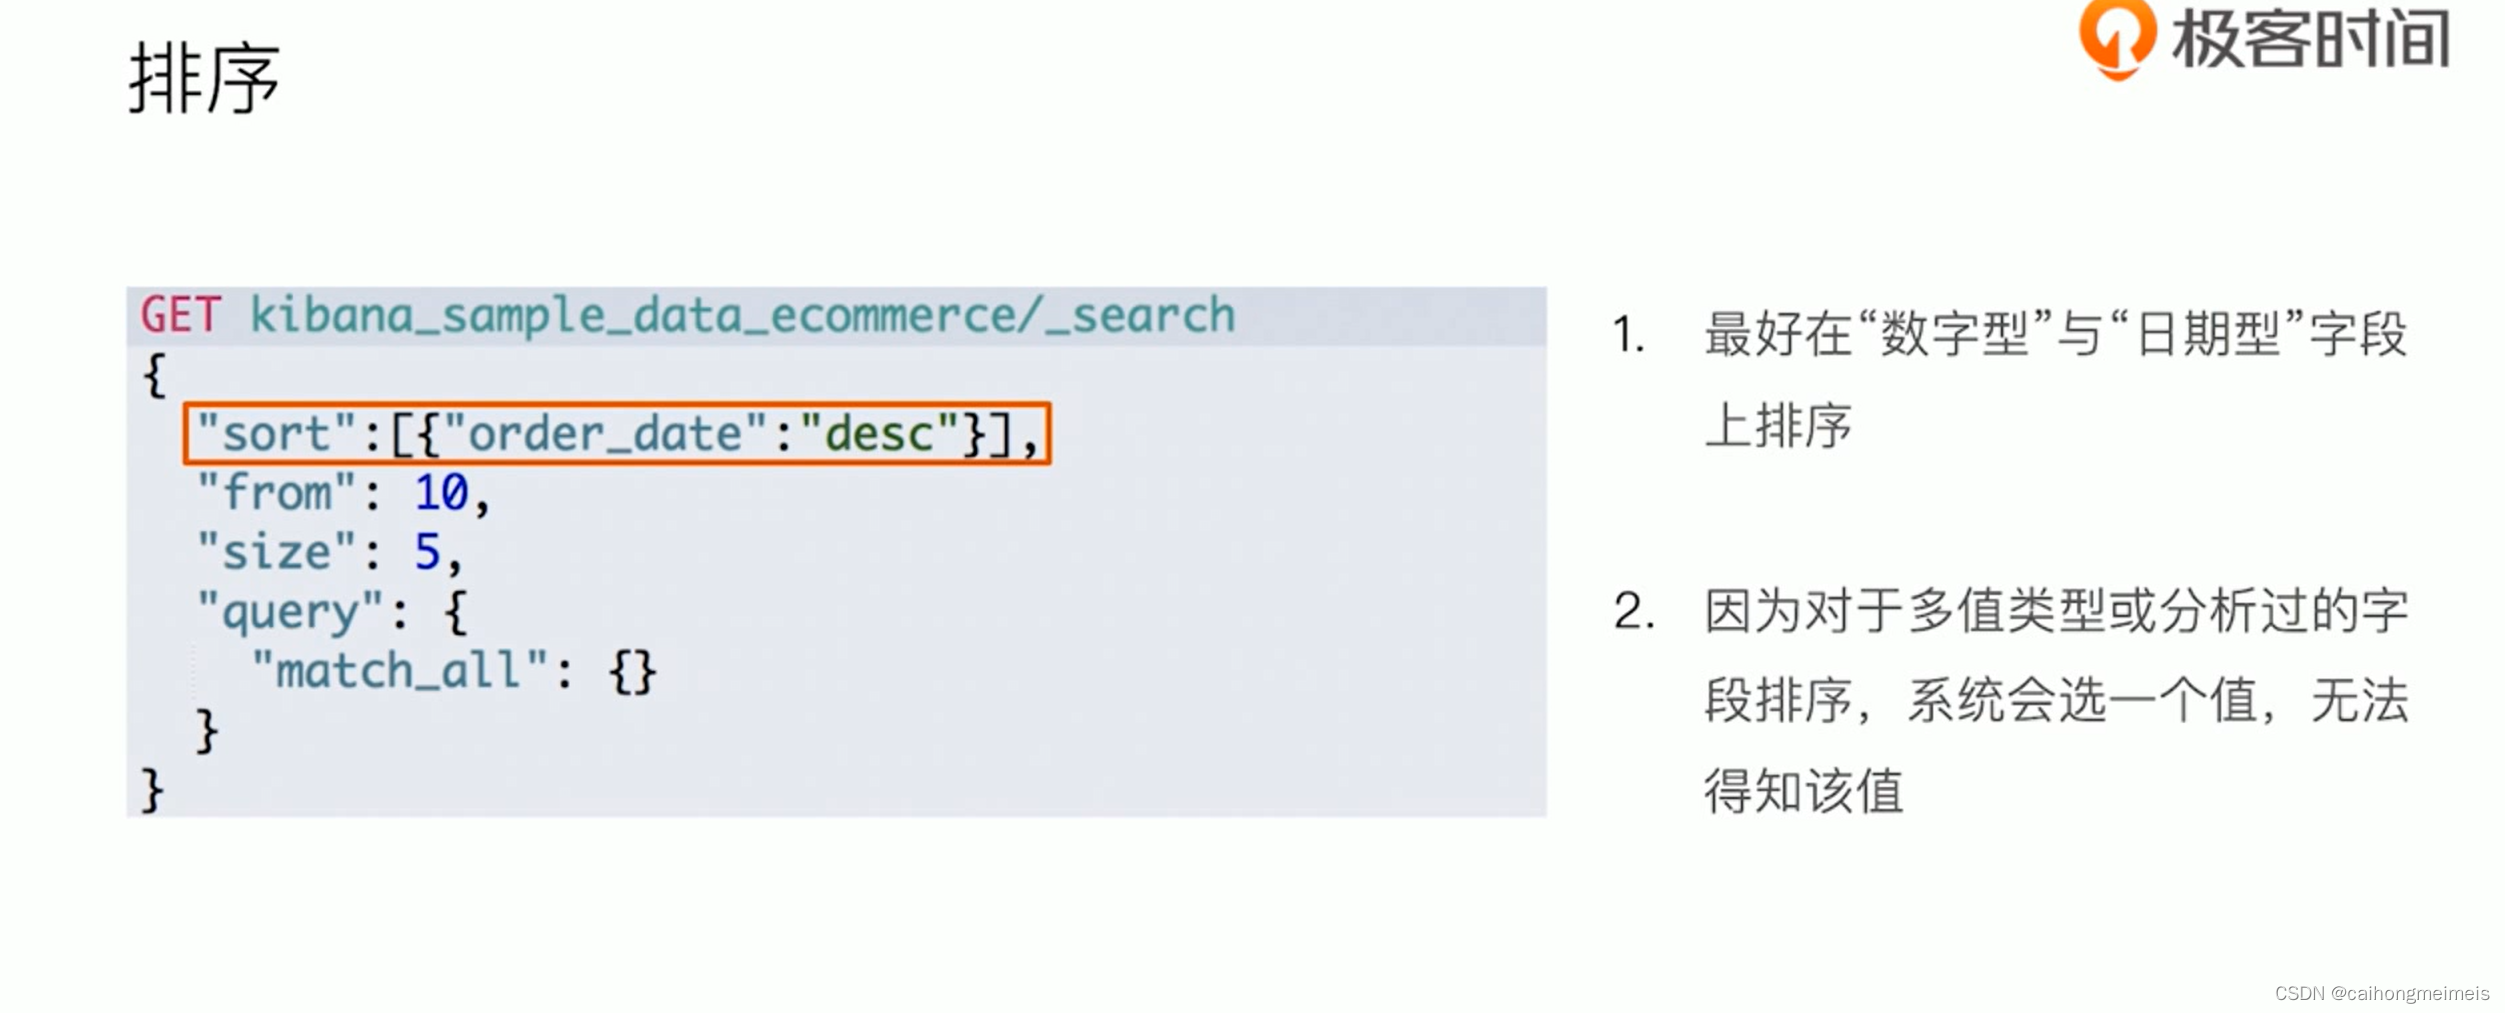
排序
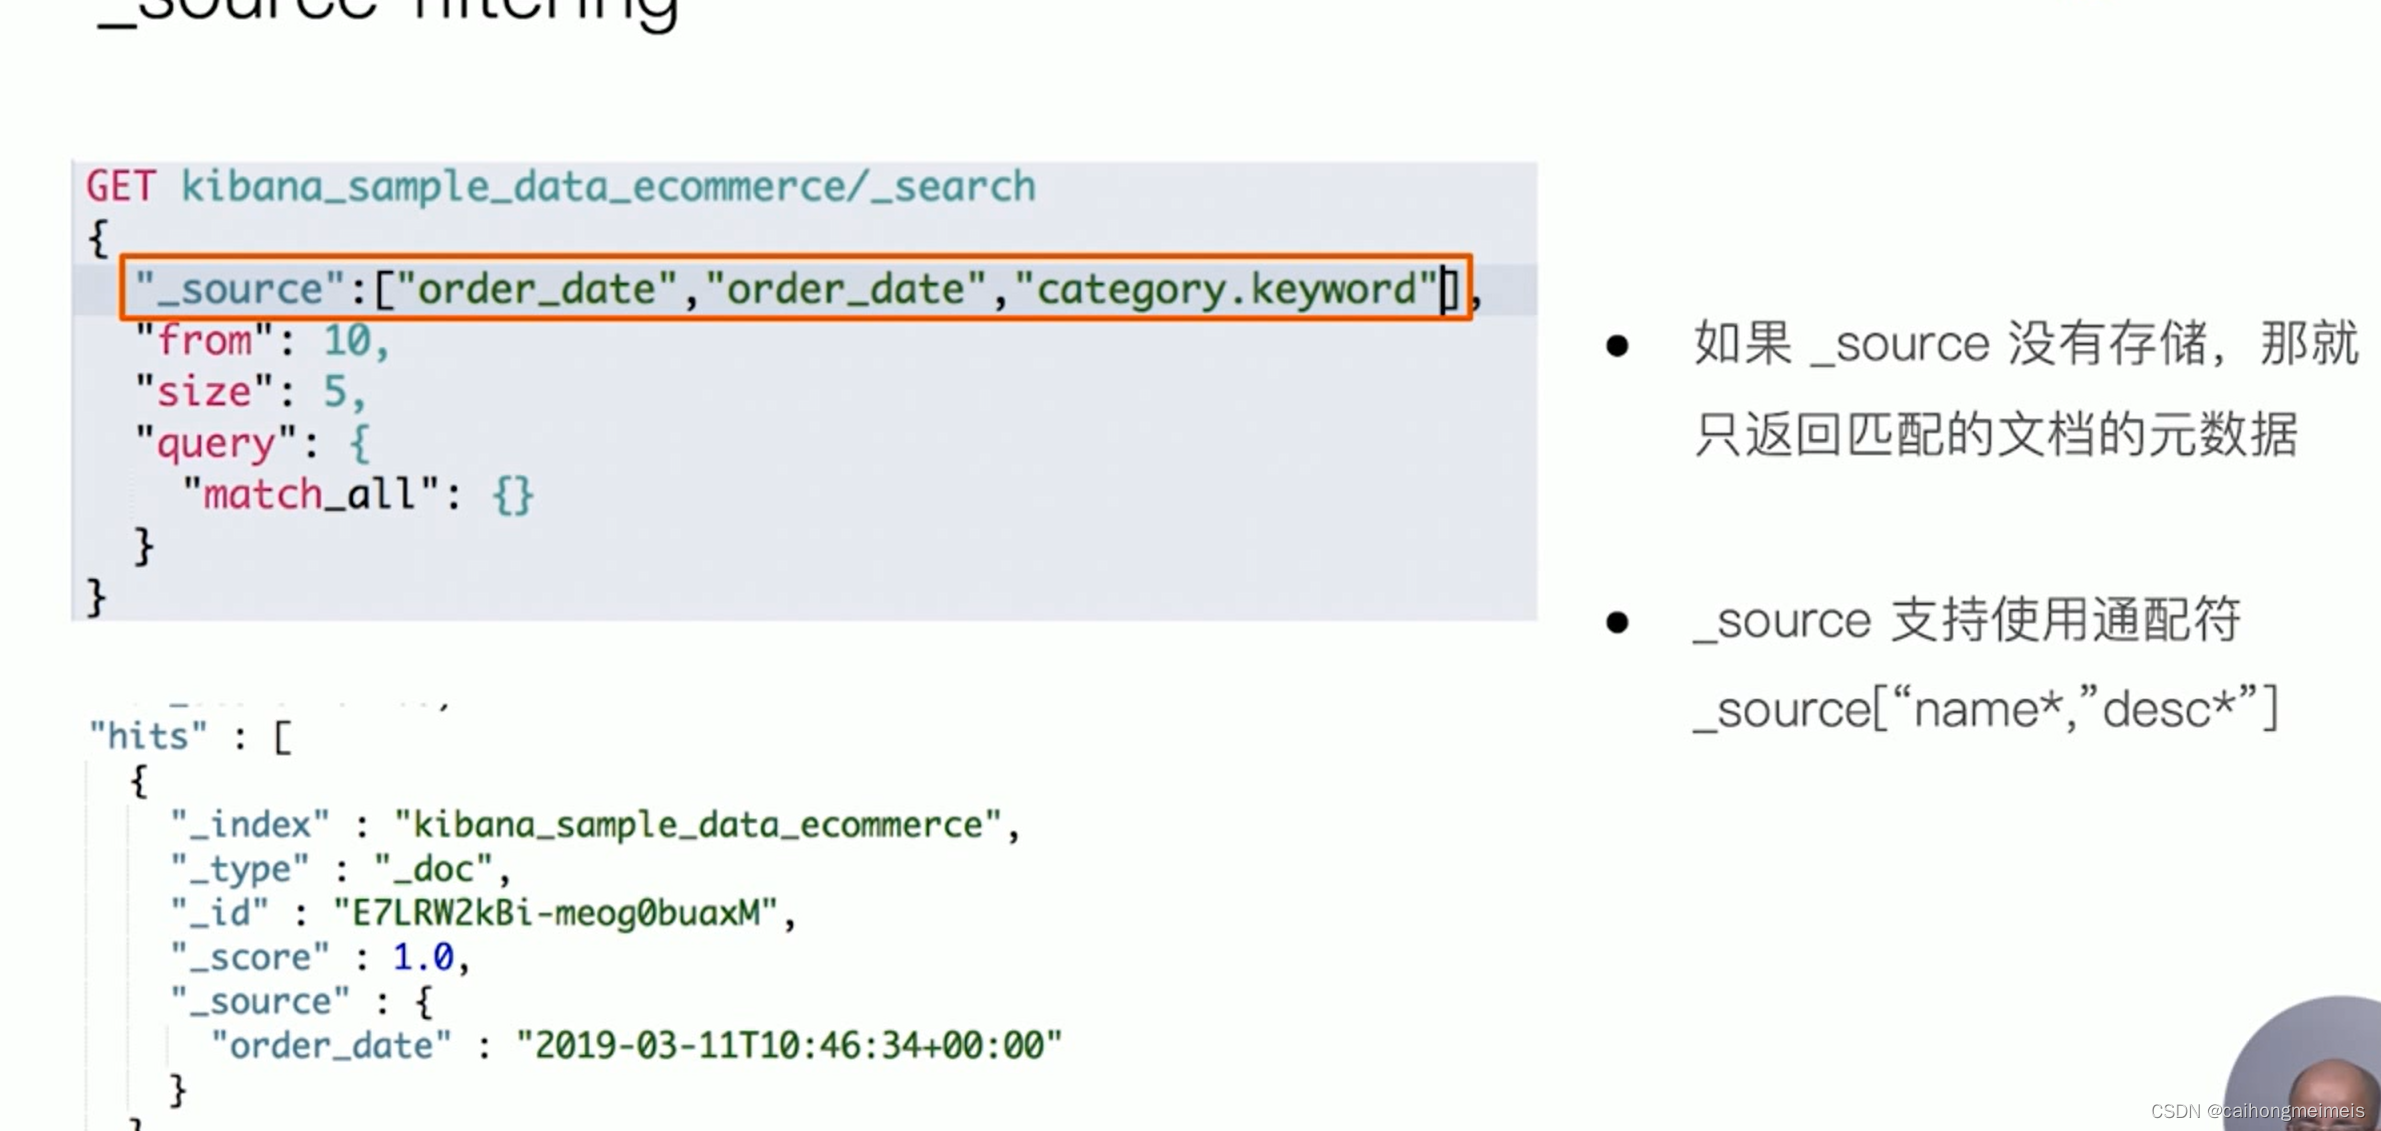
_ soruce filtering
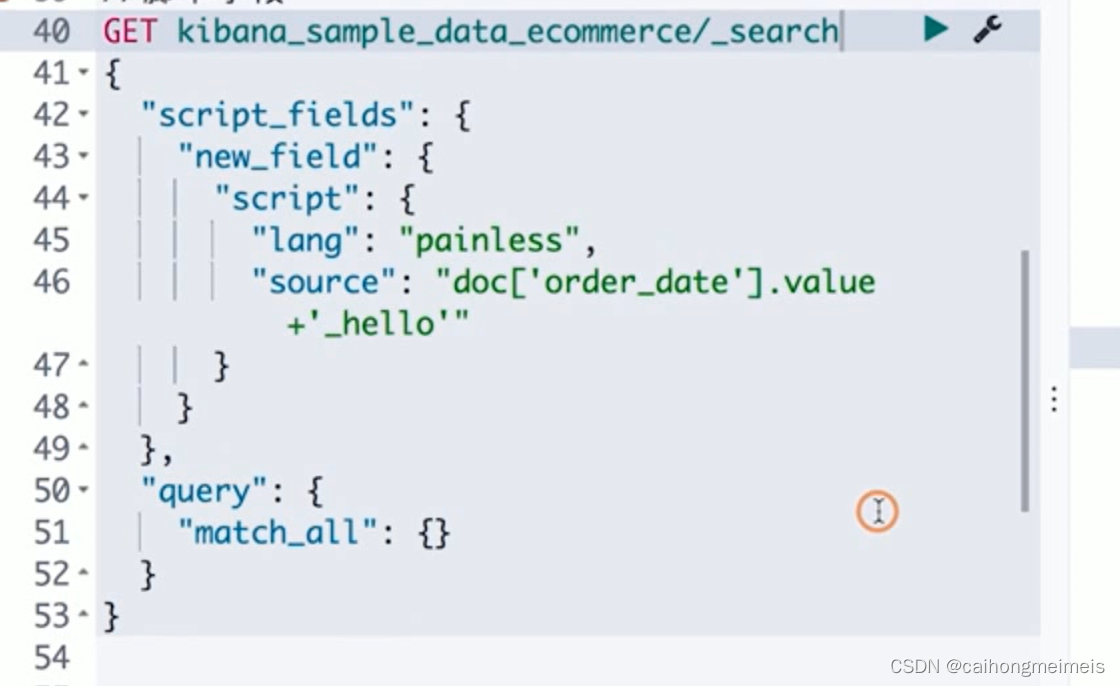
脚本字段
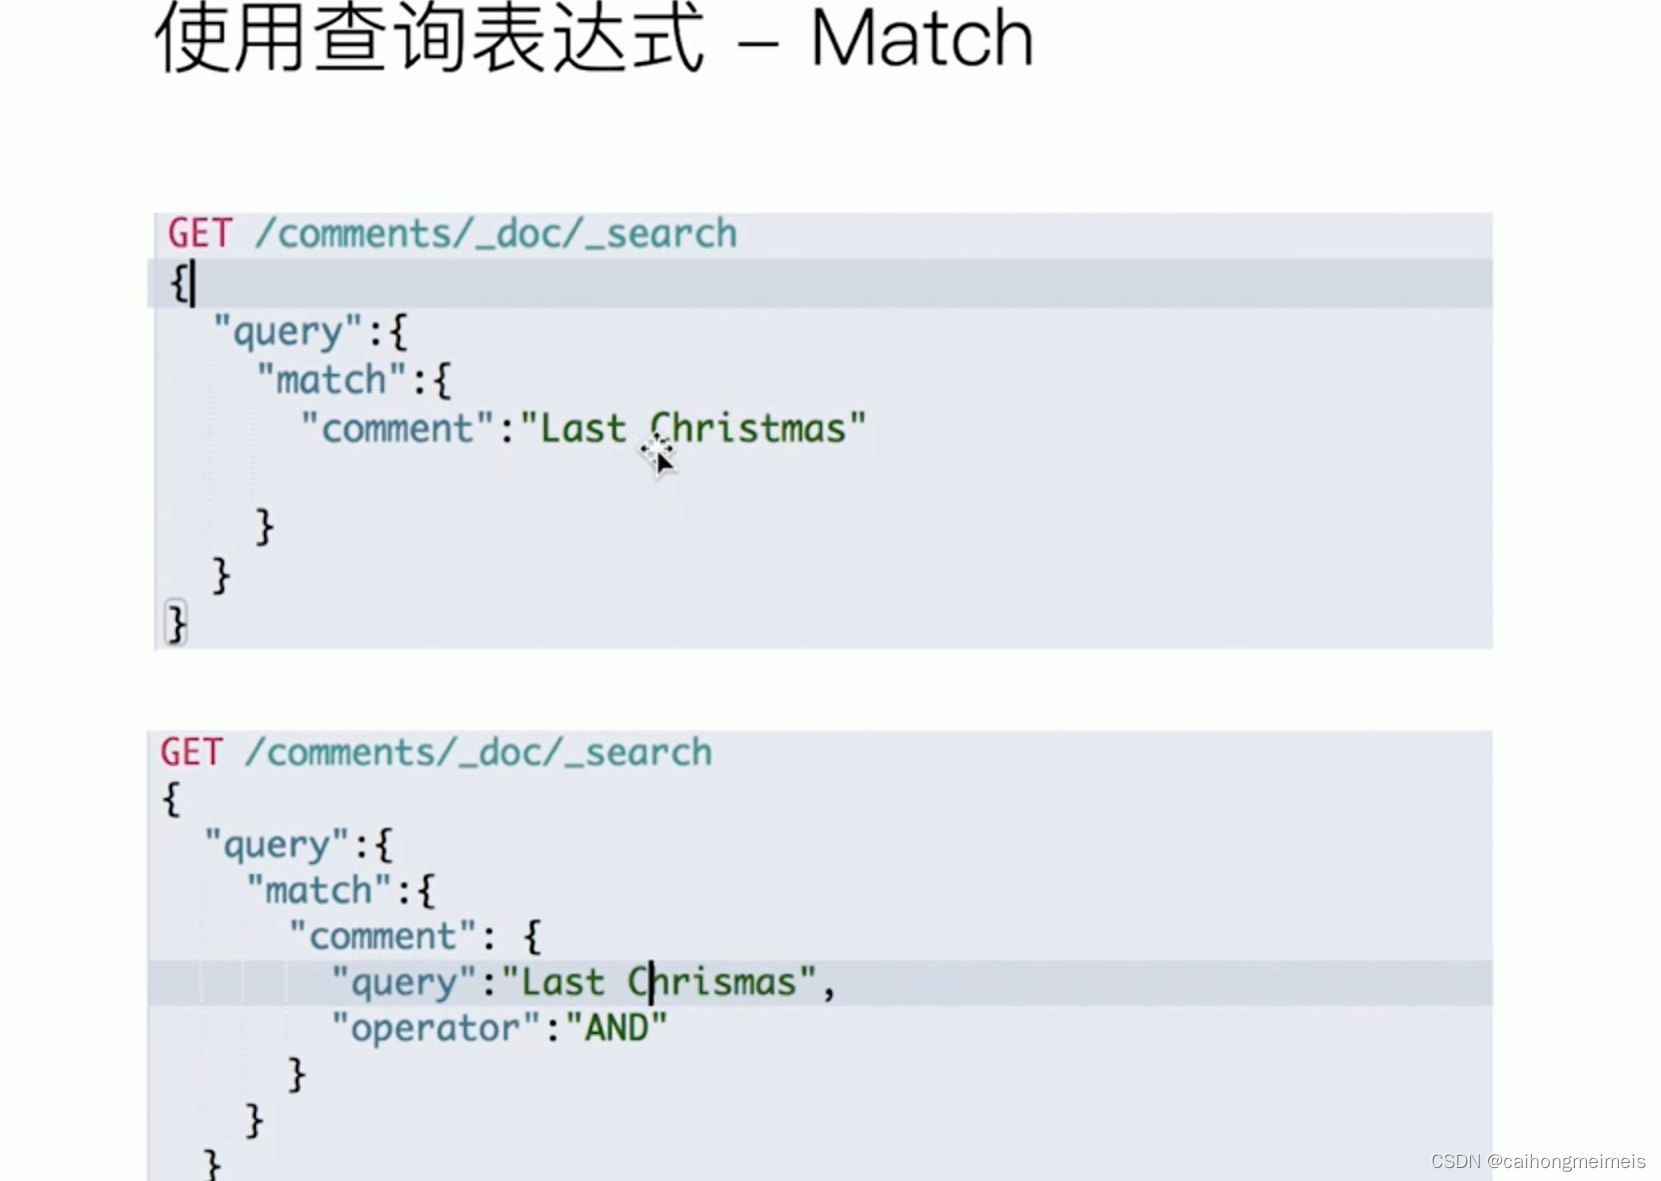
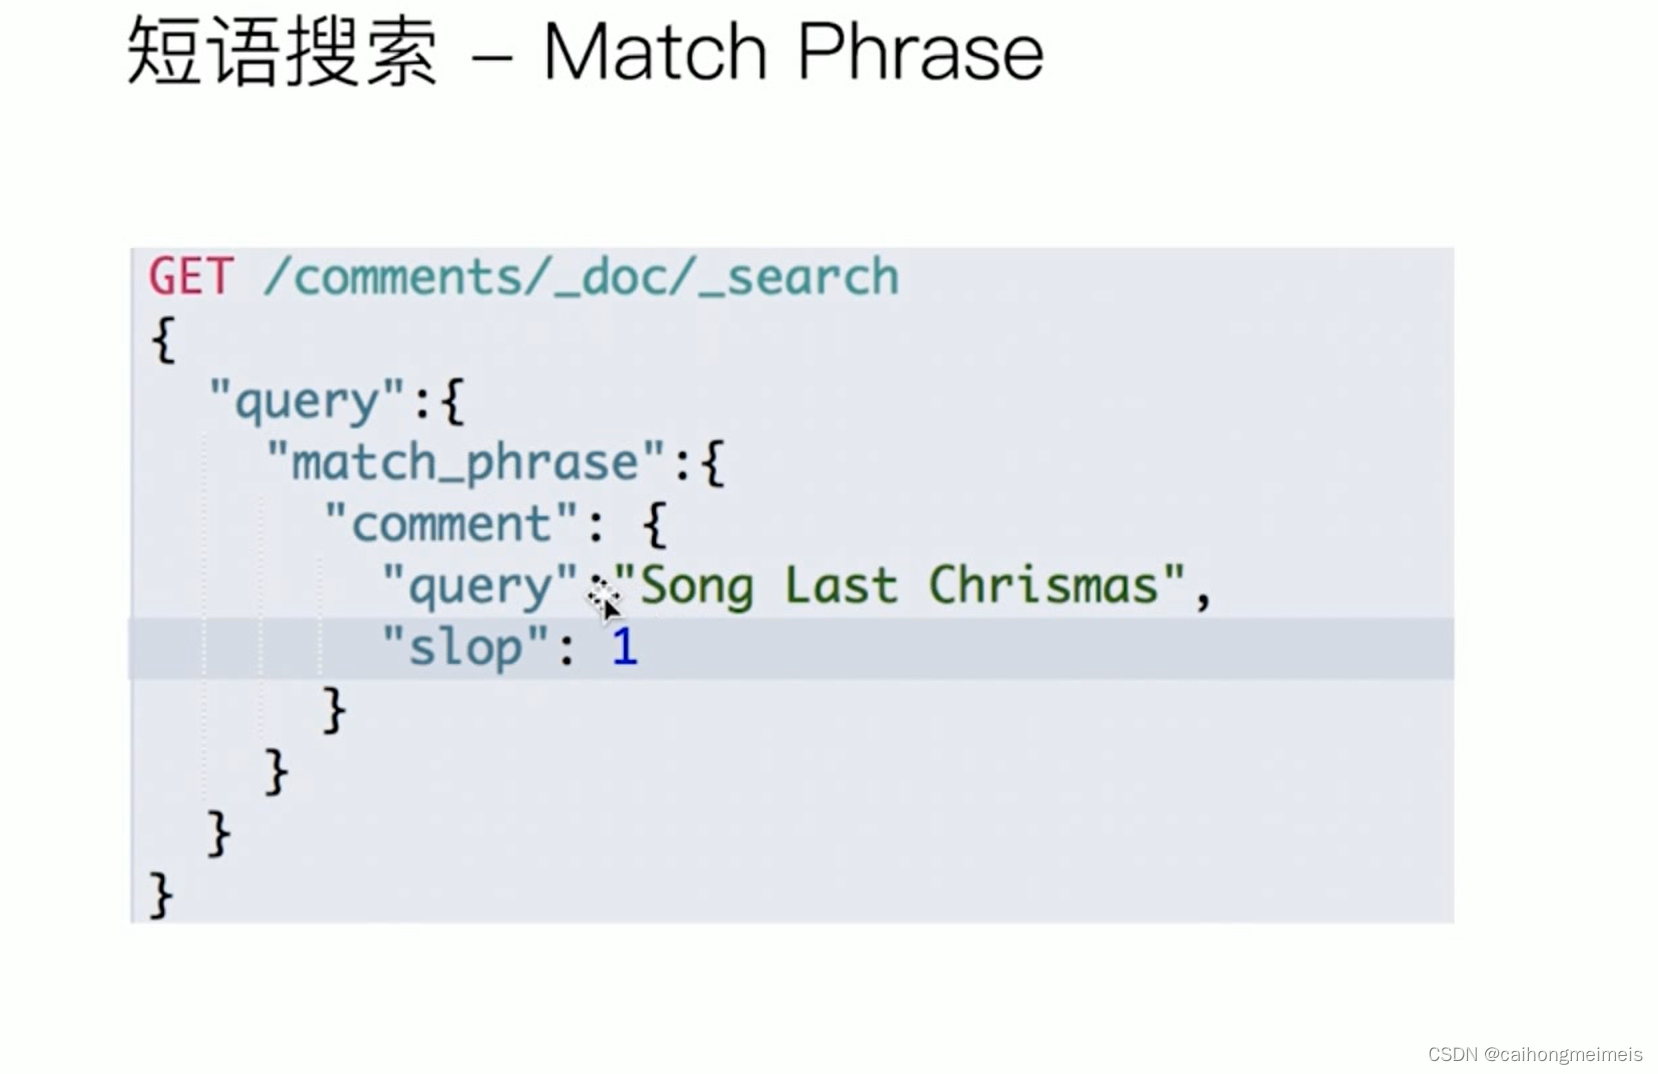
match查询
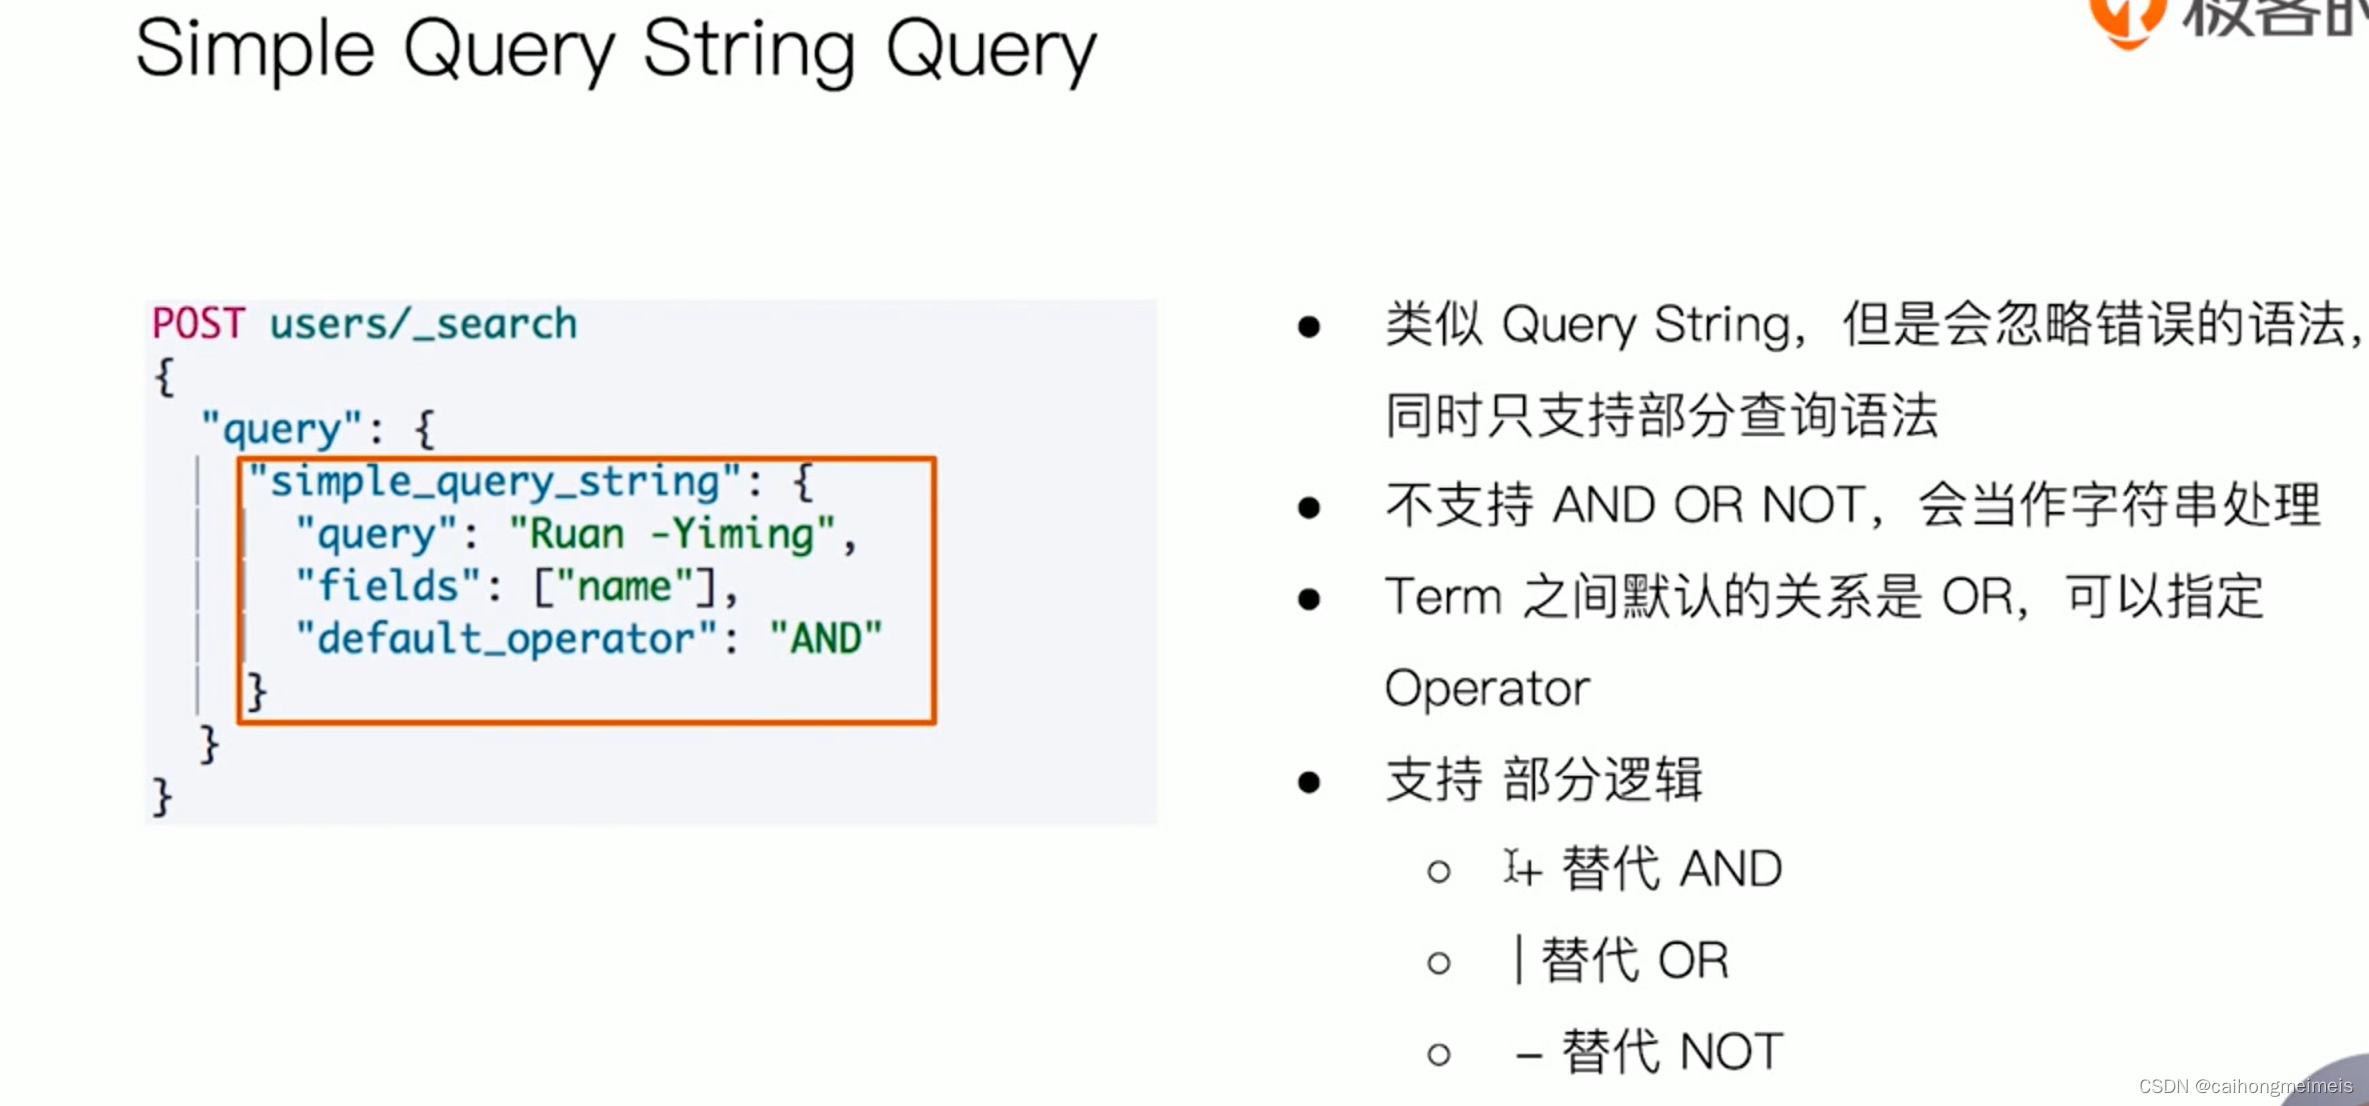
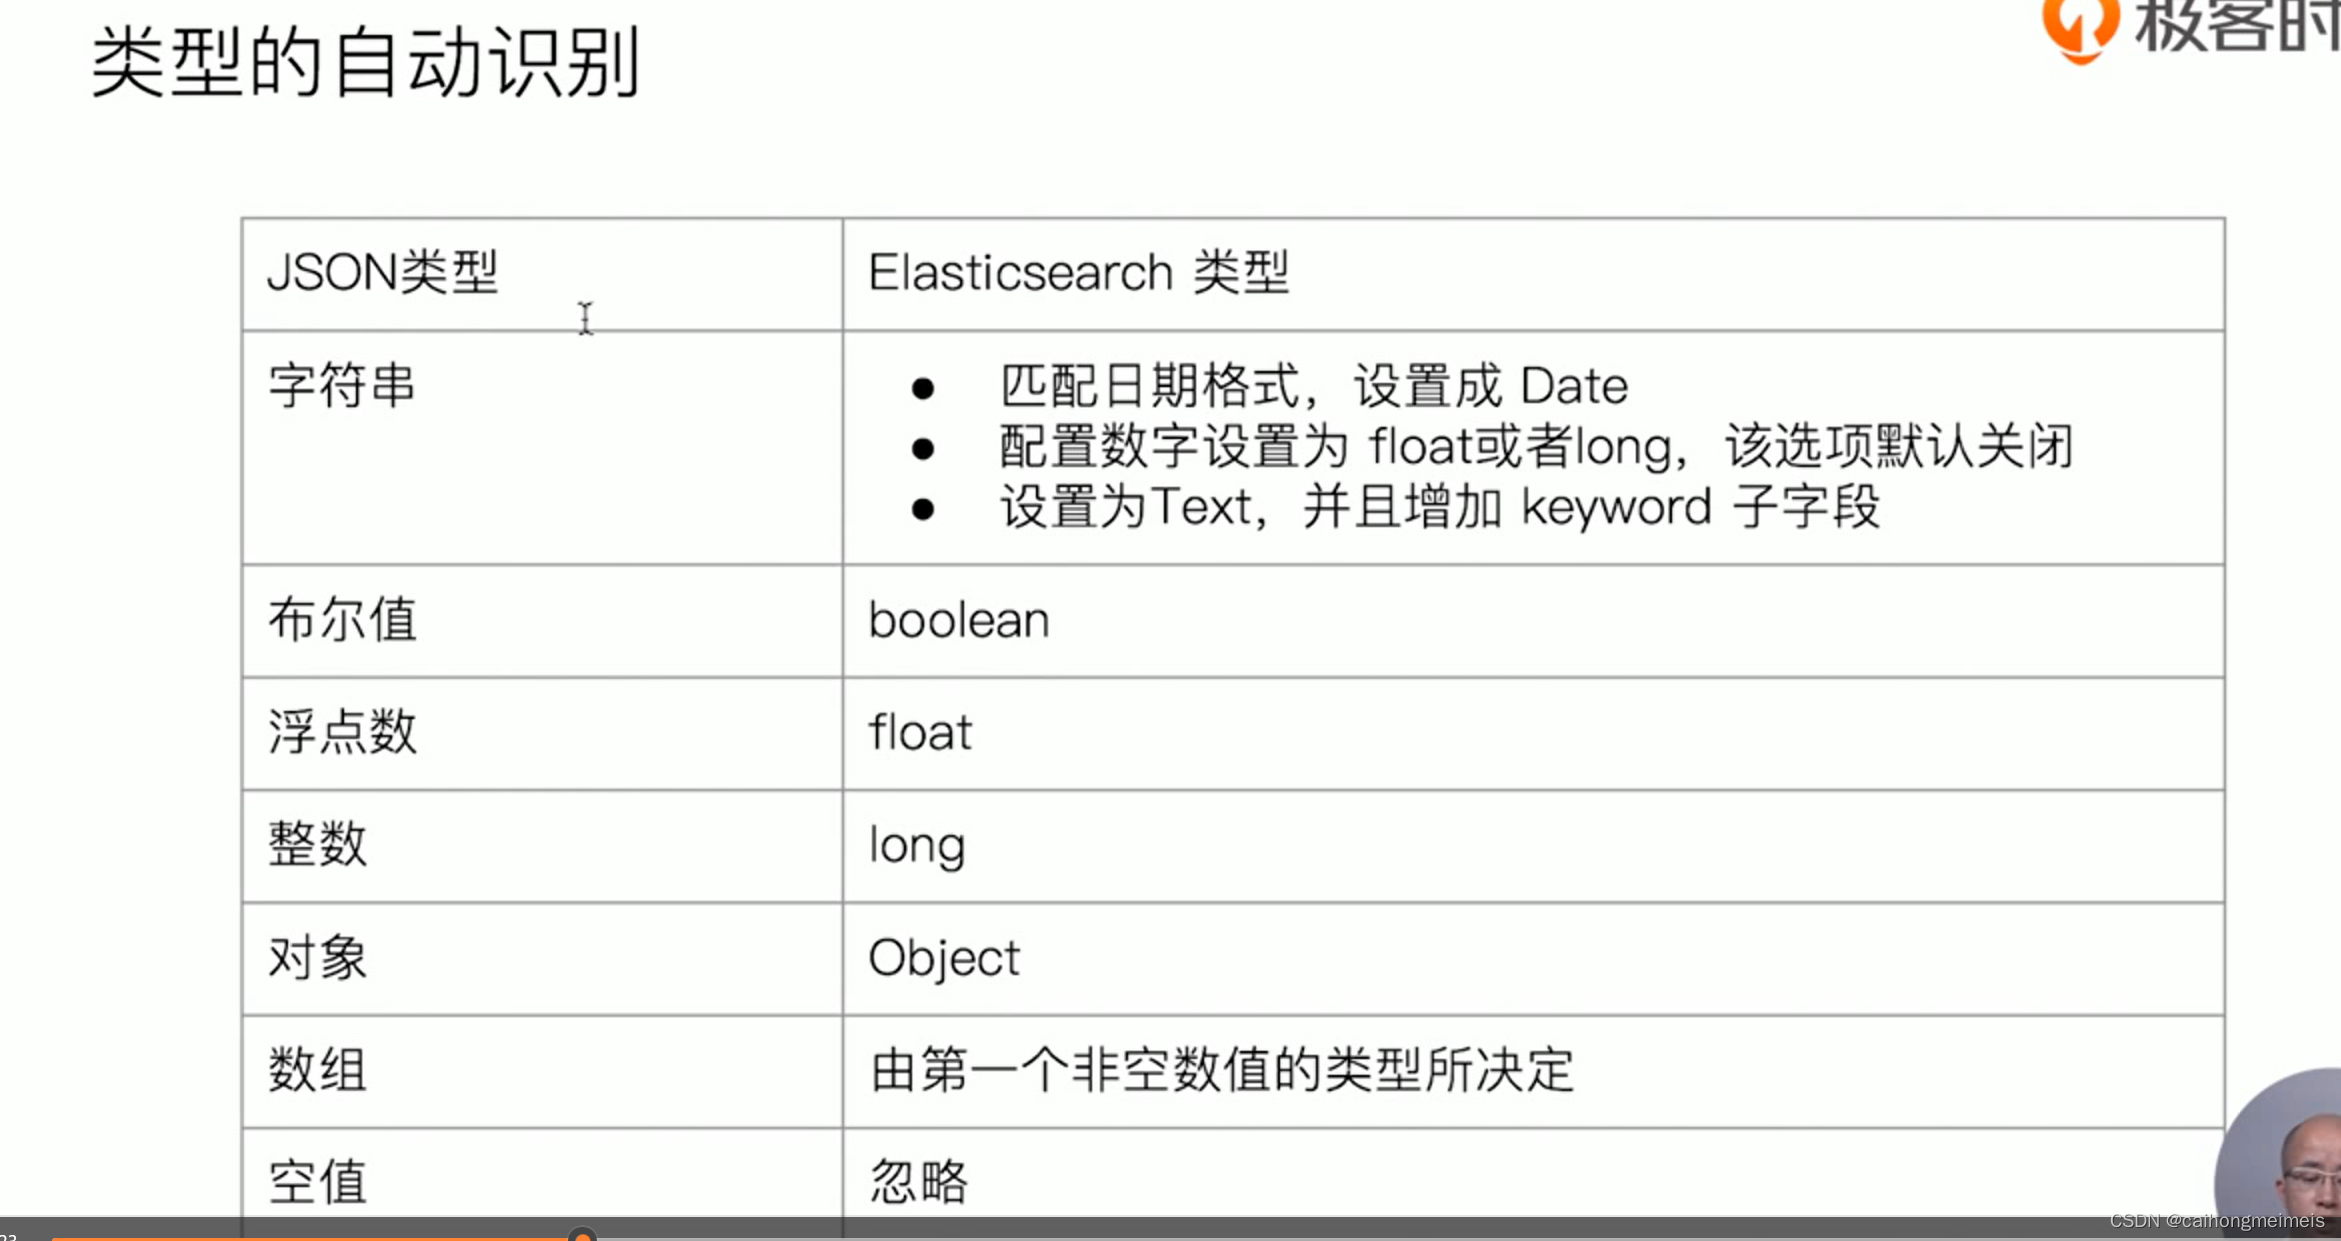
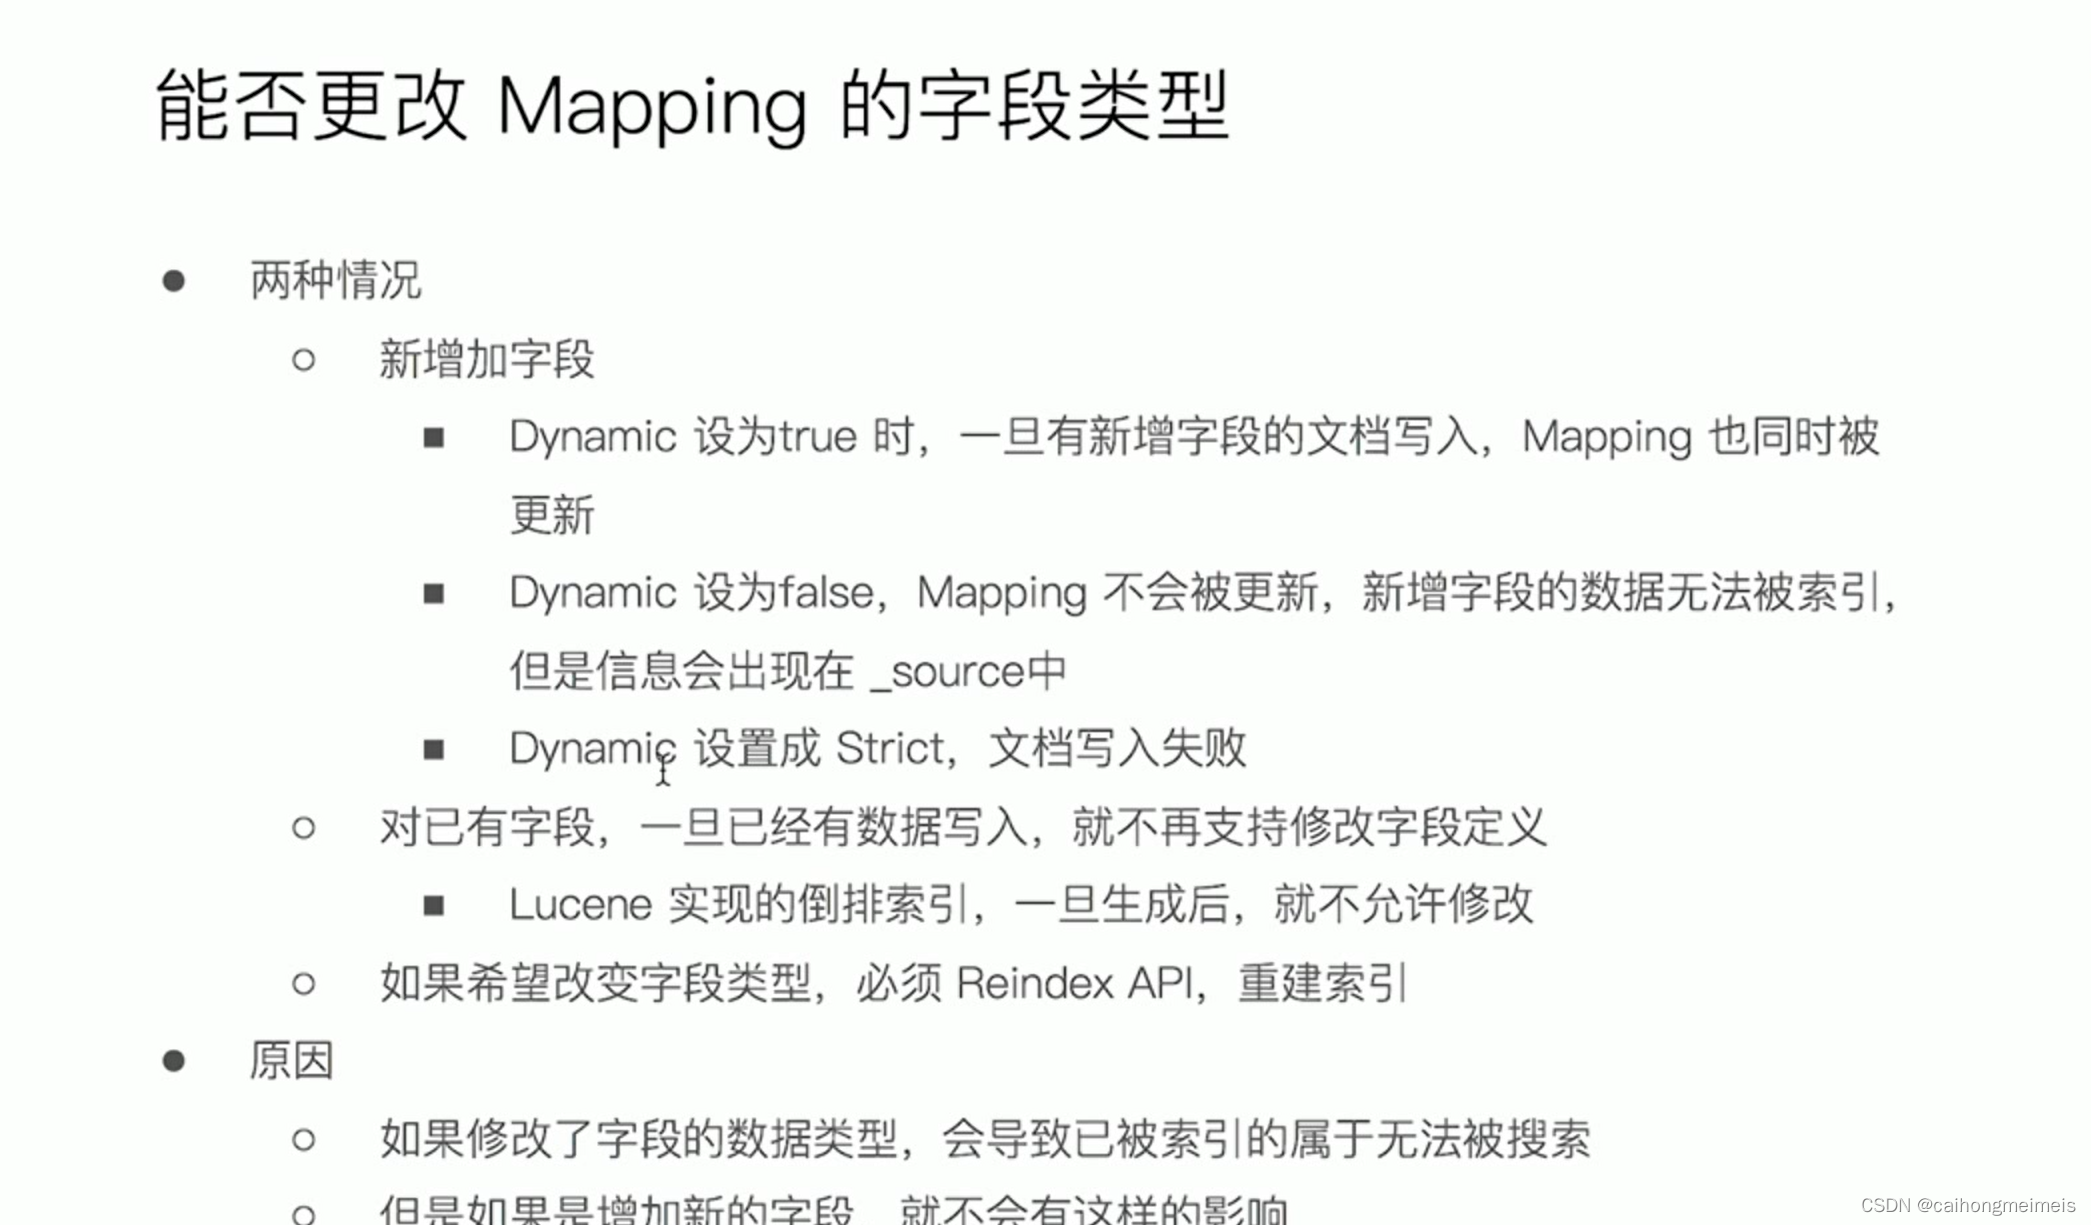
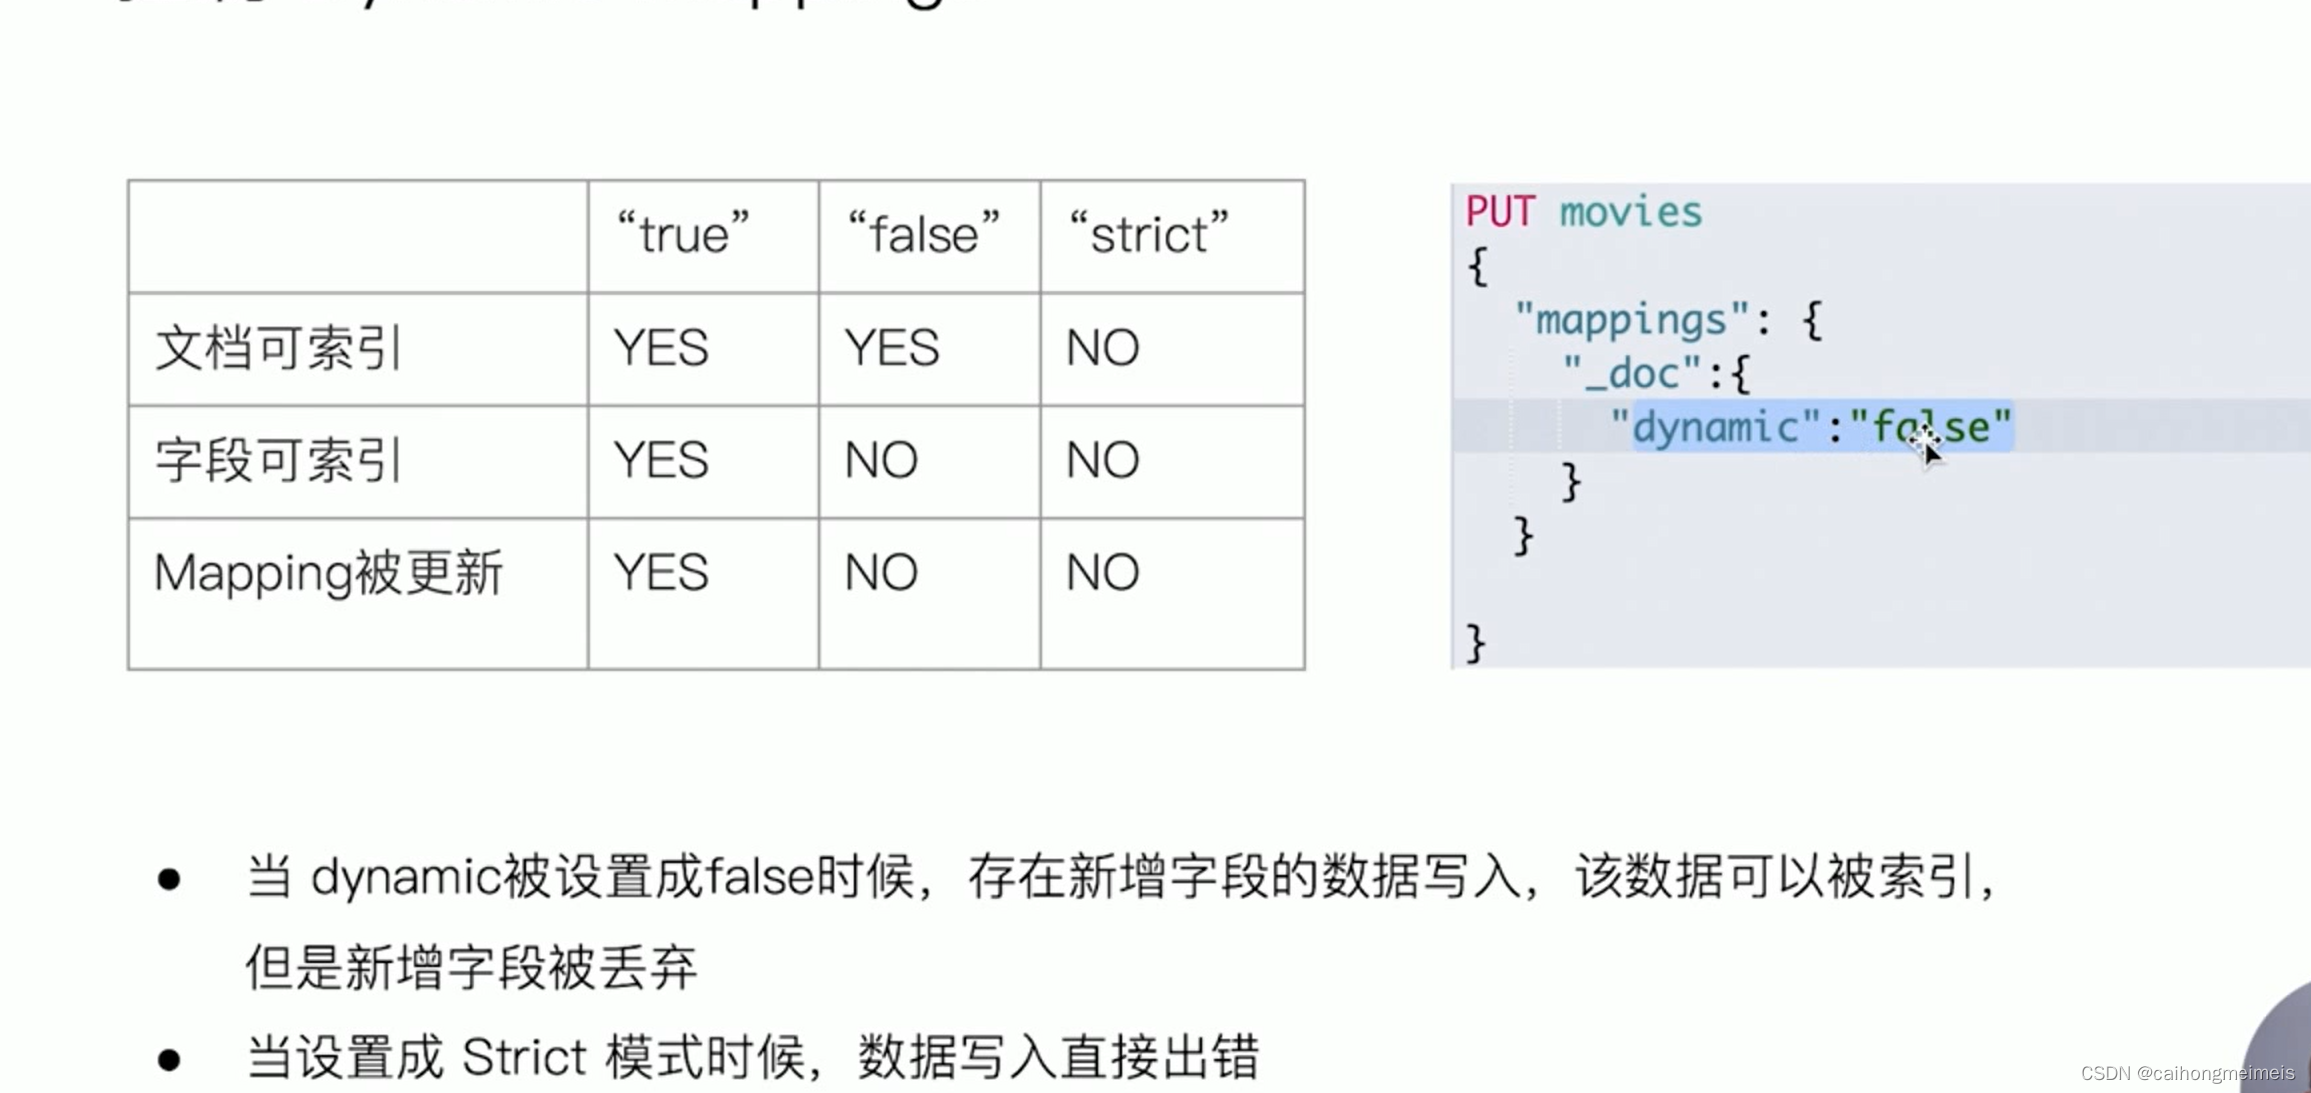
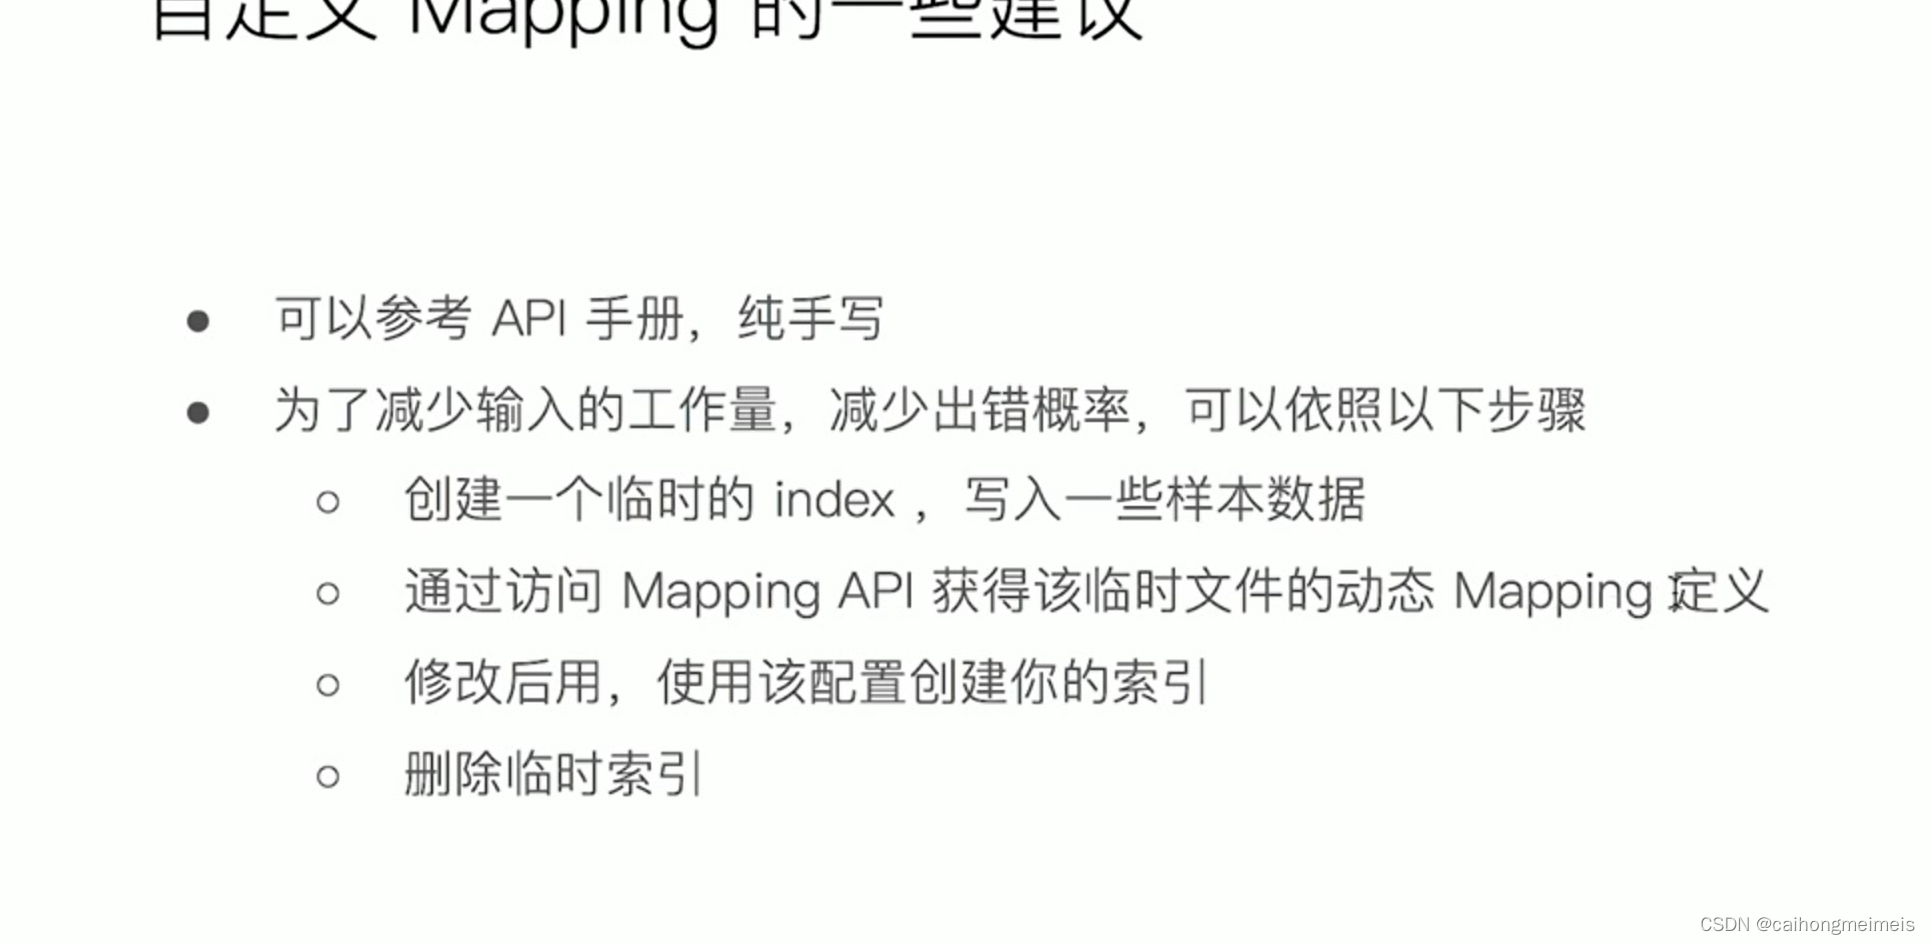
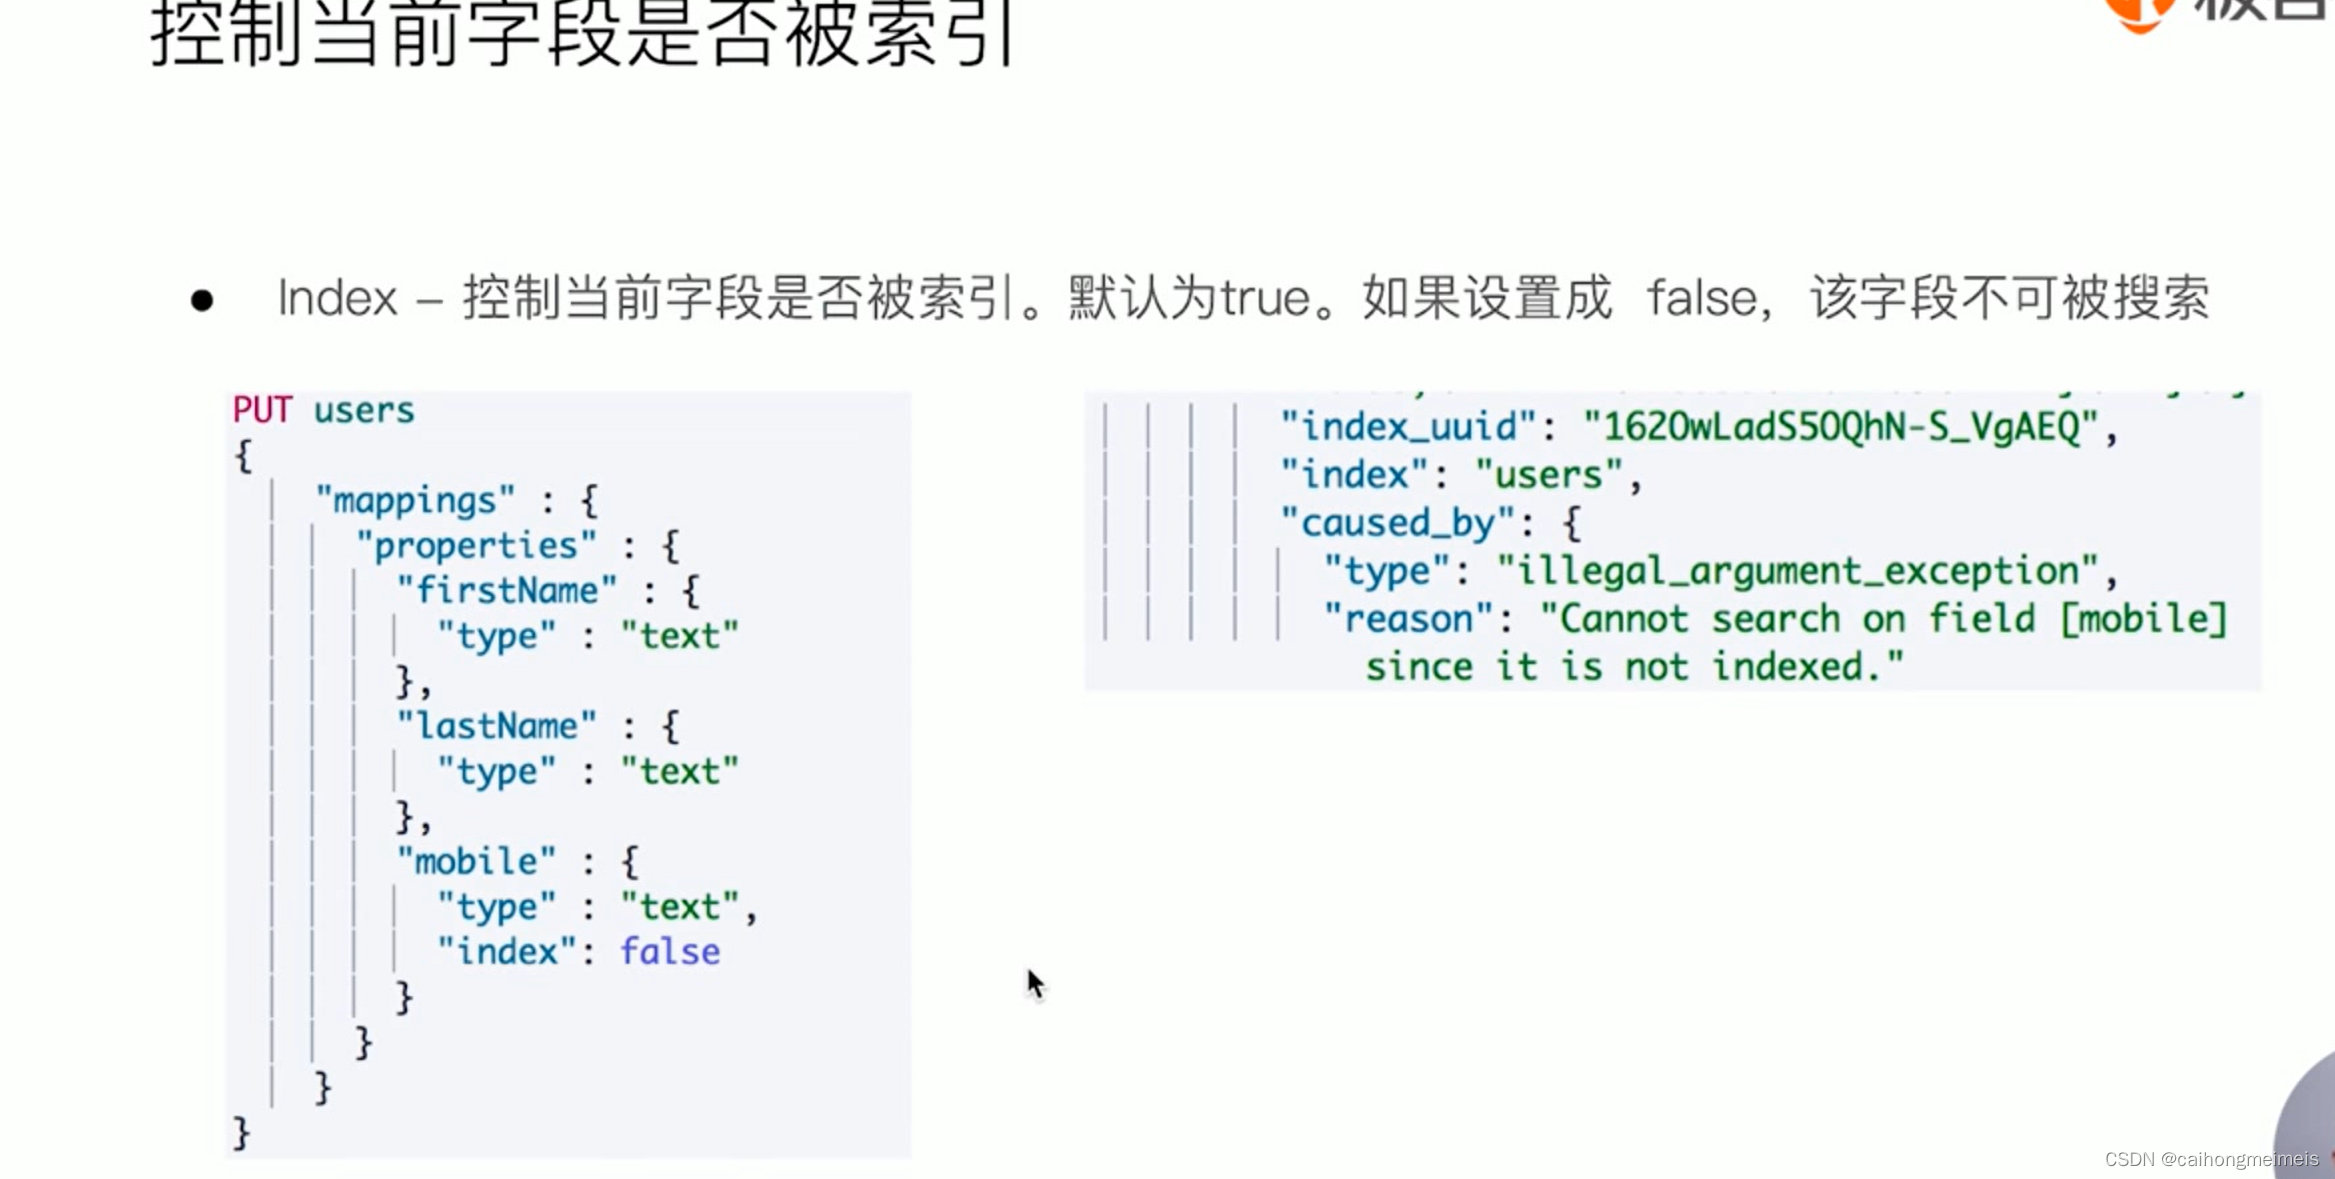
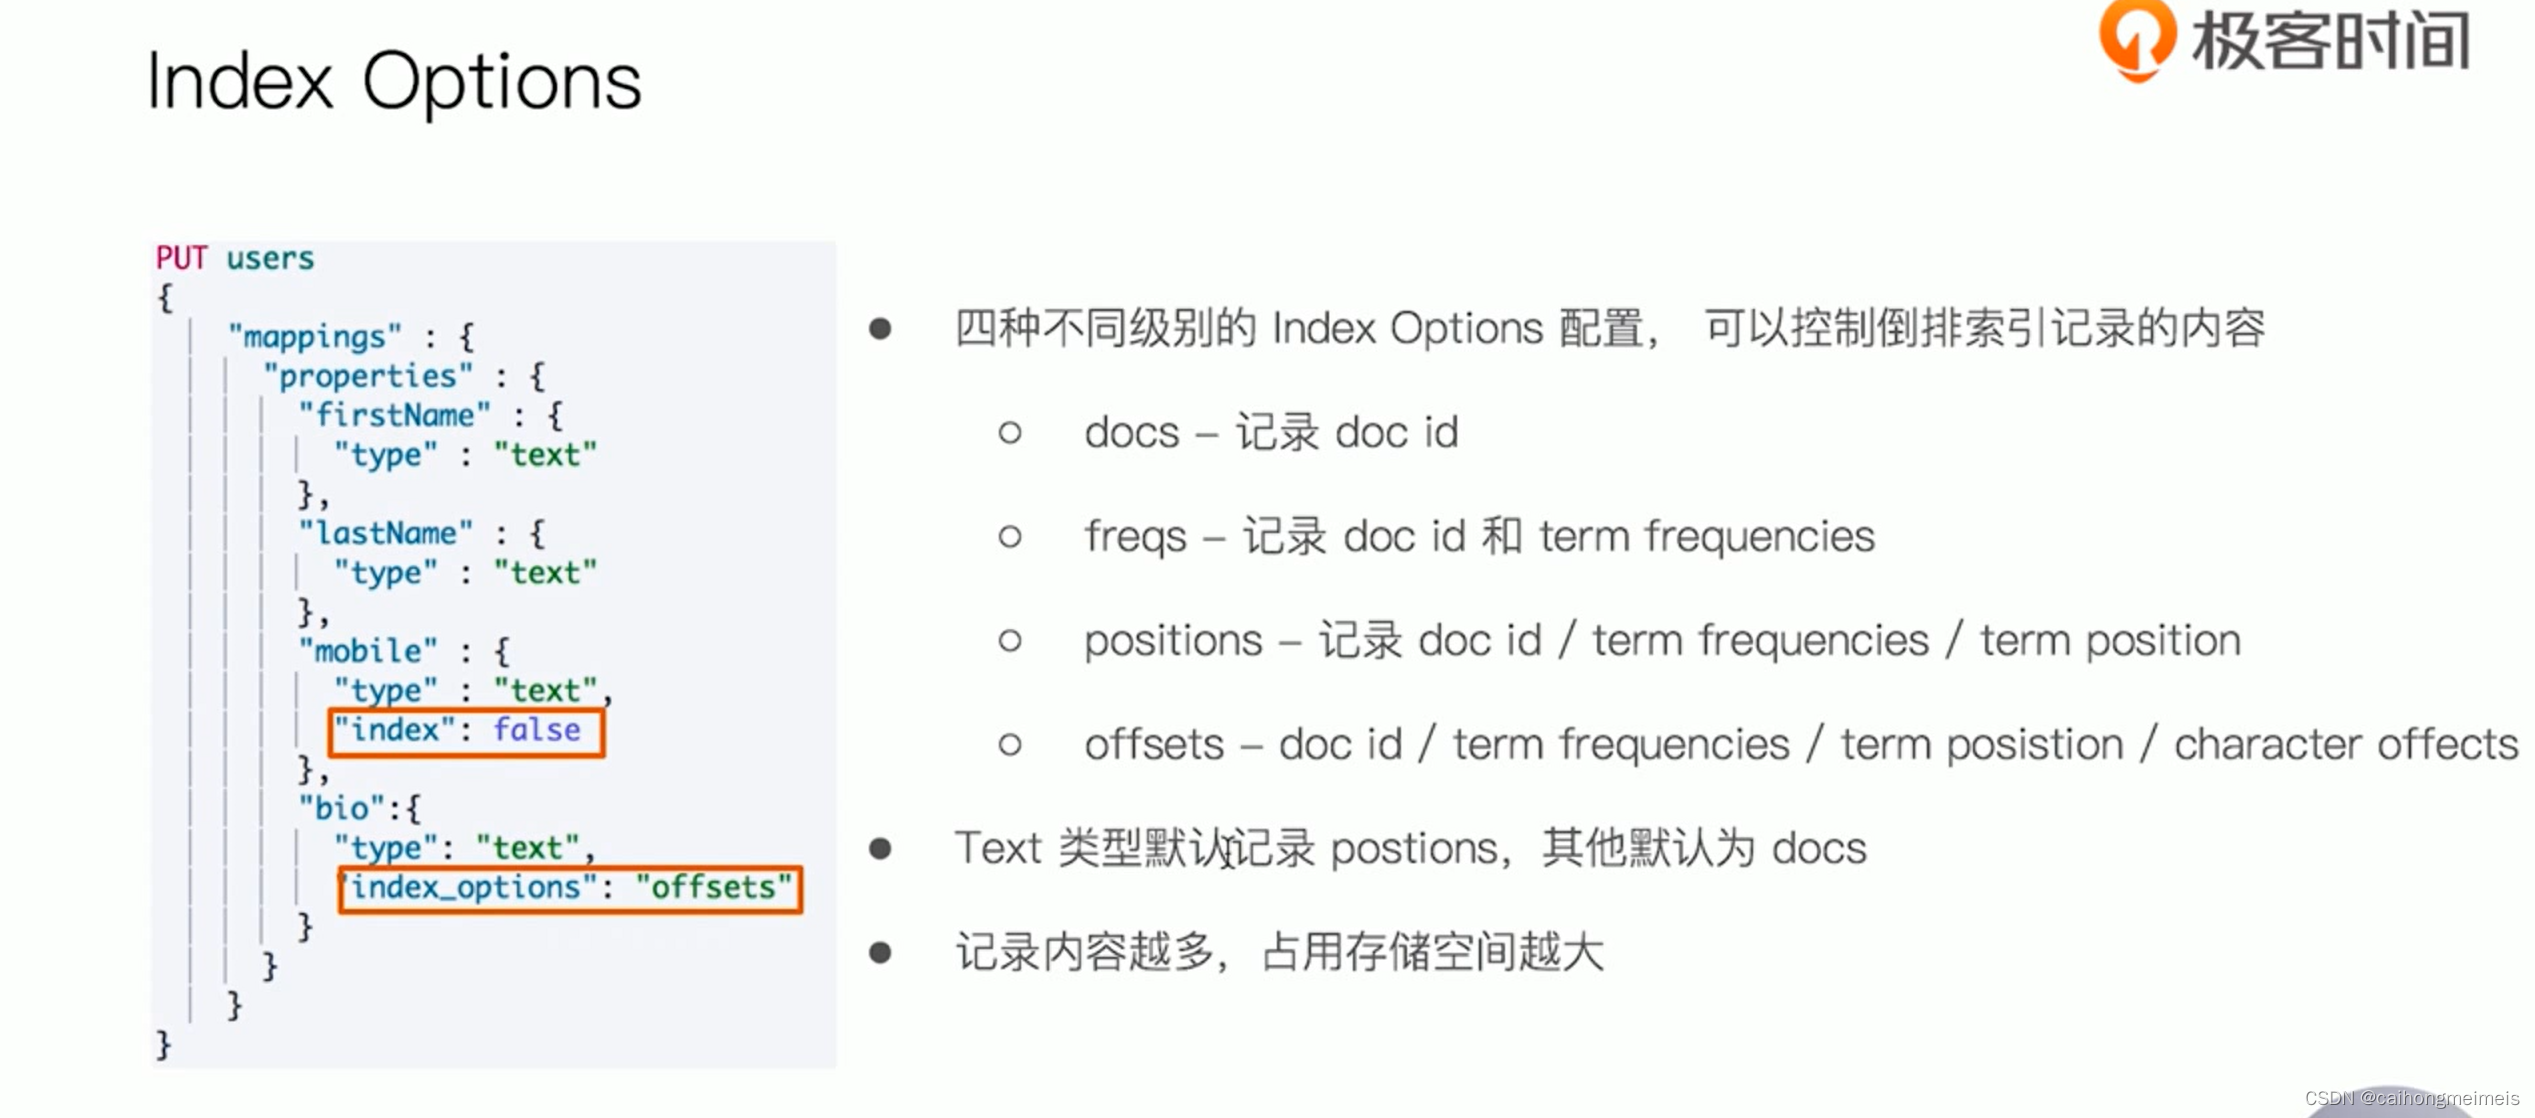
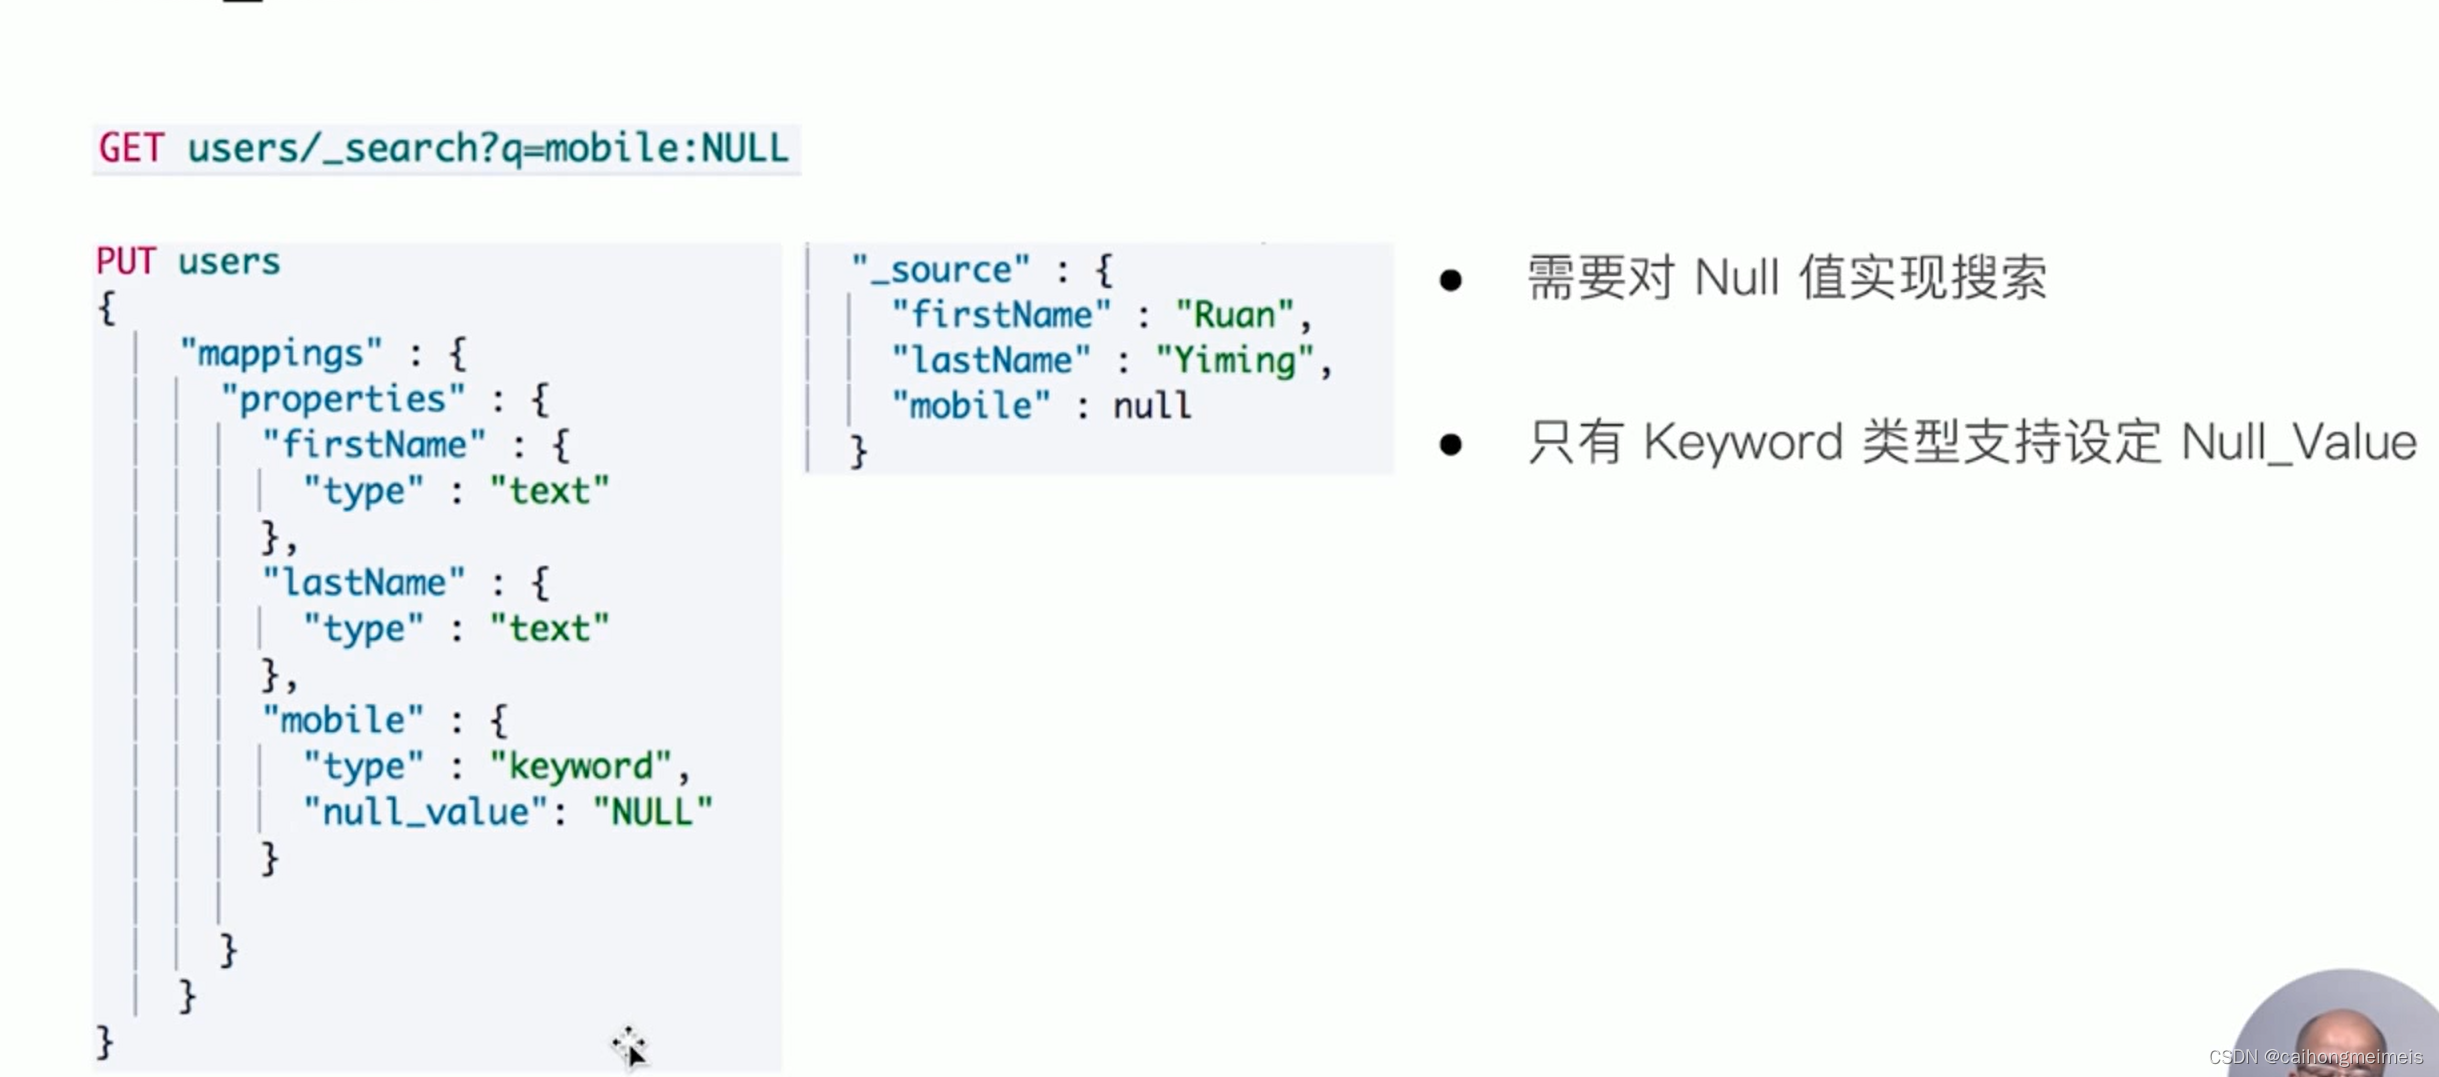
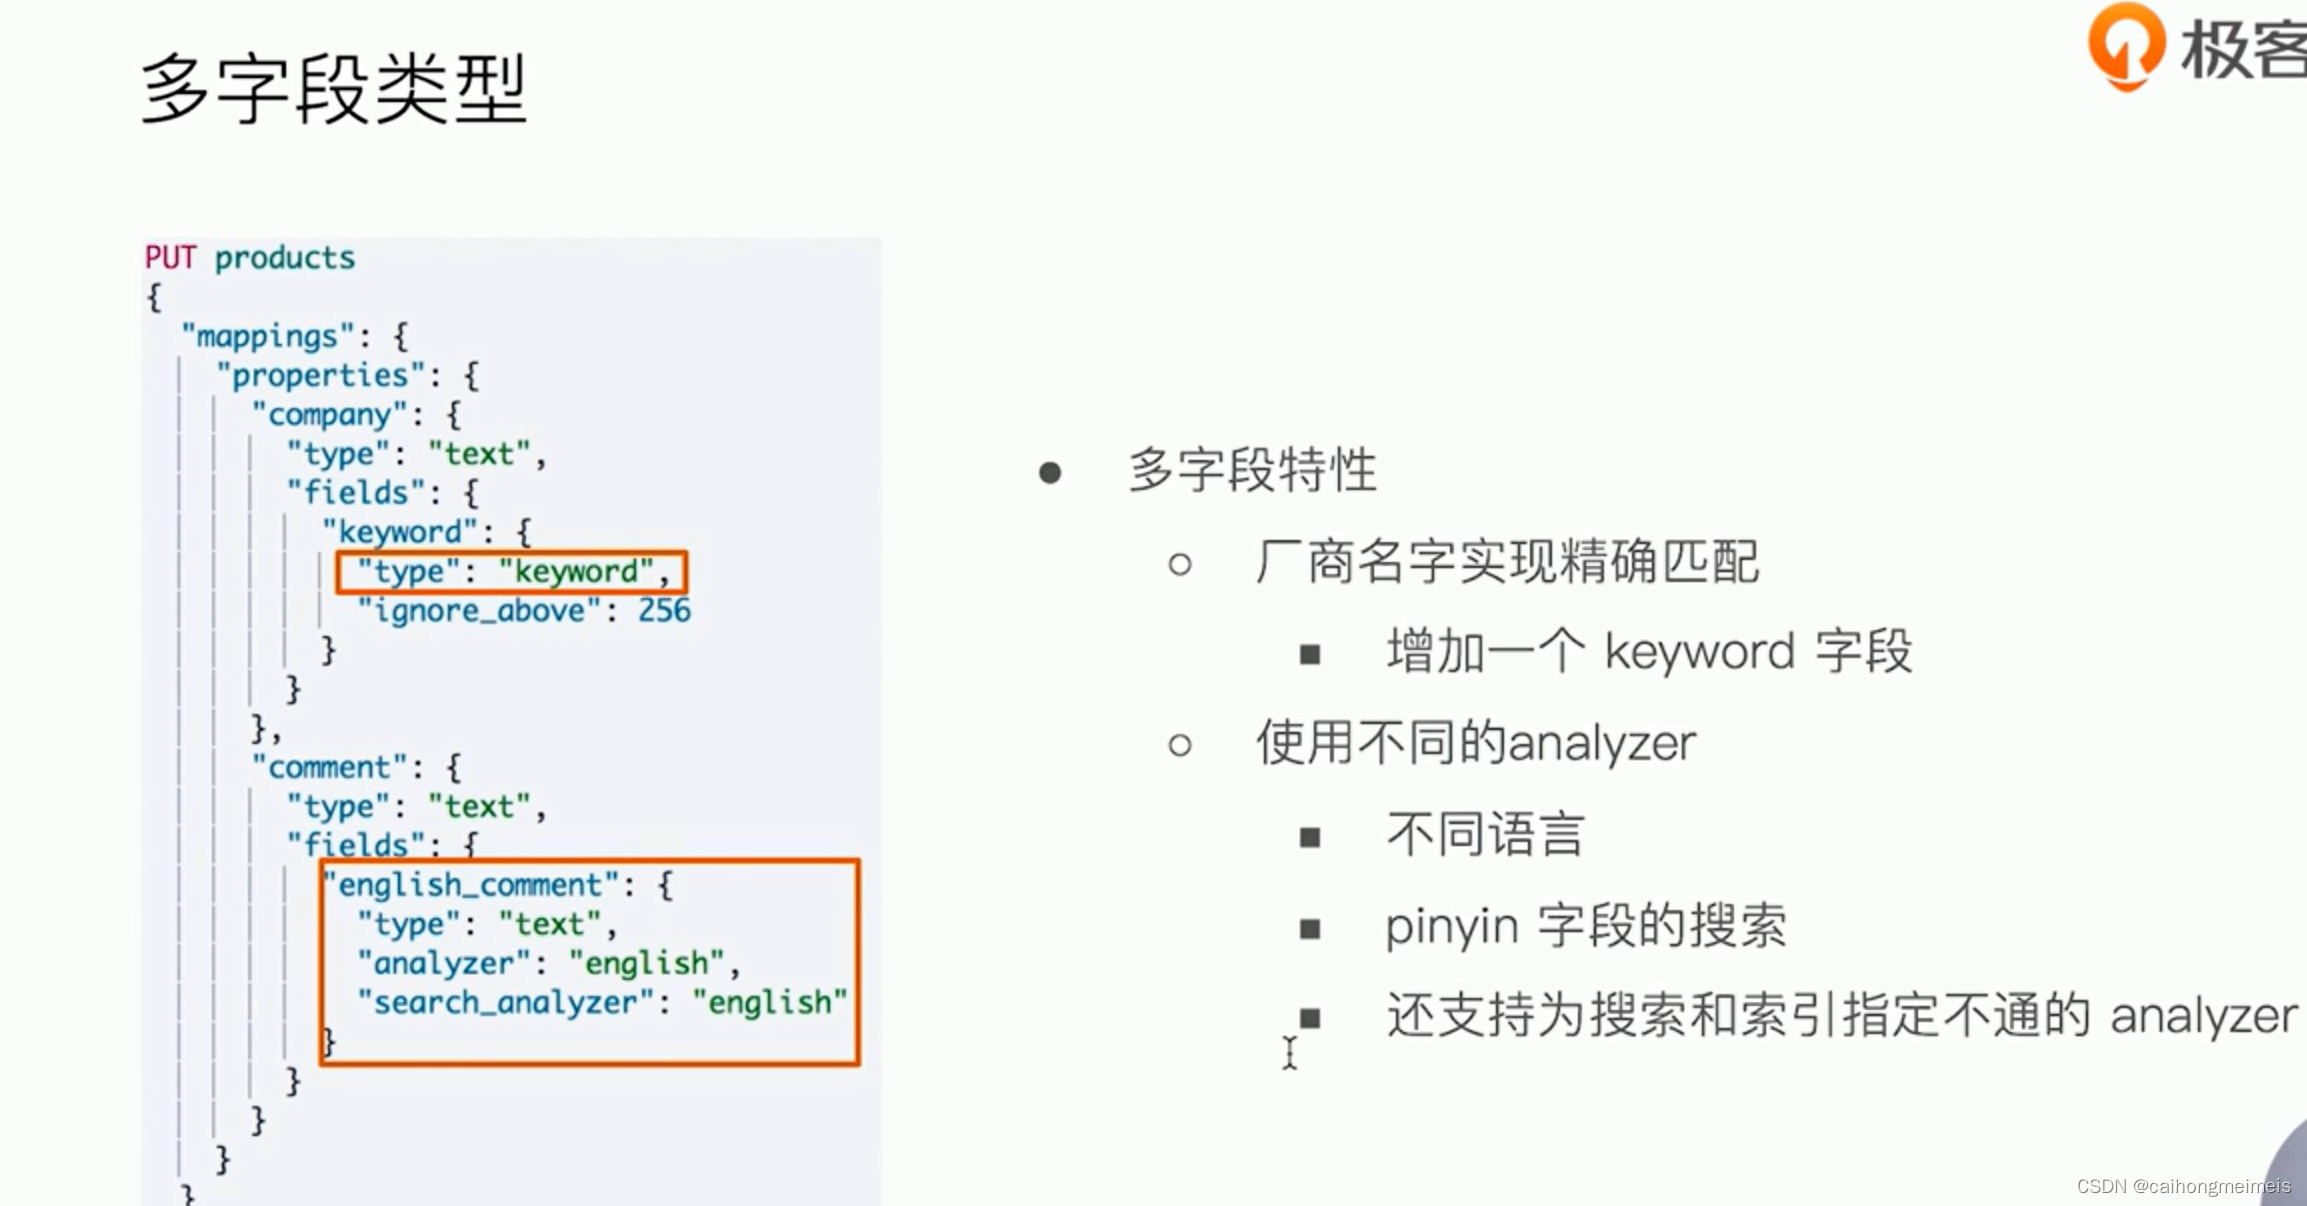
Mapping
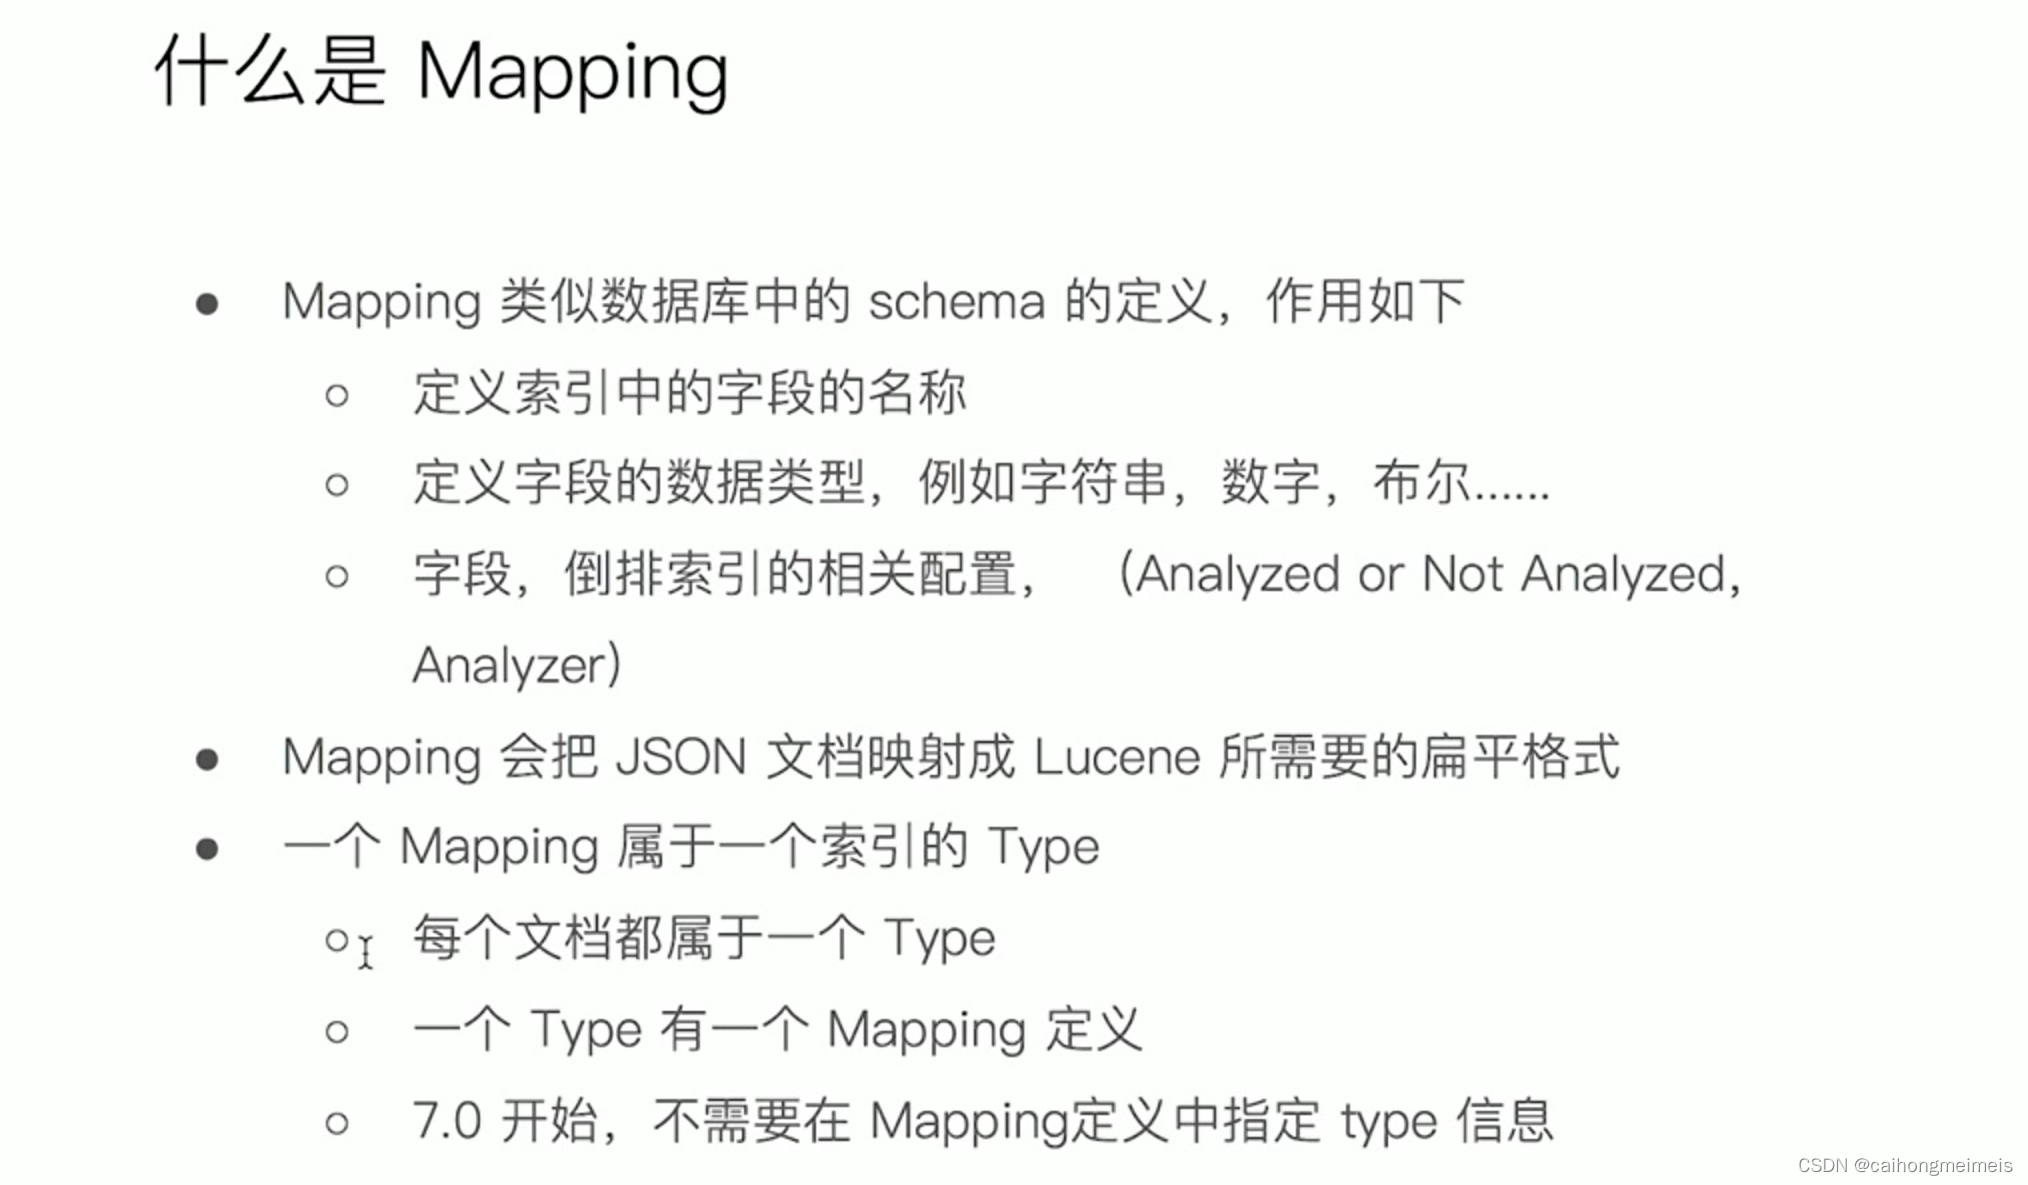
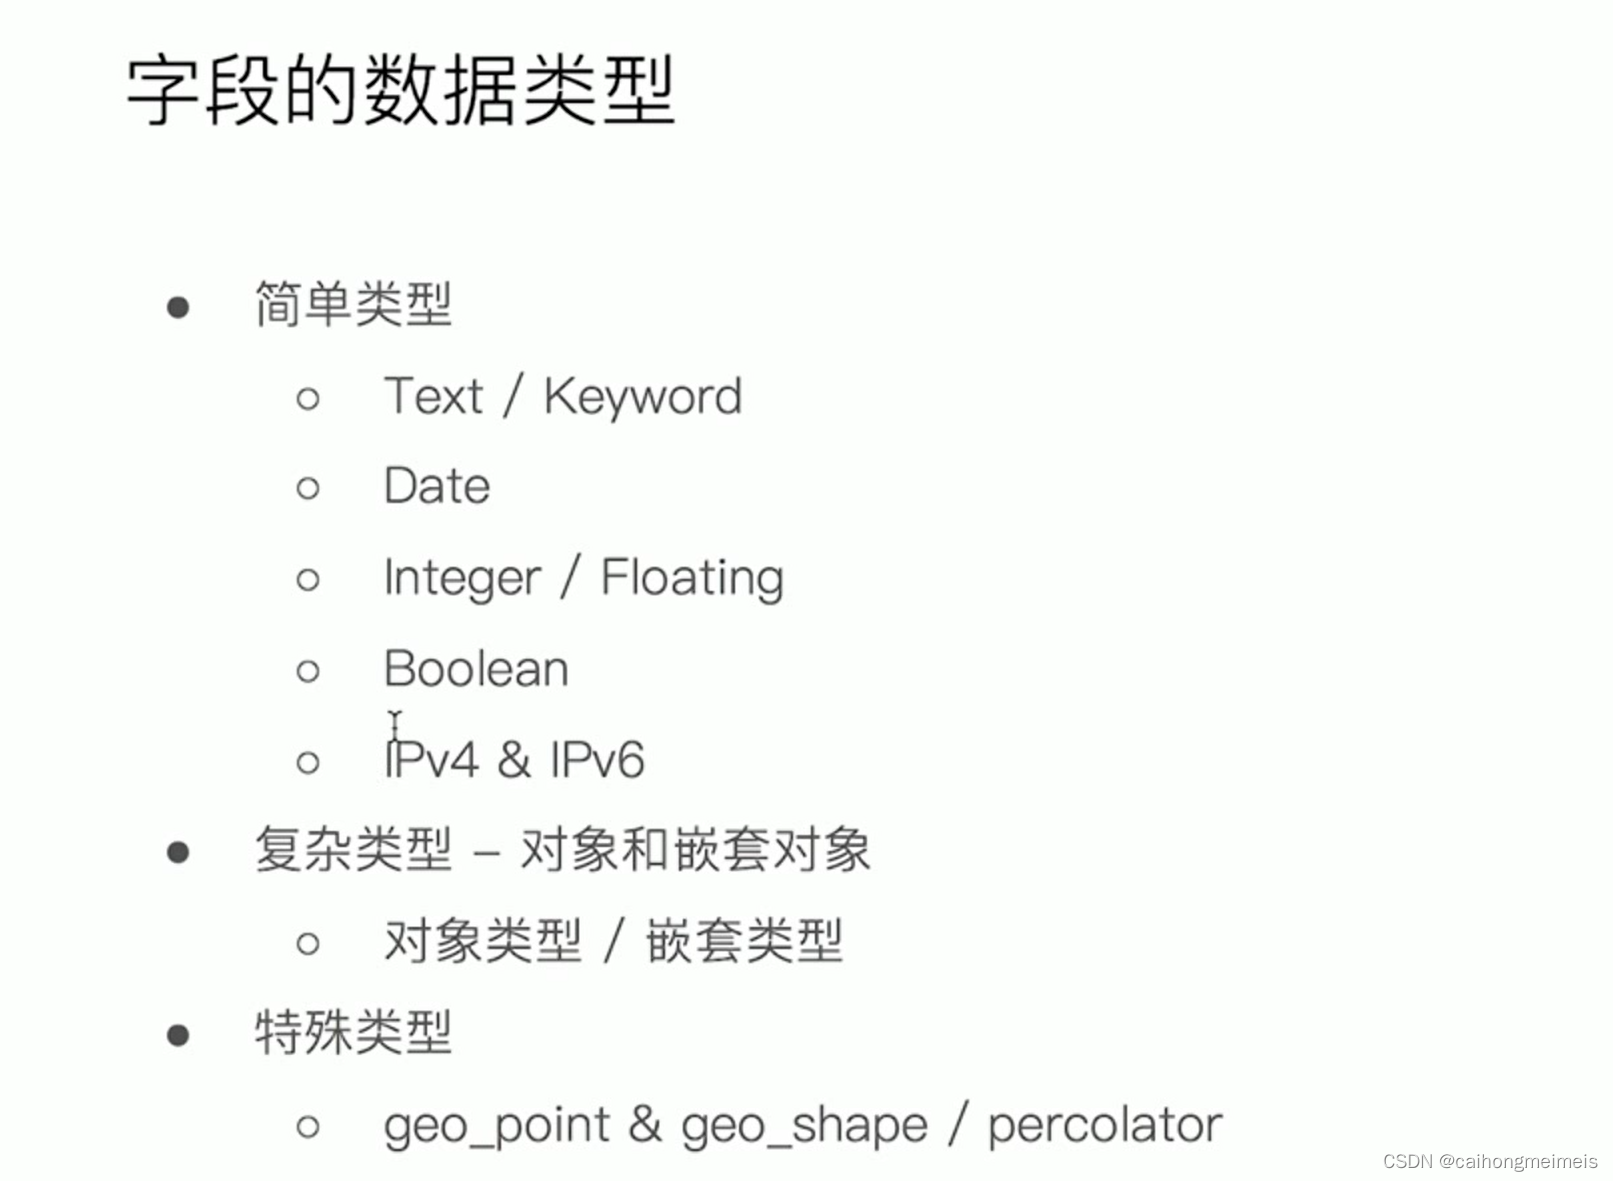
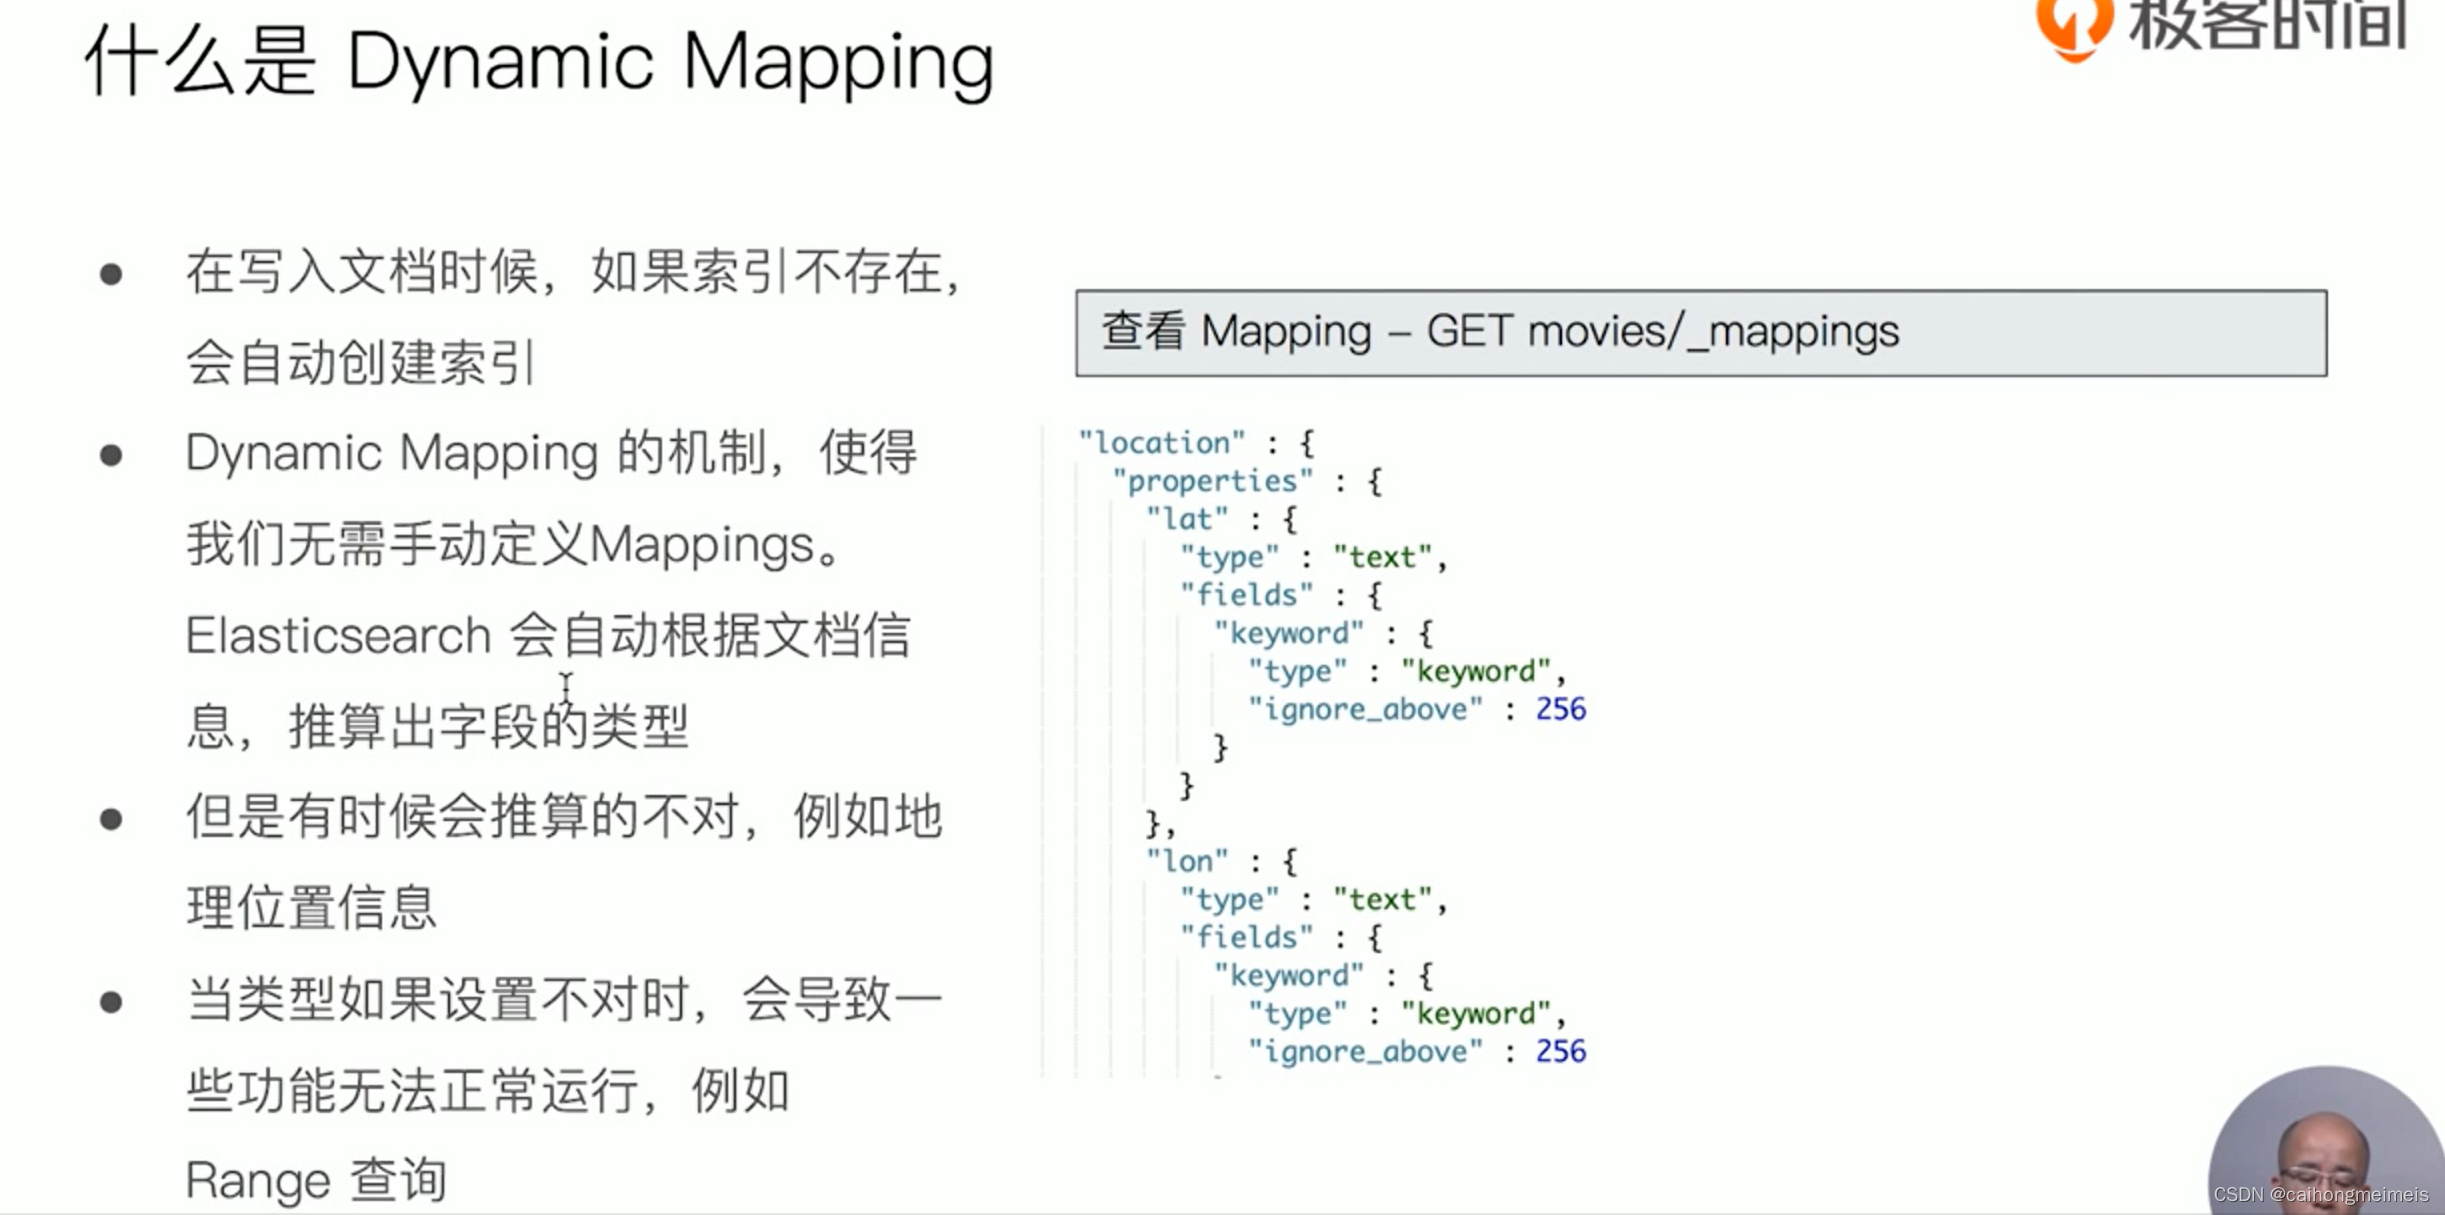
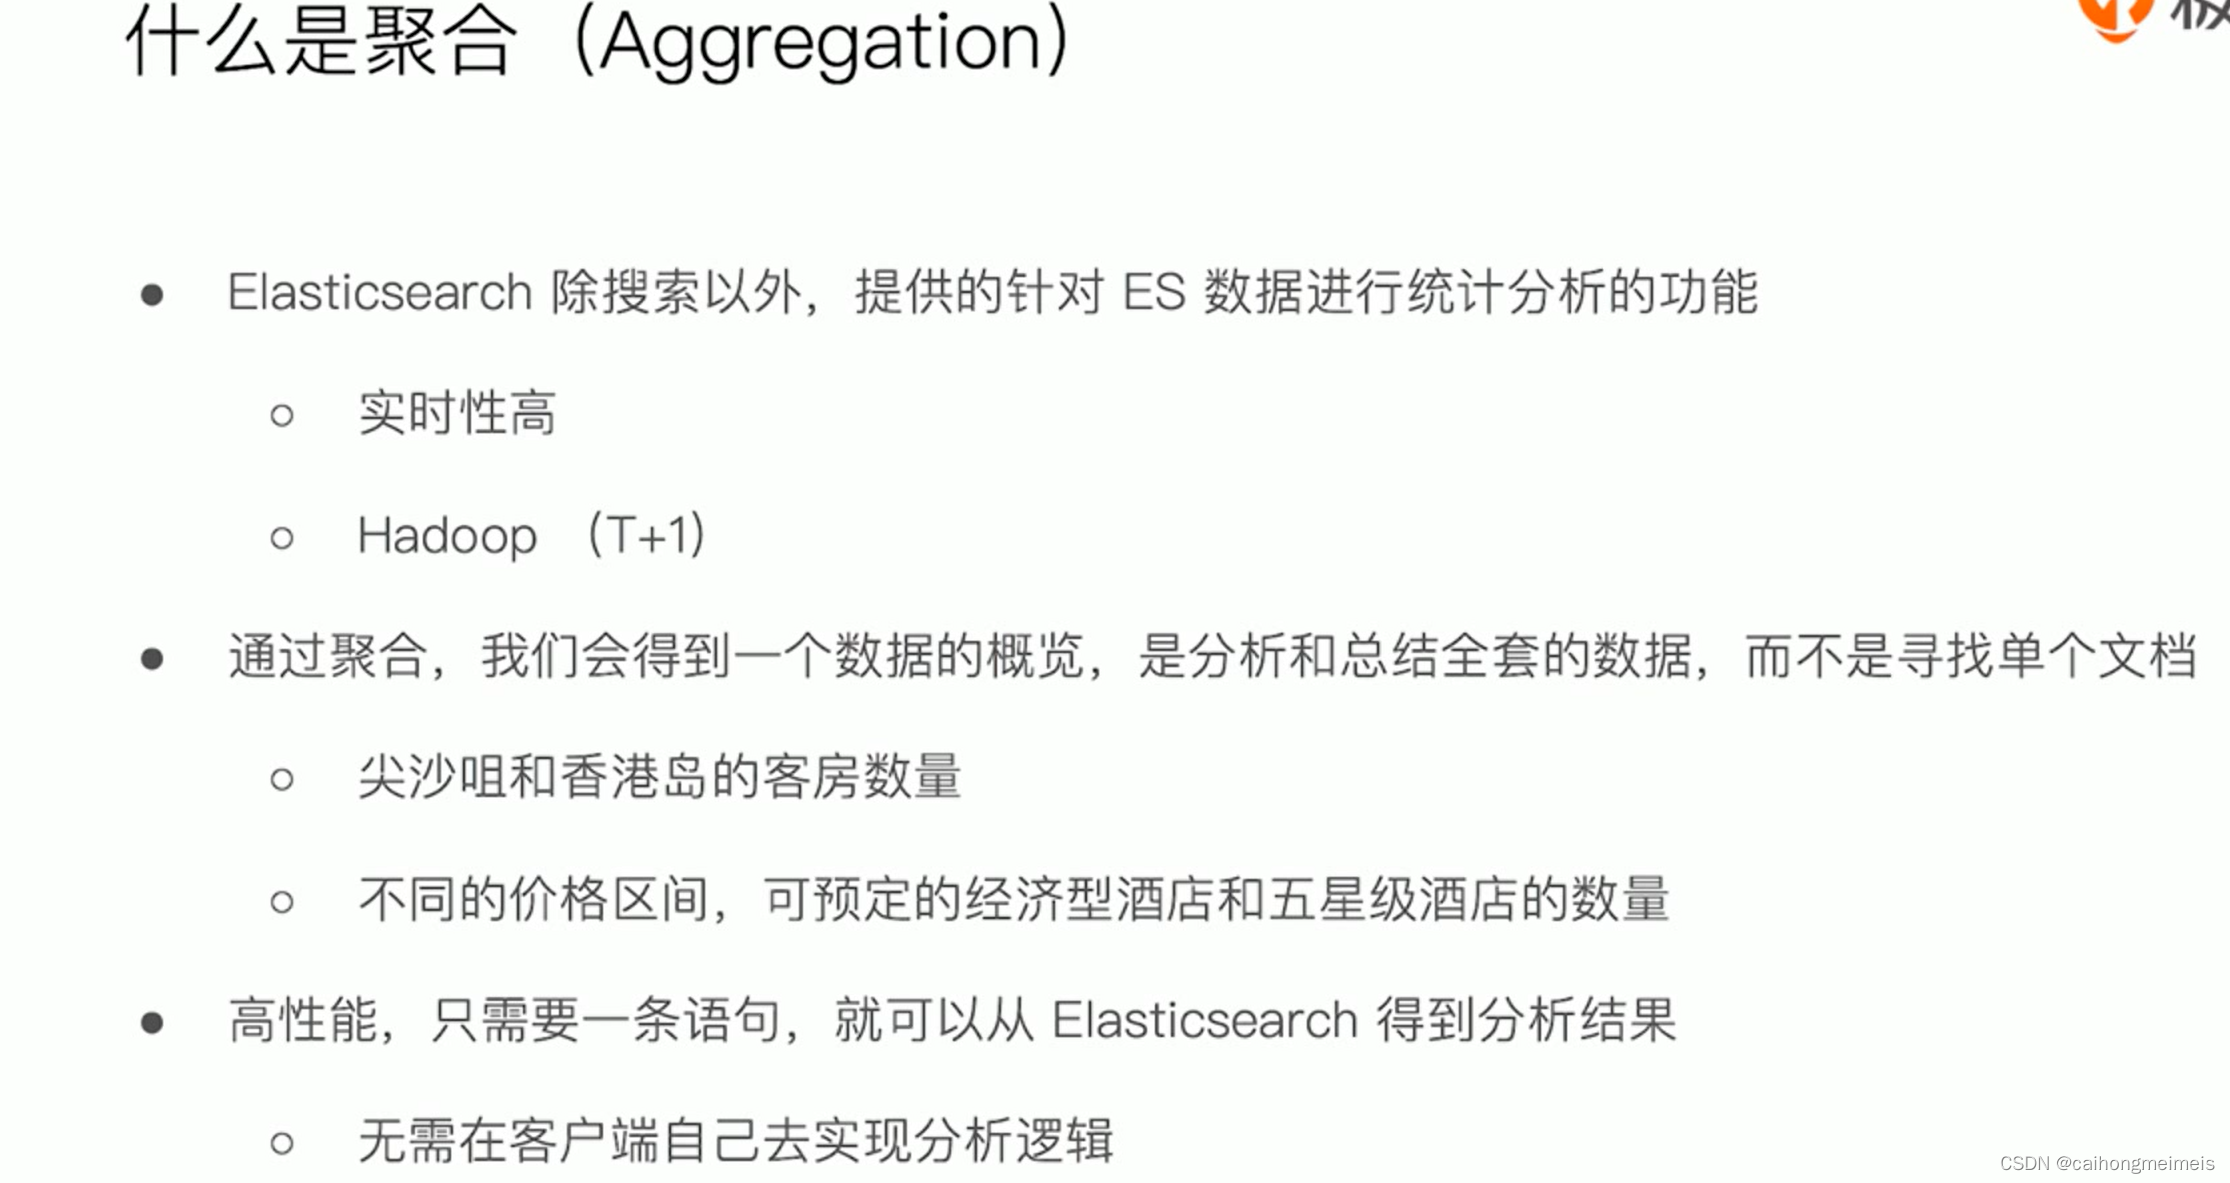
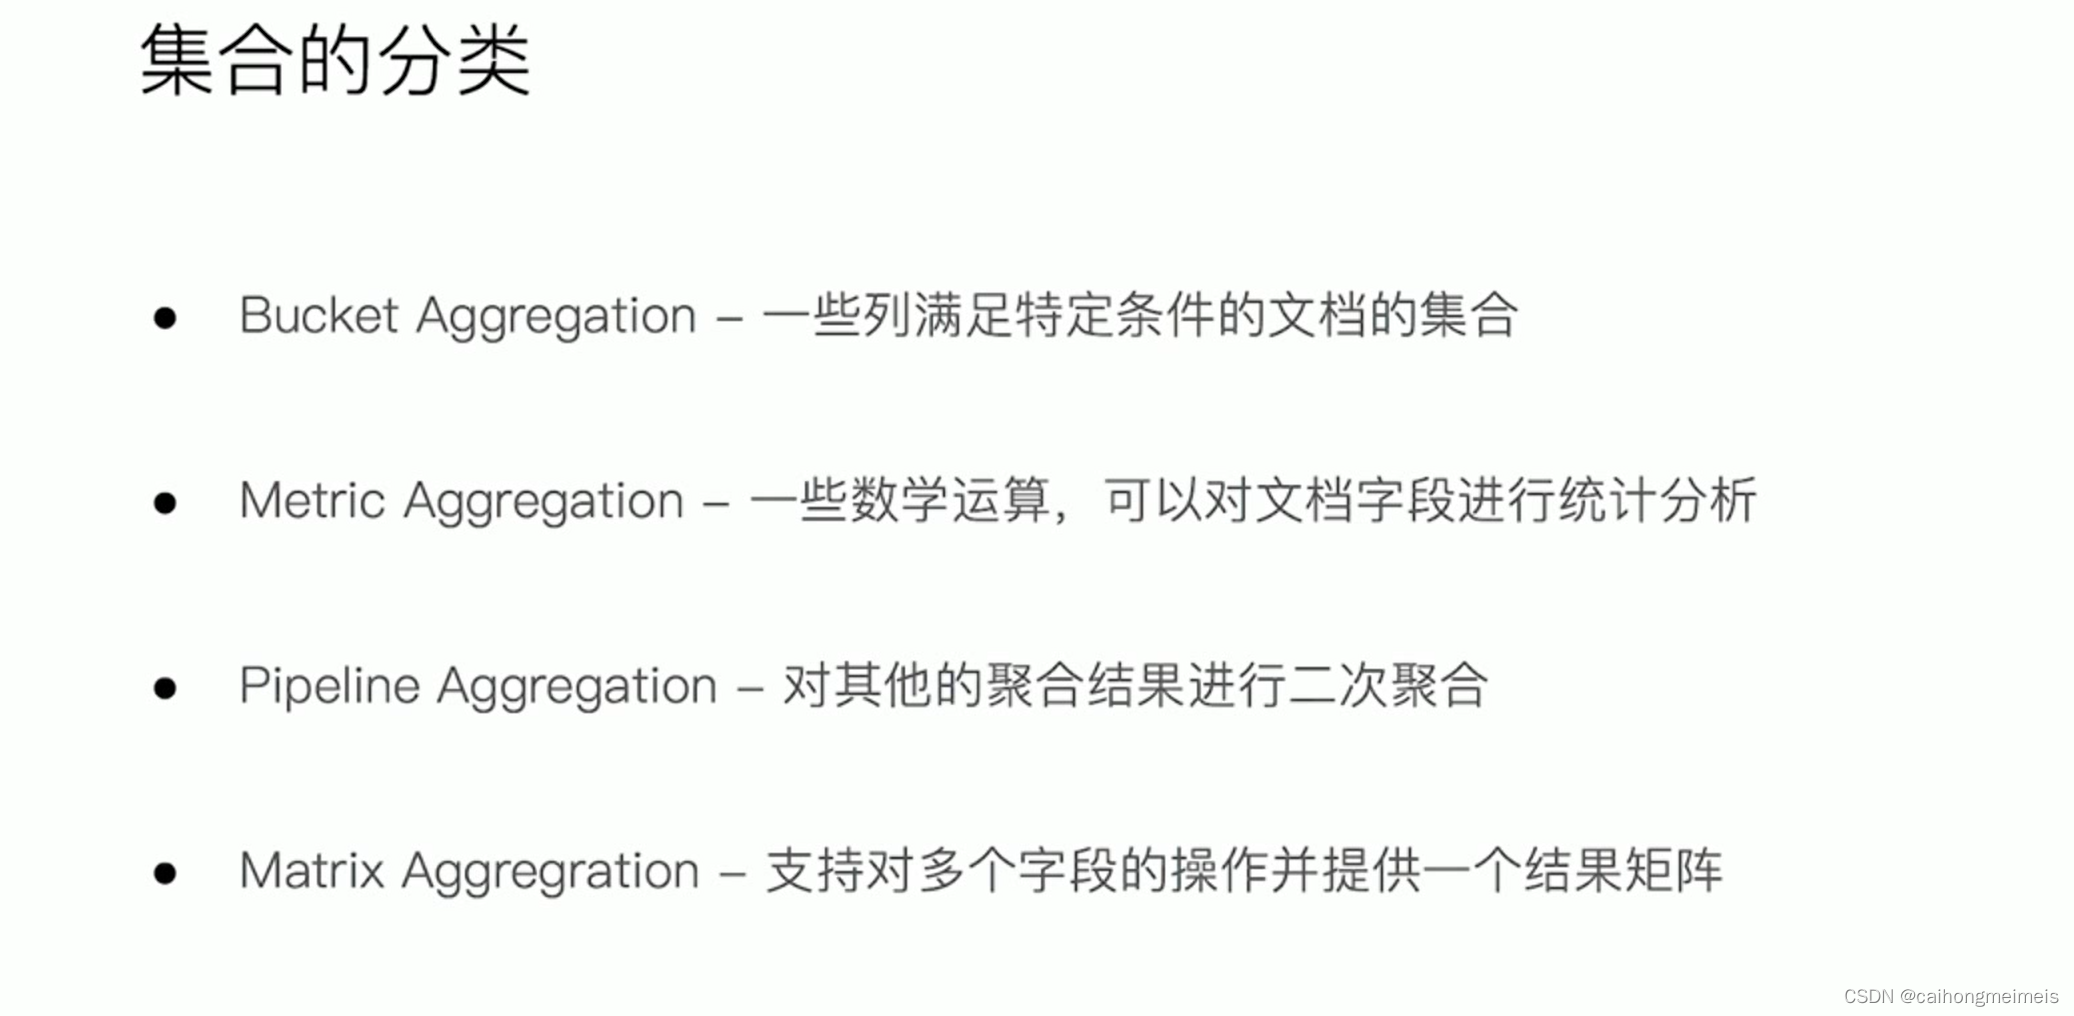
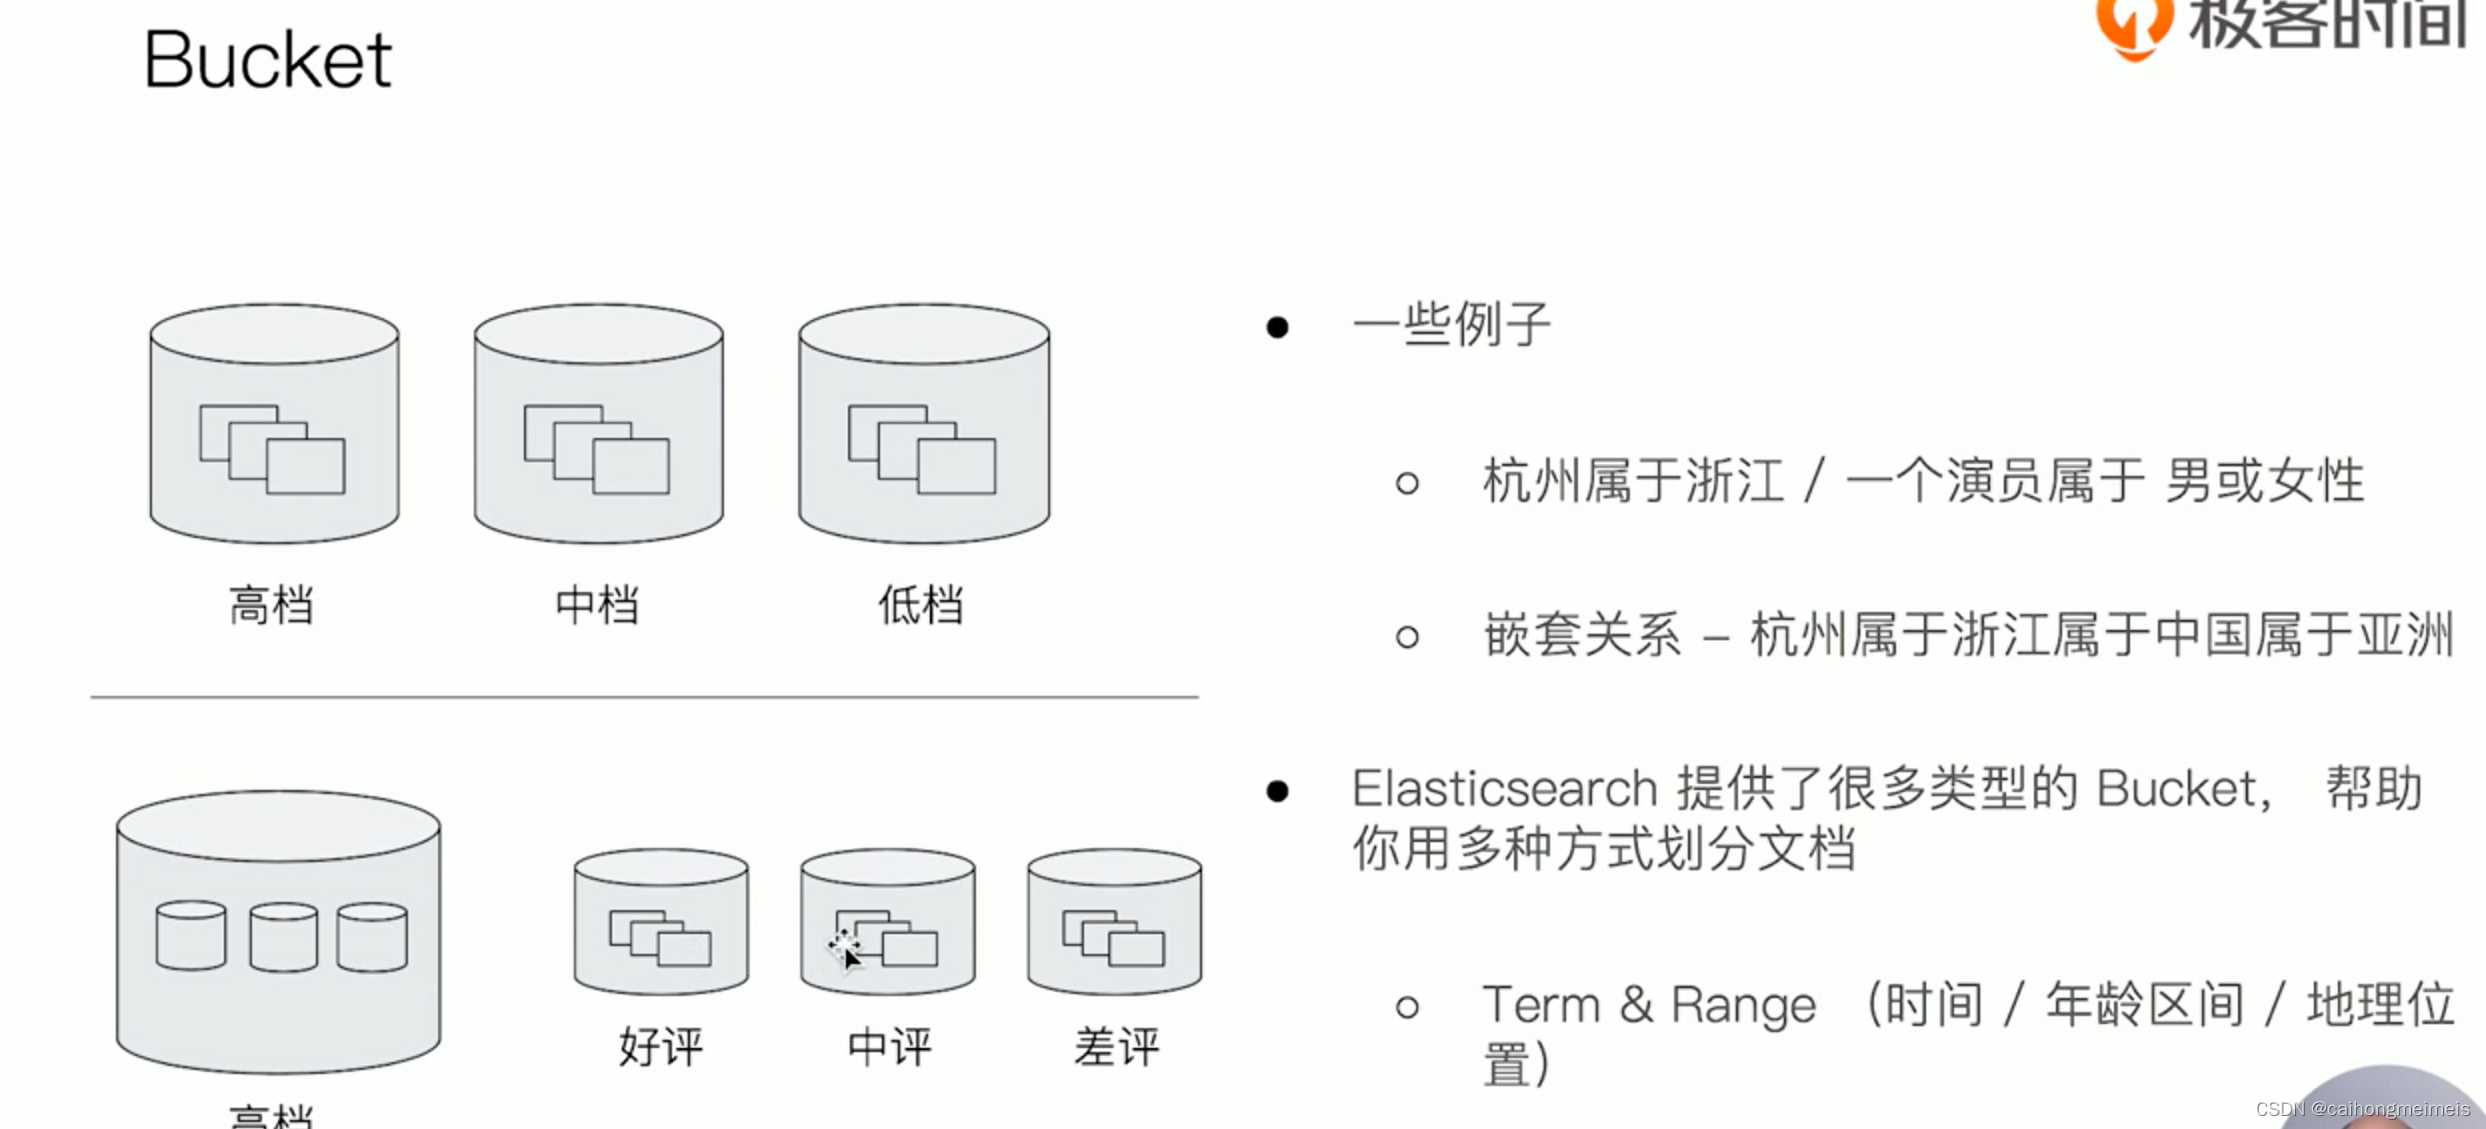
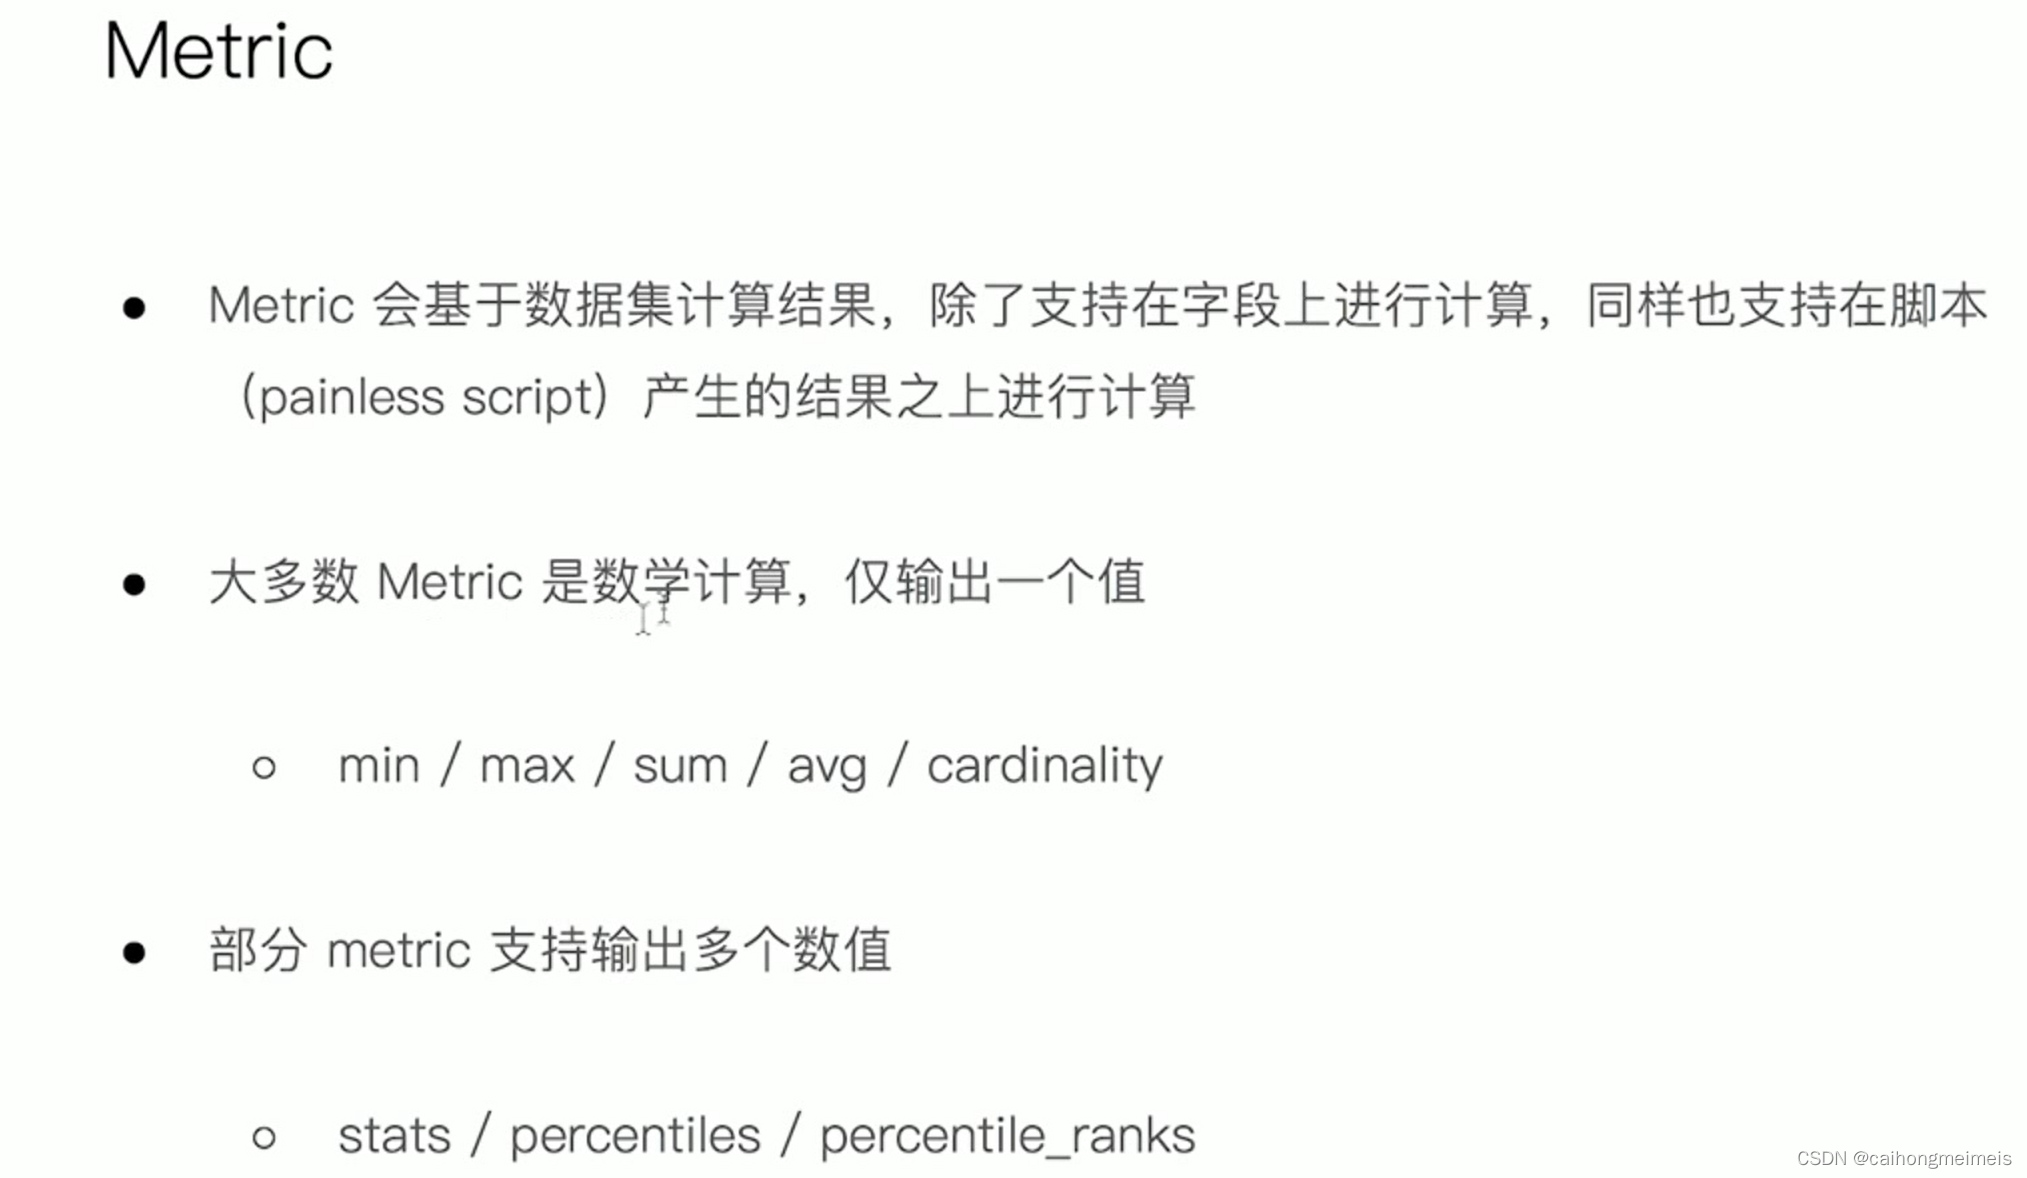
聚合
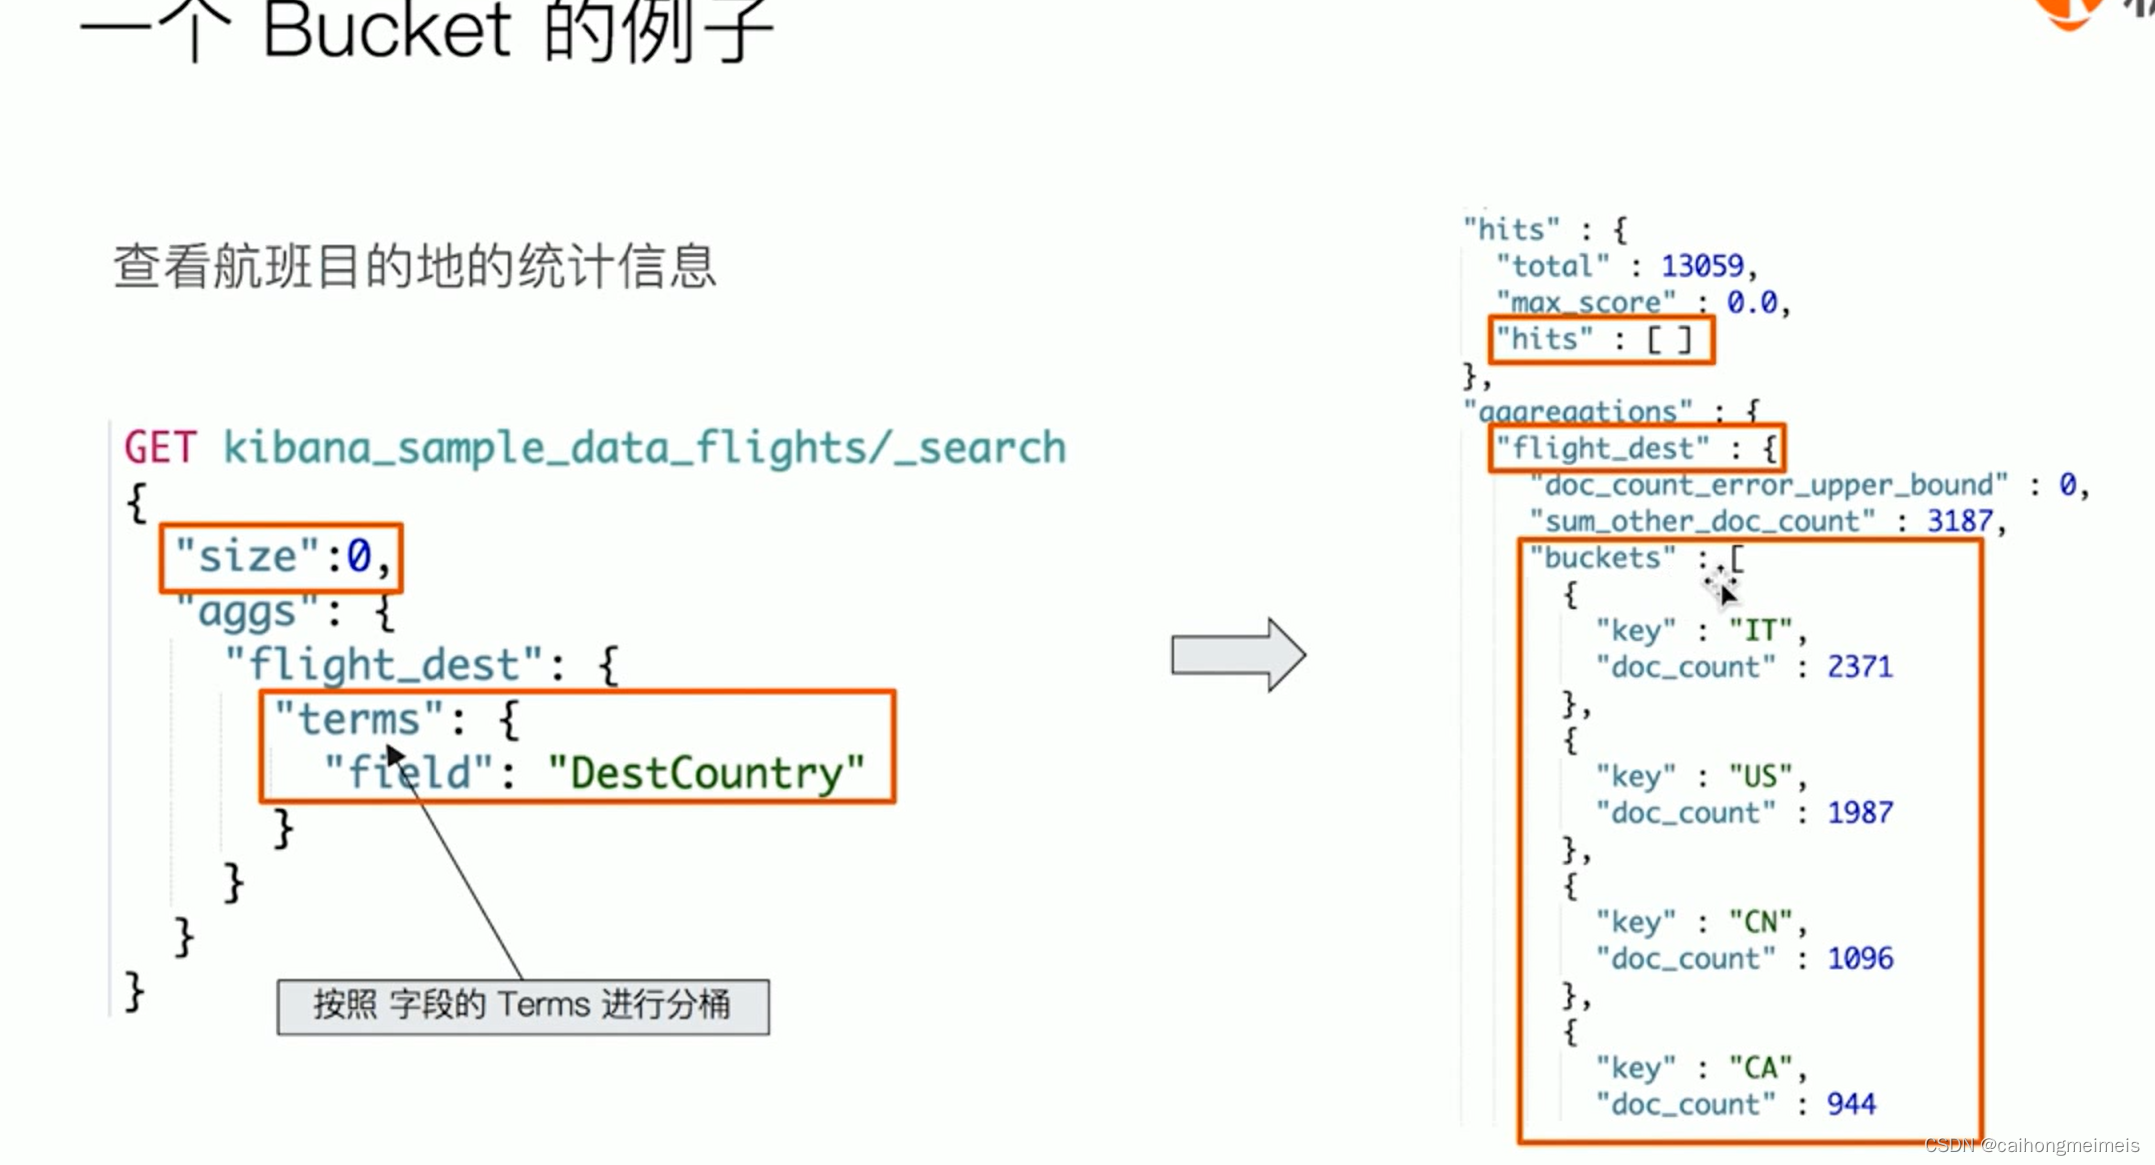
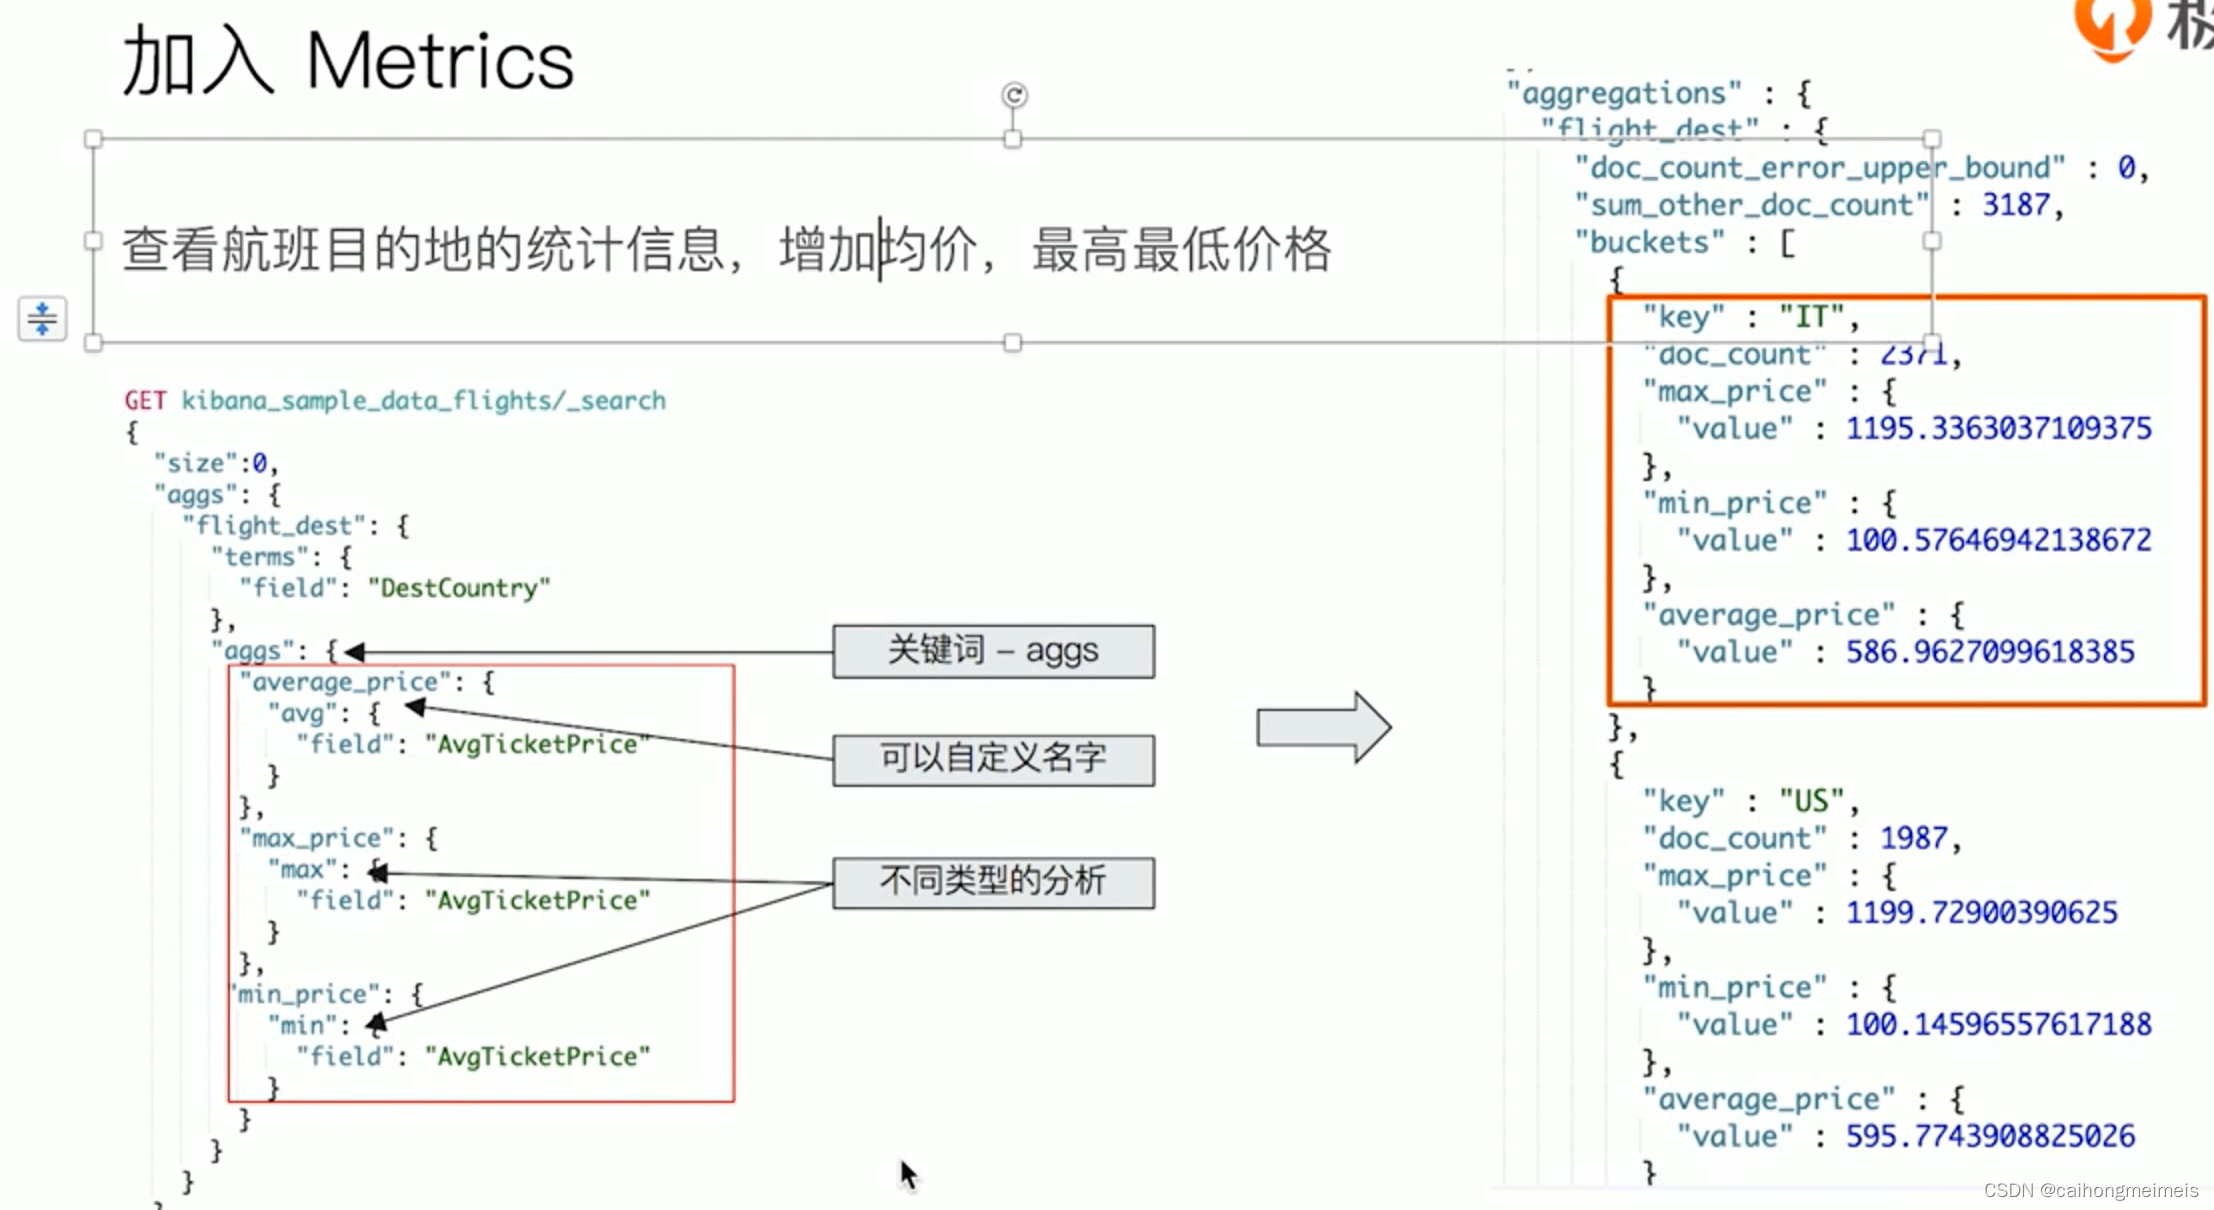
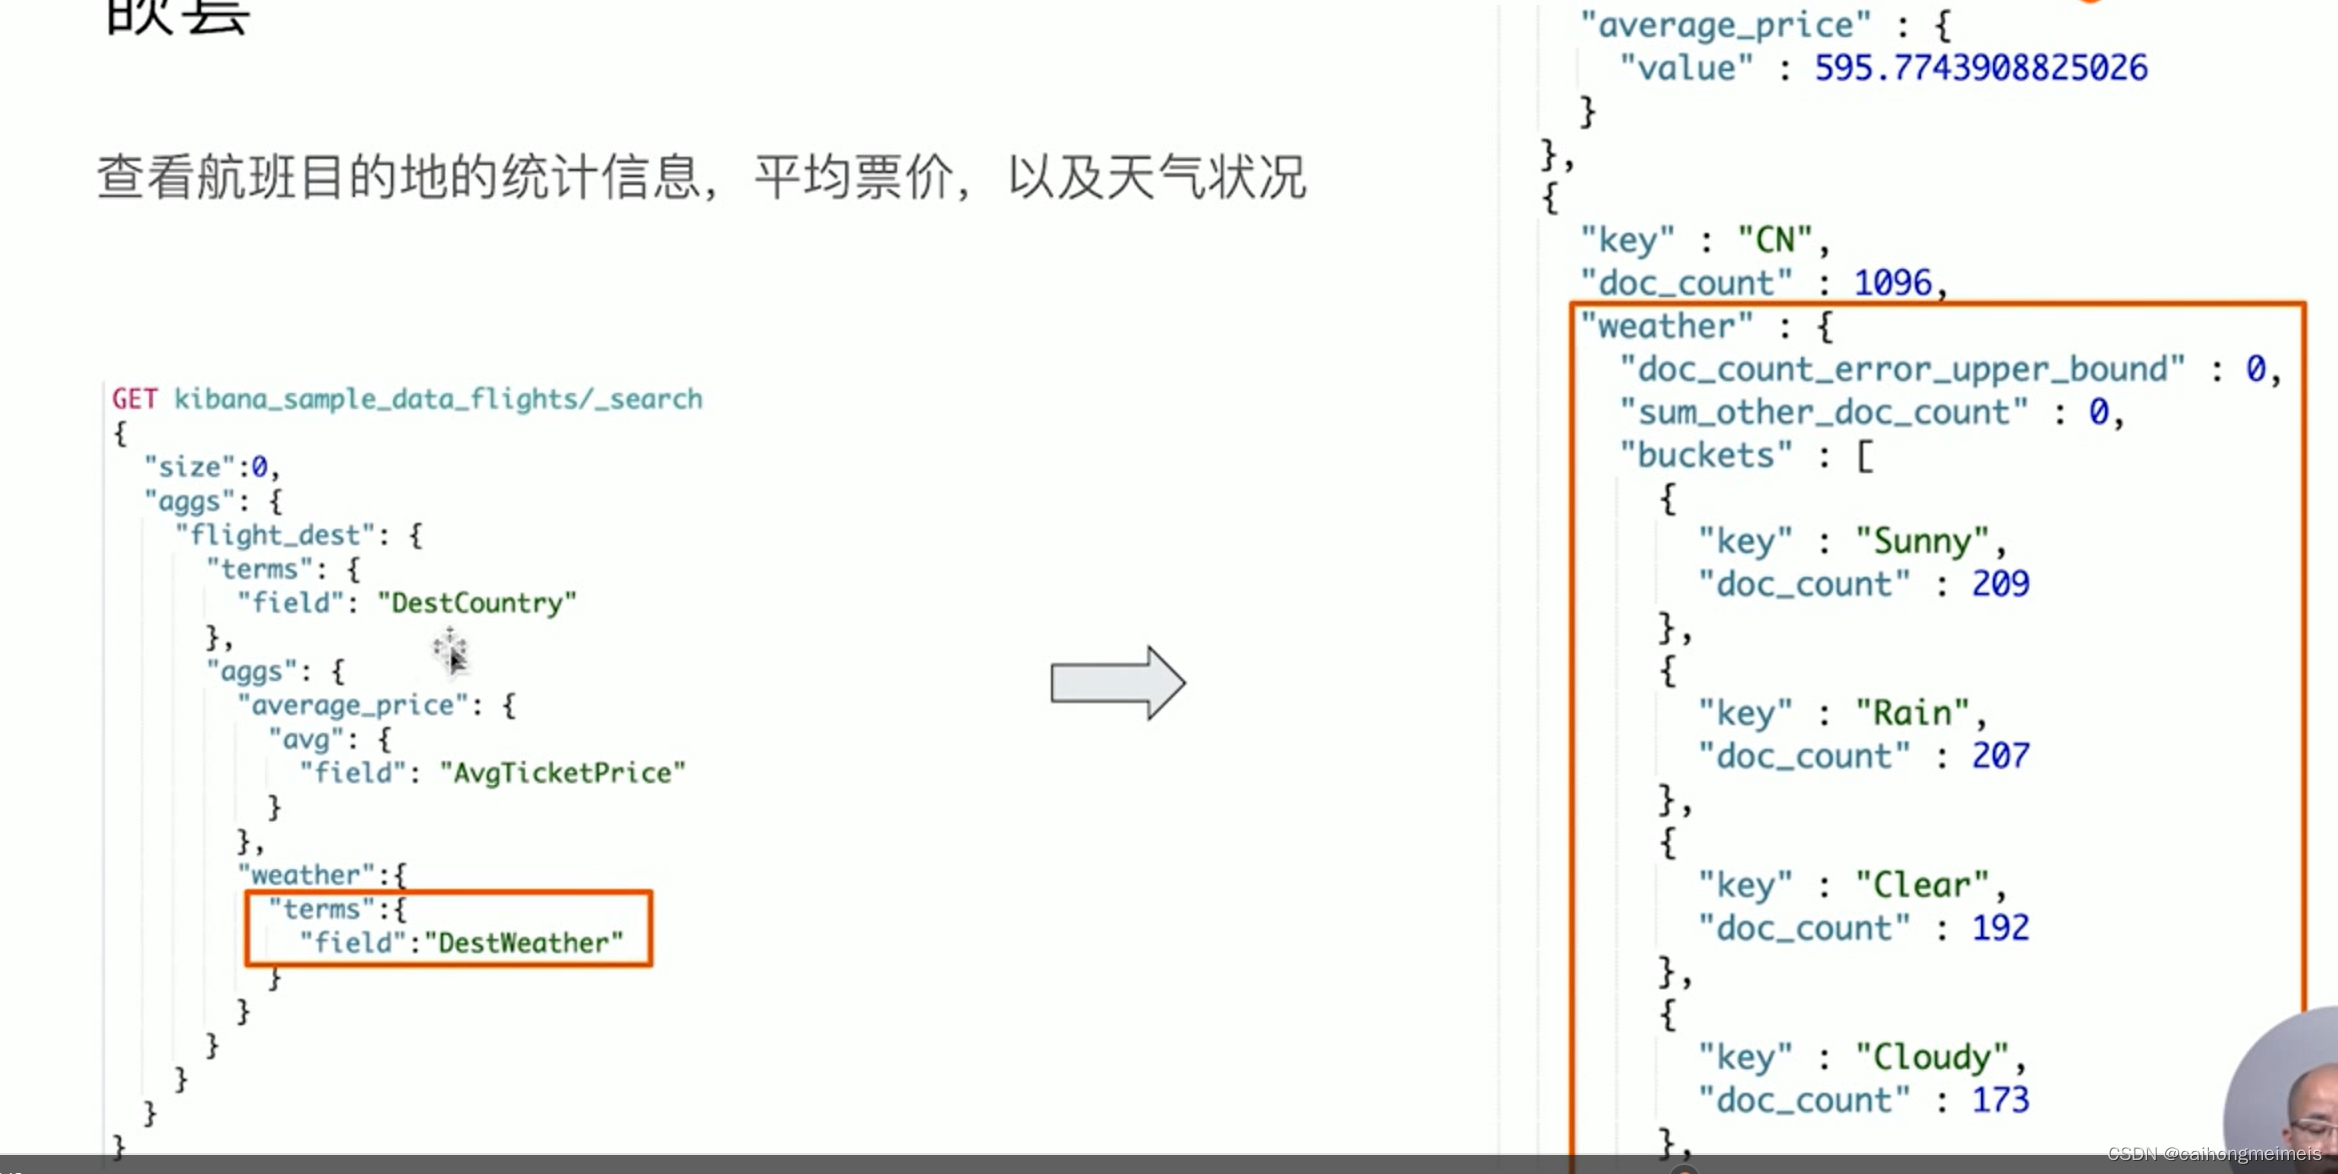
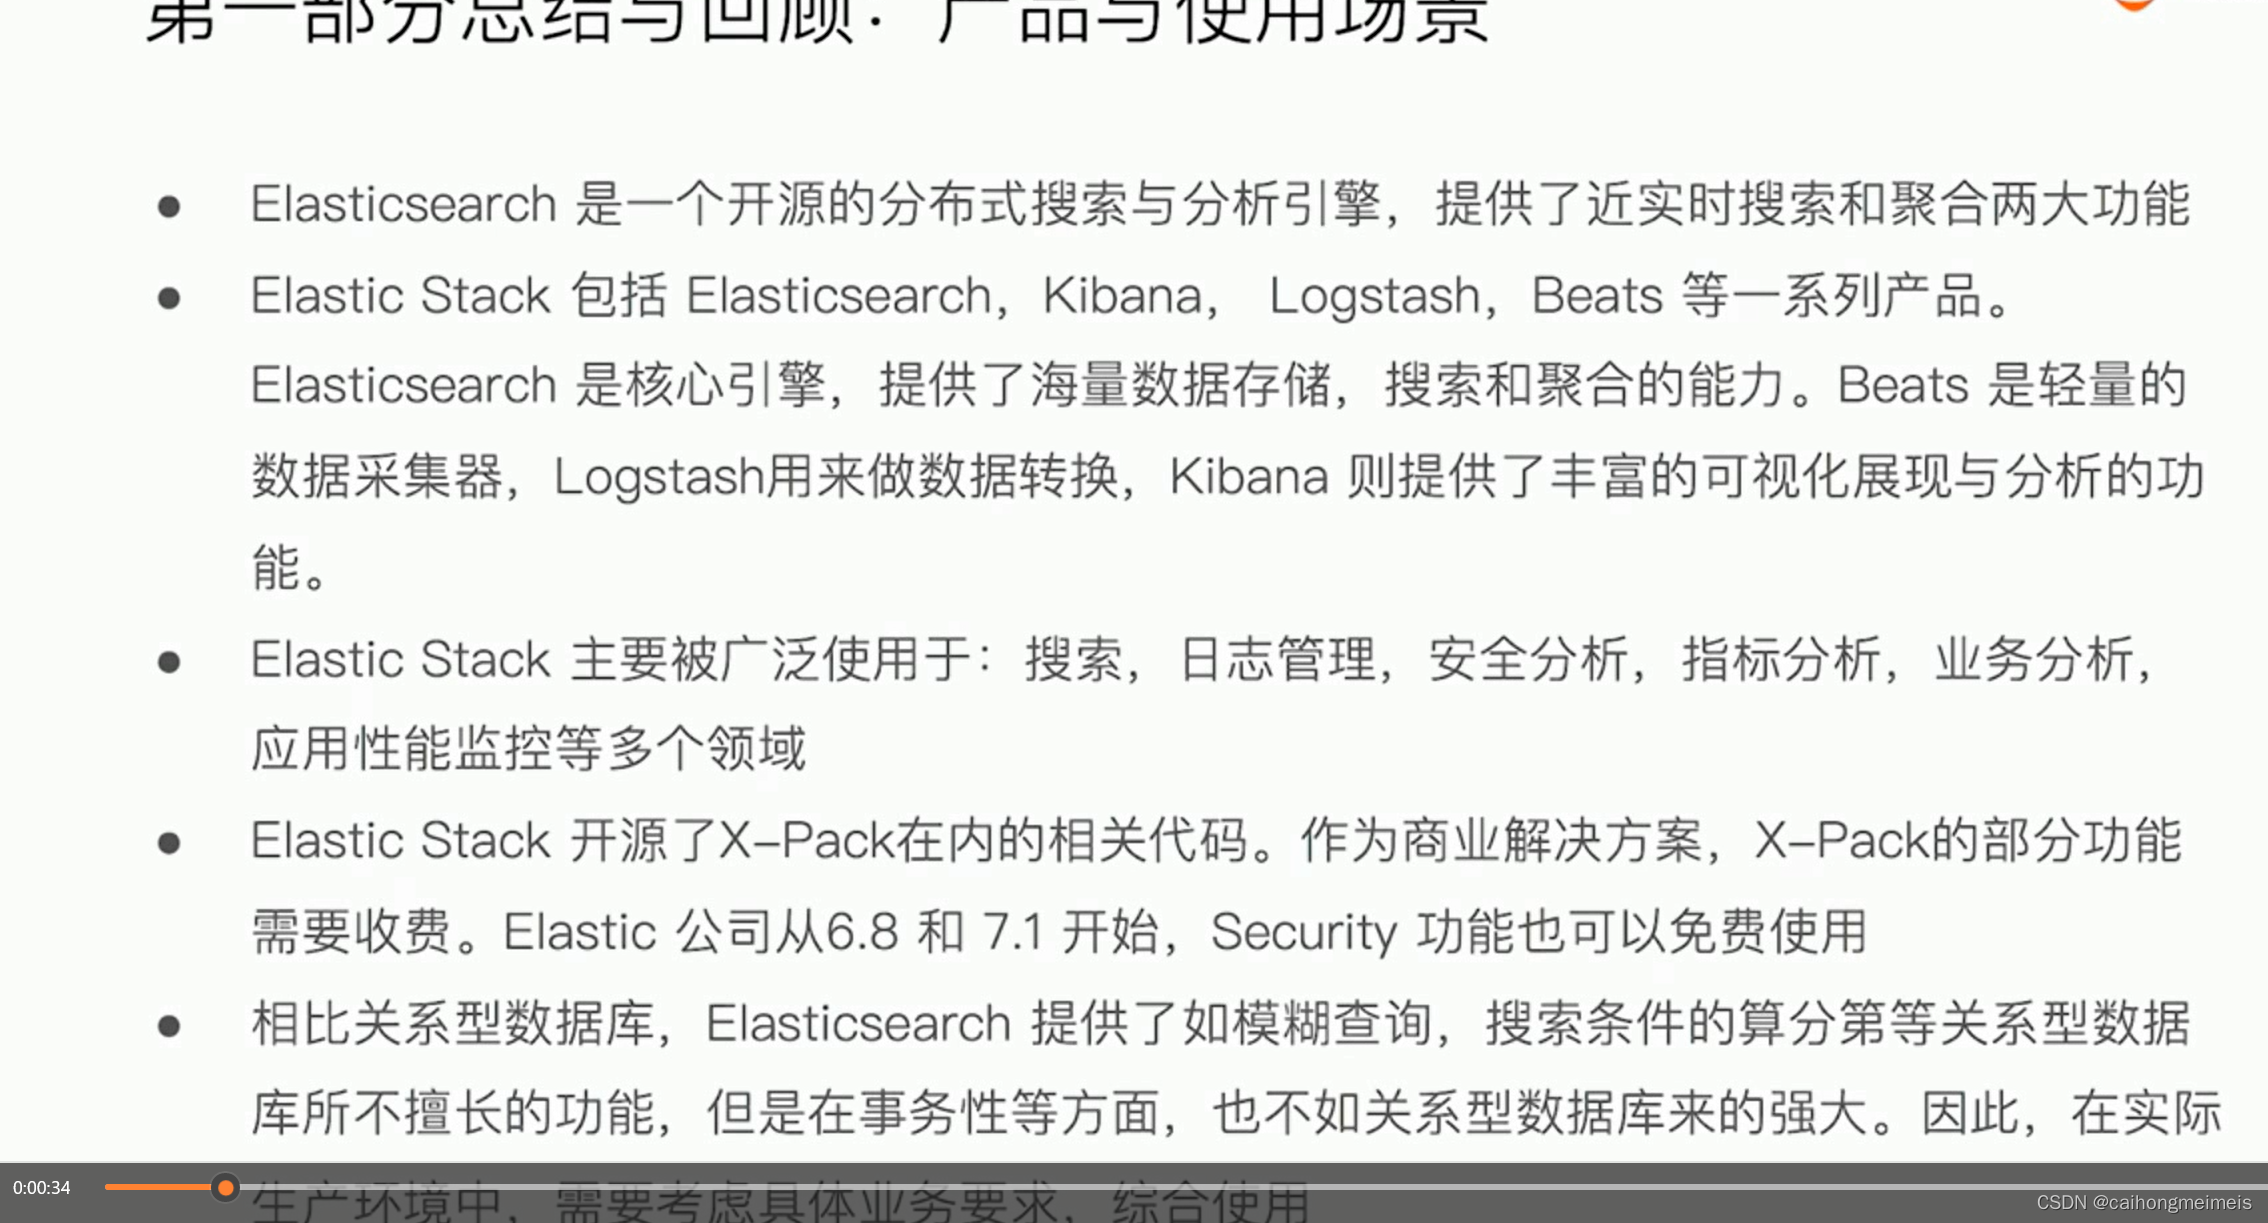
总结
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/73703.html