Deepseek v3.2更新了,有哪些值得注意的地方?
谢邀。
麻了,下午群里突然一堆人喊我,我看到都麻了,别催了别催了,已经在加班了,刚加班开完会还得来写知乎。
DeepSeek 是真不给活路,你都多余发你那 Terminus,你 Terminate 的不是 V3/V3.1,而是大家的国庆假期啊!
我还有什么好说的呢,DSA 是吧,DeepSeek Sparse Attention 是吧,我 XXXXX!
(原谅这匹加班到精神失常的牛马……)
好了说正经的。
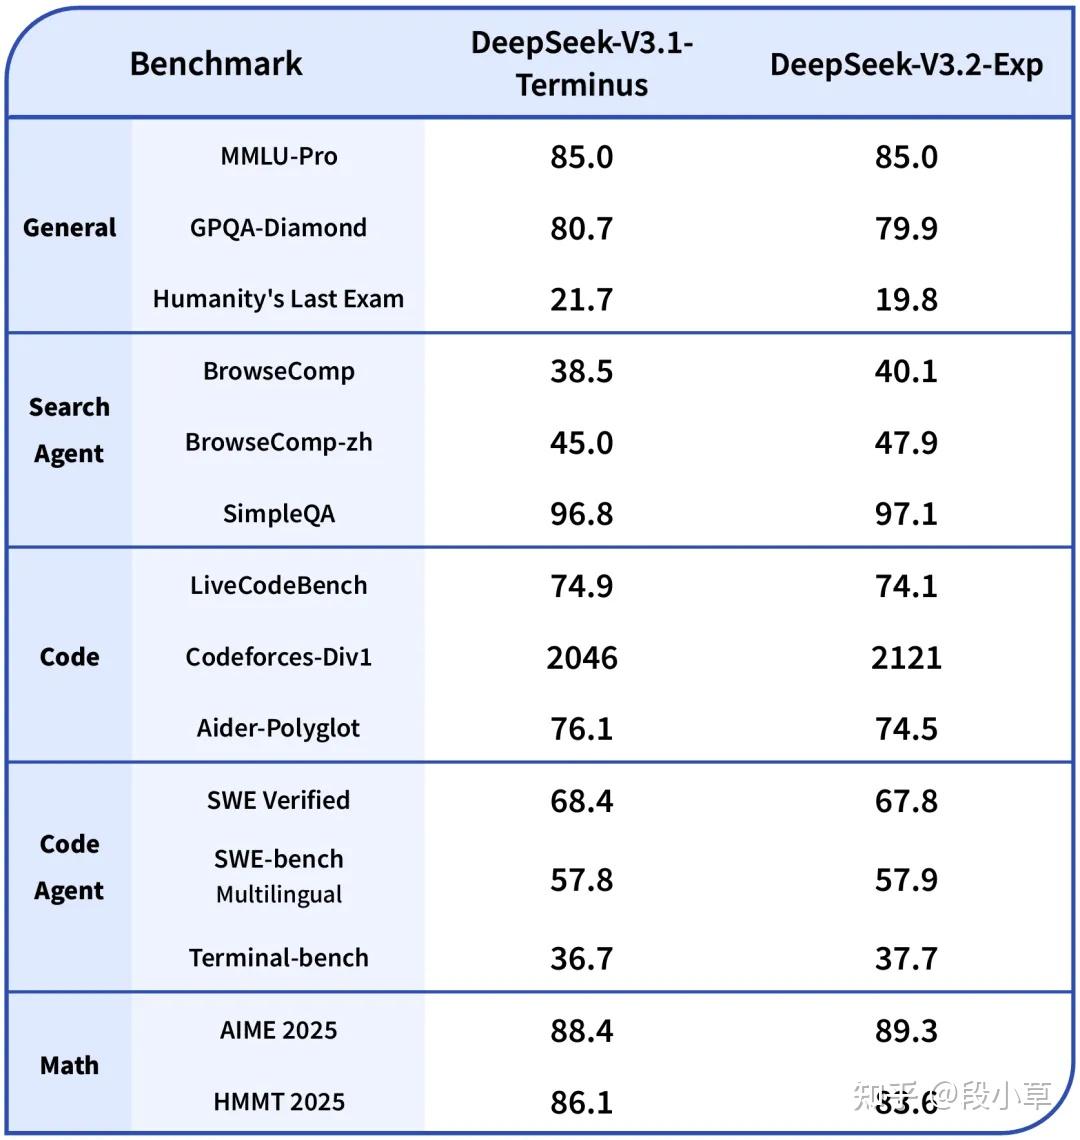
这次的 V3.2-Exp 跟 V3.1-Terminus 相比,能力基本持平,相差的幅度可以忽略不计,对用户来说基本可以看作同一个模型:
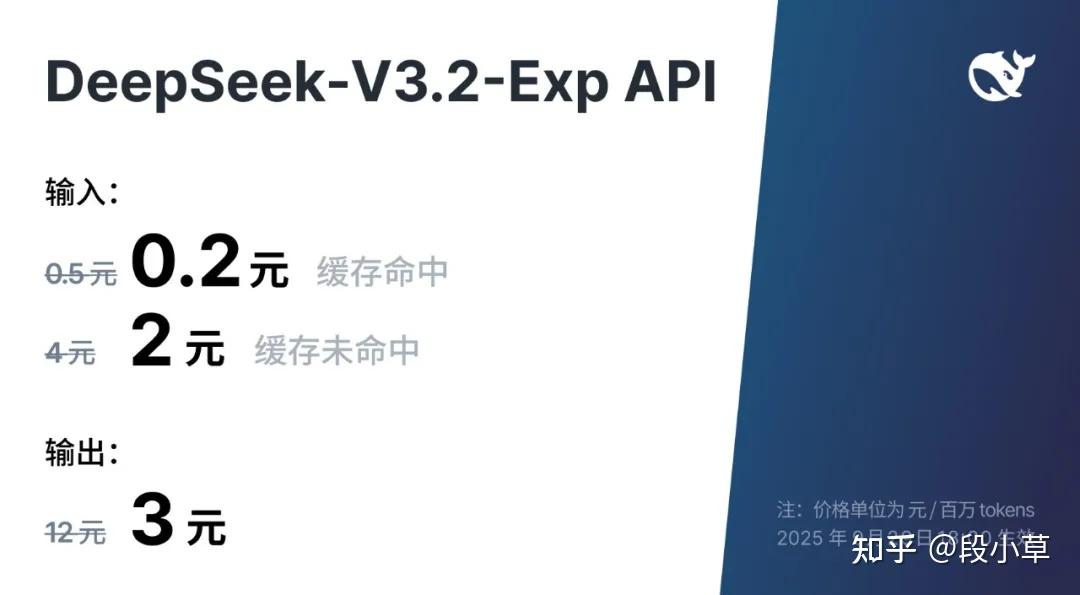
Damn 是!定价下降了 50%~75% 你敢信?!真的快要梦回 1 元/ 1M tokens 的时代了。
去年 5 月,DeepSeek 第一次出圈,就是因为 DeepSeek V2 率先把大模型的 tokens 定价带到了 1 元级别,挑起了大模型的价格战。
但是你要知道,DeepSeek V2 只是一个 236B 尺寸的模型,相比于之后 671B 的 DeepSeek V3/R1,V2 便宜一些也是合理的。
DeepSeek R1 的定价是 ¥4 和 ¥16,就这也足以打得国外同级别模型找不着北了。
现在你跟我说,DeepSeek 在模型参数量级不变、推理能力不下滑的情况下,让价格重回 ¥2/¥3,我 XXXXX!
OK,能力从何而来,答案就是 DSA,DeepSeek Sparse Attention。
要知道,之前 DeepSeek 虽然有 MLA (Multi-Head Latent Attention),有 NSA (Native Sparse Attention),但这还是第一次直接用自己的品牌命名的技术机制,得是多么自信,才能用 DeepSeek 来命名这个稀疏注意力机制。
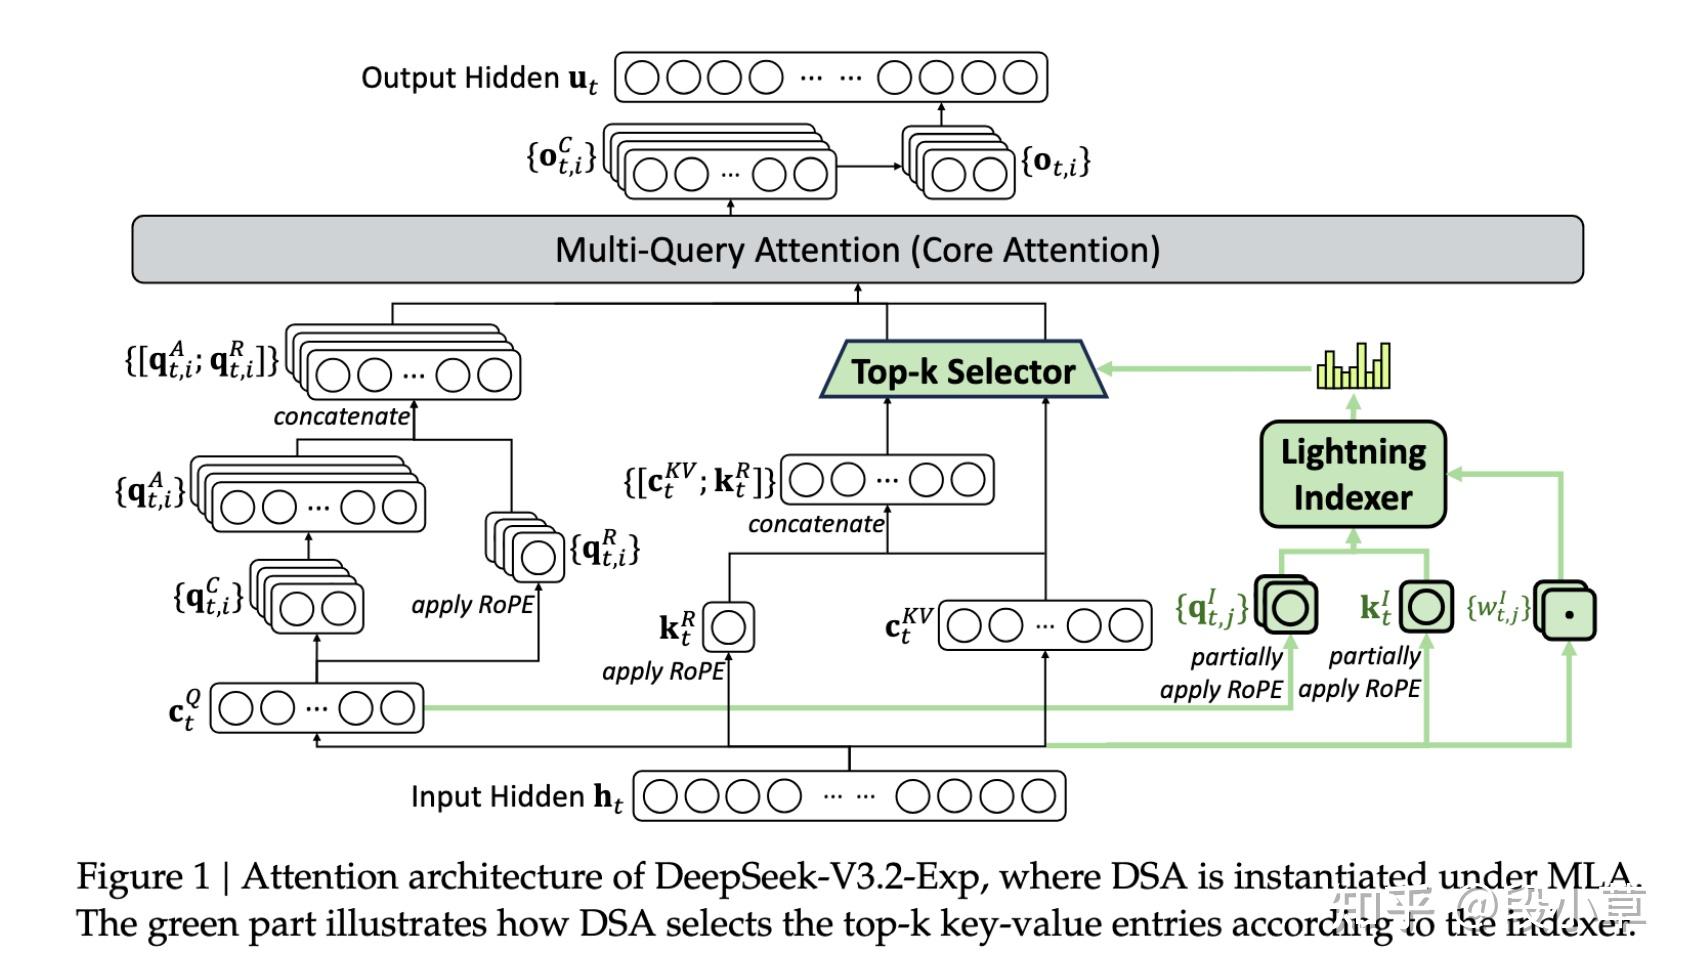
稀疏注意力机制,其实类似于我们做英语阅读时「先略读、后精读」的技巧:
- 先快速浏览章节、标题、关键词,给每一部分的重要性打分,用最少得计算量抓住重点。
- 然后再精读需要重点注意的少数关键信息,确保输出内容的质量。
快速索引+预筛选重要信息+在关键信息投入更多精力,避免了简单粗暴的计算。
带来的效果就是:
- 大幅降低长文本处理成本,无论是训练还是推理,处理长文档、长对话或大型代码库的成本都大大降低;
- 让「无限上下文」成为可能:随着处理长文本需求的计算增长变得平缓,那么模型能够处理的上下文长度就能大大增加;
- 在提升效率的同时保持高性能:DSA 的关键之处在于,提升效率的同时不以牺牲能力为代价,又快又便宜又聪明;
- 保证训练的稳定性:细读论文的训练部分会发现,新模型的训练和旧模型一样平稳,这说明 DSA 是可靠的,可以稳定应用在未来更多的模型开发中。
顺便一提,今天有很多 0 day 适配 DeepSeek V3.2-Exp 的国产 GPU 厂商。
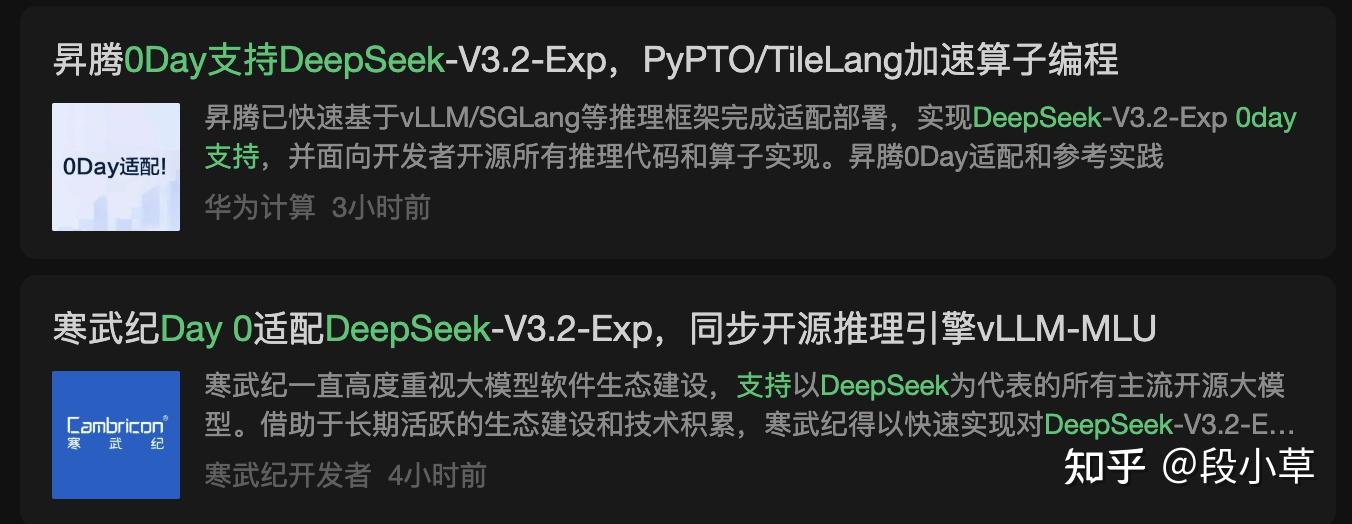
这不是偶然,说明不论哪一方主动(甚至不排除有第三方撮合),DeepSeek 都已经事实上跟国产 GPU 厂商达成了深度的合作,会提前验证模型在国产 GPU 上的推理性能和可用性。甚至可以由此推测,今后 0 day 支持 DeepSeek 新款模型的 GPU 会越来越多。
不说了,我接着啃论文去了。
下半年的节假日不多了,DeepSeek 不会真到圣诞节、元旦、春节憋个大的吧…… QAQ
欢迎感兴趣的同学用vLLM部署试试,支持NV上面的hopper、blackwell,而且还有昇腾、寒武纪的同学提供的多硬件后端支持
详细步骤可以参见 https://docs.vllm.ai/projects/recipes/en/latest/DeepSeek/DeepSeek-V3_2-Exp.html
How many infra engineers it takes, before you call it real sparse attention?
DeepSeek V3.2,可以说是算法同学最想要、最符合直觉的top 2048 token的sparse attention了,然而,经历过这场适配才能知道,背后有多少infra的坑要踩。
太不容易了,三个时区的同学连轴转一个多礼拜,在DeepSeek提供了很多帮助的情况下,才把hopper kernel集成完了。
先留一个坑,后面再具体分析。
提示,分析这个top 2048 token的sparse attention的关键,在于处理它与continuous batching、paged attention、tensor core之间的关系。
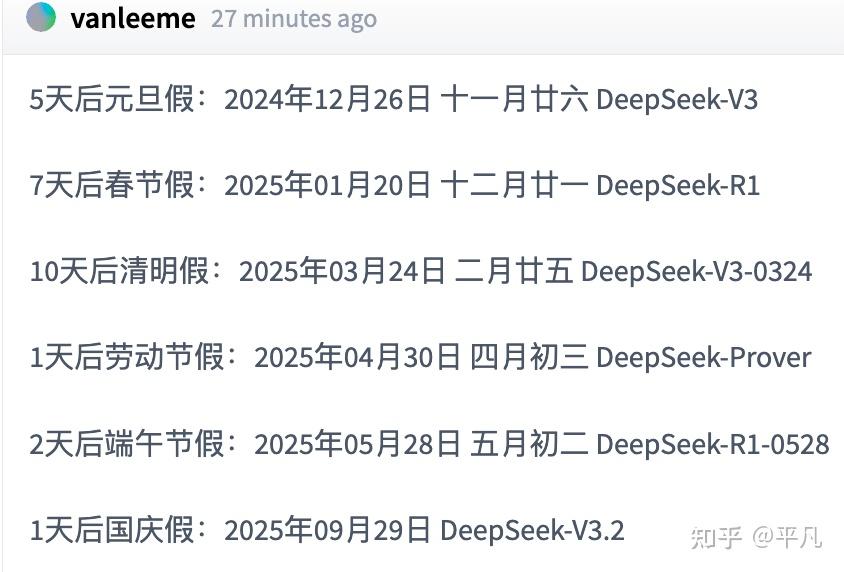
Huggingface的这个吐槽绝了,DeepSeek发新产品的时间节点貌似都在法定节假日前的1-10天不等。
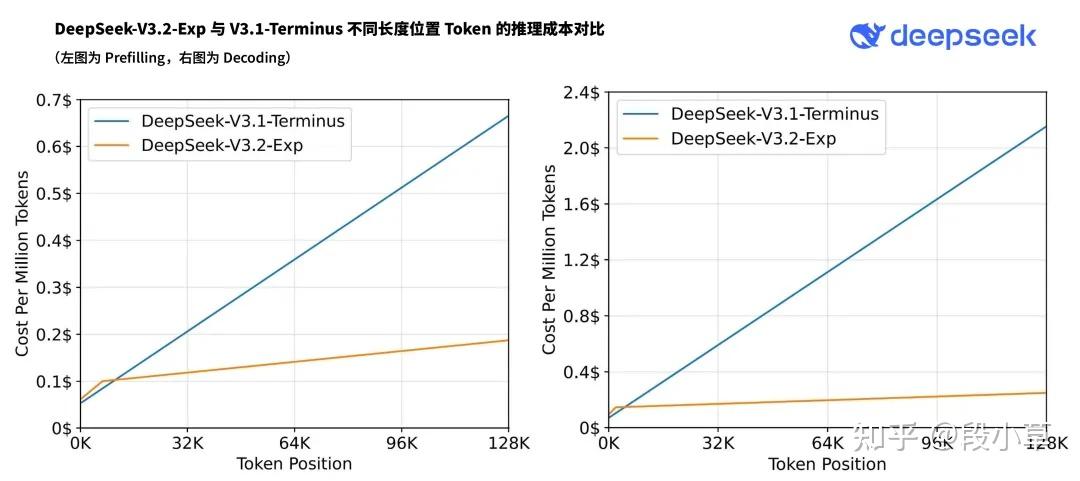
这次发布的V3.2是接着前两天发布的V3.1-Terminus,主打的还是cost efficient,你可以看到,同样的任务,V3.2的token 消耗远小于V3.1。
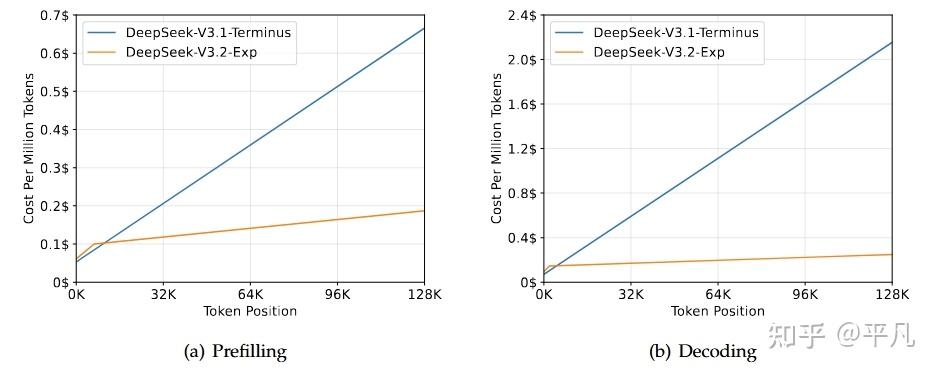
随着 token 位置增长,V3.2-Exp 的成本增长斜率显著低于 V3.1-Terminus——
- Prefill:到 128K token,V3.1 ≈ \(0.68 / M tokens,对比 V3.2 ≈ \)0.18 / M(约 3–4× 降本)。
- Decoding:到 128K token,V3.1 ≈ \(2.2 / M,对比 V3.2 ≈ \)0.32 / M(约 6–7× 降本)。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/234655.html