
- 讯享网
本文为学习笔记,文中的图片引用于马士兵教育杨淑娟老师的视频课程
数据类型
1.浮点型的数字相加,可能出现bug(由二进制底层了逻辑问题导致),可以import demical块解决。
2.字符串型数据可以用单引号 、双引号、三引号表示,区别在于三引号可以用于多行表示。
3.float类型转换为int类型的时候,小数部分会被直接舍弃而不会四舍五入,称之为截取。
4.str类型转换位int类型时,字符串必须为数字且必须为整数,否则报错。
5.str类型转换位float类型时,字符串必须为数字且必须为小数,否则报错。
注释
1.可以通过第一行注释设置字符集,例如:#coding:utf-8
运算符
1.运算符有±*/,还有取余(模)%,幂,整除//
赋值运算符
执行顺序从右向左
1.链式赋值:a=b=c=3
2.系列解包赋值:a,b,c=1,2,3
- 格外提一下,交换变量值只需要a,b=b,a
比较运算符
位运算符
1.按位与&,将两个数都转换位二进制,然后按位比较,如果都为1,则对应结果的二进制位为1,否则为零。比如4&8=0
2.按位或|,将两个数都转换位二进制,然后按位比较,只要有1个为1,则对应结果的二进制位为1,否则为零。比如4|8=12
3.左移位<<,高位溢出,低位补零,每向左移动一位,相当于乘以2
4.右移位>>,高位补零,低位截断,每向右移动一位,相当于除以2
5.运算符优先级
程序的组织结构
1996年,科学家证明了这样一个事实,任何简单或者复杂的算法都可以由顺序结构、选择结构、和循环结构这三种基本结构组合而成。
条件表达式
- if语句的特殊写法:print(“结果1” if判断语句 “结果2”),如果if判断结果为true则输出结果1,否则输出结果2
pass占位符
- 当没有想好代码怎么写的时候,可以输入pass来占位使程序不报错。
循环
1.内置函数range(),range((范围开始,默认0),范围结束,(步长,默认1))
- for 变量 in,单纯为了循环输出可不指定变量,用下划线—代替变量。
- 与for循环同级别的else语句,在前面的for循环正确执行完毕后执行(也就是for循环执行过程中没有遇到break),否则不执行。
设计思路:当我们遇到复杂需求的时候,应该将复杂的需求拆分成几个简单的需求,例如在设计99乘法表的时候,第一步先实现阶梯输出,第二步再实现将输出内容替换成乘法运算。
列表
1.列表有两组索引,一组是正向0,1,2,3…,一组是负向…-4,-3,-2,-1,通过列表函数可以直接获取对应位置的数值,比如:print(list[0]),和print(list[-4])获得的是同样的数值。
2.可以通过索引函数获取列表的索引,比如print(list.index(‘列表中的内容’),(start),(stop))
3.list[]函数完全体为list[start:stop:step]
4.append函数,追加一个元素在列表的末尾
5.extend函数,扩展元素在列表末尾
6.append和extend函数区别,举例,将list2插入到list1中,list1.append会把list2作为一个元素添加,而list1.extend则会把list2中的元素拆分出来作为多个元素追加到list1的末尾。
7.insert函数,在任意位置添加元素,例如:list.insert(插入位置的索引号,要添加的元素)
- 重点理解切片操作,结合第三点看,举例:list1[]=list2[],可以通过给出list1中可定义的选项,影响list2中的内容插在list1的何处。
- 切片删除,使用:list[1:3]=[],把空列表赋给索引1~索引3中间的位置,即相当于索引1和索引2被删除。
10.clear()函数,使用:list.clear(),解释:将列表中元素全部清除。
11.del语句,使用:del list,解释:将列表对象删除。
12.更新操作,使用:list[索引号]=值,
- 也可以list[起始索引:终止索引]=[数值1,数值2…数值n]即切片赋值更新
13.列表排序(在原列表上改,不产生新列表),sort()方法,使用:list.sort(),解释:升序排序,降序用list.sort(reverse=true)
14.列表排序(产生新列表),sorted()方法,用法同上。
15.列表生成式,list=[i参数 for i in range()],上式右边中括号里面的作用是可以生成一个序列i,通过参数可以调整序列比如i2就可以得到2,4,6,8…这种序列,然后将最终得到的序列,赋值给list生成列表。
字典
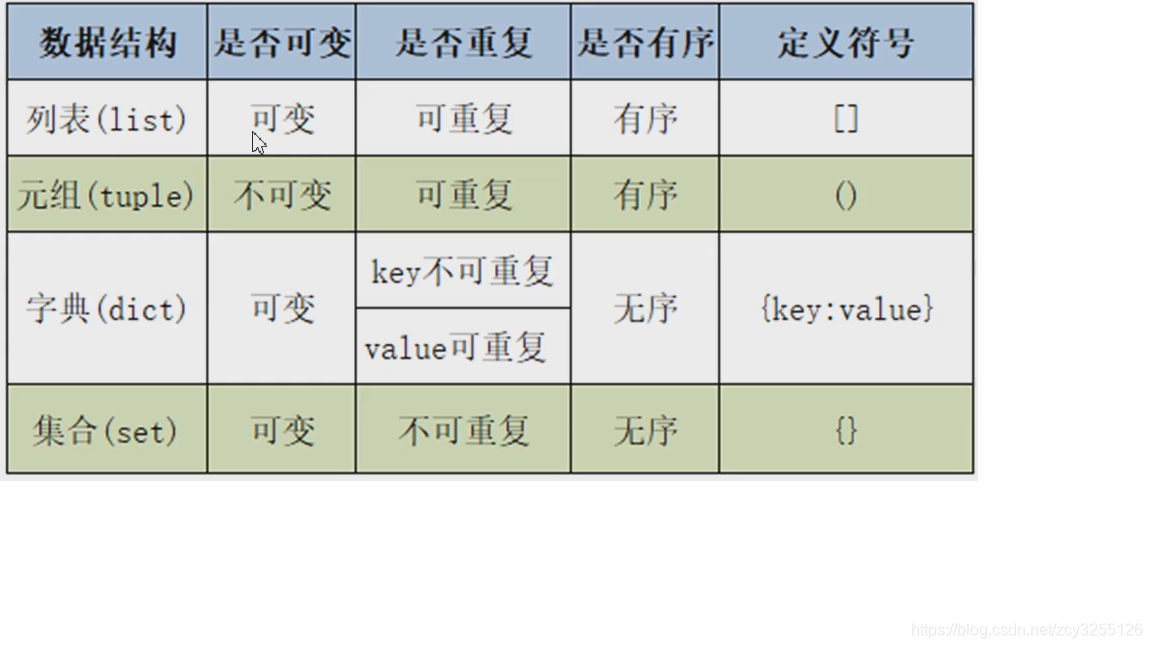
- 字典和列表相同处:是一种可变序列(可以对其中的元素进行增删改);
- 字典和列表不同处:列表是单值的有序序列,字典是以键值对方式存储数据的无序序列。
- 字典中的键为不可变序列。
1.创建字典:使用{},举例:dic1={键1:值1,键2:值2,…},如果{}内无值则创建空字典。
2.创建字典:使用内置函数:dict(键1=值1,键2=值2,…)
3.获取字典中的值:使用[],举例:a=[键1],解释:将键1的值赋给a
4.获取字典中的值:使用get()函数,完全体:get(键1,如果键不存在时的默认值),举例:print(dic.get(键1)),解释:打印字典dic中键1的值。
5.删除列表中的元素(键值对)有以下方法:
del语句,使用:del dic[键1],解释:删除dic字典中键为键1的键值对。
clear()函数,使用dic.clear(),解释:清空字典元素。
6.增和改,都是通过赋值的方式,dic[键n]=值n
7.获取字典视图:直接举例dic.keys(),dic.values(),dic.items(),分别为获取dic的键,值,键值对。(当dic.items()赋值给变量,则变成元组。)
8.注意:遍历字典元素时,得出的是键不是值,如for i in dic,print(i):如果需要获取值则需要这样写print(dic[i]),或者print(dic.get(i)) - 字典的特点:
- 元素为键值对,键不可重复,值可以重复。
- 字典中的元素是无序的
- 键必须是不可变对象
- 字典占用内存多,但是查询速度快,空间换时间。
9.字典生成式,举例:dic={键表达式a:值表达式b for a,b in zip(a,b)}
10.zip()函数,用于将可迭代对象作为参数,将对象中对应的元素打包成一个元组,然后返回由这些元组组成的列表。(如果被打包的两个列表个数不同,则生成的元组数和元素数较短的列表的元素数相同)
元组
元组是不可变序列,可变不可变就看在对对象的值进行改变后,对象的id有没有变化,可变序列有列表,字典;不可变序列有字符串,元组。
1.元组的创建方式1:tup=(元素1,元素2…元素n),方式2:利用tuple()函数,tup=tuple(元素1,元素2…元素n)。当元组中只有一个元素的时候,要在元素后加逗号以和字符串区分;元组的小括号可以省略。
- 元组不可变是指元素的内存地址即id不可变,但是如果内存地址指向的是一个可变序列,比如列表,我们是可以改变列表的值的。
集合
1.集合是一种可变序列,相当于只有键没有值的字典(键值如果有重复,会自动去重;元素是无序的)。
2.集合的创建方法1:直接使用{},举例:s={键1,键2…键n}
3.集合的创建方法2:使用set()函数,举例s=set(range(1,6)),解释:通过set函数将1~5这个序列转换成集合并赋值给s。
4.定义空集合的时候,只能用set()函数,因为如果用{}定义,得到的是一个空字典。
5.往集合中增加元素的方法:add(),update(),前者用来添加单一元素,后者可以用多种方式(例如元组,列表,集合)添加多个元素。
6.删除集合中元素的方法1:set.remove(指定元素),解释:删除一个指定元素。
7.删除集合中元素的方法2:set.pop(),解释:随机删除一个元素。(注意,此函数不可有参数,否则报错。)
8.clear()函数,使用:set.clear(),解释:清楚集合中所有元素。
9.一个集合是否为另一个集合的子集,s1.isssubset(s2),s1是否为s2的子集
10.一个集合是否为另一个集合的超集(父集),s1.isupperset(s2),s1是否为s2的超集
11.两个集合之间是否没有交集,s1.isdisjoint(s2),如果没有返回true,如果有返回false。
12.求交集,s1.intersection(s2)也可以s1 & s2.
13.求并集,s1.union(s2),也可以s1 | s2
14.求差集,s1.difference(s2),也可以s1-s2
15.求对称差集(相当于两集合的并集减去交集),s1.symmetric_difference(s2),也可以s1^s2
16.集合生成式,和列表生成式相似,把[]换成{}即可,例如set={i * 3 for i in range(6)},解释:利用range函数产生一个1~5的序列,再将这个序列乘以3,最终得到一个3,6,9,12,15的序列,并将这个序列变成集合赋值给set。
讯享网
字符串在内存的驻留机制
什么情况下字符串会发生内存驻留(同样值的字符串,指向同一个内存地址)?
1.字符串长度为0或者1时
2.符合标识符的字符串(仅由字母、数字、下划线组成)
3.字符串只在编译时驻留,运行时则会开辟新的内存地址用于运算。
4.-5~256之间的整数数字
5.sys中的intern方法可以强制两个字符串指向同一个对象。用的时候需要先import sys,例如a=sys.intern(b)。
- PyCharm对字符串进行了优化处理,会自动将值相同的字符串作内存驻留。
- 实际工作中在做字符串拼接的时候,尽量使用join方法,因为不管要拼接的字符串有多少,在运行时,join方法都会将它们拼接成一个字符串,只new一次对象,效率比用+高。
字符串的常用操作
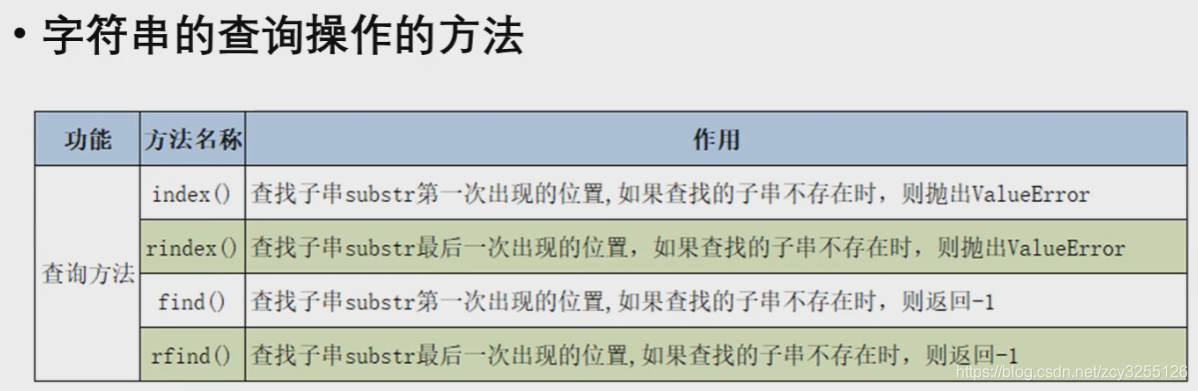
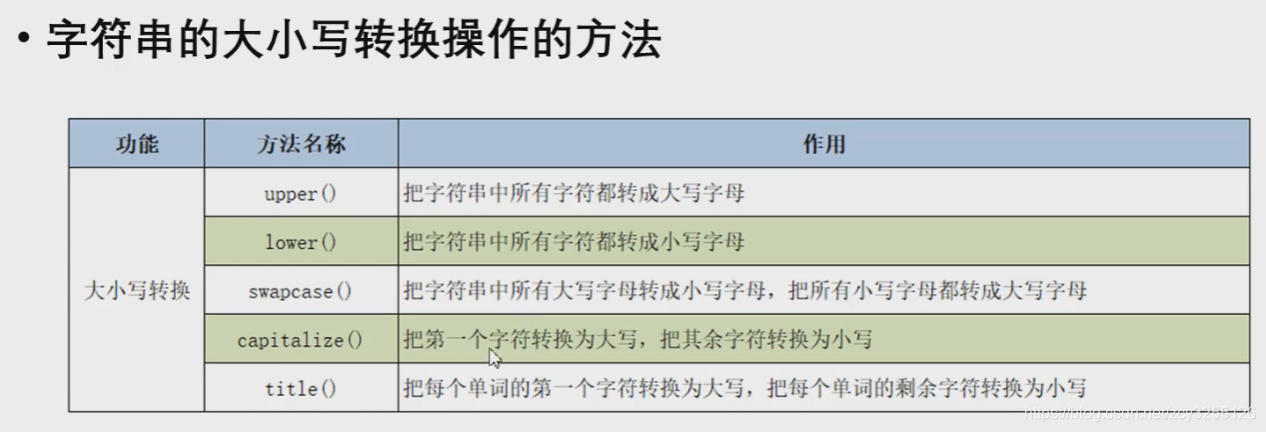
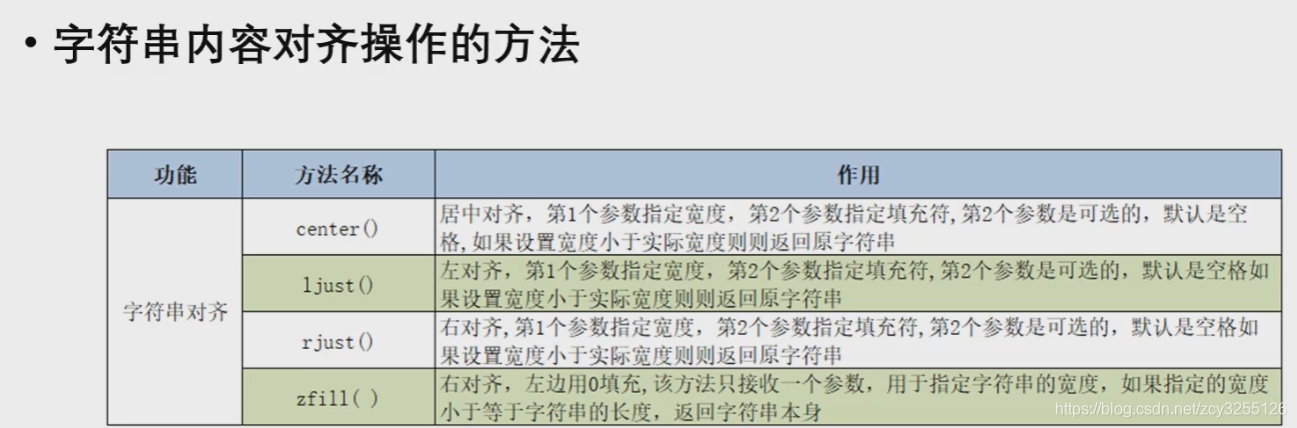
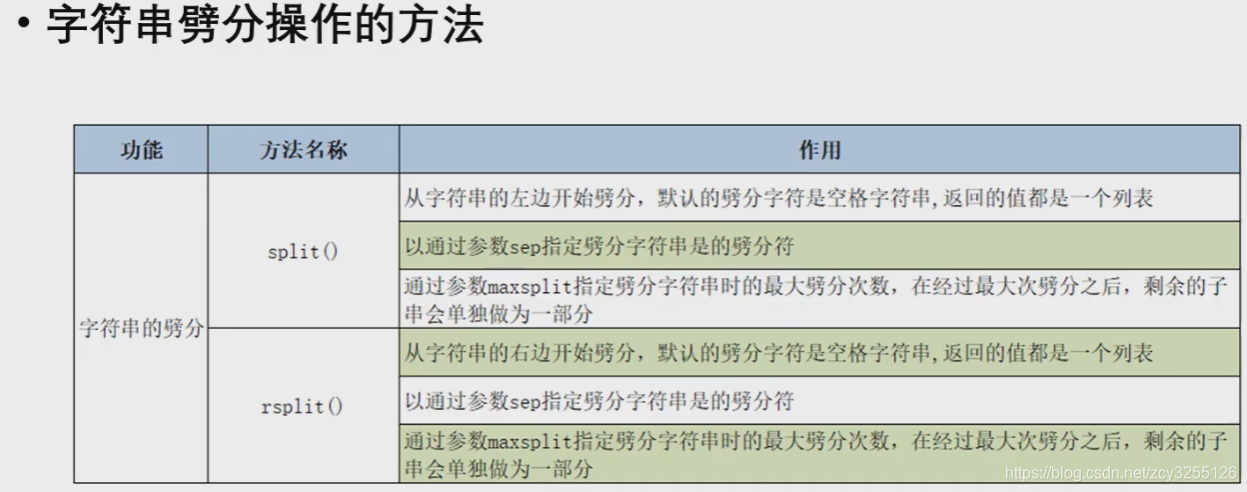
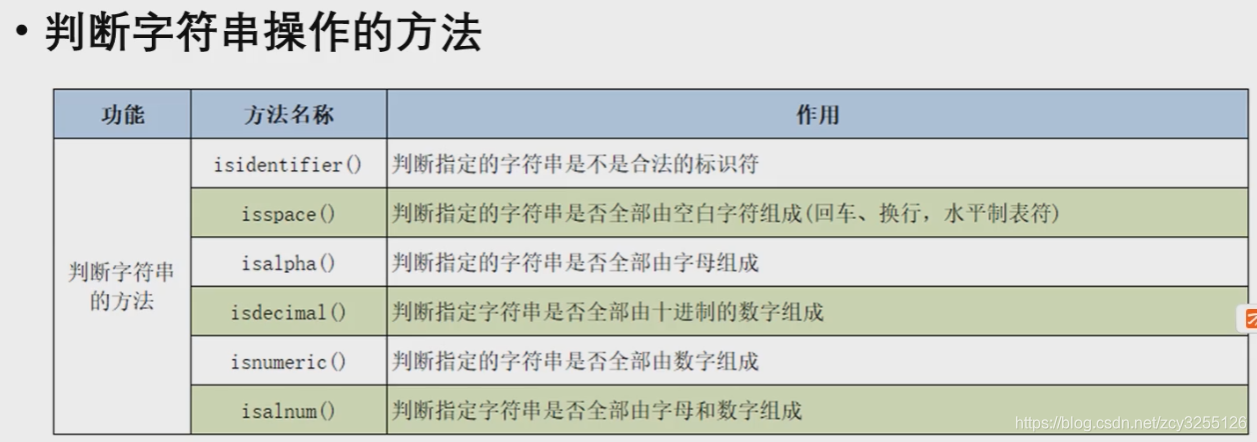
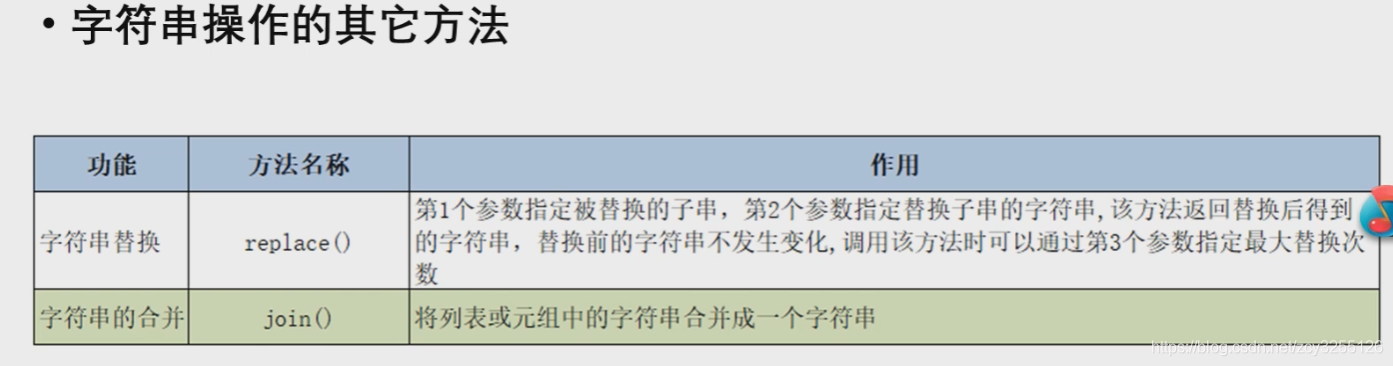
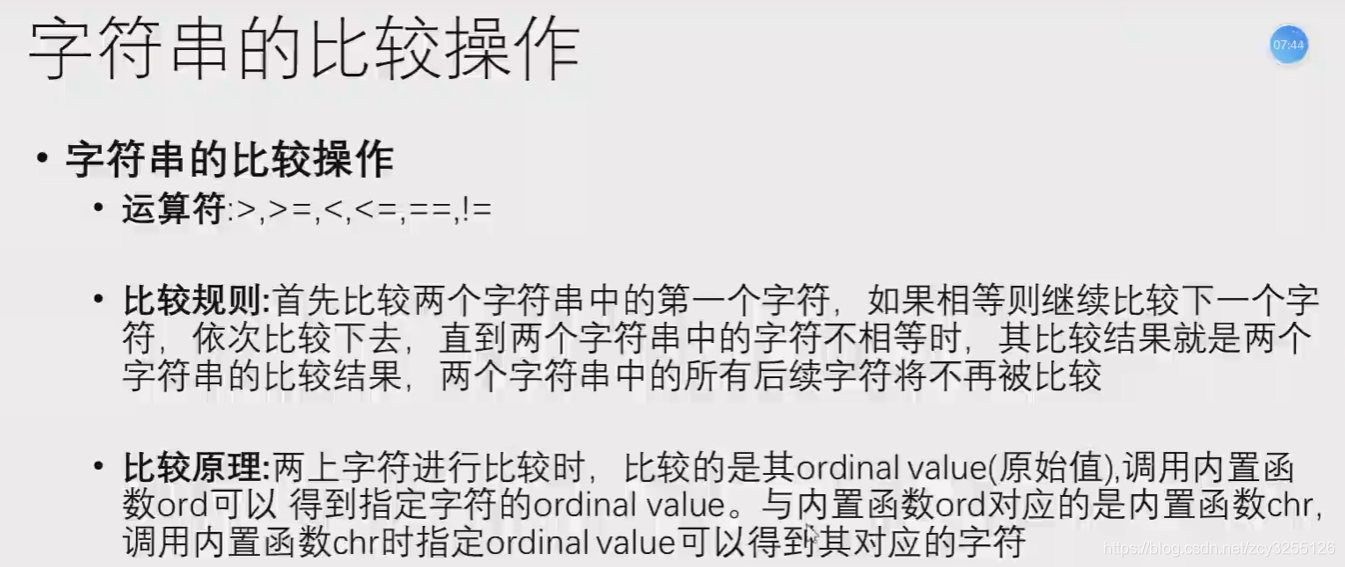
1.字符串切片写法,str[start:end:step]
格式化字符串
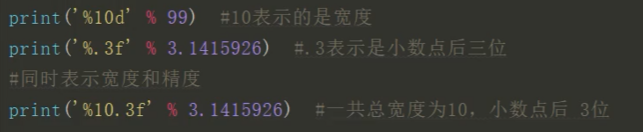
1.%占位符方式,例如:‘我叫%s,今年%d岁 % (name,age)解释:上述字符串中%为占位符,%后面的字母为数据类型,%s为str类型,%i和%d为int类型,%f为float类型,然后用单独的%结束,后面跟一个元组,元组第一个值填充到第一个占位符,第二个值填充到第二个占位符。
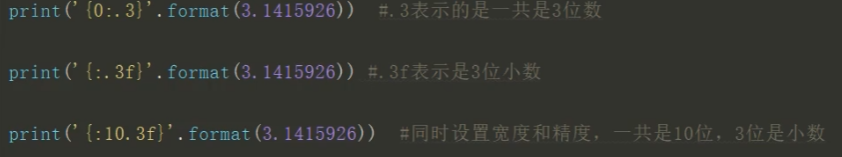
2.{}方式,例如:‘我叫{0},今年{1}岁’.format(name,age) 解释:大括号内为索引号,配合format方法使用,format方法中第一个值填充到{0},第二个{1},以此类推。
3.f-string方法,举例 f’我叫{name},今年{age}岁’
4.如下图,可以调整宽度精度。
字符串的编码解码
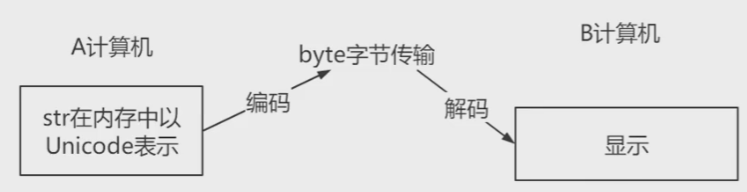
- 为什么需要字符串编码解码,如下图:

函数的定义与调用
1.定义函数:
def calc(a,b):
c=a+b
return c
其中:calc为函数名,a,b为参数,c=a+b为方法体,c为返回值。
- 函数在执行过后,实参的值是否改变取决于实参是否为可变参数,究其原因,就是因为函数在运行过程,是引用了实参的物理地址(id),函数运行时实际是对这块id进行操作。
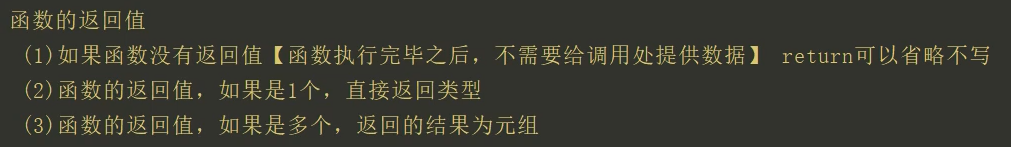
函数的返回值
函数参数的定义
- 个数可变的位置参数最多只能定义一个。
- 个数可变的关键字参数最多只能定义一个。
- 以上两者各有一个时,只有位置参数在前时不报错,例如:def(*args,args):
- 若一组形参中既有位置形参又有关键字形参,可以用来分隔区分,例如:def(a,b,,c,d):解释:在*之后的参数c和d在调用时必须使用关键字实参赋值,否则报错。
函数变量的作用域
1.函数变量分为局部变量和全局变量,函数体内为局部变量,函数体外为全局变量。
2.函数体内可以直接使用全局变量。
3.可以在函数体内用global关键字定义全局变量,例如:
def():
global a
return
则,此时a为全局变量。
递归函数
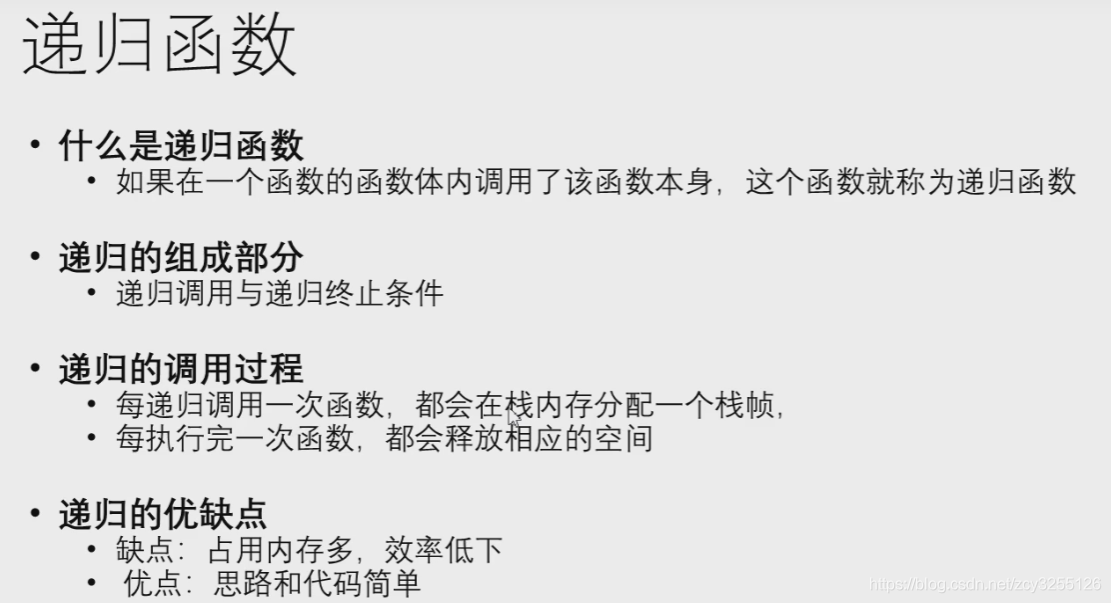
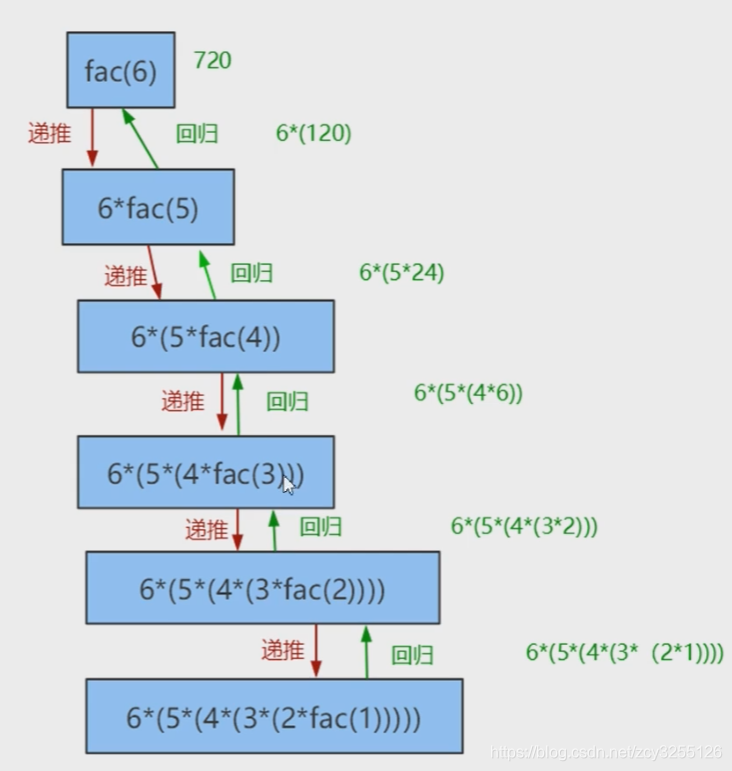
- 在运行时,是先递推到最后一层,然后再由最后一层回归到第一层。
- 一般用if和else来分别分配调用条件和终止条件
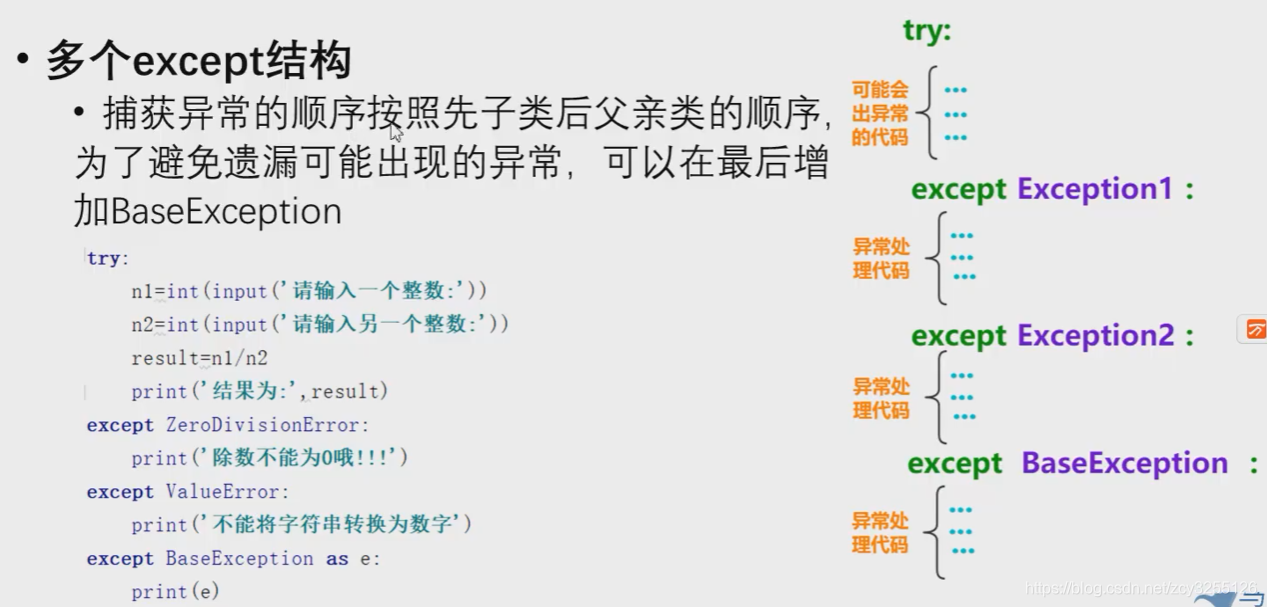
事先捕获异常设置
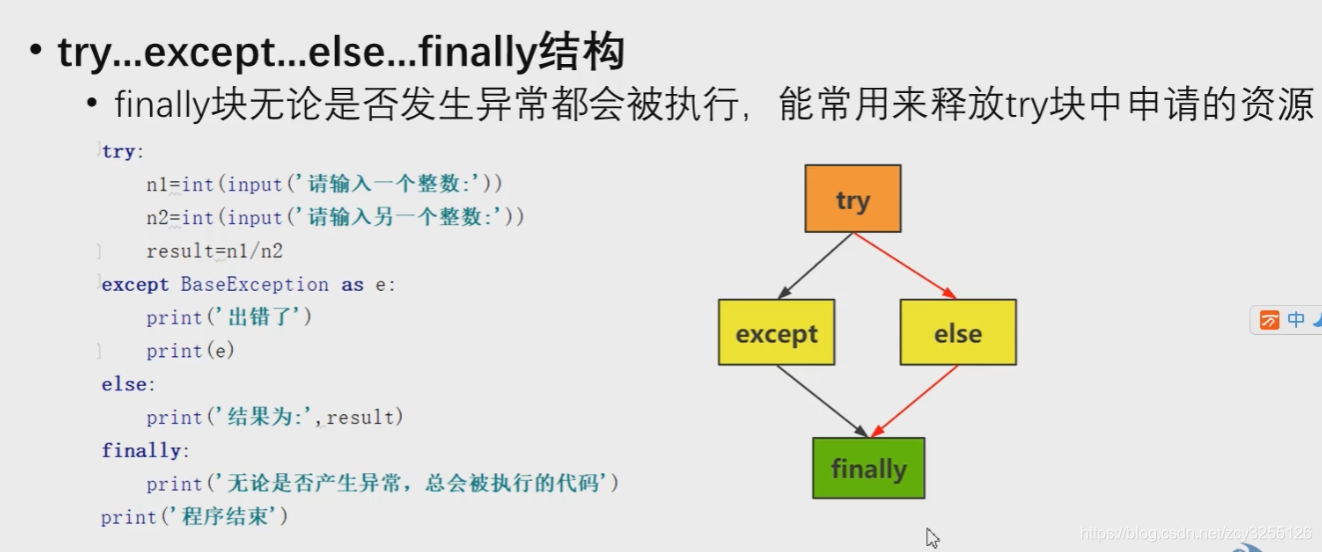
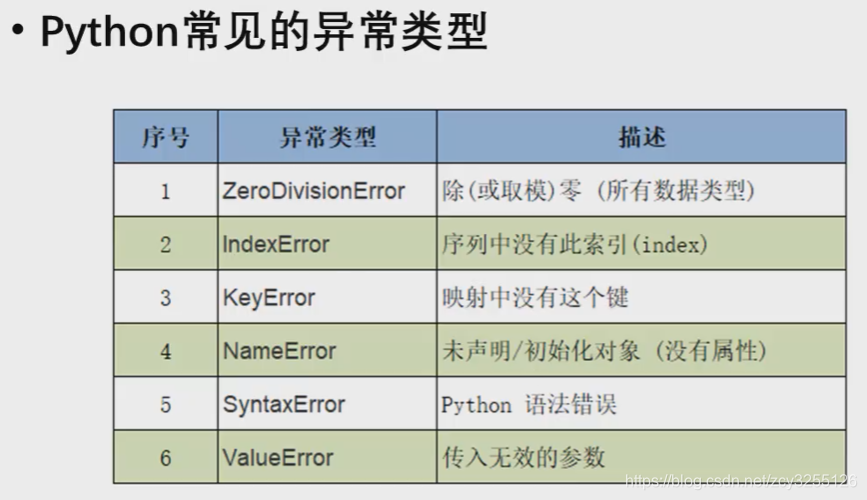
常见异常类型
traceback模块打印异常信息
1.traceback模块中print_exc()方法可以打印异常信息,用前先导入,个人觉得没啥用。就是系统默认报错用那个模块。
定义Python中的类
1.格式:class 类名:
初始化方法
属性
实例方法
静态方法
类方法
…
例如:class Student:
name=‘张三’
def eat(self):
print(‘学生在吃饭’)
- 写在类里的变量叫类属性
- 定义在类里面的函数叫方法,定义在类外面的函数叫函数
- 方法中一定要有形参self,self是一种规范,也可以替换成其它形参
2.实例方法:定义在类之内的,不用任何修饰的函数。
3.静态方法:定义在类之内的,用@staticmethod在前面修饰的,注意静态方法的()中不允许由类似self的东西,规定。
4.类方法:定义在类之内,用@classmethod在前面修饰的,注意类方法的()中要有默认形参cls
5.初始化方法,定义在类之内
例如:def init(self,name,age):
self.name=name
self.age=age
解释:此方法中self为必须有的,个人理解表示的是实例本身,name和age为自定义局部变量,self.name=name即为将局部属性的值赋给实例属性。
动态绑定
1.动态绑定即给已经实例化的对象增加属性或者方法,这些增加的属性和方法只属于那个对象而不属于其它对象或者此对象所属的类。
2.可以动态绑定属性,例如:给学生类的stu1对象增加性别属性可以这样写:stu1.gender=‘女’
3.可以动态绑定方法,先定义函数,再把函数名赋给对象,例如:
def drink():
print(‘xxxxxx is drinking’)
stu1.drink=drink
然后,stu1就可以调用drink方法了。
私有属性
1.私有属性可以用两个下划线来定义,例如stu1.__age=age,但是,除了单独访问__age以外,通过类方法和_类名__age, 都可以访问到该__age属性,所以此属性非强制私有,靠程序员自觉。
继承
- 可以继承多个父类,class student(person1,person2…)
重写
1.方法的重写,即在子类中重新定义已存在在父类中的方法(子类方法名和父类方法名相同)
- 子类重写的方法中依然可以调用父类的方法,只要加super.就可以,例如,父类方法write(),这个方法要被子类重写,在子类中就可以这么写:
def write():
super.write()
xxxxxxx(子类需要在write方法中增加的部分)
object类
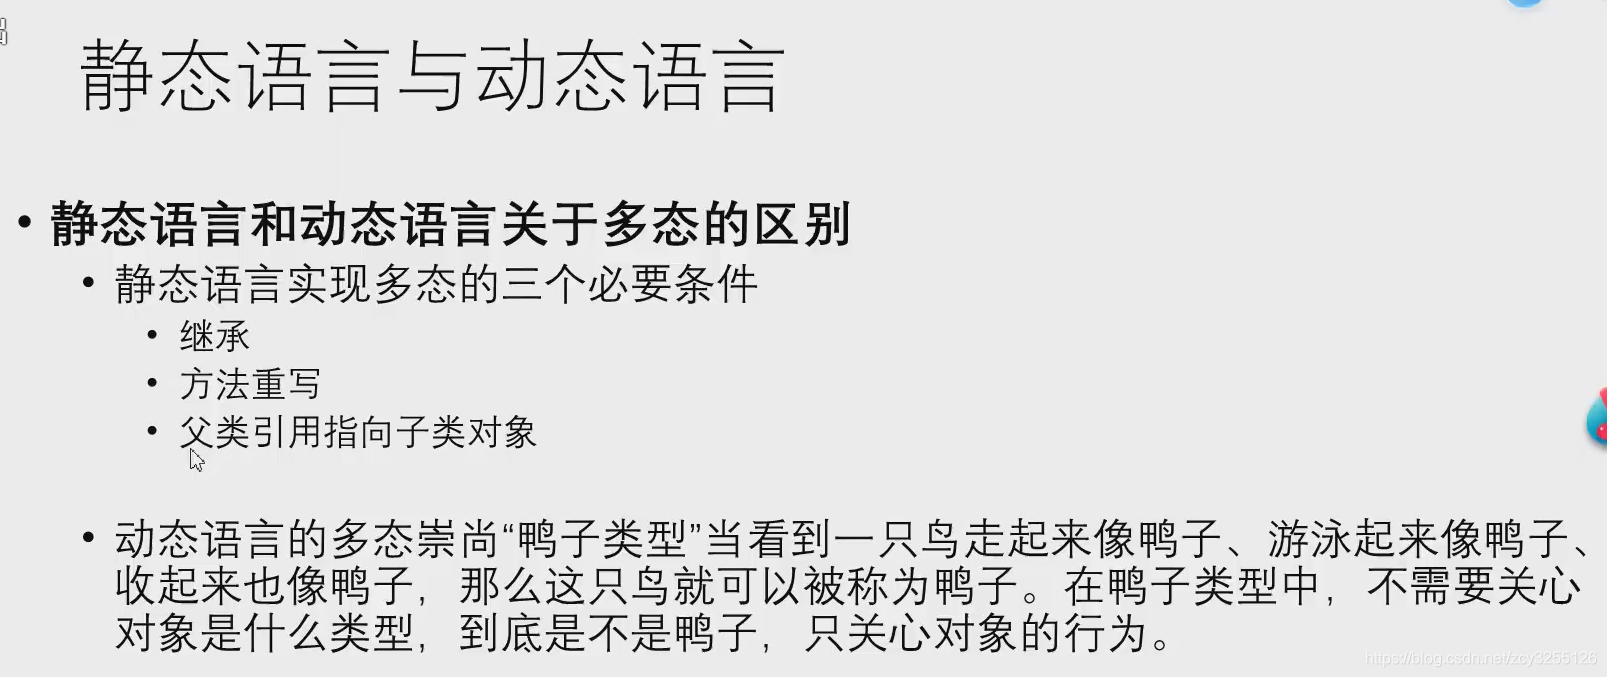
多态
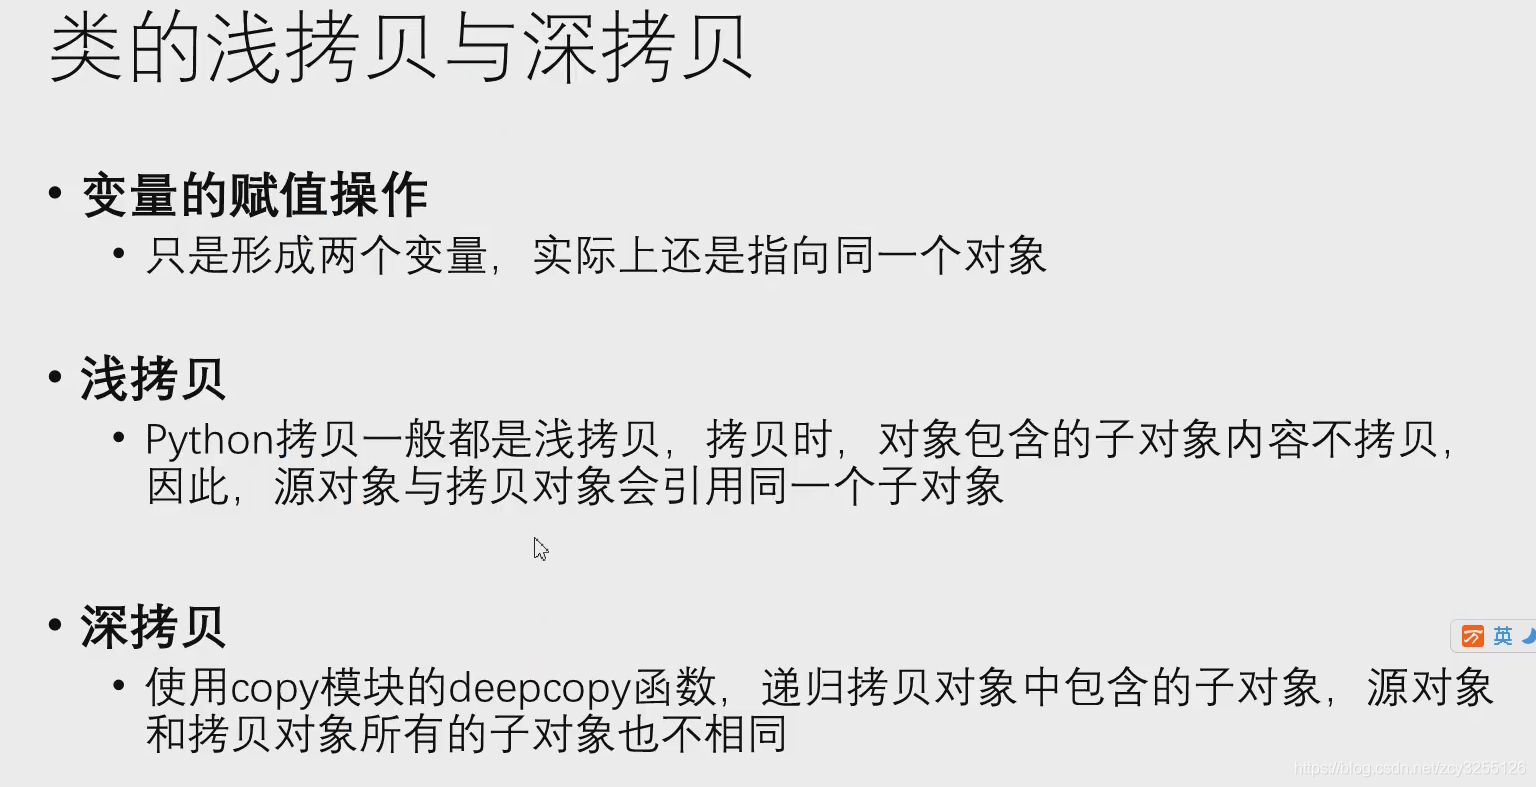
类的赋值,浅拷贝,深拷贝
先import模块copy,然后使用copy.copy()函数浅拷贝,或者copy.deepcopy()函数深拷贝。
什么是模块
简单理解就是一个.py文件,模块里有函数,类,语句。
类里又有变量,方法等。
n多个模块构成python程序。
导入模块
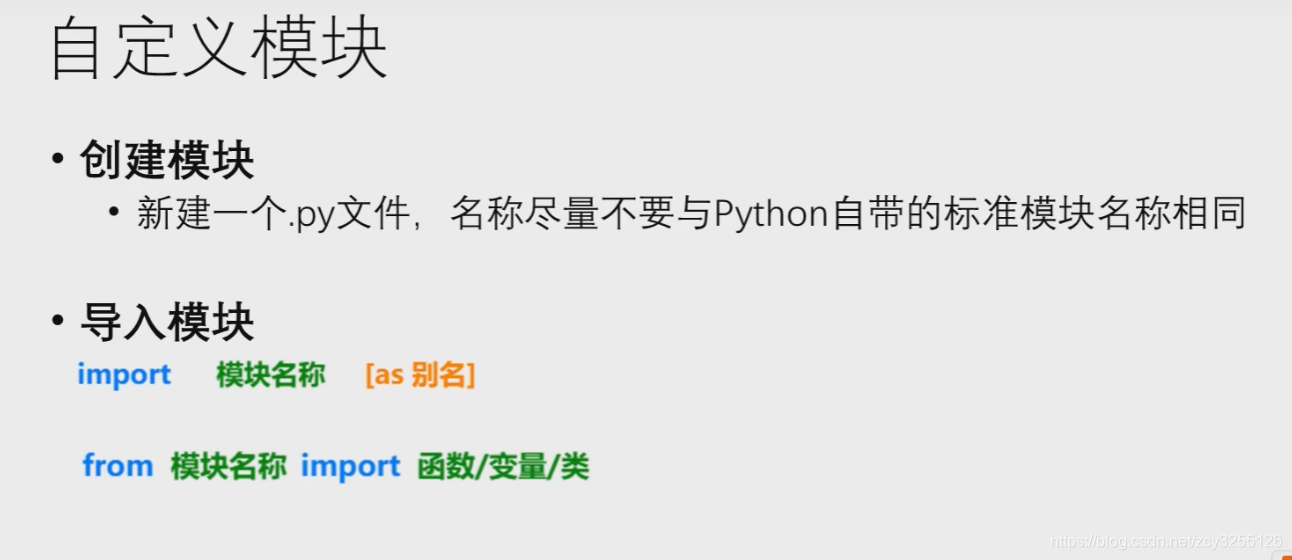
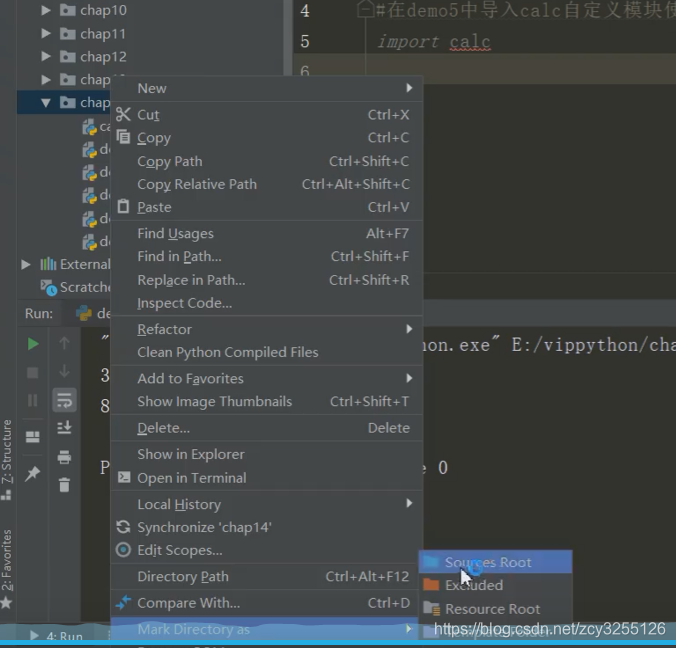
- 导入自定义模块的时候会报错,解决办法如下图
以主程序方式运行
1.python中,有个顶级模块叫做__main__,如果一个模块没有**入到其它模块中,那么默认在__main__中运行。
2.每个模块都有个默认属性__name__,此属性在程序运行时可以被检测到。
3.当模块内的某个方法不愿意在此模块导入其它模块时被使用的话,可以如下写,例如:
if name=‘main’
xxxxxx(不希望其它模块调用时被使用的方法)
解释上面代码:当模块名为__main__时,执行以下方法。
包
- import导入和from import导入的不同之处:
- import后面只能接单独的包名或者模块名字
- from import则可以精确的导入包下的模块甚至是模块下的变量
- 举例:import xxx(包名或者模块名)
from xxx(包名) import xxx(模块名)
from xxx.xxx(包名.模块名) import xxx(变量名)
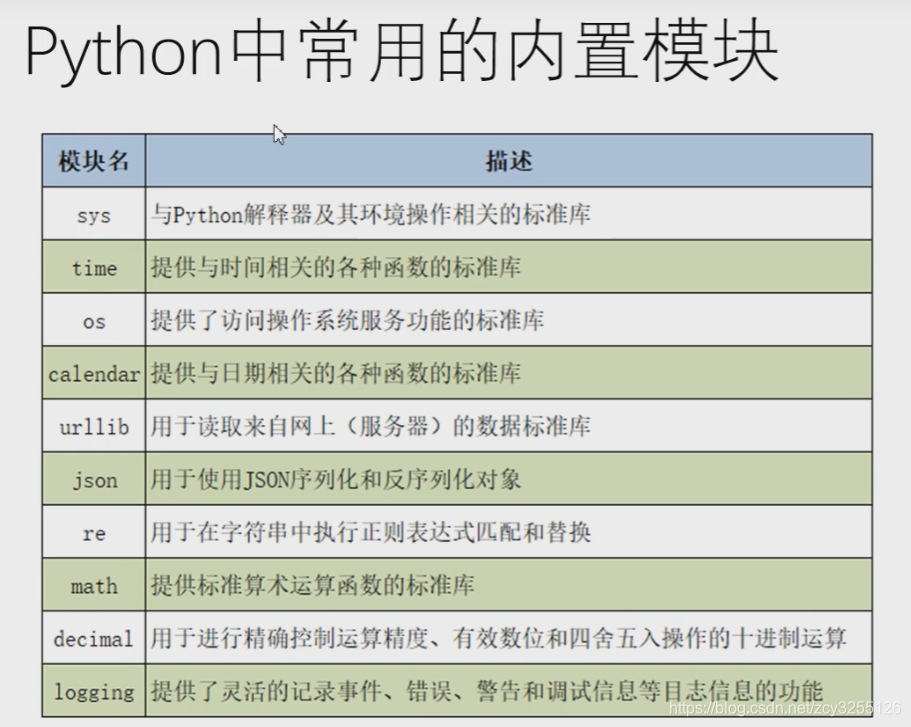
常用内置模块
第三方模块的安装和使用
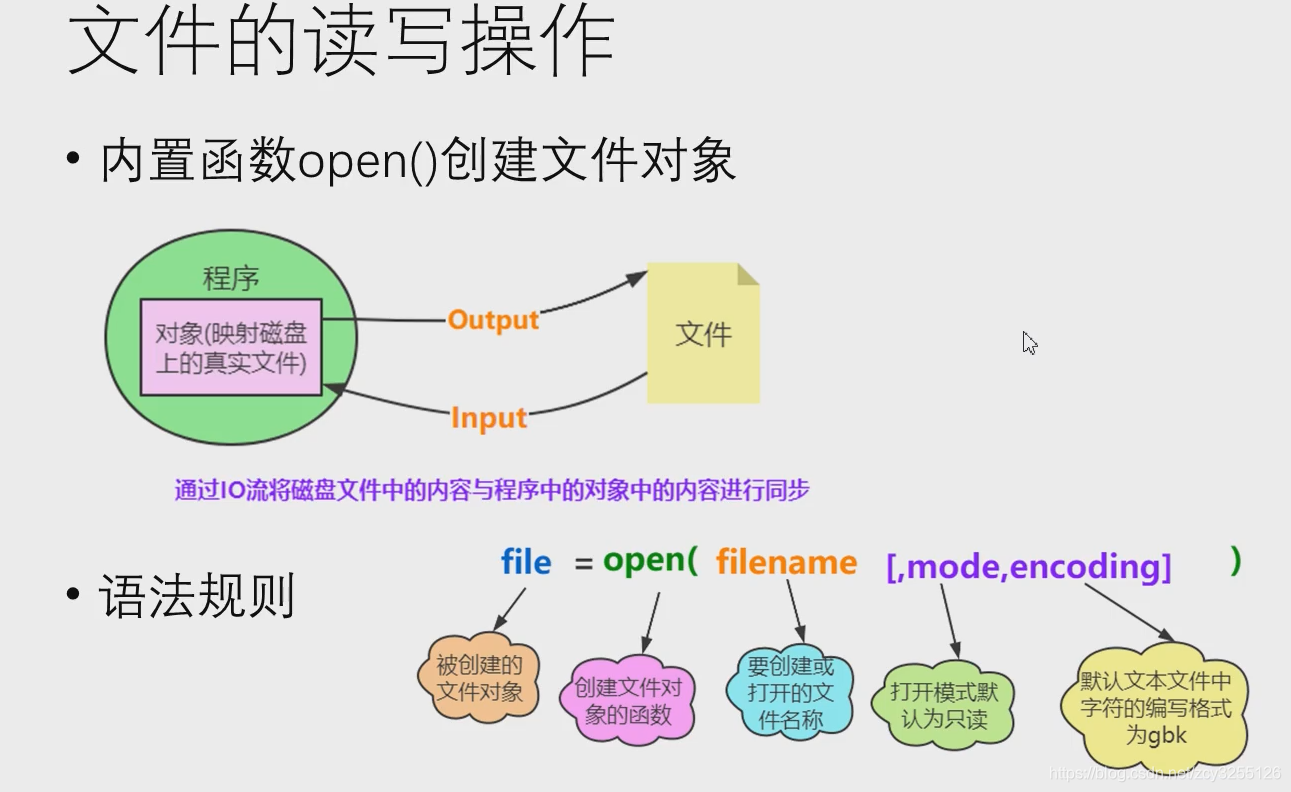
文件读写原理
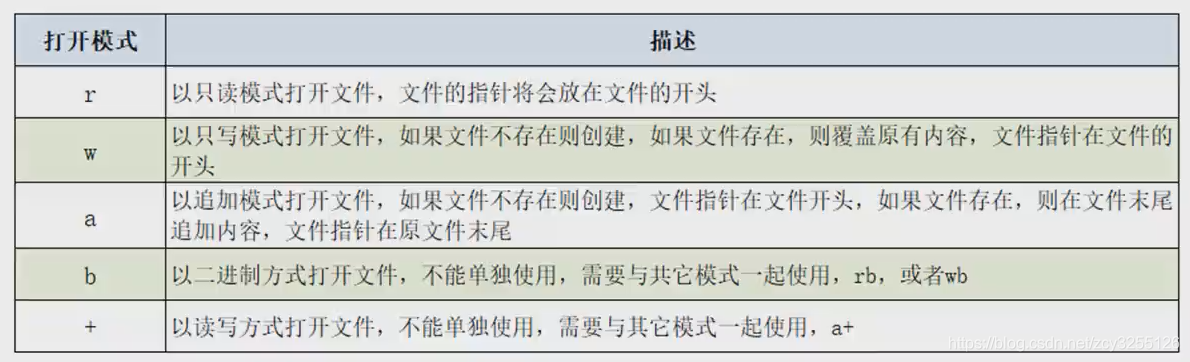
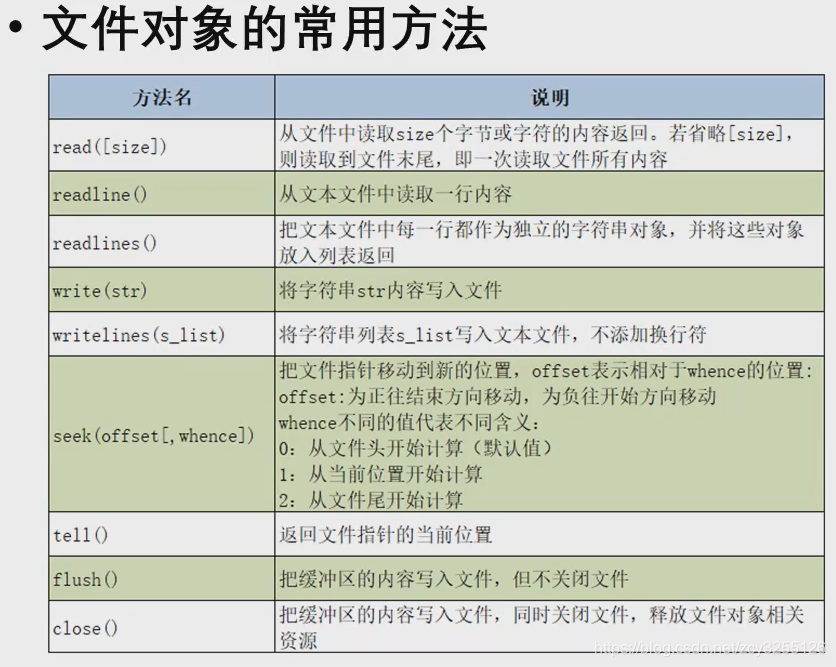
with语句(用来自动关闭程序,释放内存)
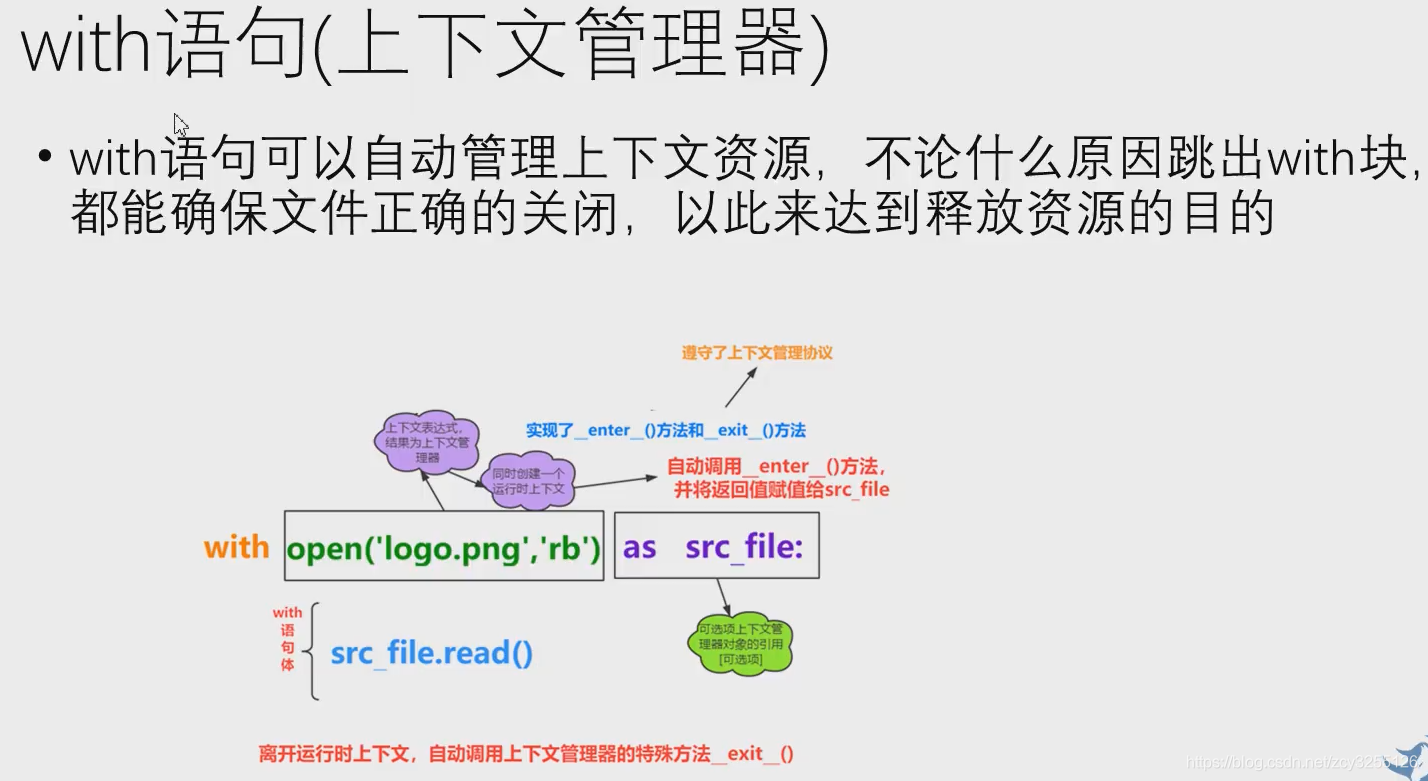
- 利用with语句实现文件复制只需要以下三行代码:
讯享网with open('logo.png','rb') as src_file: with open('copy2logo.png','wb') as target_file: target_file.write(src_file.read())
os模块关于目录的函数
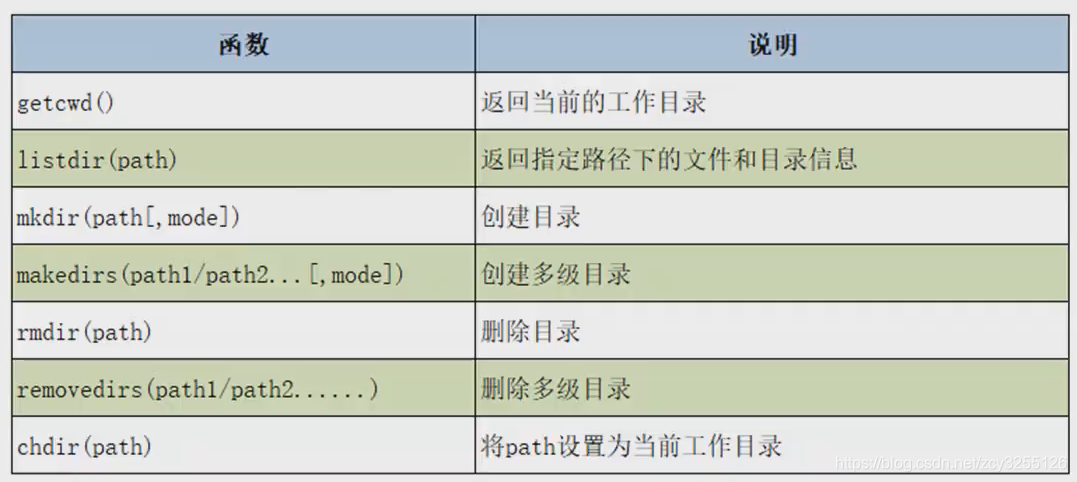
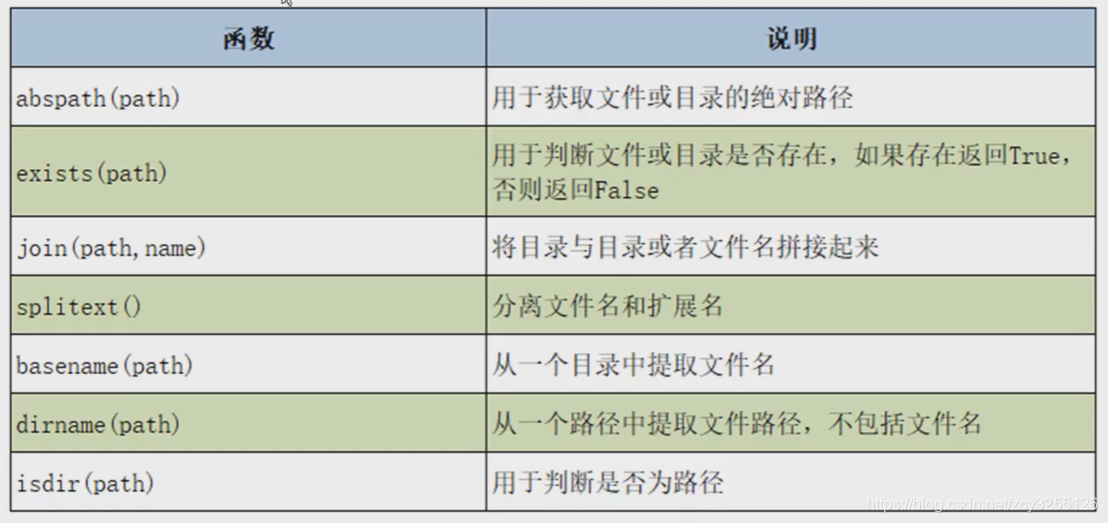
os.path模块中常用方法(也是文件和目录)
os.walk
1.可以遍历文件夹下所有文件夹和文件,例如:
import os path=os.getcwd() #获取当前工作目录,赋给path lst_files=os.walk(path) #获取所有文件夹和文件,返回值为列表,赋给lst_files
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/132421.html