
摘要
用户点击广告是广告业务中的常见场景,这类数据可以帮助平台优化用户体验、提升转化率。对于系统来说,广告点击预测是一个非常重要的问题,因为它关系到广告是否能够在合适的时间展示给合适的人。
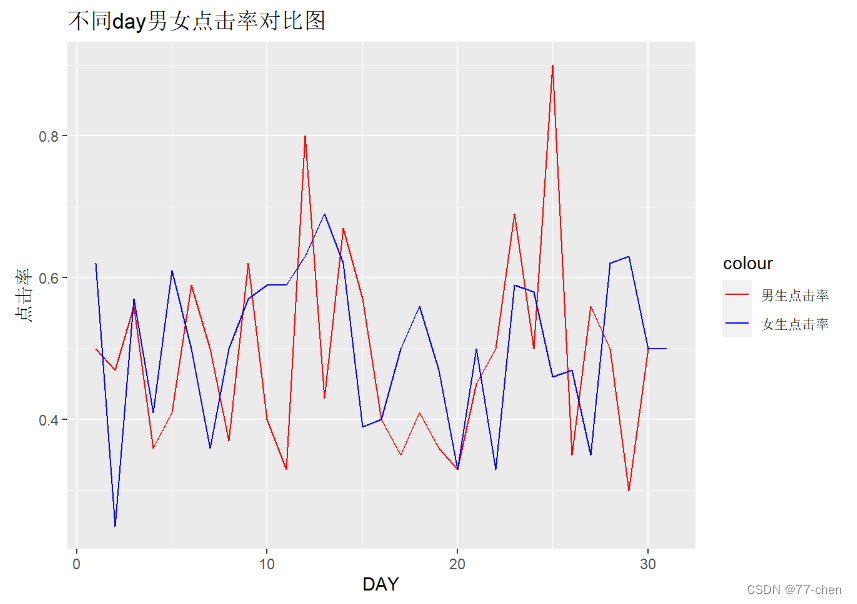
通过背景介绍,原始数据解读及处理,以及数据可视化分析的方法,得出以下结论。首先,根据数据分析结果,发现广告点击率与时间的关系不显著,波动较小。其次,男女生点击率相差不大,但是周末男生的点击率明显高于女生。
此外,广告点击率随用户浏览页面的时间和每天在互联网上的平均时间的增加而逐渐降低。另外,广告点击率与用户所在地理区域的收入均值呈负相关。
在数据可视化结果中,发现广告点击率与用户每天在互联网上的平均时间、用户浏览页面的时间以及用户所在地理区域的收入均值更为相关。尽管根据可视化结果来看,年龄越高,点击率越高,但是考虑到年龄增长可能导致用户在网页上花费的时间减少,认为用户每天在互联网上的平均时间仍然是影响广告点击率的主要因素。
因此,本篇报告的研究结果为理解广告点击率与各种因素之间的关系提供了重要参考。并且使用随机森林进行训练,预测,最终得到一个广告点击率预测模型。使用shiny创建页面,调用训练好的模型,根据输入的参数,输出用户点击广告的概率。
关键字:随机森林 shiny 数据可视化 广告点击率 R语言
-
背景介绍
在广告业务中,系统需要从历史数据中提取出一系列有效信息,再通过随机森林的方法将这些有效信息训练成模型。在训练好模型后,系统会根据模型输出结果对广告展示时间进行预测,进而指导广告的投放。
然而,对于海量数据的分析,仅依靠原始数据显然是不够的。广告业务中的广告点击预测是一个典型的大数据问题,它是一个多变量、高维、非连续的问题。由于历史数据中往往会存在大量无效和异常值,使得训练模型时出现一些错误。
此外,由于广告点击预测是一个非确定性问题,系统需要在每次预测时都能取得一个不错的效果。因此,模型需要能够在一次预测中取得较好的结果。
-
原始数据解读及处理
2.1 原始数据解读
我们先从原始数据中抽取部分有效信息,并进行解读:
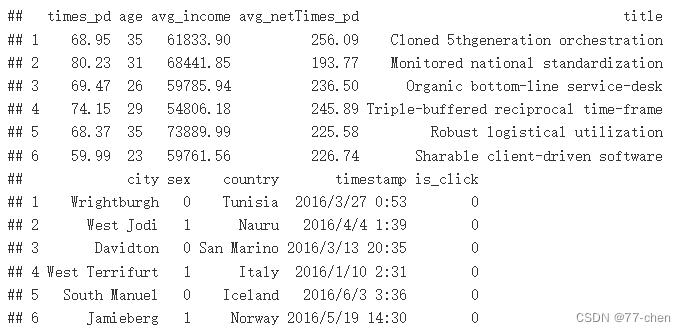
讯享网times_pd:表示用户每天花在网站上的时间,单位为分钟
age:表示用户年龄
avg_incom:表示地区收入均值,单位为美元
avg_netTimes_pd:表示用户每日互联网使用量,单位为mb
title:表示广告主题
city:城市
sex:性别,0为女性,1为男性
country:国家
timestamp:时间
is_click:是否点击广告,0为没有点击,1为点击
2.1 数据处理
数据处理:因为有一些特征本身并不能够很好地代表用户的行为习惯,所以我们还需要使用str()函数来查看一个对象的结构和信息,包括列名、数据类型、缺失值情况等等。
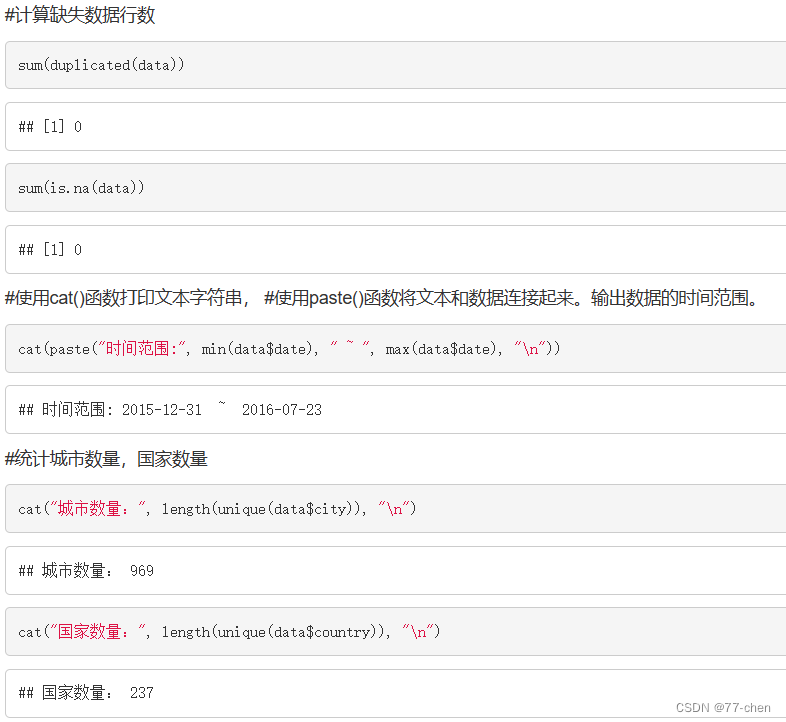
小结:可以看出数据无缺失值,无重复值,时间范围:2015-12-31 ~ 2016-07-24 , 共有1000条记录,数据分布969个城市,237个国家。
-
数据可视化分析
3.1 时间维度
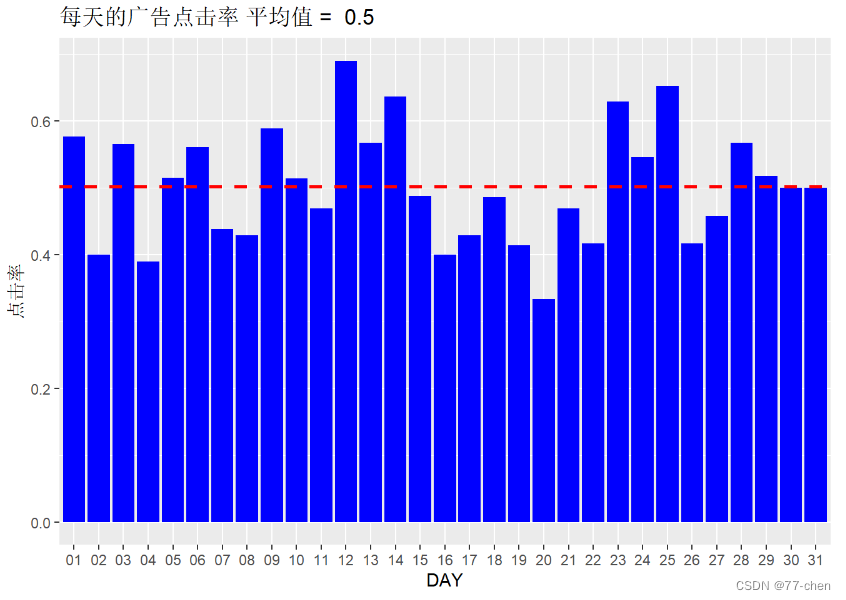
计算每天的广告点击率,绘制柱状图。
计算每周的广告点击率,绘制柱状图。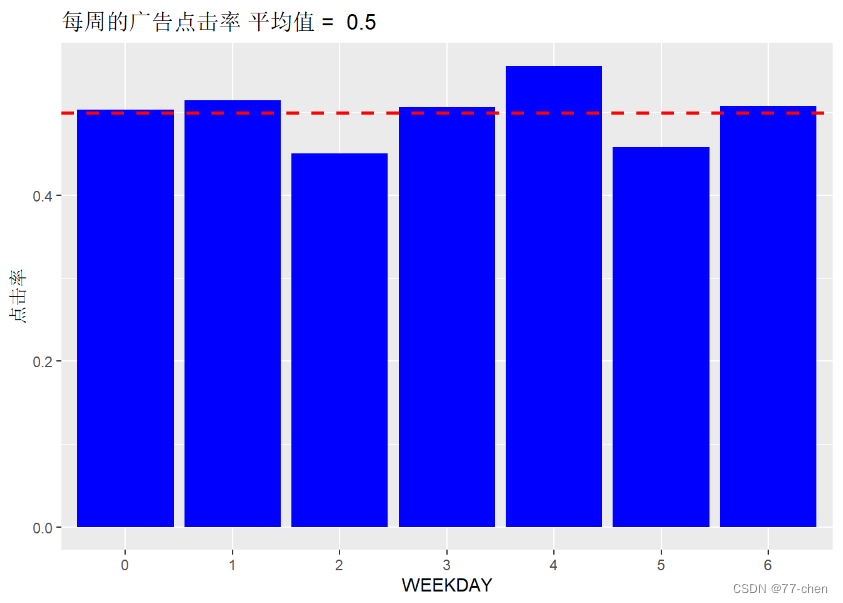
综上可以看出,用户广告的点击率与时间没有太大的关系,波动较小。
3.2 时间X性别维度
对数据进行计算 ,按天计算男生点击率,按天计算女生点击率,绘制折线图
对数据进行计算 ,按周计算男生点击率,按周计算女生点击率,绘制折线图
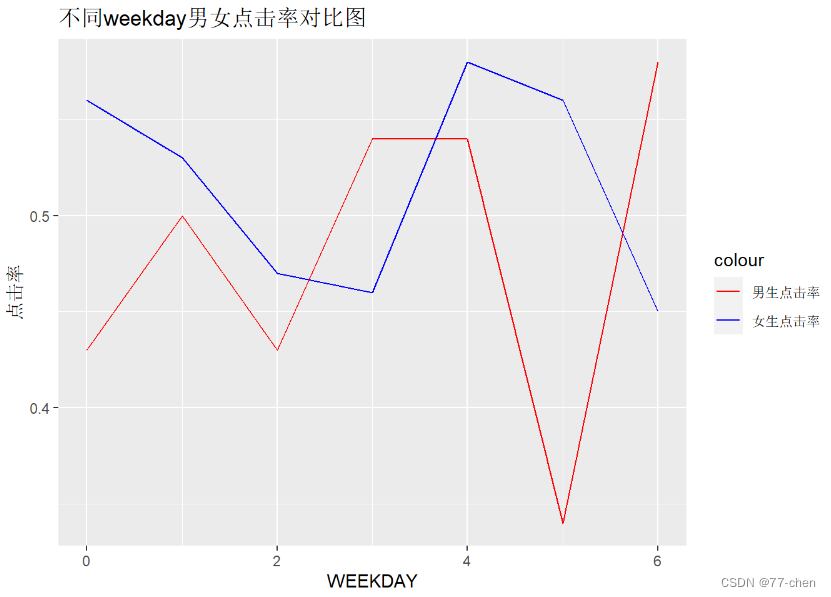 综上可以看出,虽然总体上,男女生点击率相差不大,且女生点击率高于男生,但是横向来看,男生点击率的最高值是明显大于女生的,比如周末。
3.3 年龄维度
按age计算点击率,绘制柱状图和折线图
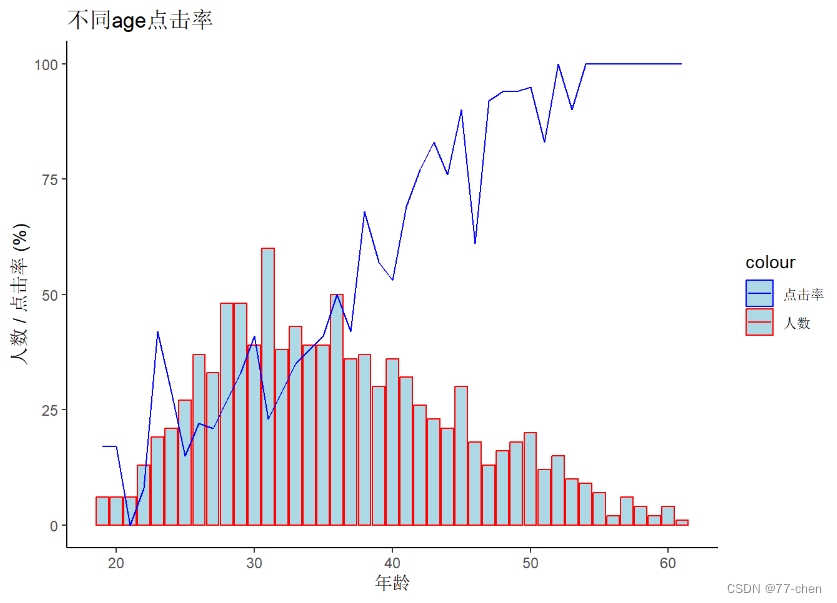
结合图表可以看出,随着年龄上升,广告点击率越来越高
3.4用户上网时间维度
计算每个时间段内的广告点击率,绘制折线柱状图。
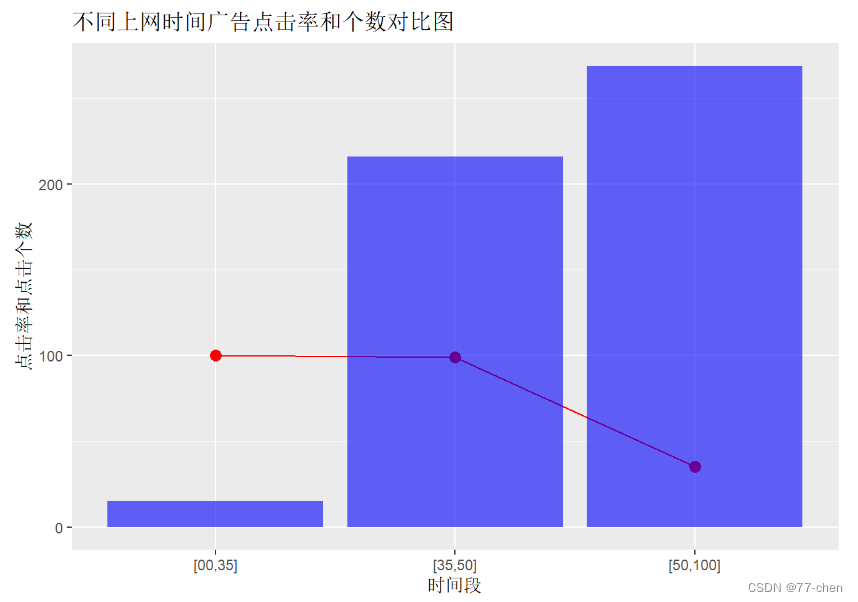
用户浏览页面的时间范围大致为0~100分钟,划分为三个组 #有图表可以看出随着用户浏览页面的时间 和 用户每天在互联网上的平均时间 的增加,广告的点击率越来越低 #用户浏览页面的时间为50分钟内的用户点击率为100%,每天在互联网上的平均时间 在100分钟内的广告点击率为94%以上 #直到用户浏览页面的时间为50-100分钟时,点击率才大幅下降。
3.5收入维度
计算在不同收入区间内的广告点击率和个数,绘制折线柱状图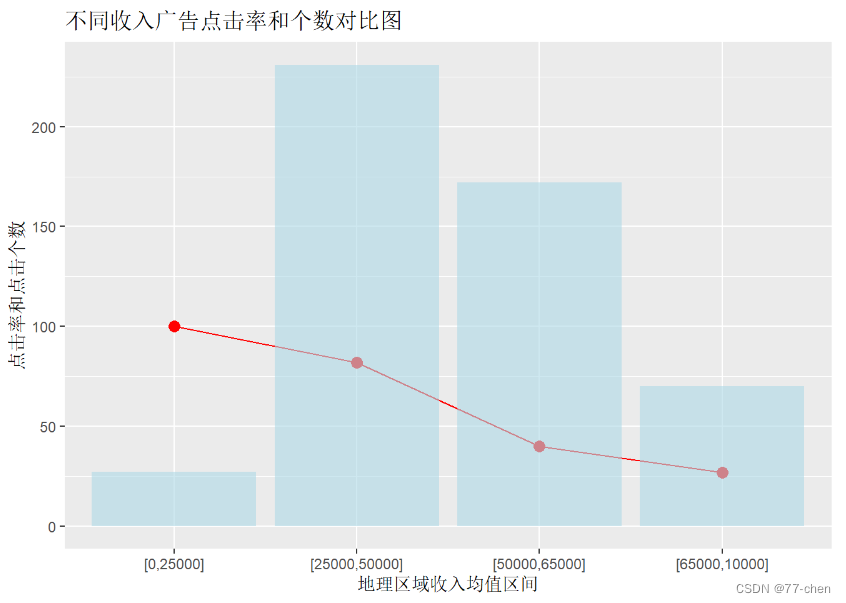 可以看出,用户的收入均值越高,用户广告点击率越低。
-
随机森林模型训练
4.1模型介绍
随机森林是一种由决策树构成的集成算法,在很多情况下都能有不错的表现。
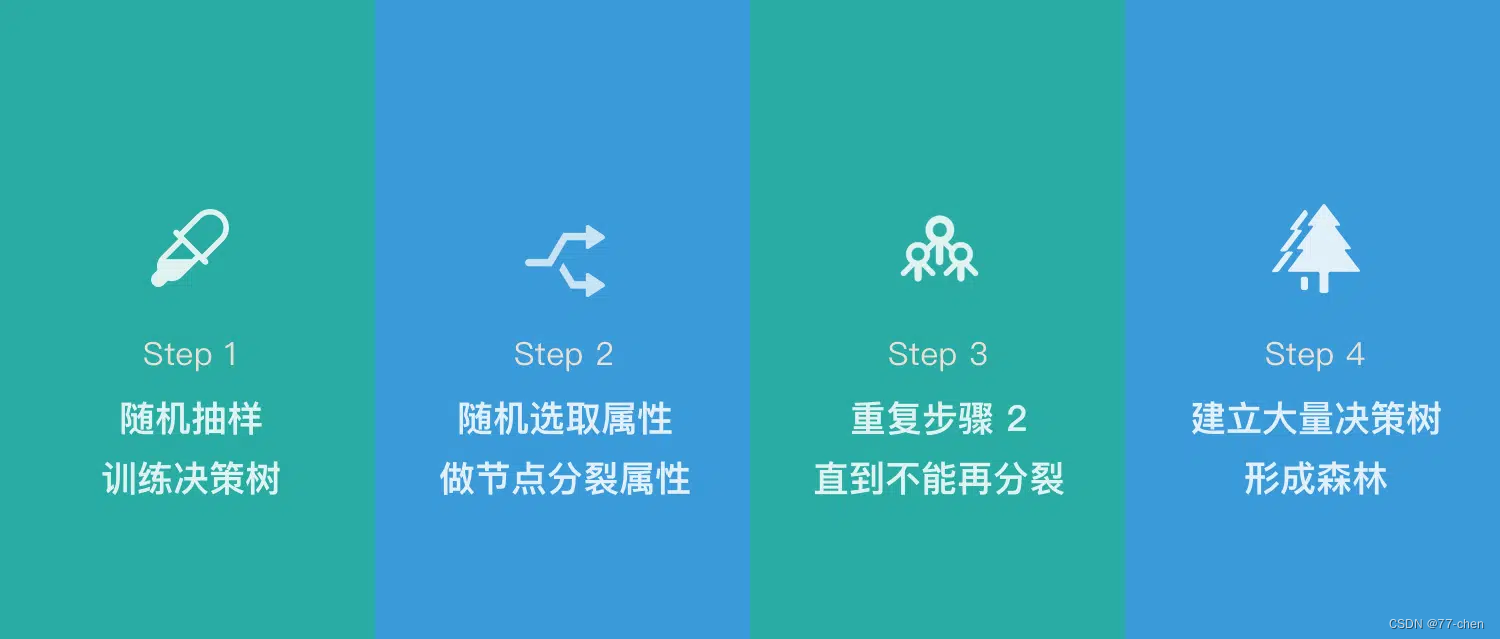
算法步骤:
- 一个样本容量为N的样本,有放回的抽取N次,每次抽取1个,最终形成了N个样本。这选择好了的N个样本用来训练一个决策树,作为决策树根节点处的样本。
- 当每个样本有M个属性时,在决策树的每个节点需要分裂时,随机从这M个属性中选取出m个属性,满足条件m << M。然后从这m个属性中采用某种策略(比如说信息增益)来选择1个属性作为该节点的分裂属性。
- 决策树形成过程中每个节点都要按照步骤2来分裂(很容易理解,如果下一次该节点选出来的那一个属性是刚刚其父节点分裂时用过的属性,则该节点已经达到了叶子节点,无须继续分裂了)。一直到不能够再分裂为止。注意整个决策树形成过程中没有进行剪枝。
- 按照步骤1~3建立大量的决策树,这样就构成了随机森林了。
4.2 训练模型
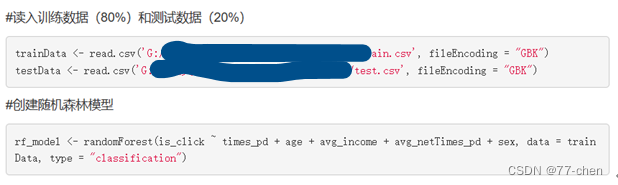
将可视化部分的数据放到模型中去预测广告点击率。
4.3 训练结果分析
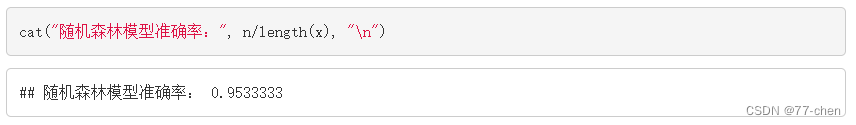
模型准确率为0.95,认为该模型准确率较高,使用该模型进行预测。
4.4 保存模型
-
SHINY可视化
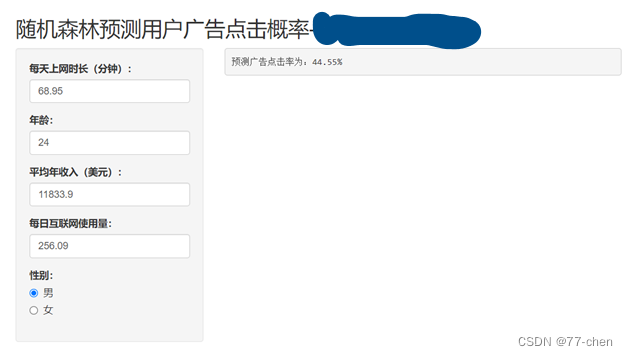
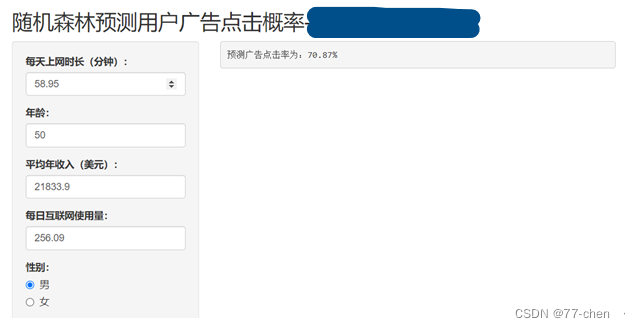
读取之前训练好的随机森林模型,根据输入用户的每周上网时长(分钟),年龄,平均年收入(美元),每日互联网使用量和性别五个变量来预测用户点击广告概率。
预测结果1
预测结果2
-
项目总结
6.1 总结
用户广告的点击率与时间没有太大的关系,波动较小
男女生点击率相差不大,但是周末男生点击率明显大于女生 ,随着用户浏览页面的时间和用户每天在互联网上的平均时间 的增加,广告的点击率越来越低
随着用户所在地理区域的收入均值越高,用户广告点击率越低
可视化结果可以看出,广告的点击率与【用户每天在互联网上的平均时间,用户浏览页面的时间,用户所在地理区域的收入均值】更相关
而【年龄】虽然根据第2部分的可视化结果来看,年龄越高,点击率越高,但是推测年龄越高,花在网页上的时间可能也会越少,
因此【用户每天在互联网上的平均时间】还是主要影响是否点击广告的主要因素。
6.2 随机森林的优缺点
优点:它可以处理高维度(特征很多)的数据,并且不用降维,无需做特征选择,它可以判断特征的重要程度,可以判断出不同特征之间的相互影响,不容易过拟合,训练速度比较快,容易做成并行方法,实现起来比较简单,对于不平衡的数据集来说,它可以平衡误差。如果有很大一部分的特征遗失,仍可以维持准确度。
缺点:随机森林已经被证明在某些噪音较大的分类或回归问题上会过拟合。对于有不同取值的属性的数据,取值划分较多的属性会对随机森林产生更大的影响,所以随机森林在这种数据上产出的属性权值是不可信的
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/132171.html