
实验环境
Java1.8
Hadoop
Hive
Spark
Sqoop
Echarts
Intellij idea
VMware Workstation
Ubuntu 16.04
实验内容
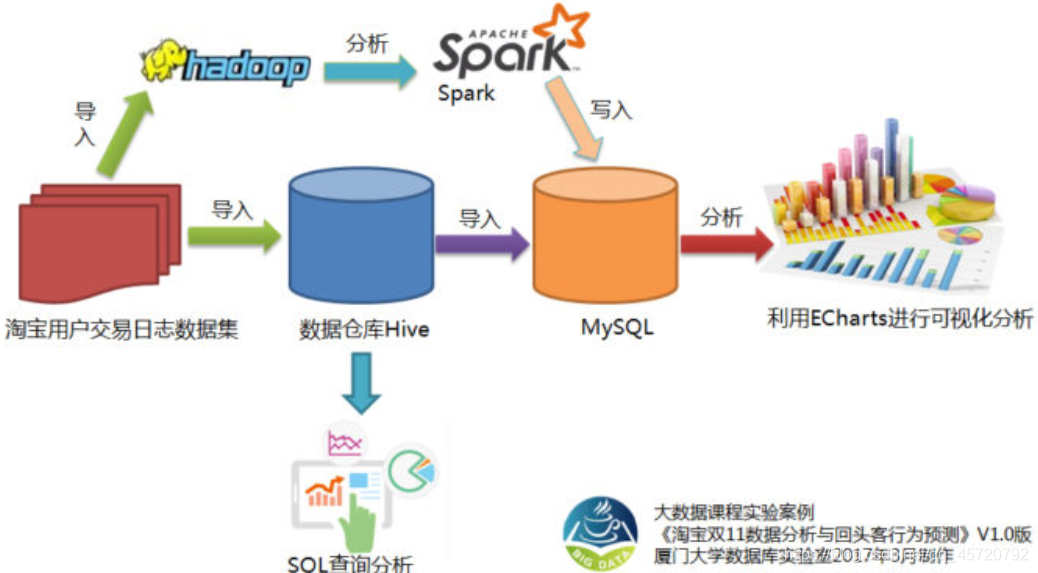
- 对文本文件形式的原始数据集进行预处理
- 把文本文件的数据集导入到数据仓库Hive中
- 对数据仓库Hive中的数据进行查询分析
- 使用Sqoop将数据从Hive导入MySQL
- 利用Eclipse搭建动态Web应用
- 利用ECharts进行前端可视化分析
- 利用Spark MLlib进行回头客行为预测
实验步骤
一、本地数据集上传到数据仓库Hive
1、数据集介绍
本案例采用的数据集压缩包为data_format.zip,该数据集压缩包是淘宝2015年双11前6个月(包含双11)的交易数据(5000万条记录),里面包含3个文件,分别是用户行为日志文件user_log.csv 、回头客训练集train.csv 、回头客测试集test.csv. 下面列出这3个文件的数据格式定义。
用户行为日志user_log.csv,日志中的字段定义如下:
(1)user_id | 买家id
(2)item_id | 商品id
(3)cat_id | 商品类别id
(4)merchant_id | 卖家id
(5)brand_id | 品牌id
(6)month | 交易时间:月
(7)day | 交易时间:日
(8)action | 行为,取值范围{0,1,2,3},0表示点击,1表示加入购物车,2表示购买,3表示关注商品
(9)age_range | 买家年龄分段:1表示年龄<18, 2表示年龄在[18,24],3表示年龄在[25,29],4表示年龄在[30,34],5表示年龄在[35,39],6表示年龄在[40,49],7和8表示年龄>=50,0和NULL则表示未知
(10)gender | 性别:0表示女性,1表示男性,2和NULL表示未知
(11)province| 收获地址省份
回头客训练集train.csv和回头客测试集test.csv拥有相同的字段,字段定义如下:
(1)user_id | 买家id
(2)age_range | 买家年龄分段:1表示年龄<18, 2表示年龄在[18,24],3表示年龄在[25,29],4表示年龄在[30,34],5表示年龄在[35,39],6表示年龄在[40,49],7和8表示年龄>=50,0和NULL则表示未知
(3)gender | 性别:0表示女性,1表示男性,2和NULL表示未知
(4)merchant_id | 商家id
(5)label | 是否是回头客,0值表示不是回头客,1值表示回头客,-1值表示该用户已经超出我们所需要考虑的预测范围。NULL值只存在测试集,在测试集中表示需要预测的值。
现在,下面需要把data_format.zip进行解压缩,我们需要首先建立一个用于运行本案例的目录dbtaobao,请执行以下命令:
cd /usr/local ls sudo mkdir dbtaobao //这里会提示你输入当前用户(本教程是hadoop用户名)的密码 //下面给hadoop用户赋予针对dbtaobao目录的各种操作权限 sudo chown -R hadoop:hadoop ./dbtaobao cd dbtaobao //下面创建一个dataset目录,用于保存数据集 mkdir dataset //下面就可以解压缩data_format.zip文件 unzip data_format.zip -d /usr/local/dbtaobao/dataset cd /usr/local/dbtaobao/dataset ls 讯享网
现在你就可以看到在dataset目录下有三个文件:test.csv、train.csv、user_log.csv,我们执行下面命令取出user_log.csv前面5条记录看一下。
讯享网head -5 user_log.csv
可以看到,前5行记录如下:
user_id,item_id,cat_id,merchant_id,brand_id,month,day,action,age_range,gender,province ,,833,2882,2661,08,29,0,0,1,内蒙古 ,,1271,2882,2661,08,29,0,1,1,山西 ,,1271,2882,2661,08,29,0,2,1,山西 ,,1271,2882,2661,08,29,0,1,1,内蒙古 2、数据集的预处理
(1)删除文件第一行记录,即字段名称
user_log.csv的第一行都是字段名称,我们在文件中的数据导入到数据仓库Hive中时,不需要第一行字段名称,因此,这里在做数据预处理时,删除第一行。
讯享网cd /usr/local/dbtaobao/dataset //下面删除user_log.csv中的第1行 sed -i '1d' user_log.csv //1d表示删除第1行,同理,3d表示删除第3行,nd表示删除第n行 //下面再用head命令去查看文件的前5行记录,就看不到字段名称这一行了 head -5 user_log.csv
(2)获取数据集中双11的前10000条数据
由于数据集中交易数据太大,这里只截取数据集中在双11的前10000条交易数据作为小数据集small_user_log.csv。下面我们建立一个脚本文件完成上面截取任务,请把这个脚本文件放在dataset目录下和数据集。
cd /usr/local/dbtaobao/dataset vim predeal.sh 上面使用vim编辑器新建了一个predeal.sh脚本文件,请在这个脚本文件中加入下面代码:
讯享网#!/bin/bash #下面设置输入文件,把用户执行predeal.sh命令时提供的第一个参数作为输入文件名称 infile=$1 #下面设置输出文件,把用户执行predeal.sh命令时提供的第二个参数作为输出文件名称 outfile=$2 #注意!!最后的$infile > $outfile必须跟在}’这两个字符的后面 awk -F "," 'BEGIN{ id=0; } { if($6==11 && $7==11){ id=id+1; print $1","$2","$3","$4","$5","$6","$7","$8","$9","$10","$11 if(id==10000){ exit } } }' $infile > $outfile
下面就可以执行predeal.sh脚本文件,截取数据集中在双11的前10000条交易数据作为小数据集small_user_log.csv,命令如下:
chmod +x ./predeal.sh ./predeal.sh ./user_log.csv ./small_user_log.csv (3)导入数据库
下面要把small_user_log.csv中的数据最终导入到数据仓库Hive中。为了完成这个操作,我们会首先把这个文件传到分布式文件系统HDFS中,然后,在Hive中创建两个个外部表,完成数据的导入。
执行下面命令启动Hadoop:
讯享网cd /usr/local/hadoop ./sbin/start-dfs.sh
然后,执行jps命令看一下当前运行的进程:
jps 如果出现下面这些进程,说明Hadoop启动成功了。
讯享网3765 NodeManager 3639 ResourceManager 3800 Jps 3261 DataNode 3134 NameNode 3471 SecondaryNameNode
现在,我们要把Linux本地文件系统中的user_log.csv上传到分布式文件系统HDFS中,存放在HDFS中的“/dbtaobao/dataset”目录下。
首先,请执行下面命令,在HDFS的根目录下面创建一个新的目录dbtaobao,并在这个目录下创建一个子目录dataset,如下:
cd /usr/local/hadoop ./bin/hdfs dfs -mkdir -p /dbtaobao/dataset/user_log 然后,把Linux本地文件系统中的small_user_log.csv上传到分布式文件系统HDFS的“/dbtaobao/dataset”目录下,命令如下:
讯享网./bin/hdfs dfs -put /usr/local/dbtaobao/dataset/small_user_log.csv /dbtaobao/dataset/user_log
下面可以查看一下HDFS中的small_user_log.csv的前10条记录,命令如下:
./bin/hdfs dfs -cat /dbtaobao/dataset/user_log/small_user_log.csv | head -10 接着在Linux系统中,再新建一个终端。因为需要借助于MySQL保存Hive的元数据,所以,请首先启动MySQL数据库:
讯享网service mysql start #可以在Linux的任何目录下执行该命令
由于Hive是基于Hadoop的数据仓库,使用HiveQL语言撰写的查询语句,最终都会被Hive自动解析成MapReduce任务由Hadoop去具体执行,因此,需要启动Hadoop,然后再启动Hive。由于前面我们已经启动了Hadoop,所以,这里不需要再次启动Hadoop。下面,在这个新的终端中执行下面命令进入Hive:
cd /usr/local/hive ./bin/hive # 启动Hive 讯享网hive> create database dbtaobao; hive> use dbtaobao;
接下来我们要分别在数据库dbtaobao中创建一个外部表user_log,它包含字段(user_id,item_id,cat_id,merchant_id,brand_id,month,day,action,age_range,gender,province),请在hive命令提示符下输入如下命令:
hive> CREATE EXTERNAL TABLE dbtaobao.user_log(user_id INT,item_id INT,cat_id INT,merchant_id INT,brand_id INT,month STRING,day STRING,action INT,age_range INT,gender INT,province STRING) COMMENT 'Welcome to xmu dblab,Now create dbtaobao.user_log!' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' STORED AS TEXTFILE LOCATION '/dbtaobao/dataset/user_log'; 上面已经成功把HDFS中的“/dbtaobao/dataset/user_log”目录下的small_user_log.csv数据加载到了数据仓库Hive中,我们现在可以使用下面命令查询一下:
讯享网hive> select * from user_log limit 10;
查询的结果如下:
OK 1280 2700 5476 11 11 0 0 1 四川 1280 2700 5476 11 11 0 7 1 重庆市 1181 1963 6109 11 11 0 1 0 上海市 1280 2700 5476 11 11 2 6 0 台湾 1280 2700 5476 11 11 0 6 2 甘肃 1280 2700 5476 11 11 0 4 1 甘肃 1280 2700 5476 11 11 0 5 0 浙江 1280 2700 5476 11 11 0 3 2 澳门 1280 2700 5476 11 11 0 7 1 台湾 962 305 6300 11 11 0 4 1 安徽 Time taken: 1.775 seconds, Fetched: 10 row(s) 二、Hive数据分析
在“hive>”命令提示符状态下执行下面命令:
讯享网hive> use dbtaobao; -- 使用dbtaobao数据库 hive> show tables; -- 显示数据库中所有表。 hive> show create table user_log; -- 查看user_log表的各种属性;
执行结果如下:
OK CREATE EXTERNAL TABLE `user_log`( `user_id` int, `item_id` int, `cat_id` int, `merchant_id` int, `brand_id` int, `month` string, `day` string, `action` int, `age_range` int, `gender` int, `province` string) COMMENT 'Welcome to xmu dblab,Now create dbtaobao.user_log!' ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe' WITH SERDEPROPERTIES ( 'field.delim'=',', 'serialization.format'=',') STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat' OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat' LOCATION 'hdfs://localhost:9000/dbtaobao/dataset/user_log' TBLPROPERTIES ( 'numFiles'='1', 'totalSize'='', 'transient_lastDdlTime'='') Time taken: 0.084 seconds, Fetched: 28 row(s) 1、查询条数统计分析
(1) 用聚合函数count()计算出表内有多少条行数据
讯享网hive> select count(*) from user_log; -- 用聚合函数count()计算出表内有多少条行数据
执行结果如下:
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/131650.html