
电信行业各大运营商竞争激烈,获客成本高,流失损失大。根据用户特征,建立流失预测模型,从中发掘用户流失的主要影响因素,对即将流失的用户进行针对性运营,是非常有必要的。
本文应用机器学习方法,对电信客户流失数据进行数据清洗,模型建立及优化,模型评估,结果分析及建议,得出一个电信用户流失预测分类器。并总结出用户流失的影响因素及运营建议。
数据来源:电信客户流失数据 数据集 - DataFountain
目录
1.数据预处理
1.1数据概览
1.2 数据预处理
2.模型建立和优化
2.1 模型准确性衡量(调参目标)
2.2 模型建立与调参
2.3 模型优化
3.结果与建议
1.数据预处理
1.1数据概览
| 数据集合名称 | 数据类型 | 字段数 | 行数 | 值缺失 |
|---|---|---|---|---|
| WA_Fn-UseC_-Telco-Customer-Churn | 字符、数值数据 | 20 | 7044 | 有 |
| 序号 | 字段名 | 数据类型 | 字段描述 |
|---|---|---|---|
| 1 | customerID | Integer | 用户ID |
| 2 | gender | String | 性别 |
| 3 | SeniorCitizen | Integer | 老年人 |
| 4 | Partner | String | 配偶 |
| 5 | Dependents | String | 家属 |
| 6 | tenure | Integer | 职位 |
| 7 | PhoneService | String | 电话服务 |
| 8 | MultipleLines | String | 多线 |
| 9 | InternetService | String | 互联网服务 |
| 10 | OnlineSecurity | String | 在线安全 |
| 11 | OnlineBackup | String | 在线备份 |
| 12 | DeviceProtection | String | 设备保护 |
| 13 | TechSupport | String | 技术支持 |
| 14 | StreamingTV | String | |
| 15 | Contract | String | 合同 |
| 16 | PaperlessBilling | String | 账单 |
| 17 | PaymentMethod | String | 付款方式 |
| 18 | MonthlyCharges | Integer | 月费用 |
| 19 | TotalCharges | Integer | 总费用 |
| 20 | Churn | String | 流失 |
导入各种包
import pandas as pd import numpy as np import seaborn as sns import matplotlib.pyplot as plt from sklearn.preprocessing import StandardScaler,LabelEncoder from sklearn.model_selection import StratifiedShuffleSplit,GridSearchCV from sklearn.tree import DecisionTreeClassifier from sklearn.naive_bayes import GaussianNB from sklearn.neighbors import KNeighborsClassifier from sklearn.ensemble import AdaBoostClassifier from sklearn.ensemble import RandomForestClassifier from sklearn.svm import SVC from xgboost import XGBClassifier from sklearn.linear_model import LogisticRegression from sklearn.metrics import accuracy_score,precision_score, recall_score, f1_score,roc_auc_score import warnings warnings.filterwarnings('ignore')讯享网
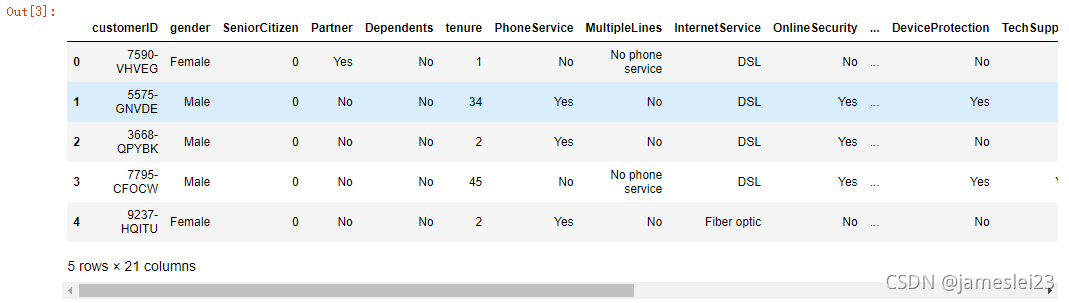
讯享网df=pd.read_csv('WA_Fn-UseC_-Telco-Customer-Churn.csv') df.head()
df.info()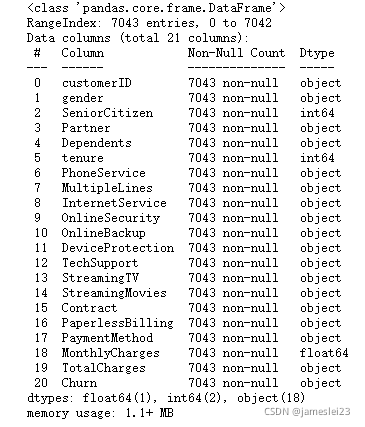
数据比较整齐,表面上看没有空值,但是需要留意是否有数值列含空格。
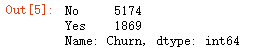
接下来看样本是否均衡,发现未流失用户数明显多于流失用户数。对于这种非均衡的样本,在训练集,测试集划分时可以采用分层取样。
讯享网df.Churn.value_counts()
1.2 数据预处理
注意到TotalCharges列本应该为浮点格式数字,但是因为某些单元格为空格,导致整列格式为文本。先筛选出含空格的行:
df[(df.TotalCharges.apply(lambda x:x.isspace()))]发现只有11行,所以直接删去,剩余的用astype函数转为浮点数。
讯享网df=df[~(df.TotalCharges.apply(lambda x:x.isspace()))] df.TotalCharges=df.TotalCharges.astype('float')
筛选出其余的非文本列:
df.select_dtypes(exclude='object')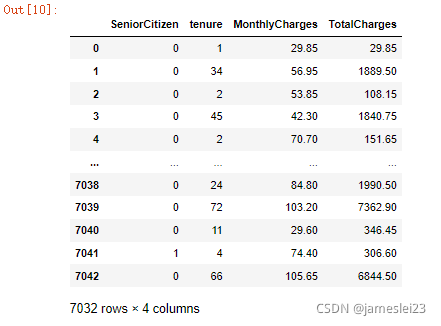
对其进行均值-标准差的标准化
讯享网ss=StandardScaler() df[['tenure','MonthlyCharges','TotalCharges']]=ss.fit_transform(df[['tenure','MonthlyCharges','TotalCharges']])
箱线图查看是否有异常值,结果并没有异常值
sns.boxplot(data=df[['tenure','MonthlyCharges','TotalCharges']])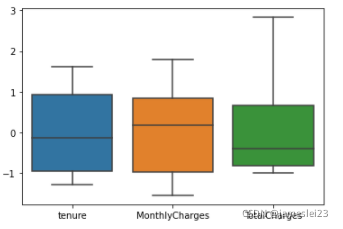
对于文本列,探究其内部有哪些值。
讯享网def uni(x): for i in range(0,len(x.columns)): print(x.columns[i],x.iloc[:,i].unique()) df_objects=df.iloc[:,1:].select_dtypes(include='object') uni(df_objects)
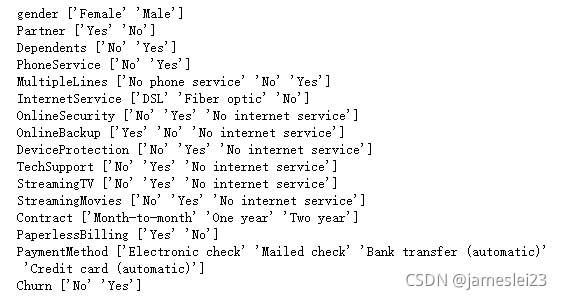
customerId为客户的编号,在分类中没有意义,可以筛出。
df1=df.iloc[:,1:]讯享网le=LabelEncoder() for i in range(0,len(df1.columns)): df1.iloc[:,i]=le.fit_transform(df1.iloc[:,i])
根据原数据的含义,将文本类数据采用One-Hot编码(编码数值大小不影响结果),此处使用sklearn的LabelEncoder进行编码,注意该方法一次只能编码一列,所以要用循环。
le=LabelEncoder() for i in range(0,len(df1.columns)): df1.iloc[:,i]=le.fit_transform(df1.iloc[:,i])
可以看到编码后,数据大小没有改变,只是把yes,no等离散变量用0,1,2。。。替换了。此处也可以不用labelencoder,而是map或者apply去逐一替换,只是有点麻烦。
接下来,将Churn设为y,其他特征设为x
讯享网x=df1.iloc[:,:-1] y=df1.iloc[:,-1].values #这里y要改成array形式,否则后面交叉验证分组时报错
用corr()检查自变量间的自相关性,画出热力图,采用YlGnBu颜色方案可以更加清楚,颜色越深相关系数越高,annot=True显示值标签,如果有自相关性很高的变量(相关系数>0.85),只需取其中一个变量即可,这样可以有效降维。
plt.figure(figsize=(12,12)) sns.heatmap(x.corr(),cmap='YlGnBu',annot=True) plt.show() 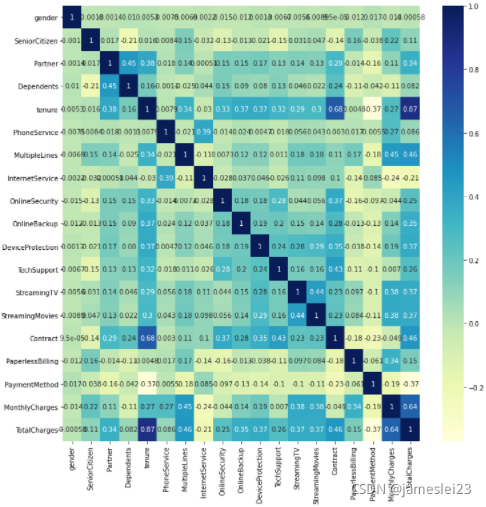
Tenure和TotalCharge相关系数0.87,可以去掉Tenure列。
讯享网x.drop(columns=['Tenure'],inplace=True)
接下来进行分组抽样。
sss=StratifiedShuffleSplit(n_splits=5, test_size=0.2, random_state=0) for train_index, test_index in sss.split(x, y): print("train:", train_index, "test:", test_index) x_train,x_test=x.iloc[train_index],x.iloc[test_index] y_train,y_test=y[train_index], y[test_index]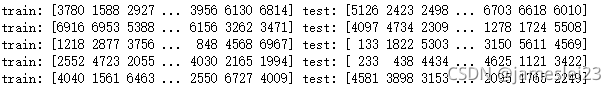
讯享网print('原数据特征',x.shape, '训练集数据特征',x_train.shape, '测试集数据特征',x_test.shape)

2.模型建立和优化
2.1 模型准确性衡量(调参目标)
对于一般的分类器,采用准确率进行衡量。准确率定义为模型预测正确的样本个数占总样本数的比例。但是准确率无法体现预测不准的地方在哪,影响如何。对于一个二分类问题,一般有四种预测情况:
TP:预测为正,预测正确
TN:预测为负,预测正确
FP:预测为正,预测错误,误报
FN:预测为负,预测错误,漏报
准确率的定义即:Accuracy=(TP+TN)/(TP+TN+FP+FN)
此处新增如下指标:
精确率:TP/(TP+FP)
召回率:TP/(TP+FN)
假正率:FP/(FP+TN)
对于精确率,分母为预测为正的数量,表明预测为流失的用户中,预测正确的比例;召回率分母为样本中正的数量,表明所有样本中的流失用户被预测为流失的比例。精确率与召回率两者一般为负相关,例如模型把所有用户都定义为流失,则召回率为1,但此时精确率很低,所以综合精确率与召回率,定义F1,为精确率和召回率的调和平均数。F1越大说明模型越好。
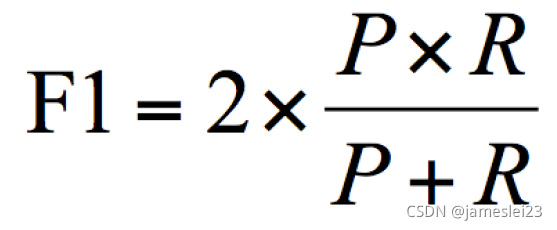
对于错正率,是在负的样本中误报为正的比例。常说的ROC曲线即为召回率(y)与错正率(x)的关系曲线,召回率与错正率的分母均基于样本中正(或负)的数量,所以对于正负分布不均的样本,ROC曲线并未受到影响。ROC曲线的面积AUC值可以量化模型的表现,AUC介于0-1之间,值越大,说明同样错正率下召回率越高,模型表现越好。AUC值如果小于0.5,说明还不如随机预测,AUC值>0.85为较好的表现。
F1与ROC-AUC:两者均包含召回率;F1除了优化召回率,还要优化精确率,希望TP大,FP小,AUC则还需优化假正率,希望FP小,TN大。所以,如果希望判断出更多正确的正,即查出更多即将流失的样本,则用F1,如果希望判断出更多正确的负,即查出更多未流失的样本,则用AUC。本例中采用F1。此外,AUC可以在样本正负不均时有较好适用性。
2.2 模型建立与调参
以f1为目标参数进行调参,选用了决策树,SVM支持向量机,KNN,随机森林,朴素贝叶斯(高斯),逻辑回归,Xgboost,Adaboost这八种常见的机器学习模型。使用GridSearch网格搜索进行暴力调参。
对于决策树,调最大树深;
SVM则是惩罚函数C,越大模型越准确,越小则越泛化,gamma为核函数系数;
KNN调邻居数;
随机森林调子分类器个数和最大树深;
朴素贝叶斯没有可调参数,故为空字典;
逻辑回归调正则化方法,一般用l2,也要调整惩罚函数C;
xgboost调学习率eta,或learning_rate,可增加模型鲁棒性,还可以调别的参数,此处省略;
adaboost 调子分类器个数(最大迭代次数)。
注意,使用get_params()可以看到模型可调的参数。
XGBClassifier().get_params()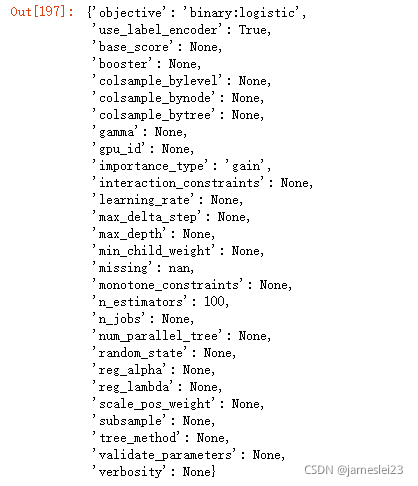
代码如下
讯享网#以F1为目标函数调参 methods_name=['clf','svm','knn','rfc',"nb",'lr','xgb','adaboost'] methods=[DecisionTreeClassifier(),SVC(),KNeighborsClassifier(),RandomForestClassifier(),GaussianNB(),LogisticRegression(),XGBClassifier(),AdaBoostClassifier()] methods_para=[{'max_depth':[5,6,7,8,9]}, {'C': [1e-2, 1e-1, 1, 10, 100],'gamma': [0.001, 0.0001]}, {'n_neighbors':[4,6,8,10,12]}, {'n_estimators':[3,7,11],'max_depth':[6,10,14]}, {}, {'penalty':['l1','l2'],'C':[0.1,1,10]}, {'eta':[0.01,0.3]}, {'n_estimators':[10,50,100]}] def classifier(x_train,y_train,x_test,y_test,methods,parameters,method_name): results={} g=GridSearchCV(estimator=methods,scoring='f1',param_grid=parameters) c=g.fit(x_train,y_train) y_pred=c.predict(x_test) results['method']=method_name results['f1_score']=c.best_score_ results['bestpar']=c.best_params_ results['accuracy_score']=accuracy_score(y_test,y_pred) results['recall_score']=recall_score(y_test,y_pred) results['precision_score']=precision_score(y_test,y_pred) results['auc_score']=roc_auc_score(y_test,y_pred) return results f1=pd.DataFrame() for i,j,k in zip(methods_name,methods,methods_para): f1=f1.append(classifier(x_train,y_train,x_test,y_test,j,k,i),ignore_index=True) f1.sort_values('f1_score',ascending=False)
结果按照f1_score降序排列,发现朴素贝叶斯效果最好,其auc的表现也最好,knn和svm表现最差。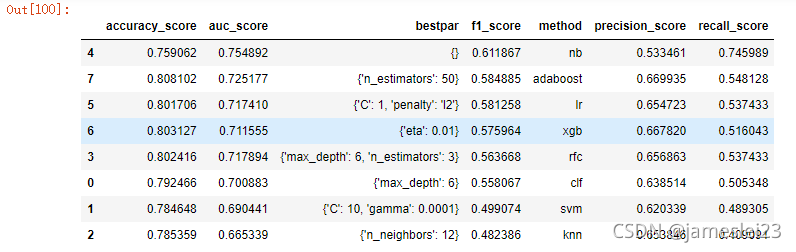
此处也可以以AUC为目标调参,方法也很简单,只需简单替换一下,代码为
#以AUC为目标函数调参 methods_name=['clf','svm','knn','rfc',"nb",'lr','xgb','adaboost'] methods=[DecisionTreeClassifier(),SVC(),KNeighborsClassifier(),RandomForestClassifier(),GaussianNB(),LogisticRegression(),XGBClassifier(),AdaBoostClassifier()] methods_para=[{'max_depth':[5,6,7,8,9]}, {'C': [1e-2, 1e-1, 1, 10, 100],'gamma': [0.001, 0.0001]}, {'n_neighbors':[4,6,8,10,12]}, {'n_estimators':[3,7,11],'max_depth':[6,10,14]}, {}, {'penalty':['l1','l2'],'C':[0.1,1,10]}, {'eta':[0.01,0.3]}, {'n_estimators':[10,50,100]}] def classifier(x_train,y_train,x_test,y_test,methods,parameters,method_name): results={} g=GridSearchCV(estimator=methods,scoring='roc_auc',param_grid=parameters) c=g.fit(x_train,y_train) y_pred=c.predict(x_test) results['method']=method_name results['auc_score']=c.best_score_ results['bestpar']=c.best_params_ results['accuracy_score']=accuracy_score(y_test,y_pred) results['recall_score']=recall_score(y_test,y_pred) results['precision_score']=precision_score(y_test,y_pred) results['f1_score']=f1_score(y_test,y_pred) return results auc=pd.DataFrame() for i,j,k in zip(methods_name,methods,methods_para): auc=auc.append(classifier(x_train,y_train,x_test,y_test,j,k,i),ignore_index=True) auc.sort_values('auc_score',ascending=False)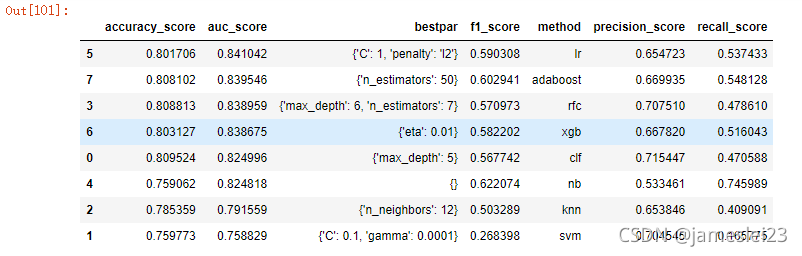
可以看到,逻辑回归的AUC效果最好,其余模型效果类似,除了knn和svm表现还是很差。但是考虑到模型样本分布不均3:1,考虑能否进一步优化。
2.3 模型优化
对于样本分布不均,采用过采样+lr,xgb正则化防止过拟合。
此处安装不上imblearn,所以手动过采样。
讯享网df2=pd.concat([df1,df1[df1.Churn=='Yes'],df1[df1.Churn=='Yes']]) x=df2.iloc[:,:-1].drop(columns=['tenure']) y=(df2.iloc[:,-1:]).applymap(lambda x:1 if x=='Yes' else 0).values x=pd.get_dummies(x) sss=StratifiedShuffleSplit(n_splits=1, test_size=0.2, random_state=0) for train_index, test_index in sss.split(x, y): print("train:", train_index, "test:", test_index) x_train,x_test=x.iloc[train_index],x.iloc[test_index] y_train,y_test=y[train_index], y[test_index] lr=LogisticRegression() lr=lr.fit(x_train,y_train) y_pred=lr.predict(x_test) results={} results['auc_score']=roc_auc_score(y_test,y_pred) results['accuracy_score']=accuracy_score(y_test,y_pred) results['recall_score']=recall_score(y_test,y_pred) results['precision_score']=precision_score(y_test,y_pred) results['f1_score']=f1_score(y_test,y_pred) results

lr的结果auc和f1都比之前好。
再试试xgb
xgb=XGBClassifier() xgb=xgb.fit(x_train,y_train) y_pred=xgb.predict(x_test) results={} results['auc_score']=roc_auc_score(y_test,y_pred) results['accuracy_score']=accuracy_score(y_test,y_pred) results['recall_score']=recall_score(y_test,y_pred) results['precision_score']=precision_score(y_test,y_pred) results['f1_score']=f1_score(y_test,y_pred) results 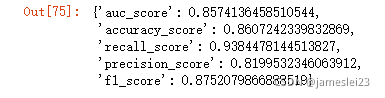
结果也比之前提升巨大。 说明欠采样对于样本分布不均匀还是很有必要的。
3.结果与建议
查看特征对模型的重要性。利用逻辑回归查看每一项的系数,绝对值越大代表影响越大,为正说明对该特征与流失成正相关,负说明该特征与不流失成正相关。
讯享网mod=LogisticRegression(penalty='l2',C=1) mod=mod.fit(x_train,y_train) coef={} for i in range(0,len(x_train.columns)): coef[x_train.columns[i]]=mod.coef_[0][i] weight=pd.DataFrame(coef,index=['weight']).T weight['abs_weight']=weight.abs() weight.sort_values('abs_weight',ascending=False)
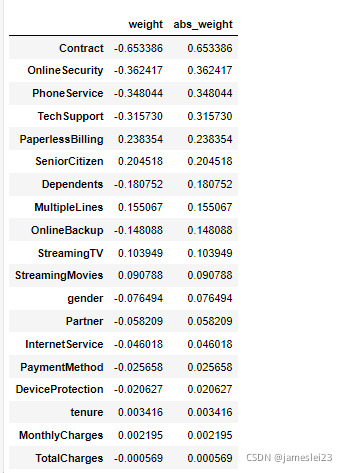
无影响:客户的职位,月费用,总费用;
几乎无影响:是否开通网络电影,性别,是否开通互联网服务,付款方式,是否开通保护业务;
影响很大:签订合同方式,按月签订极易流失,按年,两年签订则不易流失,此处可能与流失的定义有关;
影响较大:是否开通网络安全服务,是否开通电话服务业务,是否开通了技术支持服务,开通上述服务则更不易流失;
其他:年长用户更易流失,经济未独立用户更易流失。
建议:
1. 检查流失的定义,看是否可以用签订合同的方式去作为流失与否的判断,如果可以,则要调整流失的定义重新建模,或者直接用签订合同的方式判断流失;如果不可以,则在运营中注意向客户推荐长期产品或是增加长期产品的优惠。
2.运营时注意客户画像,对于易流失的年长和经济未独立用户重点关注。
3.对开通网络安全服务,开通电话业务服务,技术支持服务的人群做用户画像分析,总结这部分不易流失的用户的特征,作为未来拉新及产品改进的主要对象。
4.不要歧视月费低的用户,其月费虽然低,但流失率与月费高的用户基本一样,运营时注意引导其从低价转向高价。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/131406.html