
感谢知乎大佬:@弈心
本文是基于@弈心大佬(王印)的书籍《网络工程师的python之路》所整理的笔记
netdev(异步并行)
netdev是俄罗斯网络运维开发工程师Sergey Yakovlev开发的一套用来实现异步登录和配置网络设备的第三方开源模块。在讲解它的用法前,首先需要知道什么是同步(Synchronous),什么是异步(Asynchronous),以及为什么使用异步能够提升日常网络运维的工作效率。
1.1 同步与异步
所谓同步,可以理解为每当系统执行完一段代码或者函数后,系统都将一直等待该段代码或函数的返回值或消息,直到系统接收返回值或消息后才继续执行下一段代码或函数,在等待返回值或消息期间,程序处于阻塞状态,系统将不做任何事情。 例如前面的实验中,我们都是将设备的IP地址预先写入一个名为ip.txt的文本文件,然后在脚本里使用open()函数将其打开,调用readlines()函数并配合for循环读取每个设备的IP地址,再通过Paramiko或者Netmiko一台接一台设备地完成SSH登录。像这样Python一次只能登录一台设备,只有完成一台设备的配置后才能登录下一台设备继续配置的方式就是一种典型的“同步”。
而异步则恰恰相反,系统在执行完一段代码或者函数后,不用阻塞性地等待返回值或消息,而是继续执行下一段代码或函数,在同一时间段里执行多个任务(而不是傻傻地等着一件事情做完并且结果出来后才去做下一件事情),将多个任务并行,从而提高程序的执行效率。同步和异步有一个相同点:它们都是单线程下的概念。关于单线程和多线程的比较在后面讨论。
1.2 异步在Python中的应用
要了解异步在Python中的应用,必须知道什么是协程(Coroutine)、什么是任务(Task)、什么是可等待对象(Awaitable Object)。 我们可以把协程理解为线程的优化,看成一种微线程。它是一种比线程更节省资源、效率更高的系统调度机制。异步就是基于协程实现的。在Python中,实现协程的模块主要有asyncio、gevent和tornado,使用较多的是asyncio。首先来看下面的例子。
import asyncio import time async def main (): print ('hello') await asyncio.sleep (1) print ('world') print (f"程序于{time.strftime ('%X')}开始执行") asyncio.run (main ()) print (f"程序于{time.strftime ('%X')}执行结束")讯享网
• 在Python中,我们通过在def语句前加上async语句将一个函数定义为协程函数,在上面的例子中,main()函数被定义为协程函数。 • 这里的await asyncio.sleep(1)表示临时中断当前的函数1s。如果程序中还有其他函数,则继续执行下一个函数,直到下一个函数执行完毕,再返回来执行main()函数。因为除了一个main()函数,就没有其他函数了,所以在print('hello')后,main()函数休眠了1s,然后继续print('world')。 • 协程函数不是普通的函数,不能直接用main()来调用,需要使用asyncio.run(main())才能执行该协程函数。 • 我们配合time模块的strftime()函数来记录程序开始前的时间和程序结束后的时间,可以看到总共耗时确实是1s,如下图所示。
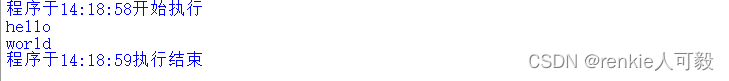
需要注意的是,不要把await asyncio.sleep(1)和time.sleep(1)弄混,后者是在同步中使用的休眠操作,前者是在异步中使用的,因为只有一个main()函数需要执行,所以暂时感受不到这两者的区别,不用着急,继续看下面的两个例子。
讯享网import asyncio import time async def say_after(what,delay): print (what) await asyncio.sleep (delay) async def main(): print (f"程序于{time.strftime ('%X')}开始执行") await say_after('hello',1) await say_after('world',2) print (f"程序于{time.strftime ('%X')}执行结束") asyncio.run (main())
• 我们在协程函数main()的基础上加入了另一个函数say_after()。同样地,我们用async将它定义为协程函数。 • 我们在main()函数中两次调用say_after()函数,因为say_after()函数是一个协程函数,因此在调用它时,前面必须加上await。 • 当main()函数第一次调用say_after()函数时,首先打印出“hello”,然后休眠1s;第二次调用say_after()函数时,打印出“world”,再休眠2s。两次调用总共花费3s来运行完整个程序,如下图所示。
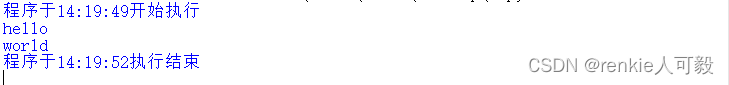 这时,第一次花费1s,第二次花费2s,总共3s时间,这没节省时间啊,两次调用的say_after()函数并没有被并行啊,这和同步有什么区别?别急,继续往下看。
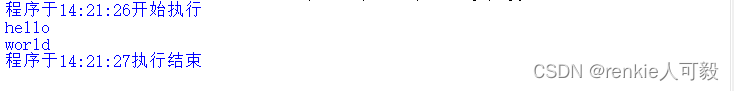
import asyncio import time async def say_after(what,delay): await asyncio.sleep (delay) print (what) async def main(): task1=asyncio.create_task(say_after('hello',1)) task2=asyncio.create_task(say_after('world',1)) print (f"程序于{time.strftime ('%X')}开始执行") await task1 await task2 print (f"程序于{time.strftime ('%X')}执行结束") asyncio.run (main())要实现异步并行,需要将协程函数打包成一个任务,这里使用asyncio的create_task()函数将say_after()函数打包了两次,并分别赋值给task1和task2两个变量。然后使用await来调用task1和task2两个任务。 • 运行脚本后可以看到,因为task1和task2是并行执行的,所以程序总共耗时2s即告完成,如下图所示。
最后来看什么是可等待对象。可等待对象的定义很简单:如果一个对象可以在await语句中使用,那么它就是可等待对象。可等待对象主要有3种类型:协程、任务和Future。
1.3netdev的安装和应用
然而由于异步在Python中引入较晚,paramiko、netmiko都不支持前面讲的可等待对象,也就无法支持异步并行。
受Netmiko项目的启发,俄罗斯网络运维开发工程师Sergey Yakovlev在Netmiko的基础上开发了一个叫作netdev的开源模块。该模块依赖Netmiko,并且需要至少Python 3.5以上才能运行,最大的特点是支持对网络设备进行异步登录和操作。 下面介绍如何安装和使用netdev。netdev可以通过pip直接下载安装(因为netdev依赖Netmiko,下载netdev前请确认你的Python主机是否已经安装了Netmiko)
目前netdev项目已经不再维护,且对华为设备支持性不好,这里不再研究这个项目了。
单线程与多线程
一个程序可以启用多个线程同时完成多个任务,如果一个线程阻塞,其他线程并不受影响。现在的CPU都是多核的,单线程只用到其中的一核,这其实是对硬件资源的一种浪费(当然不可否认的是,随着时代的进步,现在的CPU已经足够强大,即使只用单核也能同时应付多个任务,这也是后来Python支持异步的原因)。如果使用多线程来运行Python脚本,则不仅能极大地提高脚本的运行速度,提高工作效率,并且还能充分利用主机的硬件资源。下面来看如何在Python中使用多线程。
多线程在Python中的应用
Python 3已经内置了_thread和threading两个模块来实现多线程。相较于_thread,threading提供的方法更多而且更常用,因此我们将举例讲解threading模块的用法。首先来看下面这段代码。
讯享网import threading import time def say_after(what,delay): print (what) time.sleep(delay) print (what) t = threading.Thread (target=say_after,args =('hello',3)) t.start()
• 我们导入Python内置模块threading来实现多线程。之后定义一个say_after(what,delay)函数,该函数包含what和delay两个参数,分别用来表示打印的内容及time.sleep()休眠的时间。
• 随后使用threading的Thread()函数为say_after(what, delay)函数创建一个线程并将它赋值给变量t,注意Thread()函数的target参数对应的是函数名称(即say_after),args对应的是该say_after函数的参数,等同于what = 'hello'和delay = 3。
• 最后调用threading中的start()来启动刚刚创建的线程。
运行代码看效果,如下图所示。
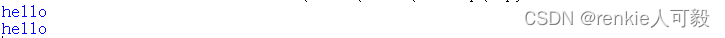 在打印出第一个“hello”后,程序因为time.sleep(3)休眠了3s,之后随即打印出了第二个个“hello”。因为这时我们只运行了say_after(what, delay)这一个函数,并且只运行了一次,因此即使我们启用了多线程,也感受不到它和单线程的区别。接下来将代码修改如下。
import threading import time def say_after(what,delay): print (what) time.sleep (delay) print (what) t = threading.Thread (target=say_after,args =('hello\n',3)) print(f"程序于{time.strftime('%X')}开始执行") t.start() print(f"程序于{time.strftime('%X')}执行结束")• 这一次调用time.strftime()来尝试记录程序执行前和执行后的时间,运行代码看效果,如下图所示。
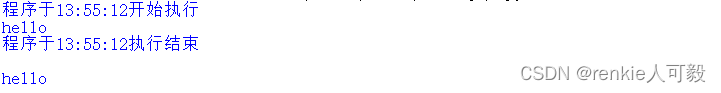
这里大家肯定会问为什么程序在13:55:12开始执行,又在同一时间结束?难道不是该休眠3s吗?为什么明明print (f"程序于 {time.strftime('%X')} 开始执行")和print (f"程序于{time.strftime('%X')} 执行结束")分别写在t.start()的上面和下面,但是不等第二个“hello”被打印出来,print (f"程序于 {time.strftime('%X')} 执行结束")就被执行了?
这是因为除了threading.Thread()为say_after()函数创建的用户线程,print(f"程序于{time.strftime('%X')}开始执行")和print(f"程序于{time.strftime('%X')}执行结束")两个print()函数也共同占用了公用的内核线程。也就是说,该脚本实际上调用了两个线程:一个是用户线程,一个是内核线程,也就构成了一个多线程的的环境。因为分属不同的线程,say_after()函数和函数之外的两个print语句是同时运行的,互不干涉,所以 print(f"程序于{time.strftime('%X')}执行结束")不会像在单线程中那样等到t.start()执行完才被执行,而是在print (f"程序于 {time.strftime('%X')} 开始执行")被执行后就马上跟着执行。这也就解释了为什么你会看到原本需要休眠3s的脚本会在13:55:12同时开始和结束。
如果想要正确捕捉say_after(what, delay)函数开始和结束的时间,需要额外使用threading模块的join()方法,代码如下。
讯享网import threading import time def say_after(what,delay): print (what) time.sleep (delay) print (what) t = threading.Thread (target=say_after,args =('hello\n',3)) print(f"程序于{time.strftime('%X')}开始执行") t.start() t.join() print(f"程序于{time.strftime('%X')}执行结束")
• 我们只修改了代码的一处地方,即在t.start()下面添加了一个t.join()。
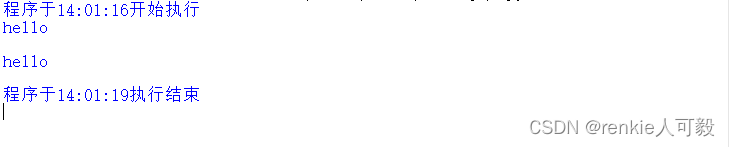
可以看到,因为调用了 join()方法,在内核线程上运行的print (f"程序于 {time.strftime('%X')}执行结束")必须等待在用户线程上运行的say_after(what, delay)函数执行完毕后,才能继续执行,因此程序前后执行总共花费3s,类似单线程同步的效果。
import threading import time def say_after(what,delay): print (what) time.sleep (delay) print (what) print(f"程序于{time.strftime('%X')}开始执行") threads=[] for i in range(1,6): t = threading.Thread (target=say_after,name="线程"+str(i),args =('hello',3)) print(t.name+'开始执行。') t.start() threads.append(t) for i in threads: i.join() print(f"程序于{time.strftime('%X')}执行结束")
• 我们使用for循环配合range(1,6)创建了5个线程,并且将它们以多线程的形式执行,也就是把say_after(what, delay)函数以多线程的形式执行了5次。每个线程都作为元素加入threads空列表,然后使用for语句遍历已经有5个线程的threads列表,对其中的每个个线程都调用join()方法,确保直到它们都执行结束,才执行内核线程的print (f"程序于 {time.strftime('%X')} 执行结束")。
运行代码看效果,如下图所示。
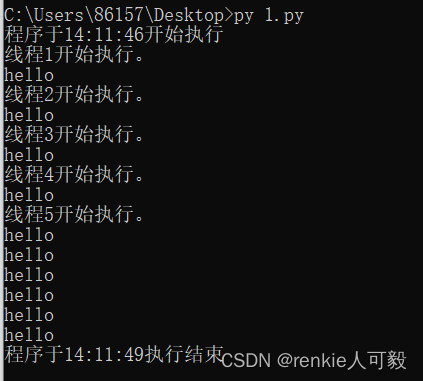
可以看到,我们成功地使用多线程将程序执行,如果以单线程来执行5次say_after(what,delay)函数,则需要花费3×5=15s才能运行完整个脚本,而在多线程形式下,整个程序只花费3s就运行完毕。
多线程在Netmiko中的应用
首先我们先看看不使用多线程,程序所用的时间,这里我们使用之前的实验:利用SSH登录四台交换机,并将stp模式由MSTP改为STP。
实验拓扑

实验代码
讯享网from netmiko import ConnectHandler import time print (f"程序于{time.strftime ('%X')}开始执行") for i in range(20,24): SW={ 'device_type':'huawei', 'ip':'10.0.1.'+str(i), 'username':'python', 'password':'', } connect=ConnectHandler(SW) print('\n'+'-----------------'+'成功登录到交换机'+SW['ip']+'-----------------') config_commands=['stp mode stp','dis stp | include CIST Global Info'] output=connect.send_config_set(config_commands) print(output) connect.save_config() print (f"程序于{time.strftime ('%X')}执行结束")
实验结果
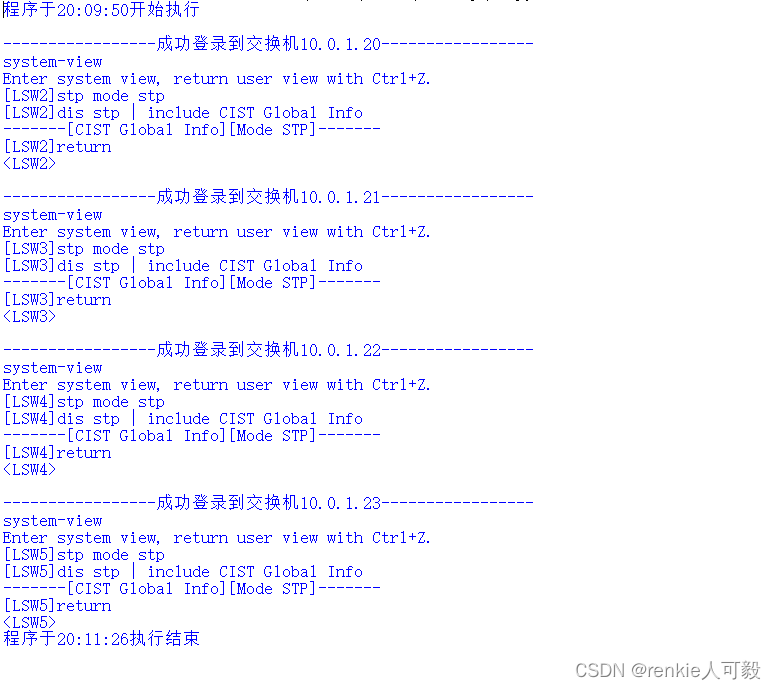
由以上结果可知,程序执行所需要的时间为96s。
使用多线程
实验代码
import threading from queue import Queue import time from netmiko import ConnectHandler threads=[] for i in range(20,24): def ssh_session(ip,output_q): commands=['stp mode stp','dis stp | include CIST Global Info'] SW={'device_type':'huawei', 'ip':'10.0.1.'+str(i),'username':'python','password':'',} ssh_session=ConnectHandler(SW) output=ssh_session.send_config_set(commands) print(output) ssh_session.save_config() print (f"程序于{time.strftime ('%X')}开始执行") for ips in range(20,24): t=threading.Thread(target=ssh_session,args=('10.0.1.'+str(i),Queue())) t.start() threads.append(t) for i in threads: i.join() print (f"程序于{time.strftime ('%X')}执行结束")在使用Netmiko实现多线程时,需要导入内置队列模块queue。在Python中,队列(queue)是线程间最常用的交换数据的形式,这里引用queue模块中的Queue类,也就是先进先出(First Input First Output,FIFO)队列,并将它作为出队列参数配置给ssh_session(ip, output_q)函数。
实验结果
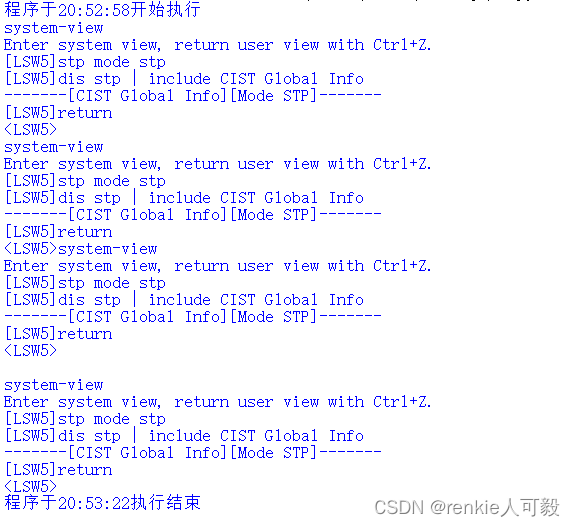
由以上结果可知,运行的时间为24s,运行时间大大缩短 。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/131341.html