
原文链接:https://mp.weixin..com/s?__biz=MzAxMDkxODM1Ng==&mid=&idx=1&sn=b735a4690d9f4efdd601bc8ddd9c4362&chksm=9b484dc6ac3fc4d025cefa64d4b83ff3dc8f76d7aedf1a21d4b5feb4086e8c&scene=21#wechat_redirect
一:下载指定癌症中感兴趣基因的表达量
#load package library(cgdsr) library(DT) #create a CGDS Object mycgds <- CGDS("http://www.cbioportal.org/") #get all the cancer type that can be studied all_TCGA_studies <- getCancerStudies(mycgds) #get the items having gbm gbm_items <- all_TCGA_studies[grepl('gbm',all_TCGA_studies$cancer_study_id),] #view the result print(gbm_items)讯享网
部分结果展示如下:
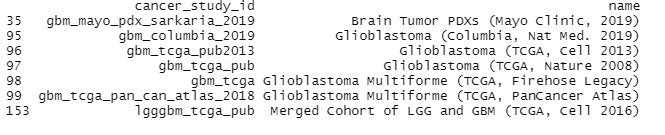
由结果可以看出,总共有7个项目带有gbm。
2.下载感兴趣基因的表达矩阵
讯享网获取基因列表 library(KEGG.db) #view the functions in the KEGG.db package ls("package:KEGG.db") #get the cell_cycle_genes_lists cellcycle_genes=KEGGPATHID2EXTID[['hsa04110']] #get the cell factor cytokine_genes=KEGGPATHID2EXTID[['hsa04060']] print(cytokine_genes) 获取在 "gbm_tcga" 数据集中有哪些表格(每个表格都是一个样本列表) all_tables <- getCaseLists(mycgds, "gbm_tcga") DT::datatable(all_tables[,1:4], extensions = 'FixedColumns', options = list( #dom = 't', scrollX = TRUE, fixedColumns = TRUE )) 而后获取可以下载哪几种数据,一般是mutation,CNV和表达量数据 all_dataset <- getGeneticProfiles(mycgds, "gbm_tcga") DT::datatable(all_dataset, extensions = 'FixedColumns', options = list( #dom = 't', scrollX = TRUE, fixedColumns = TRUE )) # my_dataset <- 'gbm_tcga_mrna_U133' # my_table <- "gbm_tcga_mrna_U133" #获取细胞周期基因列表中所有基因的数据信息 cellcycle_expr <- getProfileData(mycgds, cellcycle_genes, my_dataset, my_table) dim(cellcycle_expr) #获取细胞因子列表中所有因子的数据信息 cytokine_expr <- getProfileData(mycgds, cytokine_genes, my_dataset, my_table) dim(cytokine_expr) #获取'NCR2'基因的数据信息 NCR2_expr <- getProfileData(mycgds, 'NCR2', my_dataset, my_table) dim(NCR2_expr)
3.绘制散点图
(1)
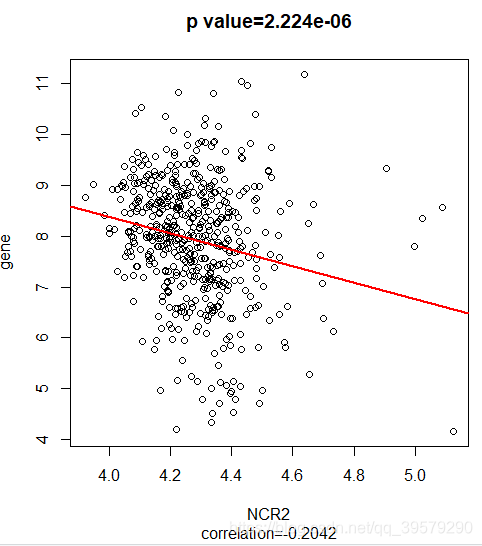
cor_plot <- function(x,y){ #x=NCR2_expr$NCR2 #y=cellcycle_expr$CCNB1 plot(x,y, xlab = 'NCR2', ylab = 'gene') model = lm(y ~ x) summary(model) int = model$coefficient["(Intercept)"] slope =model$coefficient["x"] abline(int, slope, lty=1, lwd=2, col="red") r= format(cor(x,y),digits = 4) p= format(cor.test(x,y)$p.value,digits = 4) title(main = paste0('p value=',p), sub = paste0('correlation=',r)) } cor_plot(x=NCR2_expr$NCR2,y=cellcycle_expr$CCNB1)结果图为:
(2)
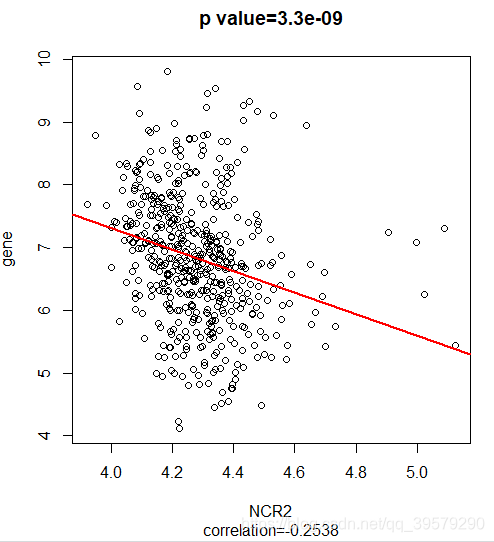
讯享网cor_plot(x=NCR2_expr$NCR2,y=cellcycle_expr$BUB1B)
结果图为:
(3)
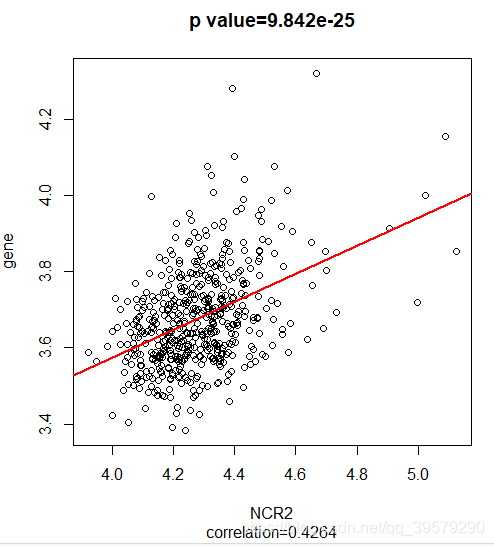
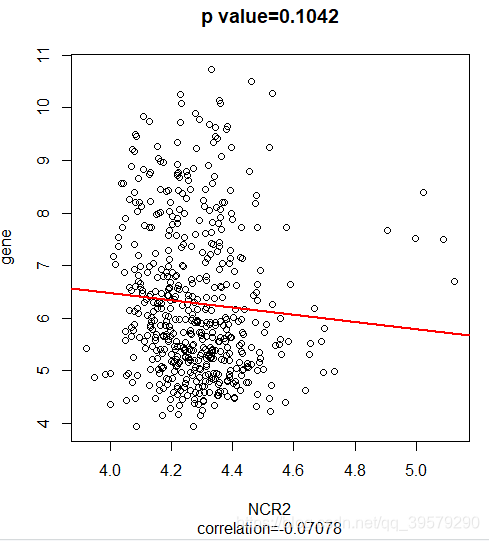
cor_plot(x=NCR2_expr$NCR2,y=cytokine_expr$CCL1)结果图为:
(4)
讯享网cor_plot(x=NCR2_expr$NCR2,y=cytokine_expr$CCL4)
结果图为:
4.相关系数的总结
(1)细胞周期基因
boxplot(as.numeric(cor(NCR2_expr$NCR2,cellcycle_expr)))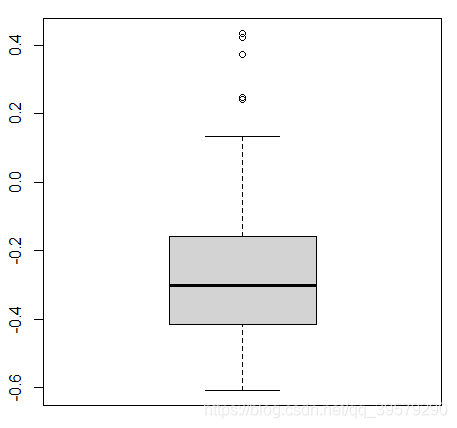
(2)细胞因子
讯享网boxplot(as.numeric(cor(NCR2_expr$NCR2,cytokine_expr)))
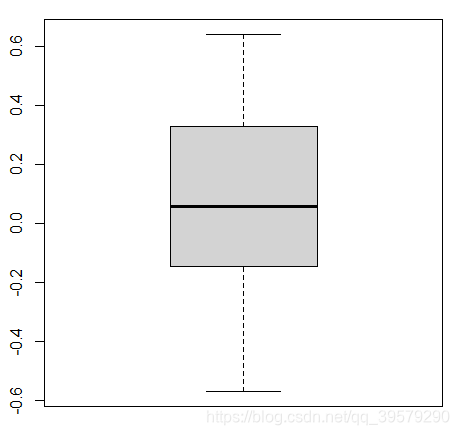
5.知识点总结
(1)grepl函数:和grep函数类似,均为R语言中的字符串处理函数。
grep()函数用法:grep(pattern, x, ignore.case = FALSE, perl = FALSE, value = FALSE, fixed = FALSE, useBytes = FALSE, invert = FALSE)。在向量x中寻找含有特定字符串(pattern参数指定)的元素,返回其在x中的下标。
grepl()函数用法:grepl(pattern, x, ignore.case = FALSE, perl = FALSE, fixed = FALSE, useBytes = FALSE),返回值为逻辑值,即判断是否有pattern被匹配。
(2)R语言的$符号:aq,a$b,从a中选取b部分。
(3)R语言中的cor()函数:cor函数的结果是列与列间的相关系数,得到的举证C(i,j)是第i列与第j列相关系数。与之相类似的是cov函数,它计算的是列与列的协方差。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/130549.html