
先给大家看一下效果:
因为没有女朋友(懂的都懂),所以只能找一些女朋友的照片啦~
先获取一些漂亮女朋友照片

讯享网
然后在根据照片进行颜值排名打分
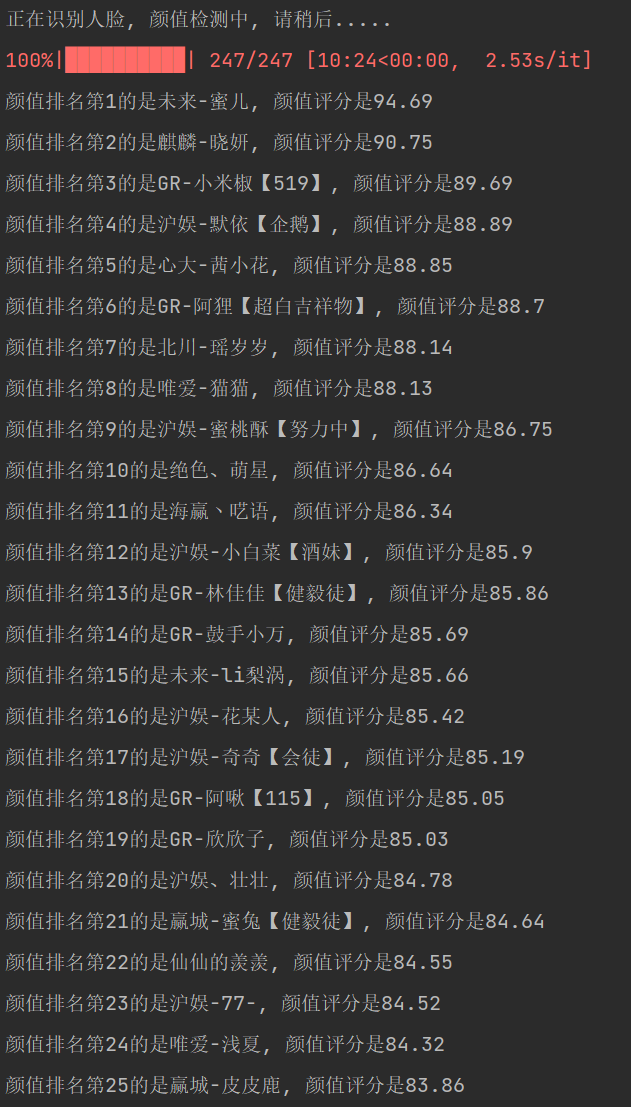
来让我们看一下第一名的女朋友的颜值
第一名:颜值评分是94.69分的女朋友

最后一名:颜值评分是22.84分的女朋友

怎么感觉有点翻车,这个评分机制都点拉垮!
也可能是她的手挡住了脸,拉低的评分!
好!废话不多说,正式开始~
需要的环境与模块
[开发环境]:
- Python 3.8
- Pycharm 2021.2
- 会使用API接口 百度云接口
[模块使用]:
- requests
- tqdm
- os
- base64
模块安装问题:
- 如果安装python第三方模块:
1. win + R 输入 cmd 点击确定, 输入安装命令 pip install 模块名 (pip install requests) 回车
2. 在pycharm中点击Terminal(终端) 输入安装命令
- 安装失败原因:
- 失败一: pip 不是内部命令
解决方法: 设置环境变量 - 失败二: 出现大量报红 (read time out)
解决方法: 因为是网络链接超时, 需要切换镜像源
清华:https://pypi.tuna.tsinghua.edu.cn/simple
阿里云:http://mirrors.aliyun.com/pypi/simple/
中国科技大学 https://pypi.mirrors.ustc.edu.cn/simple/
华中理工大学:http://pypi.hustunique.com/
山东理工大学:http://pypi.sdutlinux.org/
豆瓣:http://pypi.douban.com/simple/
例如:pip3 install -i https://pypi.doubanio.com/simple/ 模块名 - 失败三: cmd里面显示已经安装过了, 或者安装成功了, 但是在pycharm里面还是无法导入
解决方法: 可能安装了多个python版本 (anaconda 或者 python 安装一个即可) 卸载一个就好
或者你pycharm里面python解释器没有设置好
实现步骤
一. 数据来源分析
女盆友们照片, 照片url地址 可以从哪里获取
通过网页上面开发者工具进行抓包分析
二. 代码实现步骤 发送请求 >>> 获取数据 >>> 解析数据 >>> 保存数据
- 发送请求, 对于 https://www.牙.com/g/2168 发送请求 列表页面
- 获取数据, 获取服务器返回的响应数据 response
- 解析数据, 提取我们想要数据内容 主播名字 主播封面图url地址
- json数据 可以直接处理
- re正则表达式提取
- 根据标签节点/属性提取内容:
- xpath
- css选择器
- 保存数据, 图片内容保存到本地文件夹
三.颜值检测
对于我们保存下来照片, 进行颜值检测评分
代码实现
# 导入数据请求 import requests # pip install requests (导入模块没有使用是灰色) # 导入格式化输出模块 import pprint # 导入os文件操作模块 import os import base64 from tqdm import tqdm # 发送请求 # 确定请求的url地址 for page in range(1, 11): url = f'https://www..com/cache.php?m=LiveList&do=getLiveListByPage&gameId=2168&tagAll=0&page={
     page}' # headers 请求头 伪装Python的代码 不被识别出来是爬虫程序... # headers 是一个字典数据类型 headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.110 Safari/537.36' } # 通过requests模块去对url地址发送请求 response = requests.get(url=url, headers=headers) data_list = response.json()['data']['datas'] for index in data_list: # pprint.pprint(index) name = index['nick'] img_url = index['screenshot'] # 4. 保存数据 保存图片数据内容, 也需要发送请求 获取数据 # response.text 获取响应体文本数据 # response.json() 获取响应体的json字典数据 # response.content 获取响应体的二进制数据 img_content = requests.get(url=img_url, headers=headers).content # 'img\\' 文件路径 name 文件名字 '.jpg' 文件后缀 >>> 文件名 # mode 保存方式 wb 二进制模式写入 # as 重命名 为 f filename = 'img_1\\' if not os.path.exists(filename): os.mkdir(filename) with open(filename + name + '.jpg', mode='wb') as f: f.write(img_content) # 写入数据 print('正在保存: ', name) def get_beauty(img_base64): host = 'https://aip.baidubce.com/oauth/2.0/token' data = {
    'grant_type': 'client_credentials', 'client_secret': 'ouZMTMuCGLi7pbeg734ftNxn9h3qN7R4' } response = requests.get(url=host, params=data) token = response.json()['access_token'] # print(token) ''' 人脸检测与属性分析 ''' request_url = f"https://aip.baidubce.com/rest/2.0/face/v3/detect?access_token={
     token}" params = {
    "image": img_base64, "image_type": "BASE64", "face_field": "beauty" } headers = {
   'content-type': 'application/json'} response = requests.post(request_url, data=params, headers=headers) try: beauty = response.json()['result']['face_list'][0]['beauty'] return beauty except: return '识别失败' # 1. 获取所有图片 lis = [] files = os.listdir('img_1\\') print('正在识别人脸, 颜值检测中, 请稍后.....') for file in tqdm(files): img_file = 'img_1\\' + file img_name = file.split('.')[0] # print(img_file) f = open(img_file, mode='rb') # 读取一张图片内容 img_base64 = base64.b64encode(f.read()) beauty = get_beauty(img_base64) if beauty != '识别失败': dit = {
    '主播': img_name, '颜值': beauty, } lis.append(dit) # 把字典添加到空列表里面 # print(f'{img_name}颜值评分是{beauty}') lis.sort(key=lambda x:x['颜值'], reverse=True) num = 1 # 前10张照片的颜值排名 for index in lis: print(f'颜值排名第{
     num}的是{
     index["主播"]}, 颜值评分是{
     index["颜值"]}') num += 1
讯享网
学会了嘛!
喜欢记得三连哦!
结尾给大家推荐一个非常好的学习教程,希望对你学习Python有帮助!
Python基础入门教程推荐:←点击左边蓝色文字就可以跳转观看了
Python爬虫案例教程推荐:←点击左边蓝色文字就可以跳转观看了
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/115813.html