
赛题印度语和泰米尔语问答
1.赛题背景
印度拥有近 14 亿人口,是世界上人口第二多的国家。然而,像印地语和泰米尔语这样的印度语言在网络上的代表性不足。与英语相比,流行的自然语言理解 (NLU) 模型在印度语言中的表现更差,其影响导致印度用户在下游 Web 应用程序中体验不佳。随着 Kaggle 社区的更多关注和您新颖的机器学习解决方案,我们可以帮助印度用户充分利用网络。
预测问题的答案是一项常见的 NLU 任务,但不适用于印地语和泰米尔语。当前多语言建模的进展需要集中精力生成高质量的数据集和建模改进。此外,对于通常在公共数据集中代表性不足的语言,可能难以构建值得信赖的评估。我们希望为本次比赛提供的数据集以及参与者生成的其他数据集能够为印度语言的未来机器学习提供支持。
在本次比赛中,您的目标是预测有关 Wikipedia 文章的真实问题的答案。您将使用 chaii-1,这是一个带有问答对的新问答数据集。数据集涵盖印地语和泰米尔语,收集时未使用翻译。它提供了一个现实的信息搜索任务,问题是由母语专家数据注释者编写的。您将获得一个基线模型和推理代码以供构建。
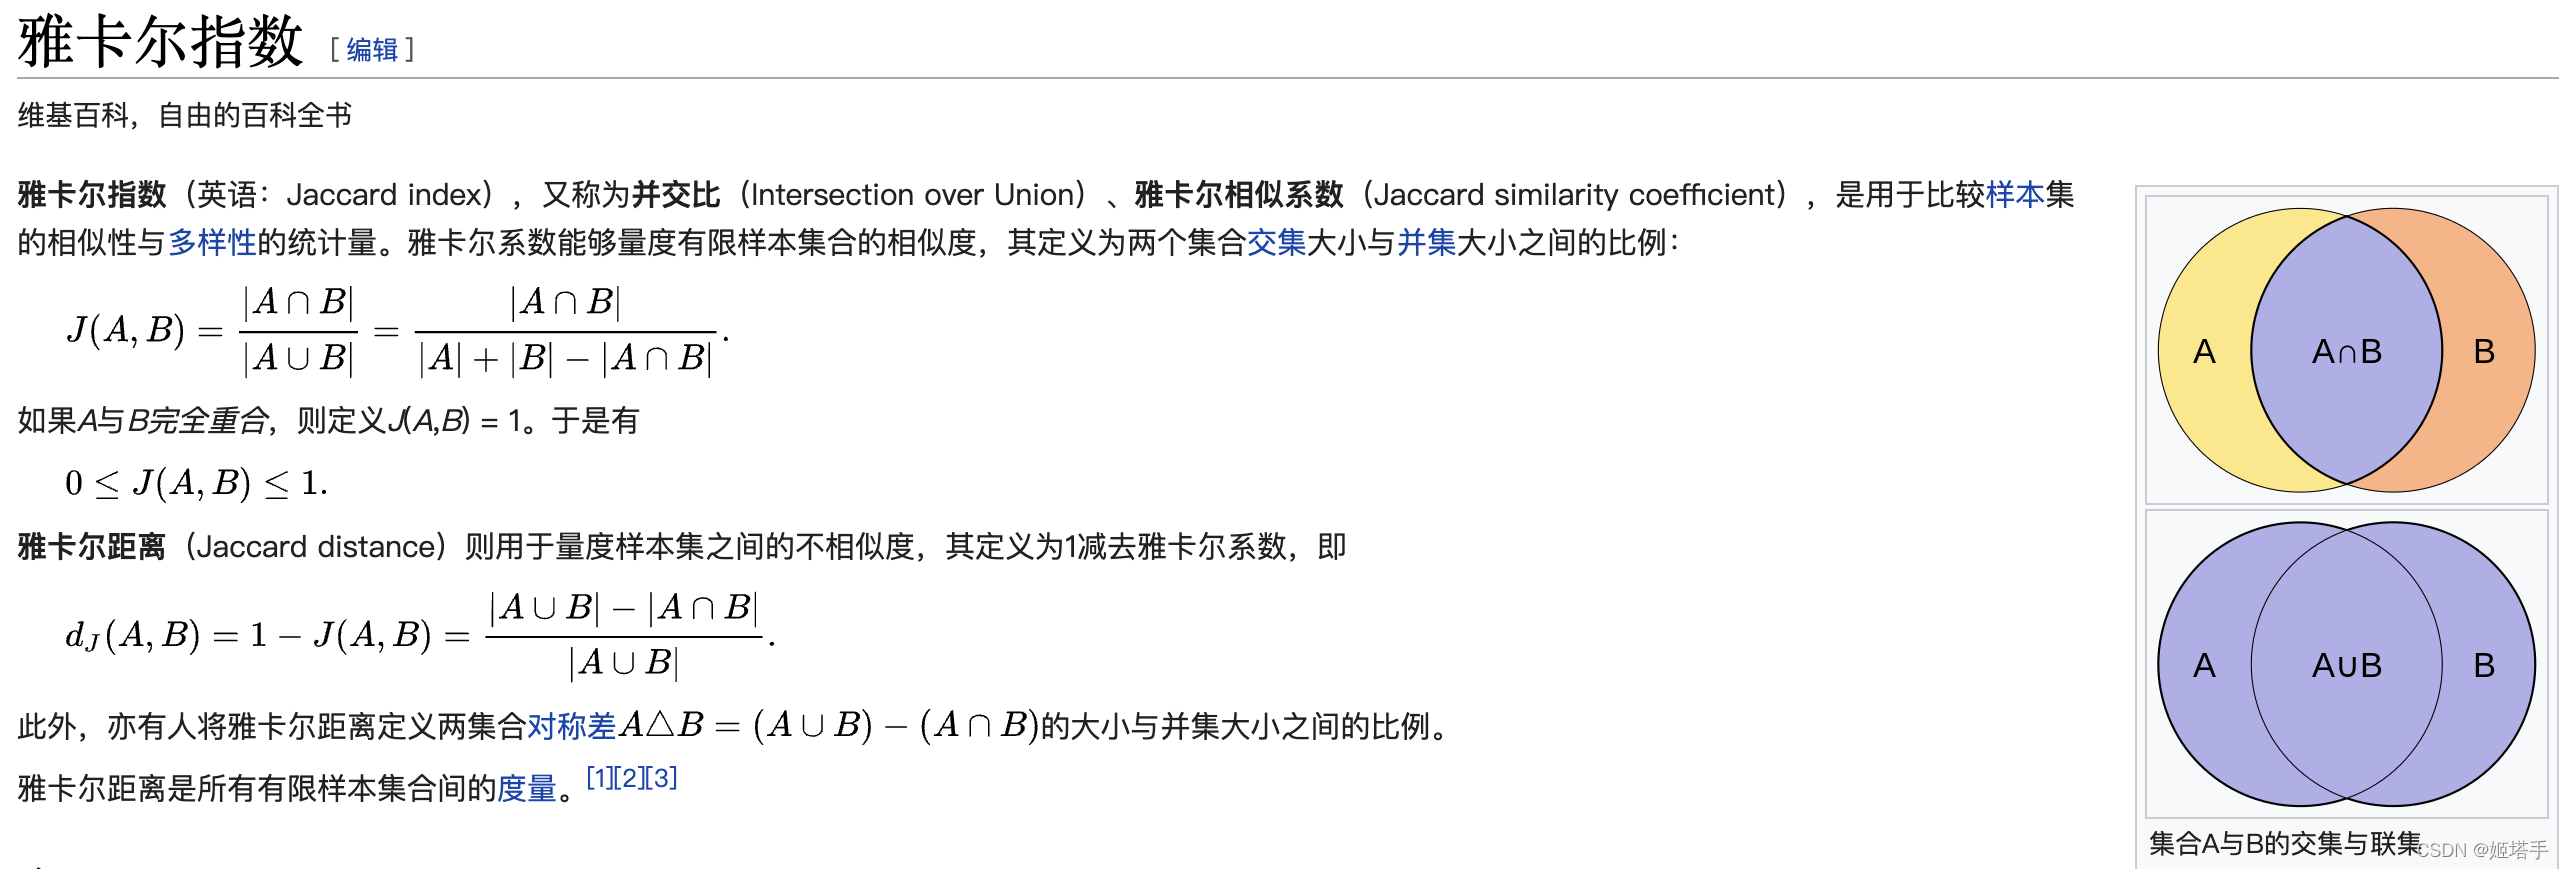
衡量指标
def jaccard(str1, str2):
a = set(str1.lower().split())
b = set(str2.lower().split())
c = a.intersection(b)
return float(len©) / (len(a) + len(b) - len©)
2.参考资料
QA赛题讲解案例
transformer tokenizerAPI使用
fine-tuning
混合精度训练
transformers
3.代码讲解(详细注释)
1.库
import os import gc gc.enable() import math import json import time import random import multiprocessing import warnings warnings.filterwarnings("ignore", category=UserWarning) import numpy as np import pandas as pd from tqdm import tqdm, trange from sklearn import model_selection import torch import torch.nn as nn import torch.nn.functional as F from torch.nn import Parameter import torch.optim as optim#优化器 from torch.utils.data import ( Dataset, DataLoader, SequentialSampler, RandomSampler ) from torch.utils.data.distributed import DistributedSampler#分布式采样器 # 混合精度训练 try: from torch.cuda import amp APEX_INSTALLED = True except ImportError: APEX_INSTALLED = False import transformers from transformers import ( WEIGHTS_NAME, AdamW, AutoConfig, AutoModel, AutoTokenizer, get_cosine_schedule_with_warmup, get_linear_schedule_with_warmup, logging, MODEL_FOR_QUESTION_ANSWERING_MAPPING, ) # https://www.jianshu.com/p/f2d0dbdc51c9÷ logging.set_verbosity_warning()#设置输出级别: logging.set_verbosity_error()#设置输出级别 #随机种子设置 def fix_all_seeds(seed): np.random.seed(seed) random.seed(seed) os.environ['PYTHONHASHSEED'] = str(seed) torch.manual_seed(seed) torch.cuda.manual_seed(seed) torch.cuda.manual_seed_all(seed) # 机器设置 def optimal_num_of_loader_workers(): num_cpus = multiprocessing.cpu_count() num_gpus = torch.cuda.device_count() optimal_value = min(num_cpus, num_gpus*4) if num_gpus else num_cpus - 1 return optimal_value print(f"Apex AMP Installed :: {
     APEX_INSTALLED}") MODEL_CONFIG_CLASSES = list(MODEL_FOR_QUESTION_ANSWERING_MAPPING.keys()) MODEL_TYPES = tuple(conf.model_type for conf in MODEL_CONFIG_CLASSES)
讯享网
2.训练参数设置
transformer tokenizerAPI使用
fine-tuning
讯享网class Config: # model model_type = 'xlm_roberta' model_name_or_path = "deepset/xlm-roberta-large-squad2" config_name = "deepset/xlm-roberta-large-squad2" #fp16。16位精度训练 fp16 = False fp16_opt_level = "O1"#欧1 gradient_accumulation_steps = 2 #所以我们可以发现,tokenizer 帮我们处理了所有, # 对文本进行特殊字符的添加 # padding # truncation # encoding (tokenize,convert_tokens_to_ids) # 转化为tensor # 输出 model 需要的attention mask # (optional) 以及输出 token type ids # tokenizer#分词 tokenizer_name = "deepset/xlm-roberta-large-squad2" max_seq_length = 400#最大序列长度(也叫序列长度,因为长度不够的会被填充) doc_stride = 135#允许的重叠长度,因为超长的时候文本会被截断,就是一个句子会被裁减成两个,但是有时候答案可能会在裁剪处被分成两部分,因此允许裁剪的地方允许存在重叠 裁剪举例 #原文 max_seq_length = 12 理论上裁剪后7 0 但是答案可能是8765 这样答案就被分为了两个部分 #使用了填充后可能就是7。 1,这样答案就不会被分割开 # train epochs = 2 train_batch_size = 4 eval_batch_size = 8 # optimizer # https://blog.csdn.net/kyle/article/details/?ops_request_misc=&request_id=&biz_id=102&utm_term=adamw%E5%8F%82%E6%95%B0%E8%AE%BE%E7%BD%AE&utm_medium=distribute.pc_search_result.none-task-blog-2~all~sobaiduweb~default-0-.pc_search_es_clickV2&spm=1018.2226.3001.4187 optimizer_type = 'AdamW' learning_rate = 1.5e-5 weight_decay = 1e-2 epsilon = 1e-8 max_grad_norm = 1.0 # scheduler decay_name = 'linear-warmup' warmup_ratio = 0.1 # (一)、什么是Warmup? # Warmup是在ResNet论文中提到的一种学习率预热的方法,它在训练开始的时候先选择使用一个较小的学习率,训练了一些epoches或者steps(比如4个epoches,10000steps),再修改为预先设置的学习来进行训练。 # (二)、为什么使用Warmup? # 由于刚开始训练时,模型的权重(weights)是随机初始化的,此时若选择一个较大的学习率,可能带来模型的不稳定(振荡),选择Warmup预热学习率的方式,可以使得开始训练的几个epoches或者一些steps内学习率较小,在预热的小学习率下,模型可以慢慢趋于稳定,等模型相对稳定后再选择预先设置的学习率进行训练,使得模型收敛速度变得更快,模型效果更佳。 # logging logging_steps = 10 # evaluate output_dir = 'output' seed = 1234
3.数据处理分折
train = pd.read_csv('../input/chaii-hindi-and-tamil-question-answering/train.csv') test = pd.read_csv('../input/chaii-hindi-and-tamil-question-answering/test.csv') #external的数据为本赛题的外部数据 external_mlqa = pd.read_csv('../input/mlqa-hindi-processed/mlqa_hindi.csv') external_xquad = pd.read_csv('../input/mlqa-hindi-processed/xquad.csv') external_train = pd.concat([external_mlqa, external_xquad]) #数据分折 def create_folds(data, num_splits): data["kfold"] = -1 kf = model_selection.StratifiedKFold(n_splits=num_splits, shuffle=True, random_state=69) for f, (t_, v_) in enumerate(kf.split(X=data, y=data['language'])): data.loc[v_, 'kfold'] = f return data #添加一个kfold列进行打上fold标签,方便后续分折 train = create_folds(train, num_splits=5) external_train["kfold"] = -1 external_train['id'] = list(np.arange(1, len(external_train)+1)) train = pd.concat([train, external_train]).reset_index(drop=True) def convert_answers(row): return {
   'answer_start': [row[0]], 'text': [row[1]]} train['answers'] = train[['answer_start', 'answer_text']].apply(convert_answers, axis=1)
4.数据编码,后半部分看不懂的在下面这个链接里面有
QA赛题讲解案例
讯享网def prepare_train_features(args, example, tokenizer): example["question"] = example["question"].lstrip()#.lstrip(),截掉字符串坐标的空格(赛题中的数据有的是以空格开始的) #tokenizer https://zhuanlan.zhihu.com/p/ tokenized_example = tokenizer( example["question"], example["context"], truncation="only_second",#文本过长进行截断,onlysecond是只对context(文本)进行切割,切割question是我们不想的(问题本来就不长,但是文本很长) max_length=args.max_seq_length,#编码长度(我们允许每个最长的编码长度) stride=args.doc_stride,#允许的重叠长度 return_overflowing_tokens=True,#返回重叠的部分,就是跟上面重叠部分长度搭配使用的 return_offsets_mapping=True,#我们需要知道我们编码里面哪个是正确答案以及特征的具体位置,map码,000000,用一标记我们的答案。自己看文档 padding="max_length", ) sample_mapping = tokenized_example.pop("overflow_to_sample_mapping") offset_mapping = tokenized_example.pop("offset_mapping") features = [] #数据处理,下面通俗易懂就是问答任务的匹配问题 # https://blog.csdn.net/_/article/details/ for i, offsets in enumerate(offset_mapping): feature = {
   } input_ids = tokenized_example["input_ids"][i] attention_mask = tokenized_example["attention_mask"][i] feature['input_ids'] = input_ids feature['attention_mask'] = attention_mask feature['offset_mapping'] = offsets cls_index = input_ids.index(tokenizer.cls_token_id) sequence_ids = tokenized_example.sequence_ids(i) sample_index = sample_mapping[i] answers = example["answers"] if len(answers["answer_start"]) == 0: feature["start_position"] = cls_index feature["end_position"] = cls_index else: start_char = answers["answer_start"][0] end_char = start_char + len(answers["text"][0]) token_start_index = 0 while sequence_ids[token_start_index] != 1: token_start_index += 1 token_end_index = len(input_ids) - 1 while sequence_ids[token_end_index] != 1: token_end_index -= 1 if not (offsets[token_start_index][0] <= start_char and offsets[token_end_index][1] >= end_char): feature["start_position"] = cls_index feature["end_position"] = cls_index else: while token_start_index < len(offsets) and offsets[token_start_index][0] <= start_char: token_start_index += 1 feature["start_position"] = token_start_index - 1 while offsets[token_end_index][1] >= end_char: token_end_index -= 1 feature["end_position"] = token_end_index + 1 features.append(feature) return features
4.Dataset Retriver
class DatasetRetriever(Dataset): def __init__(self, features, mode='train'): super(DatasetRetriever, self).__init__() self.features = features self.mode = mode def __len__(self): return len(self.features) def __getitem__(self, item): feature = self.features[item] if self.mode == 'train': return {
    'input_ids':torch.tensor(feature['input_ids'], dtype=torch.long), 'attention_mask':torch.tensor(feature['attention_mask'], dtype=torch.long), 'offset_mapping':torch.tensor(feature['offset_mapping'], dtype=torch.long), 'start_position':torch.tensor(feature['start_position'], dtype=torch.long), 'end_position':torch.tensor(feature['end_position'], dtype=torch.long) } else: return {
    'input_ids':torch.tensor(feature['input_ids'], dtype=torch.long), 'attention_mask':torch.tensor(feature['attention_mask'], dtype=torch.long), 'offset_mapping':feature['offset_mapping'], 'sequence_ids':feature['sequence_ids'], 'id':feature['example_id'], 'context': feature['context'], 'question': feature['question'] }
5.模型定义
讯享网class Model(nn.Module): def __init__(self, modelname_or_path, config): super(Model, self).__init__() self.config = config #预训练模型加载 self.xlm_roberta = AutoModel.from_pretrained(modelname_or_path, config=config) self.qa_outputs = nn.Linear(config.hidden_size, 2) self.dropout = nn.Dropout(config.hidden_dropout_prob)#dropout层,最后的全链接层使用 #dropout layer的目的是为了防止CNN 过拟合。那么为什么可以有效的防止过拟合呢? # 首先,想象我们现在只训练一个特定的网络,当迭代次数增多的时候,可能出现网络对训练集拟合的很好(在训练集上loss很小), # 但是对验证集的拟合程度很差的情况。所以,我们有了这样的想法:可不可以让每次跌代随机的去更新网络参数(weights), # 引入这样的随机性就可以增加网络generalize 的能力。所以就有了dropout 。 self._init_weights(self.qa_outputs) #初始化权重 def _init_weights(self, module): if isinstance(module, nn.Linear): module.weight.data.normal_(mean=0.0, std=self.config.initializer_range) if module.bias is not None: module.bias.data.zero_() # forward函数 def forward( self, input_ids, attention_mask=None, # token_type_ids=None ): outputs = self.xlm_roberta( input_ids, attention_mask=attention_mask, ) sequence_output = outputs[0] pooled_output = outputs[1] # sequence_output = self.dropout(sequence_output) qa_logits = self.qa_outputs(sequence_output) start_logits, end_logits = qa_logits.split(1, dim=-1) start_logits = start_logits.squeeze(-1) end_logits = end_logits.squeeze(-1) return start_logits, end_logits
6.Loss
#就是 jaccard,雅卡尔指数 def loss_fn(preds, labels): start_preds, end_preds = preds start_labels, end_labels = labels start_loss = nn.CrossEntropyLoss(ignore_index=-1)(start_preds, start_labels) end_loss = nn.CrossEntropyLoss(ignore_index=-1)(end_preds, end_labels) total_loss = (start_loss + end_loss) / 2 return total_loss 7.Grouped Layerwise Learning Rate Decay
讯享网# 分层训练 def get_optimizer_grouped_parameters(args, model): no_decay = ["bias", "LayerNorm.weight"] group1=['layer.0.','layer.1.','layer.2.','layer.3.'] group2=['layer.4.','layer.5.','layer.6.','layer.7.'] group3=['layer.8.','layer.9.','layer.10.','layer.11.'] group_all=['layer.0.','layer.1.','layer.2.','layer.3.','layer.4.','layer.5.','layer.6.','layer.7.','layer.8.','layer.9.','layer.10.','layer.11.'] optimizer_grouped_parameters = [ {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if not any(nd in n for nd in no_decay) and not any(nd in n for nd in group_all)],'weight_decay': args.weight_decay}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if not any(nd in n for nd in no_decay) and any(nd in n for nd in group1)],'weight_decay': args.weight_decay, 'lr': args.learning_rate/2.6}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if not any(nd in n for nd in no_decay) and any(nd in n for nd in group2)],'weight_decay': args.weight_decay, 'lr': args.learning_rate}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if not any(nd in n for nd in no_decay) and any(nd in n for nd in group3)],'weight_decay': args.weight_decay, 'lr': args.learning_rate*2.6}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if any(nd in n for nd in no_decay) and not any(nd in n for nd in group_all)],'weight_decay': 0.0}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if any(nd in n for nd in no_decay) and any(nd in n for nd in group1)],'weight_decay': 0.0, 'lr': args.learning_rate/2.6}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if any(nd in n for nd in no_decay) and any(nd in n for nd in group2)],'weight_decay': 0.0, 'lr': args.learning_rate}, {
   'params': [p for n, p in model.xlm_roberta.named_parameters() if any(nd in n for nd in no_decay) and any(nd in n for nd in group3)],'weight_decay': 0.0, 'lr': args.learning_rate*2.6}, {
   'params': [p for n, p in model.named_parameters() if args.model_type not in n], 'lr':args.learning_rate*20, "weight_decay": 0.0}, ] return optimizer_grouped_parameters
8.Metric Logger
class AverageMeter(object): def __init__(self): self.reset() def reset(self): self.val = 0 self.avg = 0 self.sum = 0 self.count = 0 self.max = 0 self.min = 1e5 def update(self, val, n=1): self.val = val self.sum += val * n self.count += n self.avg = self.sum / self.count if val > self.max: self.max = val if val < self.min: self.min = val 9.
讯享网#预训练模型 # model # tokenizer # config def make_model(args): config = AutoConfig.from_pretrained(args.config_name) tokenizer = AutoTokenizer.from_pretrained(args.tokenizer_name) model = Model(args.model_name_or_path, config=config) return config, tokenizer, model #优化器定义 def make_optimizer(args, model): # optimizer_grouped_parameters = get_optimizer_grouped_parameters(args, model) no_decay = ["bias", "LayerNorm.weight"] optimizer_grouped_parameters = [ {
    "params": [p for n, p in model.named_parameters() if not any(nd in n for nd in no_decay)], "weight_decay": args.weight_decay, }, {
    "params": [p for n, p in model.named_parameters() if any(nd in n for nd in no_decay)], "weight_decay": 0.0, }, ] if args.optimizer_type == "AdamW": optimizer = AdamW( optimizer_grouped_parameters, lr=args.learning_rate, eps=args.epsilon, correct_bias=True ) return optimizer def make_scheduler( args, optimizer, num_warmup_steps, num_training_steps ): if args.decay_name == "cosine-warmup": scheduler = get_cosine_schedule_with_warmup( optimizer, num_warmup_steps=num_warmup_steps, num_training_steps=num_training_steps ) else: scheduler = get_linear_schedule_with_warmup( optimizer, num_warmup_steps=num_warmup_steps, num_training_steps=num_training_steps ) return scheduler def make_loader( args, data, tokenizer, fold ): train_set, valid_set = data[data['kfold']!=fold], data[data['kfold']==fold] train_features, valid_features = [[] for _ in range(2)] for i, row in train_set.iterrows(): train_features += prepare_train_features(args, row, tokenizer) for i, row in valid_set.iterrows(): valid_features += prepare_train_features(args, row, tokenizer) train_dataset = DatasetRetriever(train_features) valid_dataset = DatasetRetriever(valid_features) print(f"Num examples Train= {
     len(train_dataset)}, Num examples Valid={
     len(valid_dataset)}") train_sampler = RandomSampler(train_dataset) valid_sampler = SequentialSampler(valid_dataset) train_dataloader = DataLoader( train_dataset, batch_size=args.train_batch_size, sampler=train_sampler, num_workers=optimal_num_of_loader_workers(), pin_memory=True, drop_last=False ) valid_dataloader = DataLoader( valid_dataset, batch_size=args.eval_batch_size, sampler=valid_sampler, num_workers=optimal_num_of_loader_workers(), pin_memory=True, drop_last=False ) return train_dataloader, valid_dataloader
10.Trainer
class Trainer: def __init__( self, model, tokenizer, optimizer, scheduler ): self.model = model self.tokenizer = tokenizer self.optimizer = optimizer self.scheduler = scheduler def train( self, args, train_dataloader, epoch, result_dict ): count = 0 losses = AverageMeter() self.model.zero_grad() self.model.train() fix_all_seeds(args.seed) for batch_idx, batch_data in enumerate(train_dataloader): input_ids, attention_mask, targets_start, targets_end = \ batch_data['input_ids'], batch_data['attention_mask'], \ batch_data['start_position'], batch_data['end_position'] input_ids, attention_mask, targets_start, targets_end = \ input_ids.cuda(), attention_mask.cuda(), targets_start.cuda(), targets_end.cuda() outputs_start, outputs_end = self.model( input_ids=input_ids, attention_mask=attention_mask, ) loss = loss_fn((outputs_start, outputs_end), (targets_start, targets_end)) loss = loss / args.gradient_accumulation_steps if args.fp16: with amp.scale_loss(loss, self.optimizer) as scaled_loss: scaled_loss.backward() else: loss.backward() count += input_ids.size(0) losses.update(loss.item(), input_ids.size(0)) # if args.fp16: # torch.nn.utils.clip_grad_norm_(amp.master_params(self.optimizer), args.max_grad_norm) # else: # torch.nn.utils.clip_grad_norm_(self.model.parameters(), args.max_grad_norm) if batch_idx % args.gradient_accumulation_steps == 0 or batch_idx == len(train_dataloader) - 1: self.optimizer.step() self.scheduler.step() self.optimizer.zero_grad() if (batch_idx % args.logging_steps == 0) or (batch_idx+1)==len(train_dataloader): _s = str(len(str(len(train_dataloader.sampler)))) ret = [ ('Epoch: {:0>2} [{: >' + _s + '}/{} ({: >3.0f}%)]').format(epoch, count, len(train_dataloader.sampler), 100 * count / len(train_dataloader.sampler)), 'Train Loss: {: >4.5f}'.format(losses.avg), ] print(', '.join(ret)) result_dict['train_loss'].append(losses.avg) return result_dict 11.evaluater
讯享网class Evaluator: def __init__(self, model): self.model = model def save(self, result, output_dir): with open(f'{
     output_dir}/result_dict.json', 'w') as f: f.write(json.dumps(result, sort_keys=True, indent=4, ensure_ascii=False)) def evaluate(self, valid_dataloader, epoch, result_dict): losses = AverageMeter() for batch_idx, batch_data in enumerate(valid_dataloader): self.model = self.model.eval() input_ids, attention_mask, targets_start, targets_end = \ batch_data['input_ids'], batch_data['attention_mask'], \ batch_data['start_position'], batch_data['end_position'] input_ids, attention_mask, targets_start, targets_end = \ input_ids.cuda(), attention_mask.cuda(), targets_start.cuda(), targets_end.cuda() with torch.no_grad(): outputs_start, outputs_end = self.model( input_ids=input_ids, attention_mask=attention_mask, ) loss = loss_fn((outputs_start, outputs_end), (targets_start, targets_end)) losses.update(loss.item(), input_ids.size(0)) print('----Validation Results Summary----') print('Epoch: [{}] Valid Loss: {: >4.5f}'.format(epoch, losses.avg)) result_dict['val_loss'].append(losses.avg) return result_dict
12.initialize training
def init_training(args, data, fold): fix_all_seeds(args.seed) if not os.path.exists(args.output_dir): os.makedirs(args.output_dir) # model model_config, tokenizer, model = make_model(args) if torch.cuda.device_count() >= 1: print('Model pushed to {} GPU(s), type {}.'.format( torch.cuda.device_count(), torch.cuda.get_device_name(0)) ) model = model.cuda() else: raise ValueError('CPU training is not supported') # data loaders train_dataloader, valid_dataloader = make_loader(args, data, tokenizer, fold) # optimizer optimizer = make_optimizer(args, model) # scheduler num_training_steps = math.ceil(len(train_dataloader) / args.gradient_accumulation_steps) * args.epochs if args.warmup_ratio > 0: num_warmup_steps = int(args.warmup_ratio * num_training_steps) else: num_warmup_steps = 0 print(f"Total Training Steps: {
     num_training_steps}, Total Warmup Steps: {
     num_warmup_steps}") scheduler = make_scheduler(args, optimizer, num_warmup_steps, num_training_steps) # mixed precision training with NVIDIA Apex if args.fp16: model, optimizer = amp.initialize(model, optimizer, opt_level=args.fp16_opt_level) result_dict = {
    'epoch':[], 'train_loss': [], 'val_loss' : [], 'best_val_loss': np.inf } return ( model, model_config, tokenizer, optimizer, scheduler, train_dataloader, valid_dataloader, result_dict )
Run
讯享网def run(data, fold): args = Config() model, model_config, tokenizer, optimizer, scheduler, train_dataloader, \ valid_dataloader, result_dict = init_training(args, data, fold) trainer = Trainer(model, tokenizer, optimizer, scheduler) evaluator = Evaluator(model) train_time_list = [] valid_time_list = [] for epoch in range(args.epochs): result_dict['epoch'].append(epoch) # Train torch.cuda.synchronize() tic1 = time.time() result_dict = trainer.train( args, train_dataloader, epoch, result_dict ) torch.cuda.synchronize() tic2 = time.time() train_time_list.append(tic2 - tic1) # Evaluate torch.cuda.synchronize() tic3 = time.time() result_dict = evaluator.evaluate( valid_dataloader, epoch, result_dict ) torch.cuda.synchronize() tic4 = time.time() valid_time_list.append(tic4 - tic3) output_dir = os.path.join(args.output_dir, f"checkpoint-fold-{
     fold}") if result_dict['val_loss'][-1] < result_dict['best_val_loss']: print("{} Epoch, Best epoch was updated! Valid Loss: {: >4.5f}".format(epoch, result_dict['val_loss'][-1])) result_dict["best_val_loss"] = result_dict['val_loss'][-1] os.makedirs(output_dir, exist_ok=True) torch.save(model.state_dict(), f"{
     output_dir}/pytorch_model.bin") model_config.save_pretrained(output_dir) tokenizer.save_pretrained(output_dir) print(f"Saving model checkpoint to {
     output_dir}.") print() evaluator.save(result_dict, output_dir) print(f"Total Training Time: {
     np.sum(train_time_list)}secs, Average Training Time per Epoch: {
     np.mean(train_time_list)}secs.") print(f"Total Validation Time: {
     np.sum(valid_time_list)}secs, Average Validation Time per Epoch: {
     np.mean(valid_time_list)}secs.") torch.cuda.empty_cache() del trainer, evaluator del model, model_config, tokenizer del optimizer, scheduler del train_dataloader, valid_dataloader, result_dict gc.collect()
for fold in range(1): print();print() print('-'*50) print(f'FOLD: {
     fold}') print('-'*50) run(train, fold)
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/115093.html