
(纯属为了记录自己学习的点滴过程,99%都是复制别人的东西,引用资料都附在参考列表)
1 基本概念
什么是词性
在语言学上,词性(Par-Of-Speech, Pos )指的是单词的语法分类,也称为词类。同一个类别的词语具有相似的语法性质,所有词性的集合称为词性标注集。不同的语料库采用了不同的词性标注集,一般都含有形容词、动词、名词等常见词性。下图就是HanLP输出的一个含有词性的结构化句子。
词性的用处
词性的作用是提供词语的抽象表示,词的数量是无穷的,但词性的数量是有限的。词性支撑着许多高级应用,当下游应用遇到 OOV 时,可以通过 OOV 的词性猜测用法,比如上面的句子“林晚霞”就识别为人名进行处理,而不会拆开。
词性也可以直接用于抽取一些信息,比如抽取所有描述特定商品的形容词等。
序列标注问题
序列标注指的是给定一个序列 ,找出序列中每个元素对应标签 的问题。其中,y 所有可能的取值集合称为标注集。比如,输入一个自然数序列,输出它们的奇偶性。
求解序列标注问题的模型一般称为序列标注器,通常由模型从一个标注数据集中学习相关知识后再进行预测。在NLP问题中,x 通常是字符或词语,而 y 则是待预测的组词角色或词性等标签。中文分词、词性标注以及命名实体识别,都可以转化为序列标注问题。
2 问题
以1998年《人民日报》一月份语料库作为训练、测试数据;
训练集:

讯享网
测试集:
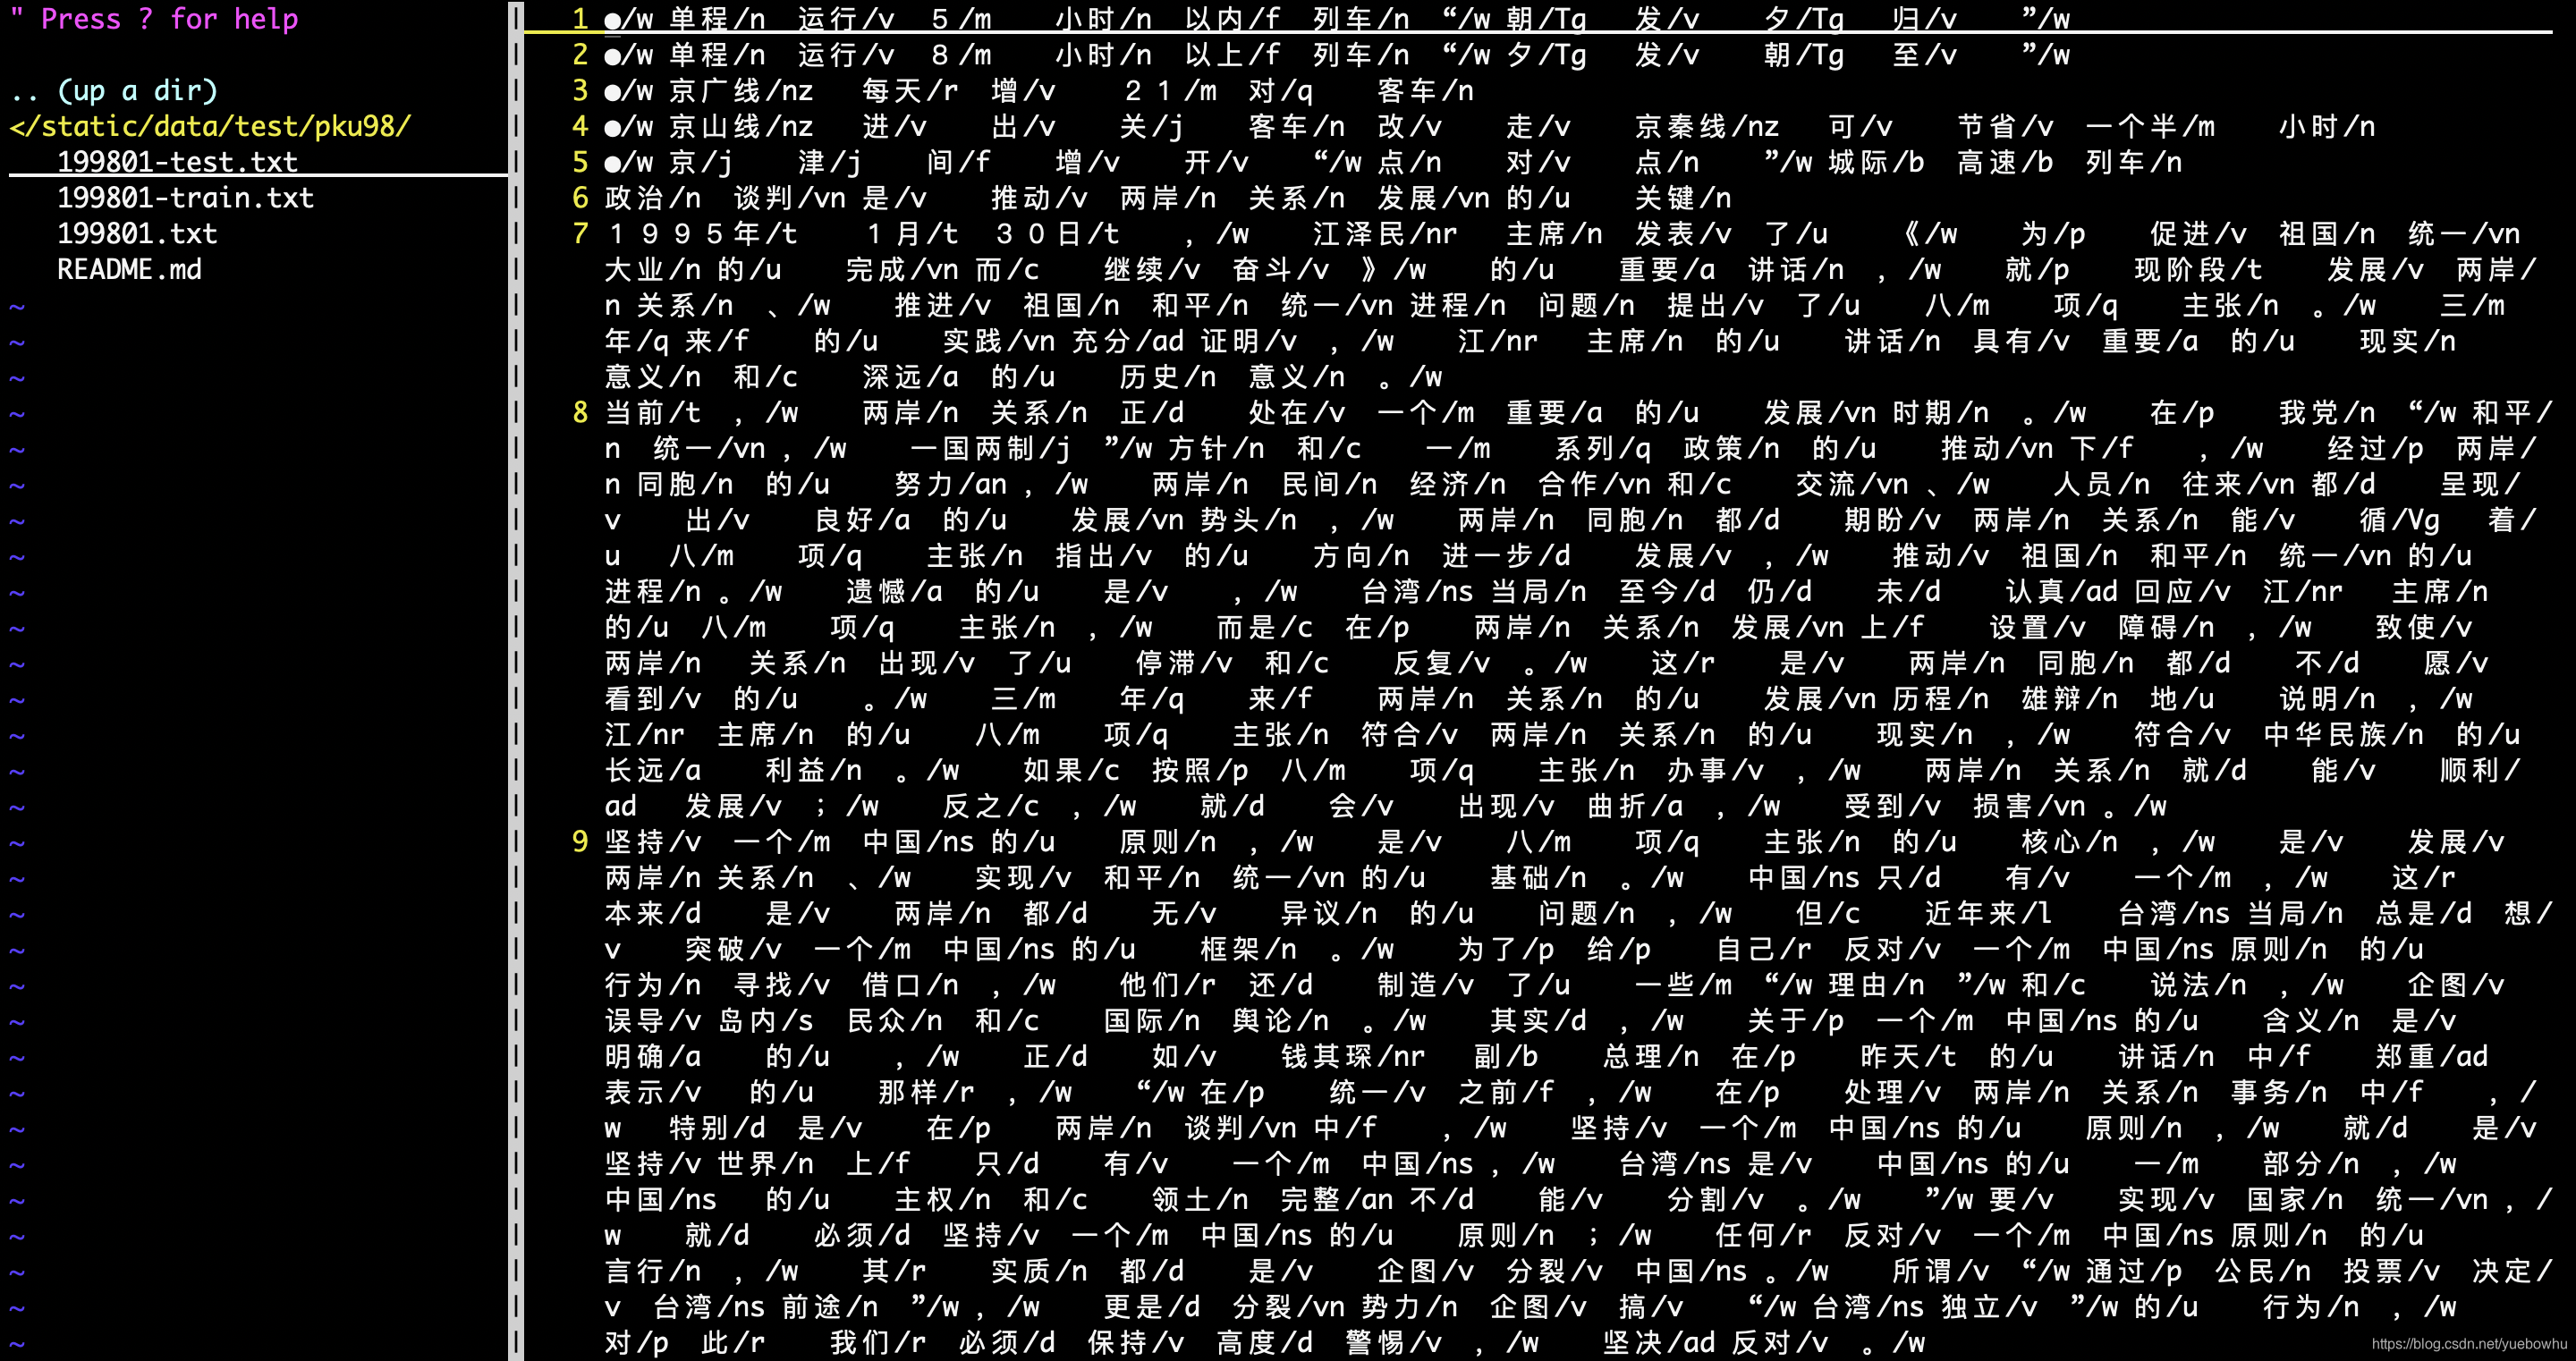
除了文本具体内容,两个数据集标注标准、词性标注集完全一样。
在上面的数据中,每个词组成的序列称为观测序列,每个词对应的词性组成的序列称为状态序列。
3 解决思路
3.1 基于隐马尔可夫模型的词性标注
HMM是概率有向图模型中的一种,应该是机器学习中推理最繁琐的算法了,并且用到了动态规划算法,具体数学细节参考《统计学习方法》;
隐马尔可夫模型( Hidden Markov Model, HMM)是描述两个时序序列联合分布 p(x,y) 的概率模型: x 序列外界可见(外界指的是观测者),称为观测序列(obsevation sequence); y 序列外界不可见,称为状态序列(state sequence)。比如观测 x 为单词,状态 y 为词性,我们需要根据单词序列去猜测它们的词性。隐马尔可夫模型之所以称为“隐”,是因为从外界来看,状 态序列(例如词性)隐藏不可见,是待求的因变量。从这个角度来讲,人们也称状态为隐状态(hidden state),而称观测为显状态( visible state)。隐马尔可夫模型之所以称为“马尔可夫模型”,”是因为它满足马尔可夫假设;
从数据–>HMM模型–>预测词性,要解决概率计算问题、学习问题、预测问题,预测问题就是根据观测序列,预测概率最大的状态序列(即词性序列);
3.2 基于条件随机场的词性标注
CRF是概率无向图模型中的一种,数学细节和HMM基本类似,具体数学细节参考《统计学习方法》;
Hanlp中的CRF实现由于基于java虚拟机,速度比c++要慢,所以作者建议直接在本机上安装crf++,mac安装很简单:brew install crf++,其它安装方法参考https://blog.csdn.net/zzzzlei/article/details/这篇博客。
即使在本机上安装了crf++,训练上面的数据依然有点漫长,大概1h+😊;
3.3 基于感知机的词性标注
perceptron算法可以说是一层神经网络,多层perceptron便成了深度学习模型,具体参考《统计学习方法》;
按照中文分词时的经验,感知机能够利用丰富的上下文特征,是优于隐马尔可夫模型的选择,对于词性标注也是如此。
感知机词性标注模板
状态特征:
x t − 1 , x t , x t + 1 x_{t-1}, x_t, x_{t+1} xt−1,xt,xt+1, x t x_t xt第一个字符, x t x_t xt长2前缀, x t x_t xt长3前缀, x t x_t xt最后一个字符, x t x_t xt长2后缀, x t x_t xt长3后缀
转移特征:
y t − 1 y_{t-1} yt−1
4 实现
4.1 基于隐马尔可夫模型实现
from pyhanlp import * # 这里使用的是1998年《人民日报》1月份语料 from tests.book.ch07.pku import PKU_TRAIN HMMPOSTagger = JClass('com.hankcs.hanlp.model.hmm.HMMPOSTagger') AbstractLexicalAnalyzer = JClass('com.hankcs.hanlp.tokenizer.lexical.AbstractLexicalAnalyzer') PerceptronSegmenter = JClass('com.hankcs.hanlp.model.perceptron.PerceptronSegmenter') FirstOrderHiddenMarkovModel = JClass('com.hankcs.hanlp.model.hmm.FirstOrderHiddenMarkovModel') SecondOrderHiddenMarkovModel = JClass('com.hankcs.hanlp.model.hmm.SecondOrderHiddenMarkovModel') def train_hmm_pos(corpus, model): tagger = HMMPOSTagger(model) # 创建词性标注器 tagger.train(corpus) # 训练 # 词性标注器不负责分词,所以只接受分词后的单词序列 # print(', '.join(tagger.tag("他", "的", "希望", "是", "希望", "上学"))) # 预测 # 加上analyzer可以同时执行分词和词性标注 analyzer = AbstractLexicalAnalyzer(PerceptronSegmenter(), tagger) # 构造词法分析器 # 英文缩写词性 # print(analyzer.analyze("今年元旦我要去看升国旗!")) # 分词+词性标注 # 把英文缩写词性转化为英文 print(analyzer.analyze("他的希望是希望上学").translateLabels()) # 分词+词性标注 return tagger # 一阶隐马尔可夫 tagger = train_hmm_pos(PKU_TRAIN, FirstOrderHiddenMarkovModel()) # 二阶隐马尔可夫 tagger = train_hmm_pos(PKU_TRAIN, SecondOrderHiddenMarkovModel()) 讯享网
运行结果:
讯享网他/代词 的/助词 希望/名词 是/动词 希望/动词 上学/动词 他/代词 的/助词 希望/名词 是/动词 希望/动词 上学/动词
4.2 基于条件随机场模型实现
from pyhanlp import * from tests.book.ch07.demo_hmm_pos import AbstractLexicalAnalyzer, PerceptronSegmenter from tests.book.ch07.pku import POS_MODEL, PKU_TRAIN CRFPOSTagger = JClass('com.hankcs.hanlp.model.crf.CRFPOSTagger') def train_crf_pos(corpus): # 选项1.使用HanLP的Java API训练,慢 tagger = CRFPOSTagger(None) # 创建空白标注器 tagger.train(corpus, POS_MODEL) # 训练 tagger = CRFPOSTagger(POS_MODEL) # 加载 # 选项2.使用CRF++训练,HanLP加载。(训练命令由选项1给出) # tagger = CRFPOSTagger(POS_MODEL + ".txt") print(', '.join(tagger.tag("他", "的", "希望", "是", "希望", "上学"))) # 预测 analyzer = AbstractLexicalAnalyzer(PerceptronSegmenter(), tagger) # 构造词法分析器 print(analyzer.analyze("李狗蛋的希望是希望上学")) # 分词+词性标注 return tagger if __name__ == '__main__': tagger = train_crf_pos(PKU_TRAIN) - 跑了近2h没有成功,😭!,笔记本风扇一直狂叫,还是转移到服务器上干吧!
4.3 基于感知机模型实现
讯享网from pyhanlp import * from tests.book.ch07.demo_hmm_pos import AbstractLexicalAnalyzer, PerceptronSegmenter from tests.book.ch07.pku import PKU_TRAIN, POS_MODEL POSTrainer = JClass('com.hankcs.hanlp.model.perceptron.POSTrainer') PerceptronPOSTagger = JClass('com.hankcs.hanlp.model.perceptron.PerceptronPOSTagger') def train_perceptron_pos(corpus): trainer = POSTrainer() # trainer.train(corpus, POS_MODEL) # 训练 tagger = PerceptronPOSTagger(POS_MODEL) # 加载 print(', '.join(tagger.tag("他", "的", "希望", "是", "希望", "上学"))) # 预测 analyzer = AbstractLexicalAnalyzer(PerceptronSegmenter(), tagger) # 构造词法分析器 print(analyzer.analyze("李狗蛋的希望是希望上学")) # 分词+词性标注 return tagger if __name__ == '__main__': train_perceptron_pos(PKU_TRAIN)
运行结果:
他/r 的/u 希望/n 是/v 希望/v 上学/v 4.4 词性标注评测
可以对每种标签计算一套 P , R , F 1 P, R, F_1 P,R,F1, 也可以笼统地为所有标签计算一套值,此时预测的标签总数=测试集中的标签总数,三个指标退化为相等的 A c c u r a c y Accuracy Accuracy。
Accuracy = #{预测正确的标签数} / #{标签总数}。
将 PKU 语料库按 9:1 分隔为训练集和测试集,分别用以上三种模型来训练,准确率如下:
| 算法 | 准确率 |
|---|---|
| 一阶隐马尔可夫模型 | 44.99% |
| 二阶隐马尔可夫模型 | 40.53% |
| 结构化感知机 | 83.07% |
| 条件随机场 | 82.12% |
从上图可知,结构化感知机和条件随机场都要优于隐马尔可夫模型,判别式模型能够利用更多的特征来进行训练,从而提高更多的精度。
5 参考文献
- 何晗《自然语言处理入门》;
- 宗成庆《统计自然语言处理》;
- 李航《统计学习方法》;
6 需要解决的问题
- 从毛数据到喂给模型训练,数据是怎样处理的?
- 三种模型在学习之前,具体的表达形式是什么?
- hanlp把数据处理和训练、预测高度集成化,尤其是python代码很难将其拆解为数据预处理、特征提取,模型训练这样标准的流程,能否找到对应的工具,将以上实验重现?
- 同一份数据,为什么CRF模型训练的速度如此之慢(其它两个模型10倍时间)?
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/113513.html