
编码体系与规范
网页编码是指网页中字符的编码方式。目前国内常见的网页字符编码主要有utf-8、gbk、gb2312,其中 utf-8为国际化编码,在各国各地区的网站中都很常见,可以说是最通用的字符编码。此外,有些日本网页会使用EUC-JP、SHIFT-JIS,有些韩国网页会使用EUC-KR等字符编码。
1 ASCII

2 gb2312/gbk
由于ASCII编码无法表示中文字符,中国在ASCII编码的基础上进行扩展,形成了中文字符编码,主要有gb2312、gbk以及gb18030。
2.1 gb2312
gb2312编码(《信息交换用汉字编码字符集》)是对ASCII的中文扩展,编码低于127的字符与ASCII编码相同。gb2312 使用两个字节连在一起表示一个汉字,两个字节中前一个称为高字节(范围0xA1~0xF7),后一个称为低字节(范围0xA1~0xFE)。其编码范围是0xA1A1~0xF7FE。
gb2312共收录6763个汉字,每个汉字占两个字节。同时,gb2312对ASCII中的可打印字符重新编了两个字节长的编码,也就是人们常说的“全角”字符;编码低于127的可打印字符为“半角”字符。
2.2 gbk
gbk编码是gb2312的扩展,gbk兼容gb2312的所有内容并且又增加了近2000个新的汉字(包括繁体字)和符号ehk 同样使用两个字节表示一个汉字,只要第一个字节大于127,便认为是一个汉字的开始。其编码范围是0x8140~0xFEFE。
3 unicode
unicode(Universal Multiple-Octet Coded Character Set,通用多八位编码字符集)包含了世界上所有的文字和字符、在unicode字符集中每个字符都有唯一的特定数值。例如大写字母“A”在unicode中的码位为U+0041,汉字“乐”的码位为U+4E50。unicode通常使用两个字节来编码,称为UCS-2(Universal Character Set coded in 2 octets)。为了使unicode 能表示更多的文字,人们提出了UCS-4,使用4个字节编码。
目前unicode 编码范围为0~0x10FFFF,最大的字符至少需要3个字节来表示。表示字符需要的字节数不相同,若直接在网页中使用会出现混淆问题;如果规定所有的字符都使用最大字节表示,会造成极大的空间浪费。为了解决编码字符集unicode 在网页中使用的效率问题,人们提出了utf-8、utf-16等编码方式。
4 utf-8
utf-8(8-bit Unicode Transformation Format)是一种针对 unicode字符集的可变长度字符编码方式。utf-8对不同范围的字符使用不同长度的编码,规则如下。
- unicode 码点在0x00~0x7F的字符,utf-8编码与ASCII编码完全相同。
- unicode 码点大于0x7F的字符,设需要使用n个字节来表示(n>1),第一个字节的前n位都设为1,第n+1位设为0,剩余的n-1个字节的前两位都设为10,剩下的二进制位使用这个字符的unicode码点来填充。
5 编码转换
Python 3中的字符串默认的编码为unicode,因此,gbk、gb2312等字符编码与utf-8编码之间都必须通过unicode编码才能互相转换。即在python中,使用encode()将unicode编码为utf-8、gbk等,而使用decode()将utf-8、gbk等字符编码解码为unicode


6 查看数据编码格式
6.1 查看网页编码
我们在查看网页编码的编码格式可以使用requests库中的apparent_encoding查看网页的编码方式。
import requests resp=requests.get('https://www.baidu.com/') resp.apparent_encoding 讯享网

6.2 查看字符串编码
这里我们使用chardet模块。
chardet模块
The easiest way to use the Universal Encoding Detector library is with the detect function.
使用通用编码检测器库的最简单方法是使用detect函数
The detect function takes one argument, a non-Unicode string. It returns a dictionary containing the auto-detected character encoding and a confidence level from 0 to 1.
detect函数有一个参数, 即非 unicode 字符串。它返回一个字典, 其中包含自动检测的字符编码和从0到1的置信度。
讯享网import chardet print(chardet.detect(str.encode('abc123'))) print(chardet.detect(str.encode('张三'))) print(chardet.detect(str.encode('\xe5\xa4\xa7')))
输出结果为:
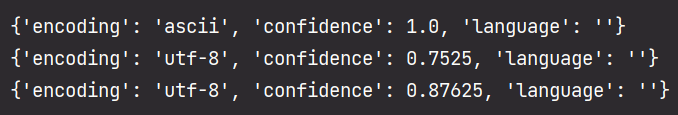
注意:chardet.detect 在查看字符串传的编码时,必须要把字符串encode后,才能查看当前字符串编码格式
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容,请联系我们,一经查实,本站将立刻删除。
如需转载请保留出处:https://51itzy.com/kjqy/112284.html